
ETL de Hive: carga de JSON, XML, ejemplos de datos de texto
 Equipo editorial
⚡ Resumen inteligente
Hive ETL convierte archivos de texto, XML y JSON en tablas consultables cargándolos en Hive y extracal procesar valores con xpath() y get_json_object(), se proporciona a los analistas una interfaz SQL sobre datos semiestructurados de Hadoop.
Hive como herramienta ETL y de almacenamiento de datos sobre la plataforma Hadoop El ecosistema proporciona funcionalidades como modelado de datos, manipulación de datos, procesamiento de datos y consulta de datos.tracLa creación de tablas en Hive implica la creación de tablas en Hive y la carga de datos estructurados y semiestructurados, así como la consulta de datos en función de los requisitos.
Para el procesamiento por lotes, vamos a escribir scripts personalizados definidos utilizando scripts map y reduce personalizados en un lenguaje de scripting. Esto proporciona una SQL entorno similar y soporte para consultas sencillas.
Trabajar con datos estructurados usando Hive
Los datos estructurados significan que los datos están en el formato adecuado de filas y columnas. Esto es más como RDBMS datos con filas y columnas adecuadas.
Aquí vamos a cargar datos estructurados presentes en archivos de texto en Hive.
Paso 1) En este paso, estamos creando la tabla "employees_guru" con nombres de columnas como Id., Nombre, Edad, Dirección, Salario y Departamento de los empleados con tipos de datos.

En la captura de pantalla anterior, podemos observar lo siguiente:
- Creación de tabla “empleados_guru”
- Cargando datos del archivo Employees.txt en la tabla “employees_guru”.
Paso 2) En este paso, mostramos el contenido almacenado en esta tabla mediante el comando "Seleccionar". Podemos observar el contenido de la tabla en la siguiente captura de pantalla.

Fragmento de código de ejemplo
Consultas a realizar
1) Create table employees_guru(Id INT, Name STRING, Age INT, Address STRING, Salary FLOAT, Department STRING)
> Row format delimited
> Fields terminated by ',';
2) load data local inpath '/home/hduser/Employees.txt' into TABLE employees_guru;
3) select * from employees_guru;
Trabajar con datos semiestructurados usando Hive (XML, JSON)
Hive realiza funcionalidades ETL en el ecosistema Hadoop actuando como un Herramienta ETLPuede resultar difícil implementar MapReduce en algunos tipos de aplicaciones; Hive puede reducir esa complejidad y proporciona la mejor solución para aplicaciones de TI en el sector del almacenamiento de datos.
Los datos semiestructurados como XML y JSON se pueden procesar con menos complejidad usando Hive. Primero veremos cómo podemos usar Hive para XML.
XML a tabla de Hive
En esto, cargaremos datos XML en tablas de Hive y recuperaremos los valores almacenados dentro de las etiquetas XML.
Paso 1) Creación de la tabla “xmlsample_guru” con una columna str de tipo de datos string.

En la captura de pantalla anterior, podemos observar lo siguiente:
- Creación de tabla “xmlsample_guru”
- Cargando datos del archivo test.xml en la tabla “xmlsample_guru”.
Paso 2) Usando el XPath Mediante el método xpath(), podremos obtener los datos almacenados dentro de las etiquetas XML.
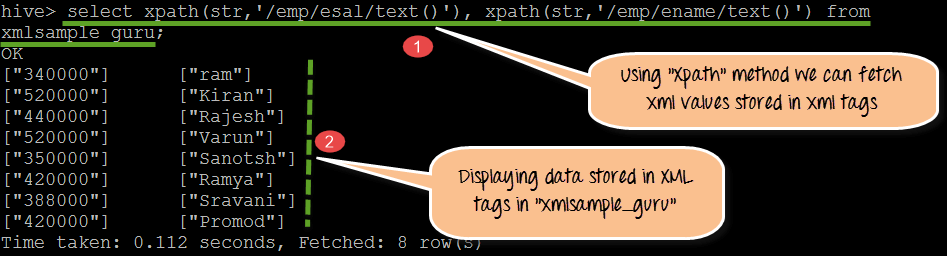
En la captura de pantalla anterior, podemos observar lo siguiente:
- Utilizando el método xpath() estamos obteniendo los valores almacenados en /emp/esal/ y /emp/ename/.
- Valores presentes dentro de las etiquetas XML. En este paso, mostramos los valores reales almacenados bajo las etiquetas XML en la tabla “xmlsample_guru”.
Tenga en cuenta que xpath() devuelve una matriz de cadenas; xpath_string(), xpath_int() y xpath_double() devuelven un único valor tipado.
Paso 3) En este paso, obtendremos y mostraremos el XML sin procesar de la tabla “xmlsample_guru”.

En la captura de pantalla anterior, podemos observar lo siguiente:
- Los datos XML reales que se muestran con etiquetas.
- Si observamos una sola etiqueta, vemos que tiene "emp" como etiqueta principal y "ename" y "esal" como etiquetas secundarias.
Code retazo:
Consultas a realizar
1) create table xmlsample_guru(str string);                                                                                                   2) load data local inpath '/home/hduser/test.xml' overwrite  into table xmlsample_guru;
3) select xpath(str,'emp/ename/text()'), xpath(str,'emp/esal/text()') from xmlsample_guru;
JSON (JavaNotación de objetos de script)
Los datos de redes sociales y sitios web suelen almacenarse en formato JSON. Al intentar obtener datos de servidores en línea, estos devuelven archivos JSON. Utilizando Hive como almacén de datos, podemos cargar datos JSON en tablas de Hive mediante la creación de esquemas.
JSON a tabla de Hive
En este proceso, vamos a cargar datos JSON en tablas de Hive y recuperaremos los valores almacenados en el esquema JSON.
Paso 1) En este paso, vamos a crear una tabla JSON llamada “json_guru”. Una vez creada, cargamos y mostramos el contenido del esquema.

En la captura de pantalla anterior, podemos observar lo siguiente:
- Creación de tabla “json_guru”
- Cargando datos de test.json en la tabla “json_guru”.
- Visualización del esquema real del archivo JSON almacenado en la tabla json_guru.
Paso 2) Utilizando el método get_json_object() podemos obtener los valores de datos almacenados en la jerarquía JSON.

En la captura de pantalla anterior, podemos observar lo siguiente:
- Usando get_json_object(str,'$.ecode') puede obtener los valores de ecode de la tabla json_guru. De manera similar, usando get_json_object(str,'$.ename') y get_json_object(str,'$.sal') obtendrá los valores de ename y sal de la tabla json_guru.
- Valores almacenados dentro de la jerarquía JSON en json_guru
Debido a que get_json_object() analiza el documento una vez por llamada, json_tuple() es más económico cuando se necesitan varias claves, y un JSON SerDe asigna el documento a columnas tipificadas en el momento de la carga.
Code retazo
Consultas a realizar
1) create table json_guru(str string);
2) load data inpath 'home/hduser/test.json' into table json_guru;
3) select * from json_guru;
4) select get_json_object(str,'$.ecode') as ecode, get_json_object(str,'$.ename') as ename ,get_json_object(str,'$.sal') as salary from json_guru;
JSON complejo a tabla de Hive
En este proceso, vamos a cargar datos JSON complejos en tablas de Hive y recuperaremos los valores almacenados en el esquema JSON.
Paso 1) Creando complexjson_guru con un campo de una sola columna.

En la captura de pantalla anterior, podemos observar lo siguiente:
- Creación de la tabla complexjson_guru con un único campo de columna de tipo de datos cadena.
- Cargando datos en complexjson_guru desde el archivo JSON complejo emp.json
Paso 2) Mediante el uso de get_json_object podemos recuperar el contenido real que está almacenado dentro de la jerarquía de archivos JSON.
En la siguiente captura de pantalla, podemos ver el resultado de los datos almacenados en complexjson_guru.
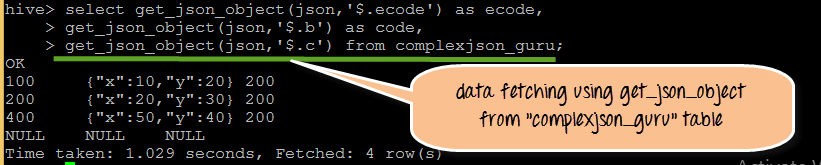
Paso 3) En este paso, mediante el comando “Select” podemos ver los datos JSON complejos almacenados en la tabla “complexjson_guru”.

Fragmento de código de ejemplo
Consultas a realizar
1) create table complexjson_guru(json string);
2) load data inpath 'home/hduser/emp.json' into table complexjson_guru;
3) select get_json_object(json,'$.ecode') as ecode ,get_json_object(json,'$.b') as code, get_json_object(json,'$.c') from complexjson_guru;
4) select * from complexjson_guru;
Hive en proyectos en tiempo real: cuándo y dónde usarlo
Cuándo y dónde usar Hive en el ecosistema Hadoop:
Cuando
- Al trabajar con funciones estadísticas fuertes y potentes en el ecosistema Hadoop
- Al trabajar con procesamiento de datos estructurados y semiestructurados
- Como herramienta de almacenamiento de datos con Hadoop
- Ingesta de datos en tiempo real con HBase, donde se puede utilizar Hive.
Donde
- Para facilitar su uso como herramienta ETL y de almacenamiento de datos.
- Proporcionar un entorno de tipo SQL y realizar consultas como SQL utilizando HiveQL.
- Para utilizar e implementar scripts de mapeo y reducción personalizados según los requisitos específicos del cliente.
