
วิธีแทนที่ค่าที่หายไป (NA) ใน R: na.omit & na.rm
 เอเวลิน คลาร์ก
⚡ สรุปอย่างชาญฉลาด
การแทนที่ค่าที่หายไปใน R ครอบคลุมการตรวจจับค่า NA การลบแถวที่ไม่สมบูรณ์ด้วย na.omit() และการเติมค่าที่หายไปด้วยค่าเฉลี่ยหรือค่ามัธยฐานผ่าน mutate() ตัวอย่างนี้ใช้ชุดข้อมูล Titanic ซึ่งทั้งอายุและค่าโดยสารมีข้อมูลที่หายไป
ค่าที่หายไปใน R คืออะไร?
ค่าที่หายไปจะปรากฏขึ้นเมื่อไม่มีค่าบันทึกไว้ในคอลัมน์ หรือเมื่อมีตัวแทนที่ไม่ใช่ตัวเลขอยู่ในตำแหน่งที่ควรจะเป็นตัวเลข จะต้องลบหรือแทนที่ค่าที่หายไปเหล่านี้ก่อนทำการคำนวณใดๆ เนื่องจากฟังก์ชันส่วนใหญ่ใน R จะส่งคืนค่า NA ทันทีที่มีค่าดังกล่าวปรากฏอยู่
บทช่วยสอนนี้แสดงวิธีการจัดการกับค่าที่หายไปโดยใช้ไลบรารี dplyr ซึ่งเป็นส่วนหนึ่งของระบบนิเวศ tidyverse สำหรับการวิเคราะห์ข้อมูล
ขั้นตอนแรกคือการตรวจสอบว่ามีค่าที่หายไปกี่ค่าและอยู่ที่ตำแหน่งใด
วิธีการตรวจจับและนับค่าที่หายไปใน R
ก่อนที่จะตัดสินใจว่าจะจัดการกับค่าที่หายไปอย่างไร คุณต้องรู้ก่อนว่ามีค่าที่หายไปจำนวนเท่าใดและอยู่ที่ตำแหน่งใด R มีวิธีการตรวจสอบสี่แบบ ตั้งแต่คำตอบใช่หรือไม่ใช่เพียงคำตอบเดียว ไปจนถึงการนับจำนวนค่าที่หายไปในแต่ละคอลัมน์อย่างละเอียด
# 1. Is there any NA at all?
anyNA(df_titanic)

# 2. How many in total?
sum(is.na(df_titanic))

# 3. How many per column, the most useful view
colSums(is.na(df_titanic))

# 4. Percentage missing per column
round(colMeans(is.na(df_titanic)) * 100, 1)
ในทางปฏิบัติ ควรเลือกใช้เมธอด colSums() เมธอดนี้จะส่งคืนเวกเตอร์ที่มีชื่อ โดยแต่ละเวกเตอร์จะนับจำนวนค่าในแต่ละคอลัมน์ ซึ่งจะแสดงให้เห็นทันทีว่าตัวแปรนั้นขาดค่าไปจำนวนหนึ่ง หรือส่วนใหญ่ว่างเปล่า
นับจำนวนแถวทั้งหมด complete.cases() จะคืนค่า TRUE สำหรับแถวที่ไม่มีค่าที่หายไปที่ใดเลย ซึ่งจะบอกคุณล่วงหน้าว่า na.omit() จะทิ้งข้อมูลไปเท่าใด:
sum(complete.cases(df_titanic))       # rows that would survive
sum(!complete.cases(df_titanic))      # rows that would be dropped
คำเตือนเกี่ยวกับตัวแปรแทนที่ R รู้จักเฉพาะค่า NA เท่านั้น ชุดข้อมูลมักจะเข้ารหัสค่าที่หายไปเป็นสตริงว่าง ช่องว่าง "N/A" "-" หรือตัวเลขบ่งชี้ เช่น -99 หรือ 999 ซึ่งจะผ่านการตรวจสอบทั้งหมดข้างต้นโดยไม่ถูกตรวจพบ แปลงค่าเหล่านี้ในระหว่างการนำเข้าเพื่อให้ขั้นตอนการทำงานที่เหลือทำงานได้อย่างถูกต้อง:
df <- read.csv(PATH, na.strings = c("", " ", "NA", "N/A", "-", "-99"))
ควรตรวจสอบช่วงค่าของแต่ละคอลัมน์ตัวเลขทุกครั้งหลังนำเข้า ค่าอายุ -99 หรือค่าโดยสาร 9999 นั้นอันตรายกว่าค่า NA มาก เพราะไม่มีฟังก์ชันใดแจ้งเตือนคุณเกี่ยวกับค่าเหล่านี้
ประเภทของข้อมูลที่หายไป: MCAR, MAR และ MNAR
สาเหตุที่ค่าหายไปจะเป็นตัวกำหนดว่าการเติมค่าลงไปนั้นปลอดภัยหรือไม่ นักสถิติระบุกลไกไว้สามอย่าง
- MCAR ย่อมาจาก Missing Completely At Random (การขาดหายไปโดยสมบูรณ์แบบสุ่ม) ความน่าจะเป็นของการสูญหายไม่เกี่ยวข้องกับสิ่งใดๆ ไม่ว่าจะสังเกตเห็นหรือไม่ก็ตาม ตัวอย่างเช่น เซ็นเซอร์ที่ทำงานผิดพลาดในบางช่วงเวลาโดยไม่ทราบสาเหตุ การตกหล่นping หรือการเติมข้อมูลในแถวเหล่านี้ไม่ได้ทำให้เกิดอคติใดๆ เพียงแต่ทำให้ความแม่นยำลดลงเท่านั้น
- MAR, หายสาบสูญโดยสุ่ม ความน่าจะเป็นขึ้นอยู่กับตัวแปรที่สังเกตได้อื่นๆ แต่ไม่ขึ้นอยู่กับค่าที่หายไปเอง หากผู้โดยสารสูงอายุมีโอกาสน้อยที่จะได้รับการบันทึกอายุ อายุจะเป็นค่า MAR (Marginal Average Requirement) เมื่อพิจารณาจากคอลัมน์อื่นๆ วิธีการประมาณค่าโดยใช้คอลัมน์เหล่านั้นสามารถจัดการปัญหานี้ได้ดี
- MNAR, ข้อมูลที่หายไปไม่ได้เกิดขึ้นโดยบังเอิญ ความน่าจะเป็นขึ้นอยู่กับค่าที่ไม่สามารถสังเกตได้เอง ตัวอย่างเช่น ผู้ที่มีรายได้สูงอาจไม่เปิดเผยรายได้ของตน ไม่มีวิธีการประมาณค่าใดที่สามารถแก้ไขปัญหานี้ได้จากข้อมูลเพียงอย่างเดียว และการขาดหายไปของข้อมูลนั้นเองก็มีข้อมูลที่ควรบันทึกไว้ในคอลัมน์บ่งชี้
การเติมค่าเฉลี่ยตามที่ใช้ในบทช่วยสอนนี้ ใช้ได้เฉพาะกับ MCAR และ MAR แบบง่ายเท่านั้น ถึงกระนั้นก็ยังมีข้อเสียที่ทราบกันดีอยู่แล้ว คือ การเติมตัวเลขเดียวกันลงในช่องว่างทุกช่องจะทำให้ค่าความแปรปรวนของคอลัมน์ลดลงและทำให้ความสัมพันธ์กับค่าอื่นๆ อ่อนลง สำหรับการใช้งานจริงจัง ควรใช้วิธีการแบบจำลอง เช่น แพ็กเกจ mice และควรเก็บคอลัมน์ที่ระบุค่าที่ถูกเติมไว้เสมอ
กลายพันธุ์()
mutate() คือ ดีพลีร์ คำกริยาที่สร้างตัวแปรใหม่หรือเขียนทับตัวแปรที่มีอยู่เดิม ทำให้เป็นเครื่องมือที่เหมาะสมที่สุดสำหรับการสร้างสำเนาที่สะอาดของคอลัมน์
เราจะดำเนินการในสองส่วน เราจะได้เรียนรู้วิธีการ:
- แยกค่าที่หายไปออกจากกรอบข้อมูล
- ระบุค่าที่หายไปด้วยค่าเฉลี่ยและค่ามัธยฐาน
การใช้คำกริยา mutate() นั้นง่ายมาก เราสามารถสร้างตัวแปรใหม่โดยใช้รูปแบบนี้:
mutate(df, name_variable_1 = condition, ...)
arguments:
-df: Data frame used to create a new variable
-name_variable_1: Name and the formula to create the new variable
-...: No limit constraint. Possibility to create more than one variable inside mutate()
ไม่รวมค่าที่ขาดหายไป (NA)
`na.omit()` เป็นฟังก์ชันพื้นฐานของ R ไม่ใช่คำสั่งของ dplyr แต่ก็สามารถส่งต่อไปยังฟังก์ชันอื่นได้อย่างราบรื่นเช่นกัน ฟังก์ชันนี้จะตัดแถวที่มีค่า `NA` อย่างน้อยหนึ่งค่าออกไป นี่เป็นวิธีที่เร็วที่สุดและแทบจะไม่ใช่วิธีที่ดีที่สุด เพราะค่าที่หายไปเพียงค่าเดียวจะทำให้ข้อมูลทั้งหมดถูกทิ้งไป
เพื่อแก้ไขปัญหาการสังเกตการณ์ที่หายไป เราจะใช้ชุดข้อมูลไททานิค ในชุดข้อมูลนี้ เราสามารถเข้าถึงข้อมูลของผู้โดยสารบนเครื่องระหว่างที่เกิดโศกนาฏกรรม ชุดข้อมูลนี้มี NA จำนวนมากที่ต้องได้รับการดูแล
โหลดไฟล์ CSV จากอินเทอร์เน็ต จากนั้นแสดงรายการคอลัมน์ที่มีค่า NA:
PATH <- "https://raw.githubusercontent.com/guru99-edu/R-Programming/master/test.csv"
df_titanic <- read.csv(PATH, sep = ",")
# Return the column names containing missing observations
list_na <- colnames(df_titanic)[ apply(df_titanic, 2, anyNA) ]
list_na
Output:
## [1] "age" "fare"
ที่นี่
colnames(df_titanic)[apply(df_titanic, 2, anyNA)]
ส่งคืนชื่อคอลัมน์ที่มีค่าว่างอย่างน้อยหนึ่งค่า
อายุและค่าโดยสารของคอลัมน์มีค่าขาดหายไป
เราสามารถปล่อยมันไว้ด้วย na.omit()
library(dplyr)
# Exclude the missing observations
df_titanic_drop <-df_titanic %>%
na.omit()
dim(df_titanic_drop)
Output:
## [1] 1045 13
ชุดข้อมูลใหม่ประกอบด้วย 1045 แถว เทียบกับ 1309 แถวกับชุดข้อมูลดั้งเดิม
เติมข้อมูลที่ขาดหายไปโดยใช้ค่าเฉลี่ยและค่ามัธยฐาน
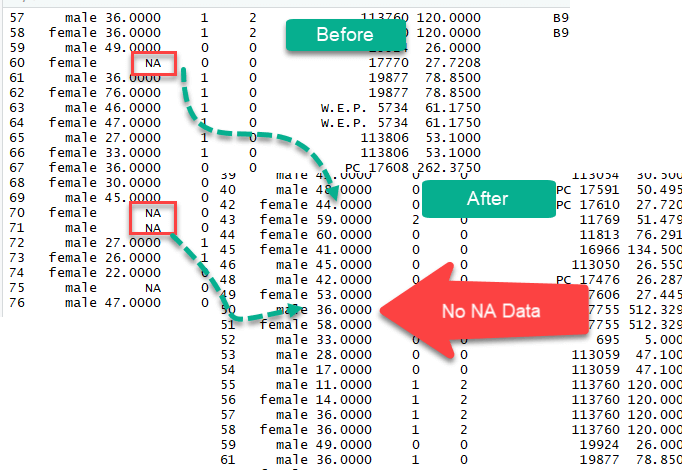
นอกจากนี้ คุณยังสามารถเติมค่าที่หายไปโดยใช้ค่าเฉลี่ยหรือค่ามัธยฐานได้ วิธีที่ดีคือการสร้างตัวแปรแยกกันสองตัวสำหรับค่าเฉลี่ยและค่ามัธยฐาน เมื่อสร้างตัวแปรแล้ว เราสามารถแทนที่ค่าที่หายไปด้วยตัวแปรที่สร้างขึ้นใหม่ได้
เราจะใช้วิธี Apply เพื่อคำนวณค่าเฉลี่ยของคอลัมน์ด้วย NA มาดูตัวอย่างกัน
ขั้นตอน 1) ในช่วงต้นของบทช่วยสอน เราได้จัดเก็บชื่อคอลัมน์ที่มีค่าที่หายไปในรายการชื่อ list_na เราจะใช้รายการนี้
ขั้นตอน 2) คำนวณค่าเฉลี่ยโดยใช้พารามิเตอร์ na.rm = TRUE พารามิเตอร์นี้จำเป็นเนื่องจากมีข้อมูลที่ขาดหายไปในคอลัมน์ และพารามิเตอร์นี้จะบอกให้ R ละเว้นข้อมูลที่ขาดหายไปเหล่านั้น
# Create mean
average_missing <- apply(df_titanic[,colnames(df_titanic) %in% list_na],
      2,
      mean,
      na.rm =  TRUE)
average_missing
Code คำอธิบาย:
เราผ่านข้อโต้แย้ง 4 ข้อในวิธีการสมัคร
- df: df_titanic[,colnames(df_titanic) %in% list_na]. รหัสนี้จะส่งคืนชื่อคอลัมน์จากวัตถุ list_na (เช่น "อายุ" และ "ค่าโดยสาร")
- 2: คำนวณฟังก์ชันบนคอลัมน์
- ความหมาย: คำนวณค่าเฉลี่ย
- na.rm = TRUE: ละเว้นค่าที่หายไป
Output:
##      age     fare
## 29.88113 33.29548
เราสร้างค่าเฉลี่ยของคอลัมน์ที่มีการสังเกตที่ขาดหายไปได้สำเร็จ ค่าทั้งสองนี้จะถูกนำมาใช้เพื่อแทนที่การสังเกตที่ขาดหายไป
ขั้นตอน 3) แทนที่ค่า NA
คำกริยากลายพันธุ์จากไลบรารี dplyr มีประโยชน์ในการสร้างตัวแปรใหม่ เราไม่จำเป็นต้องเปลี่ยนคอลัมน์เดิมเพื่อให้เราสามารถสร้างตัวแปรใหม่โดยไม่มี NA ได้ mutate ใช้งานง่าย เพียงเลือกชื่อตัวแปรและกำหนดวิธีสร้างตัวแปรนี้ นี่คือรหัสที่สมบูรณ์
# Create a new variable with the mean and median
df_titanic_replace <- df_titanic %>%
   mutate(replace_mean_age  = ifelse(is.na(age), average_missing[1], age),
   replace_mean_fare = ifelse(is.na(fare), average_missing[2], fare))
Code คำอธิบาย:
เราสร้างตัวแปรขึ้นมาสองตัวคือ replacement_mean_age และแทนที่_mean_fare ดังนี้:
- แทนที่_mean_age = ifelse (is.na (อายุ), ค่าเฉลี่ย _missing [1], อายุ)
- แทนที่_mean_fare = ifelse (is.na (ค่าโดยสาร), เฉลี่ย _missing [2], ค่าโดยสาร)
หากอายุคอลัมน์มีค่าที่ขาดหายไป ให้แทนที่ด้วยองค์ประกอบแรกของ Average_missing (ค่าเฉลี่ยอายุ) มิฉะนั้นคงค่าเดิมไว้ ตรรกะเดียวกันสำหรับค่าโดยสาร
sum(is.na(df_titanic_replace$age))
Output:
## [1] 263
หลังจากทำการแทนที่แล้ว คอลัมน์ใหม่ไม่มีค่าที่หายไปเลย:
sum(is.na(df_titanic_replace$replace_mean_age))
Output:
## [1] 0
คอลัมน์อายุเดิมมีค่าที่หายไป 263 ค่า ในขณะที่คอลัมน์ replace_mean_age ใหม่ได้เติมค่าเฉลี่ยอายุลงในค่าที่หายไปทั้งหมดแล้ว
ขั้นตอน 4) เราสามารถแทนที่การสังเกตที่หายไปด้วยค่ามัธยฐานได้เช่นกัน
median_missing <- apply(df_titanic[,colnames(df_titanic) %in% list_na],
      2,
      median,
      na.rm =  TRUE)
df_titanic_replace <- df_titanic %>%
            mutate(replace_median_age  = ifelse(is.na(age), median_missing[1], age),
            replace_median_fare = ifelse(is.na(fare), median_missing[2], fare))
head(df_titanic_replace)
Output:

ขั้นตอน 5) ในชุดข้อมูลขนาดใหญ่ วิธีการทีละขั้นตอนจะยุ่งยาก ฟังก์ชัน sapply() จะรวมกระบวนการทั้งหมดไว้ในคำสั่งเดียว แต่ข้อเสียคือจะไม่เห็นค่าที่ถูกเติมเข้าไป
sapply ไม่ได้สร้าง กรอบข้อมูลดังนั้นเราจึงสามารถรวมฟังก์ชัน sapply() ภายใน data.frame() เพื่อสร้างวัตถุ data frame
# Quick code to replace missing values with the mean
df_titanic_impute_mean <- data.frame(
    sapply(
        df_titanic,
        function(x) ifelse(is.na(x),
            mean(x, na.rm = TRUE),
            x)))
การเติมค่าที่ขาดหายไปแบบสมัยใหม่ด้วย replace_na() และ across()
วิธีการใช้ apply() และ sapply() ข้างต้นยังคงใช้ได้ แต่ปัจจุบัน tidyr และ dplyr แสดงการดำเนินการเดียวกันได้อย่างปลอดภัยและอ่านง่ายกว่า
replace_na() สำหรับค่าคงที่ tidyr::replace_na() รับรายการชื่อคอลัมน์และค่าที่จะใช้แทนที่:
library(tidyr)

df_titanic %>%
    replace_na(list(age = 29.88, fare = 33.30))
ใช้ฟังก์ชัน across() สำหรับทุกคอลัมน์ที่เป็นตัวเลข นี่คือตัวเลือกทดแทนโดยตรงและปลอดภัยต่อประเภทข้อมูลสำหรับคำสั่ง sapply() แบบบรรทัดเดียว และแตกต่างจาก sapply() ตรงที่มันไม่แตะต้องคอลัมน์ประเภทอักขระหรือแฟกเตอร์เลย:
library(dplyr)

# Mean-impute every numeric column
df_titanic %>%
    mutate(across(where(is.numeric),
                  ~ ifelse(is.na(.x), mean(.x, na.rm = TRUE), .x)))

# Median-impute instead
df_titanic %>%
    mutate(across(where(is.numeric),
                  ~ ifelse(is.na(.x), median(.x, na.rm = TRUE), .x)))
⚠️ เหตุใดการใช้ทางลัด sapply() จึงมีความเสี่ยง: ตัวอย่าง sapply() บรรทัดเดียวจะทำงานเกิน ทุกๆ คอลัมน์ดังกล่าว รวมถึงคอลัมน์ประเภทอักขระและแฟกเตอร์ การเรียกใช้ mean() บนคอลัมน์เหล่านั้นจะส่งคืนค่า NA พร้อมคำเตือน และ sapply() จะแปลงผลลัพธ์ทั้งหมดให้เป็นอักขระ วิธีการใช้ across(where(is.numeric), …) ข้างต้นจะหลีกเลี่ยงปัญหานี้ได้อย่างสมบูรณ์
coalesce() สำหรับคอลัมน์สำรอง เมื่อคอลัมน์ที่สองสามารถให้ค่าที่หายไปได้ ฟังก์ชัน coalesce() จะส่งคืนค่าที่ไม่หายไปรายการแรกจากอาร์กิวเมนต์ทั้งหมด:
df %>% mutate(age_final = coalesce(age, age_estimated, 0))
จดบันทึกสิ่งที่คุณเปลี่ยนแปลงไว้ เพิ่มแฟล็กก่อนทำการเติมข้อมูล เพื่อให้โมเดลรุ่นต่อๆ ไปสามารถเรียนรู้จากข้อเท็จจริงที่ว่ามีค่าหนึ่งหายไป:
df_titanic %>%
    mutate(age_was_missing = is.na(age),
           age = ifelse(is.na(age), mean(age, na.rm = TRUE), age))
การจัดการค่าที่หายไปใน R: คู่มือวิธีการ
บทช่วยสอนนี้จะกล่าวถึงสามแนวทาง:
- ไม่รวมข้อสังเกตที่ขาดหายไปทั้งหมด
- ใส่ร้ายด้วยค่าเฉลี่ย
- ใส่ร้ายกับค่ามัธยฐาน
ตารางด้านล่างนี้สรุปการตรวจจับและการกำจัด:
| ห้องสมุด | วัตถุประสงค์ | Code |
|---|---|---|
| ฐาน | แสดงรายการข้อสังเกตที่ขาดหายไป |
colnames(df)[apply(df, 2, anyNA)] |
| ฐาน | ลบทุกแถวที่มีค่า NA ออก |
na.omit(df) |
การใส่ร้ายด้วยค่าเฉลี่ยหรือค่ามัธยฐานสามารถทำได้สองวิธี
- การใช้สมัคร
- การใช้ sapply
| วิธี | รายละเอียด | ข้อดี | ข้อเสีย |
|---|---|---|---|
| ทีละขั้นตอนกับการสมัคร | ตรวจสอบคอลัมน์ที่ขาดหายไป คำนวณค่าเฉลี่ย/ค่ามัธยฐาน เก็บค่า แทนที่ด้วย mutate() | คุณสามารถดูค่าเฉลี่ยหรือค่ามัธยฐานที่ประมาณได้ | เวลาดำเนินการมากขึ้น อาจช้าได้ด้วยชุดข้อมูลขนาดใหญ่ |
| วิธีที่รวดเร็วด้วย sapply | ใช้ sapply() และ data.frame() เพื่อค้นหาและแทนที่ค่าที่หายไปด้วยค่าเฉลี่ย/ค่ามัธยฐานโดยอัตโนมัติ | รหัสสั้นและรวดเร็ว | ค่าที่ประมาณขึ้นจะไม่แสดงให้เห็น |
