
วิธีการตั้งค่า Cassandra Cluster บนหลายโหนด
 เดวิดคาร์เตอร์
⚡ สรุปอย่างชาญฉลาด
Cassandra Cluster คลัสเตอร์จะรวมโหนดหลายๆ โหนดเข้าด้วยกันเพื่อให้ข้อมูลกระจายออกไป และไม่มีเครื่องใดเครื่องหนึ่งเก็บข้อมูลทั้งหมดไว้เพียงเครื่องเดียว หน้านี้อธิบายถึงส่วนประกอบของคลัสเตอร์ ได้แก่ ตัวแบ่งพาร์ติชันและโทเค็นริง ข้อกำหนดเบื้องต้น การตั้งค่าที่ใช้ในการเชื่อมต่อโหนดเข้าด้วยกัน และวิธีการตรวจสอบผลลัพธ์
ความหมายของ Cassandra Cluster?
A Cassandra คลัสเตอร์คือหนึ่งในเปลือกหอยทั้งหมด Cassandra ฐานข้อมูล NS Cassandra คลัสเตอร์ประกอบด้วยชั้นจัดเก็บข้อมูลที่แตกต่างกันหลายชั้น และแต่ละชั้นก็บรรจุชั้นอื่นๆ ไว้ภายใน
องค์กรขนาดใหญ่เช่น Amazonบริษัทต่างๆ เช่น Facebook เป็นต้น มีข้อมูลจำนวนมหาศาลที่ต้องจัดการ ดังนั้นองค์กรเหล่านี้จึงไม่สามารถจัดเก็บข้อมูลจำนวนมากนั้นไว้ในเครื่องเดียวได้ นี่คือเหตุผลที่พวกเขาใช้ฐานข้อมูล เช่น Cassandra ด้วยสถาปัตยกรรมแบบกระจาย
องค์กรเหล่านี้จัดเก็บข้อมูลจำนวนมหาศาลไว้ในโหนดหลายแห่ง โหนดเหล่านี้สื่อสารกัน เพื่อจุดประสงค์นี้ Cassandra คลัสเตอร์ได้รับการจัดตั้งขึ้นแล้ว
- Cluster โดยพื้นฐานแล้วมันคือกลุ่มของโหนด เพื่อให้โหนดต่างๆ สามารถสื่อสารกันได้อย่างง่ายดาย
- โหนดผู้ประสานงานคือโหนดที่รับคำขอจากไคลเอ็นต์และสื่อสารกับโหนดจำลองในนามของไคลเอ็นต์นั้น โหนดใดก็ได้สามารถทำหน้าที่เป็นผู้ประสานงานสำหรับคำขอใดๆ ก็ได้
ฉากกั้นห้อง
ตัวแบ่งพาร์ติชันจะกำหนดว่าข้อมูลควรถูกกระจายอย่างไรบนคลัสเตอร์ ตัวแบ่งพาร์ติชันใช้ฟังก์ชันแฮชเพื่อกระจายข้อมูลบนคลัสเตอร์ โดยใช้คีย์พาร์ติชันเพื่อคำนวณแฮช แฮชดังกล่าวเรียกว่า โทเค็น- ข้อมูลถูกกระจายบนพื้นฐานของโทเค็นนี้
ตัวแบ่งพาร์ติชันเริ่มต้นคือ Murmur3Partitioner ซึ่งสร้างโทเค็นที่กระจายอย่างสม่ำเสมอในช่วงคงที่ โหนดแต่ละโหนดเป็นเจ้าของช่วงหนึ่งช่วงขึ้นไป และกลุ่มของช่วงเหล่านั้นจะประกอบกันเป็น แหวนโทเค็นเนื่องจากการกำหนดค่าใช้ค่าแฮชแทนค่าจริง การเพิ่มโหนดจึงเปลี่ยนแปลงเฉพาะช่วงข้อมูลที่โหนดนั้นครอบคลุมเท่านั้น ไม่ใช่การสลับลำดับข้อมูลทั้งหมดใหม่
ข้อกำหนดเบื้องต้นสำหรับ Cassandra Cluster
มีข้อกำหนดสำหรับการตั้งค่าคลัสเตอร์ดังต่อไปนี้
- คุณควรมีเครื่องหลายเครื่อง ไม่ว่าจะเป็นเครื่องจริงหรือเครื่องเสมือน เพื่อทำหน้าที่เป็นโหนด
- โหนดต่างๆ ต้องสามารถติดต่อกันได้บนเครือข่าย พอร์ต 7000 สำหรับการรับส่งข้อมูลระหว่างโหนด พอร์ต 7001 หากเปิดใช้งาน TLS และพอร์ต 9042 สำหรับการเชื่อมต่อจากไคลเอ็นต์จะต้องเปิดอยู่ระหว่างกัน
- ควรติดตั้ง Linux บนแต่ละโหนด เนื่องจากเป็นแพลตฟอร์ม Cassandra ได้รับการทดสอบและรองรับบนแพลตฟอร์มดังกล่าว
- Apache Cassandra ต้องติดตั้งบนทุกโหนดในเวอร์ชันเดียวกัน เวอร์ชันที่แตกต่างกันจะไม่สามารถทำให้ข้อตกลงเกี่ยวกับโครงสร้างข้อมูลเสร็จสมบูรณ์ได้
- ที่ได้รับการสนับสนุน JDK ต้องติดตั้งบนเครื่องแต่ละเครื่อง โดยต้องตั้งค่า JAVA_HOME ด้วย
- นาฬิกาต้องซิงโครไนซ์กับ NTP (เวลามาตรฐานสุทธิ) Cassandra แก้ไขปัญหาการเขียนข้อมูลที่ขัดแย้งกันโดยใช้การประทับเวลา ดังนั้นการคลาดเคลื่อนของนาฬิกาจึงส่งผลให้เกิดผลลัพธ์ที่ไม่ถูกต้องโดยไม่แจ้งให้ทราบล่วงหน้า
ข้อกำหนดสุดท้ายเป็นข้อที่มักถูกมองข้ามมากที่สุด และเป็นสาเหตุของปัญหาข้อมูลมากกว่าความล้มเหลวในการเริ่มต้นระบบ
.
วิธีการติดตั้ง Cassandra Cluster บน Linux
Cassandra ต้องติดตั้งโปรแกรมนี้บนเครื่องแต่ละเครื่องก่อนจึงจะสามารถเข้าร่วมคลัสเตอร์ได้ ภาพหน้าจอต่อไปนี้มาจากโปรแกรมติดตั้งแบบกราฟิกของ DataStax Enterprise ซึ่งเป็นวิธีการที่ใช้กันทั่วไปในขณะที่เขียนคู่มือนี้ โปรแกรมติดตั้งนั้นไม่ได้เผยแพร่ให้ใช้งานในชุมชนอีกต่อไปแล้ว ดังนั้นจึงแสดงวิธีการปัจจุบันก่อน และตามด้วยวิซาร์ดเพื่อเป็นข้อมูลอ้างอิง
วิธีการปัจจุบัน: ติดตั้ง Apache Cassandra สร้างแพ็กเกจหรือไฟล์ไบนารีแบบ tarball บนทุกโหนดในลักษณะเดียวกัน จากนั้นตรวจสอบว่าแต่ละโหนดเริ่มต้นทำงานได้เองก่อนที่จะพยายามรวมโหนดเหล่านั้นเข้าด้วยกัน
tar -xzf apache-cassandra-x.y.z-bin.tar.gz -C /opt/
export CASSANDRA_HOME=/opt/apache-cassandra-x.y.z
$CASSANDRA_HOME/bin/cassandra -f
เมื่อโหนดใดโหนดหนึ่งเริ่มต้นทำงานได้อย่างราบรื่นแล้ว ให้หยุดโหนดนั้น ล้างไดเร็กทอรีข้อมูล และดำเนินการต่อในส่วนการกำหนดค่าคลัสเตอร์ด้านล่าง
ขั้นตอน 1) เรียกใช้ Cassandra การตั้งค่าเวอร์ชันสำหรับองค์กร บน ลินุกซ์ ใช้เทอร์มินัล เรียกใช้โปรแกรมติดตั้ง หน้าต่อไปนี้จะปรากฏขึ้น

หน้านี้ไม่ได้ให้ข้อมูลที่จำเป็นใดๆ มันแค่ให้ข้อมูลเกี่ยวกับ Cassandra รุ่น ผ่านหน้านี้แล้วกดปุ่มถัดไป
ขั้นตอน 2) ยอมรับข้อตกลงใบอนุญาต หลังจากกดปุ่มถัดไป หน้าต่อไปนี้จะปรากฏขึ้น

หน้านี้ให้ข้อมูลเกี่ยวกับแพ็คเกจและแพ็คเกจย่อยใน Cassandra โปรแกรมจะถูกติดตั้ง ด้านล่างจะมีข้อความแจ้งเกี่ยวกับข้อตกลงใบอนุญาต โปรดทำเครื่องหมายในช่อง "ฉันยอมรับข้อตกลง" แล้วกดปุ่มถัดไป
ขั้นตอน 3) ติดตั้ง Builder แล้วคลิกถัดไป หลังจากกดปุ่มถัดไป คุณจะเห็นหน้าต่อไปนี้

หน้านี้ถามคุณเกี่ยวกับตัวเลือกการติดตั้ง
- ก่อนอื่นมันจะถามถึงไดเร็กทอรีการติดตั้ง โดยค่าเริ่มต้น จะมีการติดตั้งไว้ในโฮมไดเร็กตอรี่
- ต่อไปจะถามถึงประเภทการติดตั้ง เลือก Simple Install
- ต่อไปจะถามเกี่ยวกับระบบอัพเดต ให้ตรวจสอบว่า 'ไม่'
- ถัดไป ระบบจะถามถึงอินเทอร์เฟซเริ่มต้น มีสองตัวเลือก คุณสามารถติดตั้งบน localhost หรือเลือกที่อยู่ IP เลือกที่อยู่ IP สำหรับการติดตั้ง
- กดปุ่มถัดไป
ขั้นตอน 4) ตั้งค่าโหนดแล้วคลิกถัดไป หลังจากกดปุ่มถัดไป หน้าต่อไปนี้จะปรากฏขึ้น

หน้านี้ถามเกี่ยวกับการตั้งค่าโหนด
- ขั้นแรก ให้เลือกประเภทโหนด 'Cassandra โหนด'
- ขั้นต่อไป ในชื่อริง ให้ใส่ชื่อคลัสเตอร์ของคุณ Cluster ชื่อควรเหมือนกันสำหรับโหนดทั้งหมดในคลัสเตอร์เดียวกัน
- ถัดไป ให้เลือก Seed Seed คือโหนดที่โหนดอื่นๆ ที่ไม่ใช่ Seed จะติดต่อเมื่อเริ่มต้นการทำงาน
- หลังจากให้ข้อมูลนี้แล้วให้กดปุ่มถัดไป
ขั้นตอน 5) ติดตั้งเอเจนต์ตรวจสอบ หลังจากกดปุ่มถัดไป หน้าต่อไปนี้จะปรากฏขึ้น หน้านี้จะขอที่อยู่ IP ที่ต้องการติดตั้งเอเจนต์
- จำเป็นต้องใช้เอเจนต์สำหรับคอนโซลตรวจสอบ ซึ่งสามารถตรวจสอบโหนดทั้งหมดได้จากที่เดียว
- หลังจากให้ข้อมูลนี้แล้ว ให้กดปุ่มถัดไป

ขั้นตอน 6) กดถัดไปเพื่อเริ่มการติดตั้ง หลังจากกดปุ่มถัดไปแล้ว หน้าต่อไปนี้จะปรากฏขึ้น

ตอนนี้การตั้งค่าพร้อมที่จะติดตั้งแล้ว กดปุ่มถัดไป
ขั้นตอน 7) รอจนกว่ากระบวนการติดตั้งจะเสร็จสมบูรณ์ หลังจากกดปุ่มถัดไป หน้าต่อไปนี้จะปรากฏขึ้น
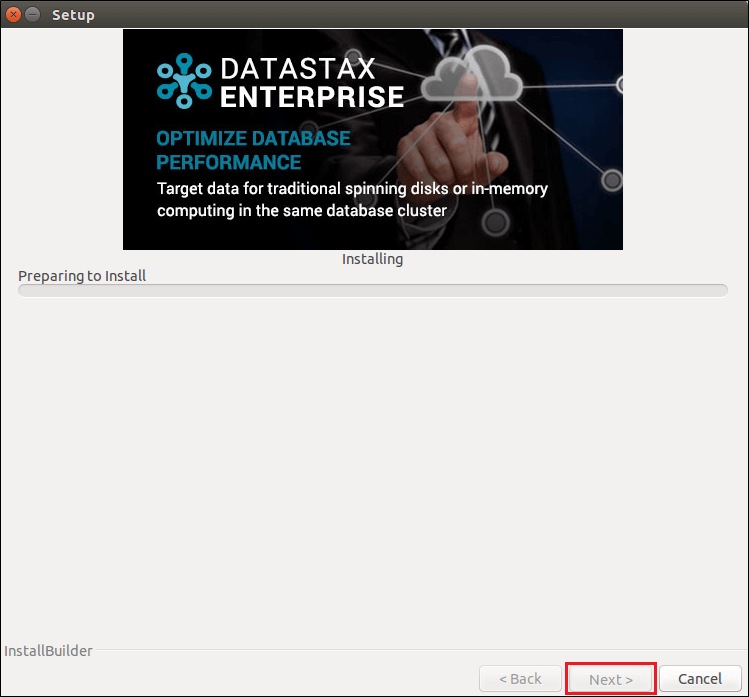
โปรแกรมจะเริ่มทำการติดตั้ง
ขั้นตอน 8) คลิกที่ปุ่มเสร็จสิ้น (Finish) หลังจากการติดตั้งเสร็จสิ้น หน้าต่อไปนี้จะปรากฏขึ้น ในหน้าเดียวกันนี้ คุณจะเห็นเครื่องหมายถูกสำหรับตัวเลือกที่ปรากฏโดยค่าเริ่มต้น

การกำหนดค่าไฟล์ cassandra.yaml เพื่อเชื่อมต่อโหนด
การติดตั้งเพียงอย่างเดียวไม่ได้สร้างคลัสเตอร์ โหนดจะค้นหากันได้ก็ต่อเมื่อการตั้งค่าสี่อย่างในไฟล์ cassandra.yaml ตรงกัน และไฟล์นี้เป็นจุดที่การตั้งค่าคลัสเตอร์ส่วนใหญ่ผิดพลาด
cluster_name: 'Guru99 Cluster'
seed_provider:
  - class_name: org.apache.cassandra.locator.SimpleSeedProvider
    parameters:
      - seeds: "192.168.1.10,192.168.1.11"
listen_address: 192.168.1.10
rpc_address: 0.0.0.0
broadcast_rpc_address: 192.168.1.10
endpoint_snitch: GossipingPropertyFileSnitch
- ชื่อคลัสเตอร์ ข้อมูลต้องตรงกันในทุกโหนด ความไม่ตรงกันเป็นสาเหตุที่พบบ่อยที่สุดที่ทำให้โหนดปฏิเสธการเข้าร่วม
- เมล็ด แสดงรายการจุดติดต่อที่โหนดเริ่มต้นใช้ในการสื่อสาร การมี seed สองหรือสามโหนดต่อศูนย์ข้อมูลก็เพียงพอแล้ว การทำให้ทุกโหนดเป็น seed จะป้องกันการบูตอัตโนมัติping.
- ที่อยู่ฟัง คือที่อยู่ซึ่งโหนดอื่นๆ ใช้เพื่อเข้าถึงโหนดนี้ ต้องเป็นที่อยู่จริงที่สามารถเข้าถึงได้ด้วยการกำหนดเส้นทาง ไม่ใช่ localhost เด็ดขาด
- เอนด์พอยต์_สนิทช์ บอก Cassandra การจัดวางแร็คและศูนย์ข้อมูล กอสซี่pingโดยทั่วไปแล้ว PropertyFileSnitch จะเป็นตัวเลือกที่ใช้กัน โดยกำหนดค่าต่างๆ ไว้ในไฟล์ cassandra-rackdc.properties
การเปลี่ยนชื่อ snitch หรือ cluster หลังจากที่มีข้อมูลอยู่แล้ว จำเป็นต้องมีขั้นตอนเพิ่มเติม ดังนั้นจึงควรตัดสินใจทั้งสองอย่างก่อนที่โหนดแรกจะเริ่มทำงาน
ที่เริ่มต้น Cassandra โหนด
หลังจากการติดตั้ง Cassandra บนแต่ละโหนด ให้เริ่มเซิร์ฟเวอร์และทำตามขั้นตอนด้านล่าง ลำดับมีความสำคัญ: เริ่มโหนดเริ่มต้นก่อนทีละโหนด โดยรอให้แต่ละโหนดรายงานสถานะว่าพร้อมใช้งานก่อนจึงจะเริ่มโหนดถัดไป การเริ่มหลายโหนดพร้อมกันอาจทำให้เกิดข้อขัดแย้งเกี่ยวกับช่วงโทเค็นได้
ขั้นตอน 1) ไปที่ Cassandra ระบุไดเร็กทอรีการติดตั้งและเริ่มเซิร์ฟเวอร์
bin/cassandra -f

เมื่อดำเนินการคำสั่งนี้แล้ว Cassandra เซิร์ฟเวอร์จะเริ่มทำงาน นี่คือภาพหน้าจอที่แสดง... Cassandra เซิร์ฟเวอร์กำลังเริ่มต้นทำงาน
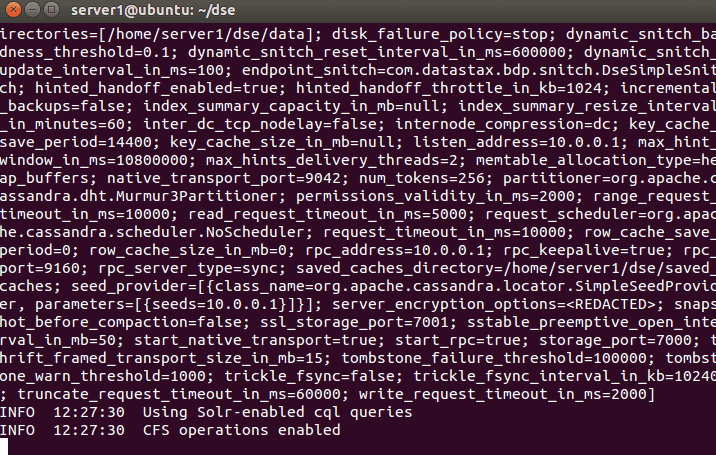
หลังจากนั้นประมาณหนึ่งนาที เซิร์ฟเวอร์จะเริ่มทำงาน เริ่มเซิร์ฟเวอร์แต่ละโหนดทีละตัว เมื่อเริ่มเซิร์ฟเวอร์ทุกโหนดเสร็จแล้ว Cassandra คลัสเตอร์พร้อมใช้งานแล้ว
ขั้นตอน 2) ตรวจสอบว่าทุกโหนดเข้าร่วมแล้วโดยการตรวจสอบวงแหวนจากโหนดใดโหนดหนึ่ง
nodetool status
nodetool describecluster
โหนดทุกโหนดควรแสดงสถานะ UNซึ่งหมายถึงสถานะ Up และ Normal และคอลัมน์ Owns ควรแสดงเปอร์เซ็นต์ที่ใกล้เคียงกัน เวอร์ชันสคีมาเดียวในผลลัพธ์ describecluster ยืนยันว่าโหนดทั้งหมดเห็นพ้องต้องกันในสคีมานั้น
อาการหลักๆ สามอย่างครอบคลุมความล้มเหลวส่วนใหญ่ โหนดที่ไม่ปรากฏขึ้นเลยมักจะมี cluster_name ไม่ตรงกันหรือพอร์ต 7000 ถูกบล็อก โหนดที่ค้างอยู่ที่... UJการเข้าร่วมยังคงเป็นการสตรีมข้อมูลและต้องการเวลาบนคลัสเตอร์ขนาดใหญ่เท่านั้น การกระจายความเป็นเจ้าของที่ไม่เท่าเทียมกันอย่างมากบ่งชี้ถึงการตั้งค่าที่ไม่ถูกต้อง โดยที่โหนดถูกวางไว้ในแร็คหรือศูนย์ข้อมูลที่ไม่ถูกต้อง
เมื่อวงแหวนทำงานได้อย่างมีประสิทธิภาพ การตั้งค่าการจำลองข้อมูลสำหรับแต่ละคีย์สเปซจะเป็นตัวกำหนดวิธีการกระจายข้อมูลไปทั่วคีย์สเปซ ดังที่ได้อธิบายไว้ใน Cassandra คีย์สเปซ บทช่วยสอนและ Cassandra สถาปัตยกรรม ทำให้พังถล่ม.
