
Диаграмма рассеяния в R с использованием ggplot2 и примером.
 Эвелин Кларк
⚡ Умное резюме
В R с помощью библиотеки ggplot2 можно построить диаграмму рассеяния, которая отображает две непрерывные переменные на оси x и y с помощью функции geom_point(). В этом пошаговом руководстве рассматриваются следующие задачи:ping с помощью цвета, логарифмических преобразований, построенных линий регрессии, меток, разбиения на категории, исправления наложений, масштабов, тем и сохранения.
Почему графики важны в анализе данных
Графики — это третья часть процесса анализа данных. Первая часть посвящена данные extracпроизводство, вторая часть посвящена очистка и манипулирование данными. Наконец, специалисту по данным, возможно, придется представить свои результаты графически.
Рабочий процесс специалиста по анализу данных представлен на рисунке ниже.
- Первая задача специалиста по данным — определить вопрос исследования. Данный исследовательский вопрос зависит от целей и задач проекта.
- После этого одной из наиболее важных задач является разработка функций. Специалисту по данным необходимо собирать, манипулировать и очищать данные.
- Когда этот шаг будет завершен, он сможет приступить к исследованию набора данных. Иногда необходимо уточнить и изменить исходную гипотезу в связи с новым открытием.

- Когда пояснительная анализ достигнут, специалист по данным должен учитывать способность читателя понять основные концепции и модели.
- Его результаты должны быть представлены в формате, понятном всем заинтересованным сторонам. Один из лучших способов общаться результаты через график.
- Графики — невероятный инструмент для упрощения сложного анализа.
В оставшейся части этого руководства мы построим эти графики с помощью пакета ggplot2.
Пакет ggplot2
В этом руководстве рассматривается построение диаграмм в R с помощью библиотеки ggplot2.
В этом уроке вы будете использовать пакет ggplot2. Этот пакет реализует грамматику графики, описанную Леландом Уилкинсоном в 2005 году. ggplot2 — гибкий пакет, поставляется со множеством тем и позволяет задавать параметры графика на высоком уровне абстрактного представления.tracОбратите внимание, что он не создает трехмерную или интерактивную графику; для этого требуются такие пакеты, как plotly или rgl.
В ggplot2 график состоит из следующих аргументов:
- данным
- эстетическая картаping
- геометрический объект
- статистические преобразования
- Весы
- система координат
- корректировка положения
- огранка
В этом уроке вы узнаете, как контролировать эти аргументы.
Основной синтаксис ggplot2:
ggplot(data, mapping=aes()) +
geometric object

arguments:
data: Dataset used to plot the graph
mapping: Control the x and y-axis
geometric object: The type of plot you want to show. The most common object are:

- Point: `geom_point()`
- Bar: `geom_bar()`
- Line: `geom_line()`
- Histogram: `geom_histogram()`
Как создать диаграмму рассеяния в R
Давайте посмотрим, как ggplot работает с набором данных mtcars. Вы начинаете с построения диаграммы рассеяния переменных mpg и drat.
Базовый график рассеяния
library(ggplot2)
ggplot(mtcars, aes(x = drat, y = mpg)) +
    geom_point()
Code объяснение
- Сначала вы передаете набор данных mtcars в ggplot.
- Внутри аргумента aes() вы добавляете оси X и Y.
- Знак + означает, что вы хотите, чтобы R продолжал читать код. Это делает код более читабельным, если его взломать.
- Используйте geom_point() для геометрического объекта.
Выход:

График рассеяния с группами
Иногда может быть интересно различать значения по группе данных (т. е. данных на уровне факторов).
ggplot(mtcars, aes(x = mpg, y = drat)) +
    geom_point(aes(color = factor(gear)))
Code объяснение
- Функция aes() внутри geom_point() управляет цветом каждой группы. Группаping Переменная должна быть фактором, поэтому шестерня заключена в функцию factor().
- В целом у вас есть код aes(color = Factor(gear)), который меняет цвет точек.
Выход:

Изменение масштаба оси с помощью логарифмического преобразования
Изменение масштаба данных составляет значительную часть работы аналитика, поскольку исходные переменные редко имеют четкую колоколообразную форму. Логарифмирование — один из способов сжать экстремальные значения и сделать график менее чувствительным к выбросам.
ggplot(mtcars, aes(x = log(mpg), y = log(drat))) +
    geom_point(aes(color = factor(gear)))
Code объяснение
- Вы преобразуете переменные x и y в функции log() непосредственно внутри функции aes() map.ping.
Обратите внимание, что можно применить любое другое преобразование, например стандартизацию или нормализацию.
Выход:

Диаграмма рассеяния с подобранными значениями
Вы можете добавить на график дополнительный уровень информации. Вы можете наложить на него подобранные значения. линейная регрессия.
my_graph <- ggplot(mtcars, aes(x = log(mpg), y = log(drat))) +
    geom_point(aes(color = factor(gear))) +
    stat_smooth(method = "lm",
        col = "#C42126",
        se = FALSE,
        size = 1)
my_graph
Code объяснение
- my_graph: график хранится в объекте my_graph, поэтому на последующих этапах можно добавлять слои без повторения всего вызова.
- Аргумент stat_smooth() управляет методом сглаживания.
- метод = «lm»: линейная регрессия
- col = “#C42126”: Code для красного цвета линии
- se = FALSE: не отображать стандартную ошибку.
- size = 1: толщина линии. В ggplot2 версии 3.4.0 и более поздних версиях этот аргумент был переименован в linewidth для линейных геометрических объектов.
Выход:

Обратите внимание, что доступны и другие методы сглаживания.
- GLM
- гам
- loess: значение по умолчанию для количества наблюдений менее 1,000.
- rlm: устойчивая линейная модель из пакета MASS.
Прежде чем оформлять диаграмму, стоит понять, когда вообще целесообразно использовать точечную диаграмму.
Диаграмма рассеяния против линейного графика против BubblДиаграмма в R
На всех трех графиках показаны две непрерывные переменные в сравнении друг с другом, поэтому выбор сводится к тому, какой вывод должен сделать читатель.
| Критерии | Точечная диаграмма | График линия | Bubblэлектронная диаграмма |
|---|---|---|---|
| Шоу | Корреляция между двумя переменными | Изменение одной переменной по упорядоченной оси | Корреляция плюс третья величина |
| Ось X | Любая непрерывная переменная | Обычно это временная или другая упорядоченная шкала. | Любая непрерывная переменная |
| Пункт заказа | Ненужные | Ключевые точки взаимосвязаны. | Ненужные |
| Третья переменная | По цвету или форме | По отдельным линиям | Размер точки |
| вызов ggplot2 | geom_point() | geom_line() | geom_point(aes(size = z)) |
Соединение точек на графике линией, когда ось X не имеет естественного порядка, — распространённая ошибка: это подразумевает последовательность, которой не существует. Используйте функцию geom_line() только для упорядоченных осей, таких как даты. Для распределений одной переменной используйте... сюжет .
Добавьте информацию в график
Пока что графики не содержат пояснительного текста. Читатель должен понимать суть данных, глядя только на график, без обращения к дополнительной документации, а это значит, что графику необходимы хорошие подписи. Подписи можно добавить с помощью функции labs().
Базовый синтаксис функции labs() выглядит следующим образом:
labs(title = "Hello Guru99")
arguments:
- title: Main title displayed above the plot
- subtitle: Secondary line below the title
- caption: Note below the plot, usually the data source
- x: Rename the x-axis
- y: Rename the y-axis
- color / fill: Rename the legend

Example: labs(title = "Hello Guru99", subtitle = "My first plot")
Добавить заголовок
Очевидно, что одна обязательная информация, которую следует добавить, — это заголовок.
my_graph +
    labs(
        title = "Plot Mile per hours and drat, in log"
         )
Code объяснение
- my_graph: вы используете сохраненный график. Это позволяет избежать переписывания всех кодов каждый раз, когда вы добавляете новую информацию в график.
- Заголовок нужно заключить в функцию `labs()`.
Выход:

Добавить заголовок с динамическим именем
Динамический заголовок полезен для добавления более точной информации в заголовок.
Вы можете использовать функцию Paste() для печати статического и динамического текста. Основной синтаксис Paste():
paste("This is a text", A)
arguments
- " ": Text inside the quotation marks are the static text
- A: Display the variable stored in A
- Note you can add as much static text and variable as you want. You need to separate them with a comma
Пример:
A <- 2010
paste("The first year is", A)
Выход:
## [1] "The first year is 2010"
B <- 2018
paste("The first year is", A, "and the last year is", B)
Выход:
## [1] "The first year is 2010 and the last year is 2018"
Вы можете добавить к нашему графику динамическое имя, а именно: среднее значение расхода миль на галлон.
mean_mpg <- mean(mtcars$mpg)
my_graph + labs(
    title = paste("Plot Mile per hours and drat, in log. Average mpg is", mean_mpg)
)
Code объяснение
- Вы создаете среднее значение миль на галлон, используя среднее значение (mtcars$mpg), хранящееся в переменнойmean_mpg.
- Вы используете метод Paste() с помощью функции «Mean_mpg», чтобы создать динамический заголовок, возвращающий среднее значение миль на галлон.
Выход:

Добавить подзаголовок
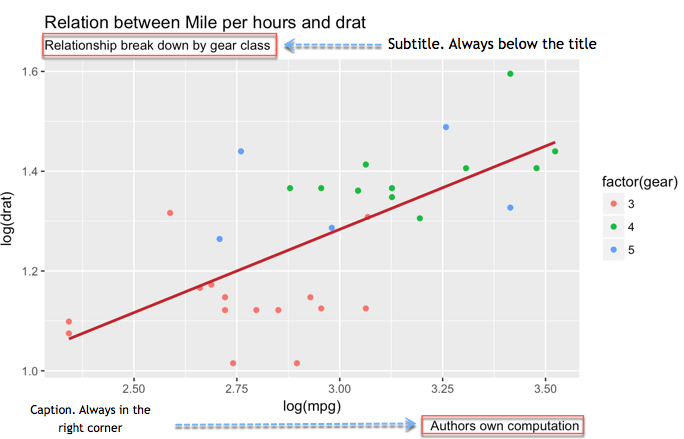
Две дополнительные детали делают график более наглядным. Вы говорите о подзаголовке и подписи. Подзаголовок располагается прямо под заголовком. Подпись может сообщать, кто выполнил вычисления и из какого источника данных.
my_graph +
    labs(
        title =
        "Relation between Mile per hours and drat",
        subtitle =
        "Relationship break down by gear class",
        caption = "Authors own computation"
    )
Code объяснение
- Внутри функции labs() вы добавили:
- title = «Связь между милями в час и дратом»: Добавить заголовок
- subtitle = «Отношения по классам снаряжения»: Добавить подзаголовок
- caption = «Вычисления принадлежат авторам: Добавить подпись»
- Каждую новую информацию вы отделяете запятой, ,
- Обратите внимание, что вы нарушаете строки кода. Это не является обязательным и лишь помогает легче читать код.
Выход:
Переименуйте оси X и Y.
Названия столбцов редко бывают готовы к отображению на графике. Часто они сокращаются или содержат подчеркивания между словами, как, например, GDP_CAP. Переименуйте их на графике и добавьте единицы измерения там, где это важно.
my_graph +
    labs(
        x = "Drat definition",
        y = "Mile per hours",
        color = "Gear",
        title = "Relation between Mile per hours and drat",
        subtitle = "Relationship break down by gear class",
        caption = "Authors own computation"
    )
Code объяснение
- Внутри функции labs() вы добавили:
- x = «Определение проекта»: измените имя оси X.
- y = «Миль в час»: измените имя оси Y.
Выход:

Контролируйте весы
Вы можете контролировать масштаб оси.
Функция seq() удобна, когда вам нужно создать числовую последовательность. Основной синтаксис:
seq(begin, last, by = x)
arguments:
- begin: First number of the sequence
- last: Last number of the sequence
- by= x: The step. For instance, if x is 2, the code adds 2 to `begin-1` until it reaches `last`
Например, диапазон от 0 до 12 с шагом 4 возвращает четыре числа: 0, 4, 8 и 12.
seq(0, 12,4)
Выход:
## [1] 0 4 8 12
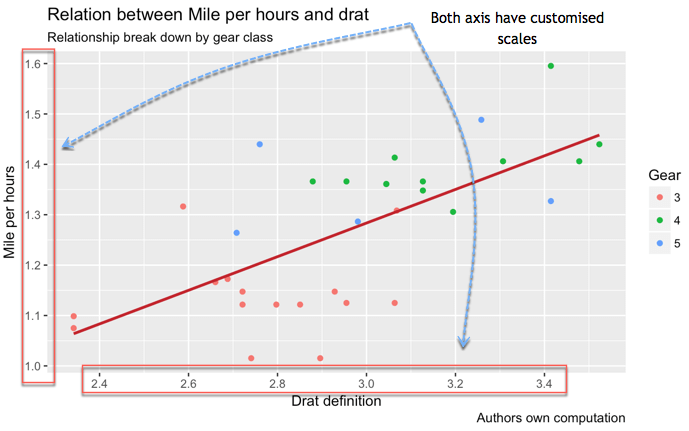
Вы можете контролировать масштаб осей X и Y, как показано ниже.
my_graph +
    scale_x_continuous(breaks = seq(1, 3.6, by = 0.2)) +
    scale_y_continuous(breaks = seq(1, 1.6, by = 0.1)) +
    labs(
        x = "Drat definition",
        y = "Mile per hours",
        color = "Gear",
        title = "Relation between Mile per hours and drat",
        subtitle = "Relationship break down by gear class",
        caption = "Authors own computation"
    )
Code объяснение
- Функция Scale_y_continious() управляет оси
- Функция Scale_x_continious() управляет Ось х.
- Параметр Breaks управляет разделением оси. Вы можете добавить последовательность чисел вручную или использовать функцию seq():
- seq(1, 3.6, by = 0.2): Создайте последовательность от 1 до 3.6 с шагом 0.2, то есть 14 точек разрыва.
- seq(1, 1.6, by = 0.1): Создает семь чисел от 1 до 1.6 с шагом 0.1
Выход:
Варианты
Наконец, ggplot2 позволяет изменить стиль всего графика с помощью одной функции темы. В пакет входят восемь полных тем оформления:
- theme_bw()
- theme_light()
- theme_classic()
- theme_linedraw()
- theme_dark()
- theme_minimal()
- theme_gray()
- theme_void()
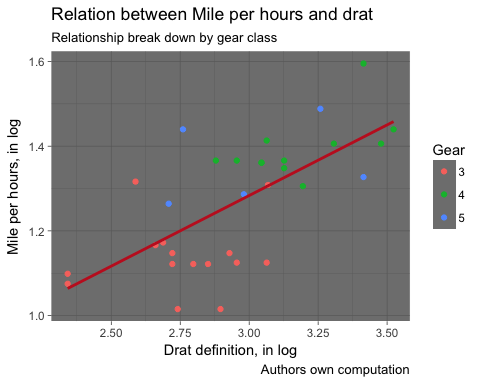
my_graph +
    theme_dark() +
    labs(
        x = "Drat definition, in log",
        y = "Mile per hours, in log",
        color = "Gear",
        title = "Relation between Mile per hours and drat",
        subtitle = "Relationship break down by gear class",
        caption = "Authors own computation"
    )
Выход:

Сохранить графики
После выполнения всех этих шагов пришло время сохранить и поделиться графиком. Вызовите функцию ggsave(“name_of_the_file.png”) сразу после построения графика, и изображение будет записано на диск.
График сохраняется в рабочем каталоге. Чтобы проверить рабочий каталог, вы можете запустить этот код:
directory <- getwd()
directory
Постройте готовый график, сохраните его и проверьте, какое значение он показал:
my_graph +
    theme_dark() +
    labs(
        x = "Drat definition, in log",
        y = "Mile per hours, in log",
        color = "Gear",
        title = "Relation between Mile per hours and drat",
        subtitle = "Relationship break down by gear class",
        caption = "Authors own computation"
    )
Выход:
ggsave("my_fantastic_plot.png")
Выход:
## Saving 5 x 4 in image
Внимание: Исключительно в педагогических целях мы создали функцию open_folder(), которая открывает вам папку каталога. Вам просто нужно запустить приведенный ниже код и посмотреть, где хранится изображение. Вы должны увидеть имя файла my_fantastic_plot.png.
# Run this code to create the function
open_folder <- function(dir) {
    if (.Platform['OS.type'] == "windows") {
        shell.exec(dir)
    } else {
        system(paste(Sys.getenv("R_BROWSER"), dir))
    }
}

# Call the function to open the folder
open_folder(directory)
Как создать многогранные диаграммы рассеяния в R с помощью функции facet_wrap()
Фасетирование — один из восьми компонентов ggplot2, перечисленных ранее, и это наиболее удобное решение для диаграмм, перегруженных данными. Вместо того чтобы сжимать все группы в одну панель, ggplot2 отображает небольшую кратную панель для каждого уровня переменной, причем все панели находятся в одном масштабе, что позволяет сохранять их сопоставимость.
# One panel per gear count
ggplot(mtcars, aes(x = drat, y = mpg)) +
    geom_point() +
    facet_wrap(~ gear) +
    theme_classic()
Большую часть работы выполняют три аргумента.
- нкол or Nrow: принудительно расположить панели в заданном порядке, например, facet_wrap(~ gear, ncol = 2).
- ВесыПо умолчанию используется значение «fixed», поэтому все панели используют один диапазон оси. Используйте «free_y» или «free», если группы сильно различаются по величине, но имейте в виду, что свободные шкалы делают визуальное сравнение между панелями некорректным.
- этикетировочные: заменяет исходный уровень фактора в каждой полосе, например, labeller = label_both, чтобы вывести «gear: 4» вместо «4».
Две группыping переменные. Используйте функцию facet_grid() для построения матрицы панелей, где первая переменная распределена по строкам, а вторая — по столбцам:
ggplot(mtcars, aes(x = drat, y = mpg)) +
    geom_point(aes(color = factor(cyl))) +
    facet_grid(am ~ gear) +
    theme_classic()
Грани или цвета? Цветовое разбиение хорошо работает примерно до четырех групп на диаграмме с ограниченным перекрытием. При большем количестве групп или при сильном перекрытии, разбиение на панели упрощает чтение, поскольку каждая панель содержит только свои собственные точки. Можно комбинировать оба подхода: разбиение на панели по одной переменной и цветовое разбиение по другой, как в примере с функцией facet_grid() выше.
Как справиться с наложением точек на диаграмме рассеяния в R
При нескольких десятках наблюдений каждая точка видна. При тысячах маркеров они накладываются друг на друга, и наиболее плотная область выглядит просто как сплошное пятно. чрезмерное заговор, а ggplot2 предлагает четыре стандартных решения.
1. Уменьшите непрозрачность. Самое дешевое решение. Перекрытие.ping Точки естественным образом темнеют, поэтому становится видна плотность:
ggplot(diamonds, aes(x = carat, y = price)) +
    geom_point(alpha = 0.05) +
    theme_classic()
2. Дискретные значения дрожания. Когда переменная принимает лишь несколько значений, точки располагаются на одних и тех же координатах. Их разделяет небольшое случайное смещение:
ggplot(mtcars, aes(x = factor(cyl), y = mpg)) +
    geom_jitter(width = 0.15, height = 0) +
    theme_classic()
Установите высоту равной 0, чтобы значения по оси Y, несущие реальную информацию, никогда не изменялись.
3. Выбросить самолет в мусорный контейнер. Для больших наборов данных подсчитайте количество наблюдений в каждой ячейке и сопоставьте это число с цветом. Шестиугольные ячейки позволяют избежать визуальных артефактов, которые возникают при использовании квадратных ячеек:
ggplot(diamonds, aes(x = carat, y = price)) +
    geom_hex(bins = 40) +
    theme_classic()
4. Нарисуйте контуры плотности. Контурные линии обозначают области, где сосредоточены наблюдения, и аккуратно накладываются на размытые точки:
ggplot(diamonds, aes(x = carat, y = price)) +
    geom_point(alpha = 0.05) +
    geom_density_2d(color = "#C42126") +
    theme_classic()
Как правило, альфа-канал обрабатывает несколько тысяч точек, гексагональное биннинговое разбиение — десятки тысяч, а выборка данных с помощью dplyr::slice_sample() является прагматичным вариантом при большем количестве точек.
Диаграмма рассеяния в R: Code Референции
В таблице ниже приведен список вызовов ggplot2 для каждого из описанных выше параметров:
| Цель | Code |
|---|---|
| Базовый график рассеяния |
ggplot(df, aes(x = x1, y = y)) + geom_point() |
| Диаграмма рассеяния с цветовой группой |
ggplot(df, aes(x = x1, y = y)) + geom_point(aes(color = factor(x2))) |
| Добавить подобранные значения |
ggplot(df, aes(x = x1, y = y)) + geom_point() + stat_smooth(method = "lm") |
| Добавить заголовок |
ggplot(df, aes(x = x1, y = y)) + geom_point() + labs(title = paste("Hello Guru99")) |
| Добавить субтитры |
ggplot(df, aes(x = x1, y = y)) + geom_point() + labs(subtitle = paste("Hello Guru99")) |
| Переименовать х |
ggplot(df, aes(x = x1, y = y)) + geom_point() + labs(x = "X1") |
| Переименовать y |
ggplot(df, aes(x = x1, y = y)) + geom_point() + labs(y = "y1") |
| Контролируйте масштаб |
ggplot(df, aes(x = x1, y = y)) + geom_point() + scale_y_continuous(breaks = seq(10, 35, by = 10)) + scale_x_continuous(breaks = seq(2, 5, by = 1)) |
| Создание журналов |
ggplot(df, aes(x = log(x1), y = log(y))) + geom_point() |
| Варианты |
ggplot(df, aes(x = x1, y = y)) + geom_point() + theme_classic() |
| Аспект, определяемый группой |
ggplot(df, aes(x = x1, y = y)) + geom_point() + facet_wrap(~ x2) |
| Обработка наложения графиков |
ggplot(df, aes(x = x1, y = y)) + geom_point(alpha = 0.3) |
| Сохранено |
ggsave("my_fantastic_plot.png")
|
