
K-средних ClusterПрограммирование на языке R с примерами
 Эвелин Кларк
⚡ Умное резюме
K-средних ClusterВ R группы наблюдений формируются путем минимизации расстояния между каждой точкой и центром ее кластера. В этом пошаговом руководстве стандартизируется набор данных о ценах на компьютеры, анимируется алгоритм, находится оптимальное значение k с помощью метода «локтя» и отображаются кластеры в виде тепловой карты.

Что такое Cluster анализ?
Cluster анализ относится к неконтролируемое обучение. Кластер — это группа данных, имеющих схожие характеристики. Можно сказать, что кластерный анализ — это скорее открытие, чем предсказание. Машина ищет сходство в данных. Например, вы можете использовать кластерный анализ для следующего приложения:
- Сегментация клиентов: ищет сходство между группами клиентов.
- Кластеризация фондового рынка: групповые акции на основе результатов
- Уменьшение размерности набора данных путем группировкиping наблюдения со схожими значениями
ClusterТакой анализ не так уж и сложен в реализации, он имеет смысл и полезен для бизнеса.
Самая разительная разница между обучением с учителем и без учителя заключается в результатах. Обучение без учителя создает новую переменную — метку, а обучение с учителем предсказывает результат. Машина помогает практикующему специалисту маркировать данные на основе тесной связи. Аналитик должен использовать группы и дать им названия.
Давайте приведем пример, чтобы понять концепцию кластеризации. Для простоты мы работаем в двух измерениях. У вас есть данные об общих расходах клиентов и их возрасте. Чтобы улучшить рекламу, маркетинговая команда хочет отправлять своим клиентам более целевые электронные письма.
На следующем графике показаны общие расходы и возраст клиентов.
library(ggplot2)
df <- data.frame(age = c(18, 21, 22, 24, 26, 26, 27, 30, 31, 35, 39, 40, 41, 42, 44, 46, 47, 48, 49, 54),
    spend = c(10, 11, 22, 15, 12, 13, 14, 33, 39, 37, 44, 27, 29, 20, 28, 21, 30, 31, 23, 24)
)
ggplot(df, aes(x = age, y = spend)) +
    geom_point()

В этом месте видна закономерность
- Внизу слева вы можете увидеть молодых людей с более низкой покупательной способностью.
- Верхний средний уровень – это люди, имеющие работу, которую они могут себе позволить, тратят больше
- Наконец, пожилые люди с меньшим бюджетом.

На рисунке выше вы группируете наблюдения вручную и определяете каждую из трех групп. Этот пример довольно простой и очень наглядный. Если к набору данных добавляются новые наблюдения, вы можете пометить их внутри кружков. Вы определяете круг на основе нашего суждения. Вместо этого вы можете использовать Машинное обучение объективно сгруппировать данные.
В этом уроке вы узнаете, как использовать К средних алгоритм.
Алгоритм K-средних
Алгоритм K-средних является наиболее широко используемым методом кластеризации. Он появился в 1950-х годах и с тех пор неоднократно совершенствовался.
Алгоритм пытается найти группы, минимизируя расстояние между наблюдениями, называемое локальный оптимум решения. Расстояния измеряются на основе координат наблюдений. Например, в двумерном пространстве координаты — это просто x и y.
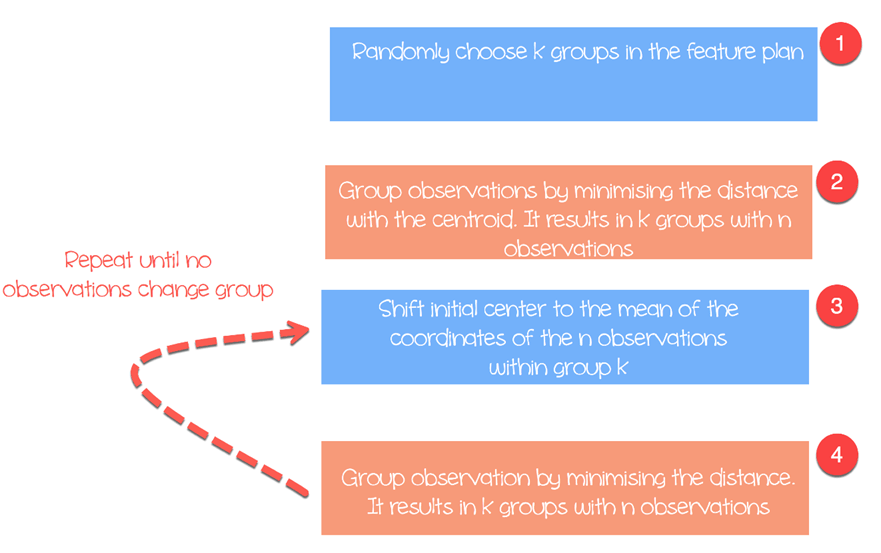
Алгоритм работает следующим образом:
- Шаг 1: Случайным образом выберите k начальных центроидов в пространстве признаков.
- Шаг 2: Присвойте каждому наблюдению ближайший к нему центр кластера. центроидаЭто приводит к образованию k групп.
- Шаг 3: Shift от начального центроида до среднего значения координат внутри группы.
- Шаг 4: Минимизируйте расстояние в соответствии с новыми центроидами. Создаются новые границы. Таким образом, наблюдения будут переходить из одной группы в другую.
- Повторяйте до тех пор, пока ни одно наблюдение не изменит группы.
Алгоритм k-средних обычно измеряет евклидово расстояние между двумя наблюдениями x и y:

Доступны и другие меры, такие как манхэттенское или расстояние Минковского. Обратите внимание, что алгоритм k-средних каждый раз возвращает разные группы. Напомним, что первые начальные предположения случайны, и расстояния вычисляются до тех пор, пока алгоритм не достигнет однородности внутри групп. То есть, алгоритм k-средних очень чувствителен к первому выбору, и, если количество наблюдений и групп невелико, получить одинаковую кластеризацию практически невозможно.
Выбор количества кластеров
Еще одна сложность алгоритма k-средних заключается в выборе количества кластеров. Можно установить высокое значение k, то есть большое количество групп, чтобы улучшить однородность внутри групп, но при этом существует риск переобучения данные. Переобучение означает резкое снижение производительности на новых данных, поскольку модель запомнила шум в этом конкретном образце, а не лежащую в его основе закономерность.
Количество кластеров зависит от характера набора данных, отрасли, бизнеса и т. д. Однако существует практическое правило выбора подходящего количества кластеров:

где n — количество наблюдений в наборе данных.
На практике стоит потратить время на поиск значения k, которое наилучшим образом соответствует потребностям бизнеса.
Мы будем использовать набор данных «Цены на персональные компьютеры» для выполнения кластерного анализа. Этот набор данных содержит 6259 наблюдений и 10 объектов. В наборе данных отражены цены на 1993 персональных компьютеров в США с 1995 по 486 год. Переменными являются цена, скорость, оперативная память, экран, компакт-диск и другие.
Вы будете действовать следующим образом:
- Даты импорта
- Тренируй модель
- Оцените модель
Даты импорта
Алгоритм K-средних не подходит для факторных переменных, поскольку он работает с расстояниями, а между дискретными метками нет осмысленного расстояния. Удалите три категориальных столбца (cd, multi, premium) вместе с индексом строки X. Этот набор данных не содержит пропущенных значений.
library(dplyr)
PATH <-"https://raw.githubusercontent.com/guru99-edu/R-Programming/master/computers.csv"
df <- read.csv(PATH) %>%
select(-c(X, cd, multi, premium))
glimpse(df)
Результат
## Observations: 6,259
## Variables: 7
## $ price <int> 1499, 1795, 1595, 1849, 3295, 3695, 1720, 1995, 2225, 2...
## $ speed <int> 25, 33, 25, 25, 33, 66, 25, 50, 50, 50, 33, 66, 50, 25, ...
## $ hd <int> 80, 85, 170, 170, 340, 340, 170, 85, 210, 210, 170, 210...
## $ ram <int> 4, 2, 4, 8, 16, 16, 4, 2, 8, 4, 8, 8, 4, 8, 8, 4, 2, 4, ...
## $ screen <int> 14, 14, 15, 14, 14, 14, 14, 14, 14, 15, 15, 14, 14, 14, ...
## $ ads <int> 94, 94, 94, 94, 94, 94, 94, 94, 94, 94, 94, 94, 94, 94, ...
## $ trend  <int> 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1...
Из сводной статистики видно, что данные содержат большие значения. Перед применением любого метода, основанного на расстоянии, рекомендуется стандартизировать данные, чтобы каждая переменная имела определенное значение. среднее значение нуля и стандартное отклонение одногоБез этого цена, исчисляющаяся тысячами, будет играть решающую роль в расчете расстояния, а размер экрана будет иметь практически нулевое значение.
summary(df)
Выход:
##      price          speed              hd              ram
##  Min.   : 949   Min.   : 25.00   Min.   :  80.0   Min.   : 2.000
##  1st Qu.:1794   1st Qu.: 33.00   1st Qu.: 214.0   1st Qu.: 4.000
##  Median :2144   Median : 50.00   Median : 340.0   Median : 8.000
##  Mean   :2220   Mean   : 52.01   Mean   : 416.6   Mean   : 8.287
##  3rd Qu.:2595   3rd Qu.: 66.00   3rd Qu.: 528.0   3rd Qu.: 8.000
##  Max.   :5399   Max.   :100.00   Max.   :2100.0   Max.   :32.000
##      screen           ads            trend
##  Min.   :14.00   Min.   : 39.0   Min.   : 1.00
##  1st Qu.:14.00   1st Qu.:162.5   1st Qu.:10.00
##  Median :14.00   Median :246.0   Median :16.00
##  Mean   :14.61   Mean   :221.3   Mean   :15.93
##  3rd Qu.:15.00   3rd Qu.:275.0   3rd Qu.:21.50
##  Max.   :17.00   Max.   :339.0   Max.   :35.00
Вы изменяете масштаб переменных с помощью функции Scale() библиотеки dplyr. Преобразование уменьшает влияние выбросов и позволяет сравнивать отдельное наблюдение со средним значением. Если стандартизированное значение (или Z-балл) высока, вы можете быть уверены, что это наблюдение действительно выше среднего (большой z-показатель означает, что эта точка находится далеко от среднего значения с точки зрения стандартного отклонения. Z-показатель, равный двум, означает, что значение равно 2 стандартным отклонения от среднего значения. Обратите внимание, что z-показатель соответствует распределению Гаусса и симметричен относительно среднего значения.
# Note: speed is deliberately left out of the scaled data frame
rescale_df <- df %>%
    mutate(price_scal = scale(price),
    hd_scal = scale(hd),
    ram_scal = scale(ram),
    screen_scal = scale(screen),
    ads_scal = scale(ads),
    trend_scal = scale(trend)) %>%
select(-c(price, speed, hd, ram, screen, ads, trend))
База R имеет функцию для запуска алгоритма k-среднего. Основная функция kmean:
kmeans(df, k)
arguments:
-df: dataset used to run the algorithm
-k: Number of clusters
Тренируй модель
На третьем рисунке вы подробно показали, как работает алгоритм. Вы можете проследить каждый шаг графически с помощью пакета анимации, написанного Ихуи Се, который также создал knitr для R Markdown. Этот пакет отсутствует в каналах conda, поэтому установите его из CRAN:
install.packages("animation")
После загрузки библиотеки вы добавляете .ani после kmeans и R пропишу все шаги. В целях иллюстрации вы запускаете алгоритм только с масштабированными переменными hd и ram с тремя кластерами.
set.seed(2345)
library(animation)
kmeans.ani(rescale_df[2:3], 3)
Code объяснение
- kmeans.ani(rescale_df[2:3], 3): выберите столбцы 2 и 3 набора данных rescale_df и запустите алгоритм с наборами k, равными 3. Постройте анимацию.


Вы можете интерпретировать анимацию следующим образом:
- Шаг 1: R случайным образом выбирает три точки.
- Шаг 2. Вычислите евклидово расстояние и нарисуйте кластеры. У вас есть один кластер зеленого цвета внизу слева, один большой кластер черного цвета справа и красный между ними.
- Шаг 3. Вычислите центроид, то есть среднее значение кластеров.
- Повторяйте до тех пор, пока данные не изменятся в кластере.
Алгоритм сходился после семи итераций. Вы можете запустить алгоритм k-mean в нашем наборе данных с пятью кластерами и назвать его pc_cluster.
pc_cluster <-kmeans(rescale_df, 5)
Список pc_cluster содержит семь полезных элементов:
- pc_cluster$cluster: Кластер, назначенный каждому наблюдению
- pc_cluster$centers: Центры кластеров.
- pc_cluster$totss: Общая сумма квадратов.
- pc_cluster$withinss: В пределах суммы квадратов — одно значение на кластер
- pc_cluster$tot.withinss: Сумма withinss
- pc_cluster$betweenss: Сумма квадратов минус сумма квадратов внутри кластера
- pc_cluster$size: количество наблюдений в каждом кластере.
Вы будете использовать сумму внутренней суммы квадратов (т. е. tot.withinss) для вычисления оптимального количества кластеров k. Нахождение k действительно является серьезной задачей.
Как найти оптимальное значение k с помощью метода «локтя»
Один из методов выбора лучшего k называется локтевой метод. Этот метод использует внутригрупповую однородность или внутригрупповую гетерогенность для оценки изменчивости. Другими словами, вас интересует процент дисперсии, объясняемый каждым кластером. Можно ожидать, что изменчивость будет увеличиваться с увеличением количества кластеров, или наоборот, гетерогенность уменьшится. Наша задача — найти значение k, которое находится за пределами убывающей отдачи. Добавление нового кластера не улучшает изменчивость данных, поскольку остается очень мало информации для объяснения.
В этом уроке мы находим эту точку, используя меру неоднородности. Общая сумма квадратов внутри кластеров — это tot.withinss в списке, возвращаемом функцией kmean().
Вы можете построить график локтей и найти оптимальный k следующим образом:
- Шаг 1. Создайте функцию для вычисления суммы квадратов внутри кластеров.
- Шаг 2: Запустите алгоритм для диапазона значений k.
- Шаг 3. Создайте фрейм данных с результатами алгоритма.
- Шаг 4. Постройте график результатов
Шаг 1) Создайте функцию для вычисления суммы квадратов в пределах кластеров.
Вы создаете функцию, которая запускает алгоритм k-mean и сохраняет итоговую сумму в кластерах, сумму квадратов.
kmean_withinss <- function(k) {
    cluster <- kmeans(rescale_df, k)
    return (cluster$tot.withinss)
}
Code объяснение
- function(k): установите количество аргументов в функции
- kmeans(rescale_df, k): Запустить алгоритм для этого значения k
- return(cluster$tot.withinss): сохраняет итоговую сумму квадратов в кластерах.
Проверьте функцию, при этом k равно 2.
Выход:
## Try with 2 cluster
kmean_withinss(2)
Выход:
## [1] 27087.07
Шаг 2) Запустите алгоритм n раз
Вы будете использовать функцию sapply() для запуска алгоритма в диапазоне k. Этот метод быстрее, чем создание цикла и сохранение значения.
# Set maximum cluster
max_k <-20
# Run algorithm over a range of k
wss <- sapply(2:max_k, kmean_withinss)
Code объяснение
- max_k <- 20: Установить максимальное значение k равным 20
- sapply(2:max_k, kmean_withinss): Запустите функцию kmean_withinss() в диапазоне 2:max_k, то есть от 2 до 20.
Шаг 3) Создайте фрейм данных с результатами алгоритма.
После написания и тестирования функции запустите ее в диапазоне от 2 до 20 и сохраните каждое значение tot.withinss.
# Create a data frame to plot the graph
elbow <-data.frame(2:max_k, wss)
Code объяснение
- data.frame(2:max_k, wss): создать фрейм данных с выходными данными алгоритма, хранящимися в wss.
Шаг 4) Постройте результаты
Вы строите график, чтобы визуализировать, где находится точка локтя.
# Plot the graph with gglop
ggplot(elbow, aes(x = X2.max_k, y = wss)) +
    geom_point() +
    geom_line() +
    scale_x_continuous(breaks = seq(1, 20, by = 1))

На графике вы можете видеть, что оптимальное k равно семи, при этом кривая начинает приносить убывающую доходность.
Как только вы получите наш оптимальный k, вы повторно запускаете алгоритм с k, равным 7, и оцениваете кластеры.
Изучение кластеров
pc_cluster_2 <-kmeans(rescale_df, 7)
Как упоминалось ранее, вы можете получить доступ к оставшейся интересной информации в списке, возвращаемом функцией kmean().
pc_cluster_2$cluster
pc_cluster_2$centers
pc_cluster_2$size
Оценка субъективна и зависит от назначения кластеров. Цель здесь — сгруппировать компьютеры со схожими характеристиками. Эксперт в данной области мог бы сделать это вручную, но процесс был бы медленным и чреватым ошибками. Метод k-средних выполняет группировку.ping объективно, а интерпретацию и обозначение результата оставляет эксперту.
В качестве предварительной оценки вы можете изучить размер кластеров.
pc_cluster_2$size
Выход:
## [1] 608 1596 1231 580 1003 699 542
Самый большой кластер, номер 2, содержит 1,596 наблюдений, в то время как самый маленький, номер 7, содержит всего 542 компьютера. Желательно обеспечить однородность кластеров, в противном случае может потребоваться более щадящая подготовка данных.
Более детальный анализ данных обеспечивается центральным компонентом. Строки обозначают нумерацию кластеров, а столбцы — переменные, используемые алгоритмом. Значения представляют собой средний балл каждого кластера для интересующего столбца. Стандартизация упрощает интерпретацию. Положительные значения указывают на то, что z-балл для данного кластера выше общего среднего значения. Например, кластер 4 имеет самую высокую среднюю цену (price_scal = 1.09), а кластер 5 — самую низкую (-0.82).
center <-pc_cluster_2$centers
center
Выход:
##   price_scal    hd_scal     ram_scal screen_scal   ads_scal trend_scal
## 1 -0.6372457 -0.7097995 -0.691520682  -0.4401632  0.6780366 -0.3379751
## 2 -0.1323863  0.6299541  0.004786730   2.6419582 -0.8894946  1.2673184
## 3  0.8745816  0.2574164  0.513105797  -0.2003237  0.6734261 -0.3300536
## 4  1.0912296 -0.2401936  0.006526723   2.6419582  0.4704301 -0.4132057
## 5 -0.8155183  0.2814882 -0.307621003  -0.3205176 -0.9052979  1.2177279
## 6  0.8830191  2.1019454  2.168706085   0.4492922 -0.9035248  1.2069855
## 7  0.2215678 -0.7132577 -0.318050275  -0.3878782 -1.3206229 -1.5490909
Вы можете создать тепловую карту с помощью ggplot, чтобы помочь нам выделить разницу между категориями.
Цвета ggplot по умолчанию необходимо изменить с помощью библиотеки RColorBrewer. Вы можете использовать Конду библиотеки и код для запуска в терминале:
conda install -c r r-rcolorbrewer
Чтобы создать тепловую карту, вы выполняете три шага:
- Постройте фрейм данных со значениями центра и создайте переменную с номером кластера.
- Измените форму данных с помощью функции сбора() библиотеки tidyr. Вы хотите преобразовать данные из широких в длинные.
- Создайте палитру цветов с помощью цветаRampФункция Палитра()
Шаг 1) Создайте фрейм данных
Давайте создадим набор данных изменения формы.
library(tidyr)

# create dataset with the cluster number

cluster <- c(1: 7)
center_df <- data.frame(cluster, center)

# Reshape the data

center_reshape <- gather(center_df, features, values, price_scal: trend_scal)
head(center_reshape)
Выход:
##   cluster   features     values
## 1       1 price_scal -0.6372457
## 2       2 price_scal -0.1323863
## 3       3 price_scal  0.8745816
## 4       4 price_scal  1.0912296
## 5       5 price_scal -0.8155183
## 6       6 price_scal  0.8830191
Шаг 2) Создайте цветовую палитру
Приведённый ниже код формирует цветовую палитру, используемую для тепловой карты.
library(RColorBrewer)
# Create the palette
hm.palette <-colorRampPalette(rev(brewer.pal(10, 'RdYlGn')),space='Lab')
Шаг 3) Визуализируйте
Вы можете построить график и посмотреть, как выглядят кластеры.
# Plot the heat map
ggplot(data = center_reshape, aes(x = features, y = cluster, fill = values)) +
    scale_y_continuous(breaks = seq(1, 7, by = 1)) +
    geom_tile() +
    coord_equal() +
    scale_fill_gradientn(colours = hm.palette(90)) +
    theme_classic()

Как получить воспроизводимые результаты алгоритма K-средних с помощью set.seed() и nstart
В руководстве отмечается, что алгоритм k-средних возвращает разные группы при каждом запуске. Это не недостаток, с которым нужно мириться, это проблема, которую можно решить двумя стандартными способами, и ни один из них не используется в приведенных выше примерах.
1. Зафиксируйте начальную точку с помощью метода set.seed(). Начальные центроиды выбираются случайным образом, поэтому один и тот же вызов каждый раз приводит к разным кластерам. Установка начального значения генератора случайных чисел делает весь анализ воспроизводимым:
set.seed(123)
pc_cluster_2 <- kmeans(rescale_df, 7)
2. Выполните несколько запусков и выберите лучший результат с помощью команды nstart. Одно случайное начало может привести к плохому локальному оптимуму. Аргумент nstart запускает алгоритм, который многократно использует разные случайные начальные значения, и возвращает то, которое имеет наименьшую сумму квадратов:
set.seed(123)
pc_cluster_2 <- kmeans(rescale_df, centers = 7, nstart = 25)
Обычно рекомендуется 25 стартов, и это обходится очень недорого для набора данных такого размера. Без этого кривая изгиба становится нестабильной, поскольку каждая точка на графике соответствует одному неудачному или удачному старту. Поэтому функцию kmean_withinss(), определенную ранее, следует записать следующим образом:
kmean_withinss <- function(k) {
    cluster <- kmeans(rescale_df, centers = k, nstart = 25)
    return (cluster$tot.withinss)
}
3. Увеличьте значение iter.max, если алгоритм выдаст предупреждение. Если R сообщает о том, что «не удалось достичь сходимости за 10 итераций», передайте iter.max = 50, чтобы дать ему больше пространства для маневра.
K-средних против иерархического алгоритма Clusterинг в R
Метод k-средних — не единственный доступный метод кластеризации, и выбор обычно зависит от размера данных и от того, знаете ли вы заранее, сколько групп вам нужно.
| Критерии | K-средних | Иерархический |
|---|---|---|
| Количество кластеров | Необходимо выбрать заранее. | Выбрано впоследствии путем разрезания дендрограммы. |
| Стабильность результатов | Зависит от случайного начала. | детерминистический |
| Масштабируемость | Обрабатывает очень большие наборы данных. | Трудности, выходящие за рамки нескольких тысяч рядов. |
| Cluster формировать | Предполагается, что группы имеют приблизительно сферическую форму и схожий размер. | Более гибкий |
| Результат | Плоский набор меток | Дендрограмма, показывающая вложенную структуру. |
| Функция R | kmeans(df, k) | hclust(dist(df)) |
# Hierarchical alternative on the same scaled data
hc <- hclust(dist(rescale_df), method = "ward.D2")
plot(hc)
groups <- cutree(hc, k = 7)
При наличии 6,259 наблюдений иерархическая кластеризация должна построить матрицу расстояний, содержащую примерно 19.6 миллионов пар, поэтому алгоритм k-средних является наиболее практичным выбором для этого набора данных. Следует также отметить, что алгоритм k-средних предполагает кластеры схожего размера и приблизительно сферической формы; там, где это предположение не выполняется, алгоритм DBSCAN обрабатывает нерегулярные формы и выявляет выбросы, вместо того чтобы принудительно объединять каждую точку в группу.
K-средних ClusterВ R: Справочник по функциям
Ниже перечислены все функции, использованные в этом руководстве:
| Упаковка | Цель | Функция | Аргумент |
|---|---|---|---|
| Использование темпера с изогнутым основанием | Поезд k-среднее | kmeans () | дф, к |
| Кластер доступа | kmeans()$кластер | ||
| Cluster центры | kmeans()$центры | ||
| Cluster Размеры | kmeans()$размер | ||
| Сумма квадратов | kmeans()$tot.withinss | Используется локтевой метод | |
| Сумма квадратов между | kmeans()$betweenss | ||
| Использование темпера с изогнутым основанием | Воспроизводимый результат | set.seed() | начальная стоимость |
| Использование темпера с изогнутым основанием | Стабилизировать результат | kmeans(df, k, nstart = 25) | нстар |
