
Столярное преобразование в Informatica с ПРИМЕРОМ
 Редакционная коллегия
⚡ Умное резюме
В Informatica преобразование Joiner представляет собой активный, связанный объект, который объединяет два разнородных источника на основе условия соответствия, кэшируя основной конвейер в памяти, в то время как детальный конвейер обрабатывает его потоком.
Что такое столярное преобразование?
Преобразование Joiner — это активное и связанное преобразование, которое предоставляет возможность создавать соединения в Informatica. Соединения, созданные с помощью преобразования Joiner, аналогичны соединениям в базах данных. Преимущество преобразования Joiner заключается в том, что соединения можно создавать для гетерогенных систем (различных баз данных).
В преобразовании Joiner для объединения используются два источника. Эти два источника называются
- Главный источник
- Подробный источник
В свойствах преобразования Joiner можно выбрать, какой источник данных будет основным, а какой — подробным.
В процессе выполнения основной источник данных кэшируется в памяти для целей объединения. Поэтому рекомендуется выбирать в качестве основного источника источник с меньшим количеством записей. Основной конвейер обработки данных хранится в двух кэшах: индексном кэше для значений, используемых в условии объединения, и кэше данных для остальных строковых данных.
Типы соединений в преобразовании Joiner
Свойство «Тип соединения» на вкладке «Свойства» определяет, что происходит со строками, для которых не найдено совпадений. Следующие типы соединений можно создать с помощью преобразования «Соединитель».
- Мастер внешнего соединения – При внешнем соединении по основному источнику возвращаются все записи из источника подробных данных, и возвращаются только соответствующие строки из основного источника.
- Подробное внешнее соединение – При внешнем соединении с подробными данными из источника подробных данных возвращаются только совпадающие строки, а из основного источника возвращаются все строки.
- Полное внешнее соединение – При полном внешнем соединении возвращаются все записи из обоих источников.
- Обычное соединение – При обычном объединении из обоих источников возвращаются только совпадающие строки.
Основные внешние и детальные внешние соединения эквивалентны левым внешним соединениям в SQL: каждый из них сохраняет все строки одного источника и только совпадения из другого. В таблице ниже приведено сравнение четырех типов с их эквивалентами в SQL.
| Тип соединения | Строки сохранены из основного файла | Строки скрыты от подробностей | эквивалент SQL |
|---|---|---|---|
| Обычное соединение | Только совпадение | Только совпадение | Внутреннее соединение |
| Мастер внешнего соединения | Только совпадение | Все строки | Левое внешнее соединение в источнике данных |
| Подробное внешнее соединение | Все строки | Только совпадение | Левое внешнее соединение на главном источнике |
| Полное внешнее соединение | Все строки | Все строки | Полное внешнее соединение |
Тип соединения — это свойство, а не структурный параметр, поэтому его можно изменить позже без перестройки карты.ping или переподключение любых портов.
Как использовать преобразование Joiner в Informatica
В этом примере мы объединим таблицы сотрудников и отделов с помощью преобразования Joiner. Выполните восемь шагов, описанных ниже, в таблице Map.ping Дизайнер.
Шаг 1) Создайте новую целевую таблицу EMP_DEPTNAME в базе данных, используя приведенный ниже скрипт, и импортируйте эту таблицу в целевые объекты Informatica.
Загрузите указанный выше файл emp_deptname.sql.
Шаг 2) Создать новый картаping и импортировать исходные таблицы «EMP» и «DEPT», а также целевую таблицу, созданную на предыдущем шаге. Все три определения теперь находятся на холсте, как показано ниже.

Шаг 3) В меню «Преобразование» выберите пункт «Создать». Затем в окне «Создать преобразование», показанном ниже,
- Выберите преобразование столяра
- Введите имя преобразования «jnr_emp_dept».
- Выберите вариант создания

Шаг 4) Перетащите все столбцы из обоих Квалификаторы источника к преобразованию Joiner. Оба конвейера теперь связаны с jnr_emp_dept, как показано на скриншоте.

Шаг 5) Double Щелкните по преобразованию «Соединитель», затем в окне «Редактировать преобразования»
- Выберите вкладку условия
- Нажмите на значок добавления нового условия.
- Выберите deptno в списке основных и подробных столбцов.
Теперь на вкладке «Условие» отображается условие для единственного соединения по адресу deptno.

Шаг 6) Затем в том же окне
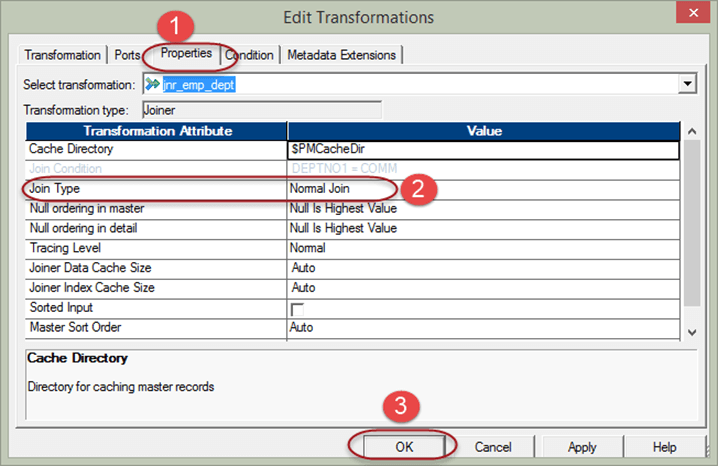
- Выберите вкладку свойств
- Выберите «Обычное соединение» в качестве типа соединения.
- Нажмите кнопку ОК
Далее отображается вкладка «Свойства» с заданным типом соединения.
Для оптимизации производительности мы назначаем основной источник конвейеру обработки исходных таблиц, содержащему меньшее количество записей. Для выполнения этой задачи:
Шаг 7) Double Чтобы открыть окно «Редактирование преобразований», щелкните по преобразованию «Соединитель», а затем...
- Выберите вкладку портов
- Выберите любой столбец определенного источника, который вы хотите сделать основным.
- Выберите OK
На вкладке «Порты» выбранный конвейер помечается как главный, как показано ниже.

Шаг 8) Свяжите соответствующие столбцы из преобразования Joiner с целевой таблицей. Картаping Теперь данные поступают из обоих источников через объединение с EMP_DEPTNAME.
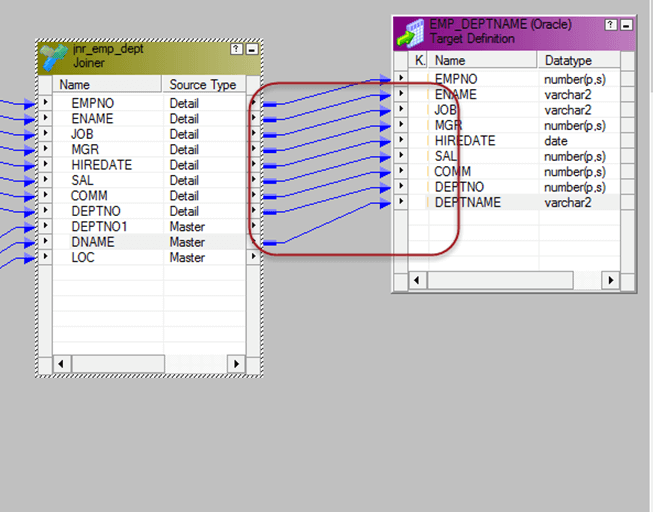
Теперь сохраните карту.ping и выполнить его после создания Сессия и рабочий Для этого. Объединение будет выполнено с помощью инструмента Informatica Joiner, и соответствующие данные будут извлечены из обеих таблиц.
Свойства преобразования соединителя
Вкладка «Свойства» содержит не только тип соединения. Приведенные ниже настройки определяют объем памяти, используемый для соединения, и место записи файлов кэша.
| настройка | Что он контролирует |
|---|---|
| Тип соединения | Обычный, основной внешний, детальный внешний или полный внешний. Определяет, какие несовпадающие строки будут сохранены. |
| Условие присоединения | Список пар «главный-подробный порт» сравнивается с помощью оператора равенства. Несколько условий объединены с помощью оператора И. |
| Отсортированный ввод | Указывается, что оба конвейера уже поступают отсортированными по портам условий, что позволяет службе интеграции минимизировать ввод и вывод данных на диск. |
| Основной порядок сортировки | Порядок сортировки исходных данных, используемых вместе с отсортированными входными данными. |
| Каталог кэша | Каталог, в котором создаются файлы индекса и кэша данных. По умолчанию используется переменная процесса $PMCacheDir. |
| Размер кэша данных участника | Размер кэша данных, хранящего основные строки. По умолчанию установлено значение «Авто», которое позволяет службе интеграции самостоятельно определять его размер. |
| Размер кэша индекса объединения | Размер кэша индекса, хранящего значения основных условий. По умолчанию — Авто. |
| Объем преобразований | Применяет объединение к каждой транзакции, ко всем входящим данным или к данным на уровне строк. |
Отсортированный ввод — это настройка, с которой стоит начать. Когда оба конвейера поступают в упорядоченном виде по портам условий, службе интеграции не нужно хранить весь основной источник до начала сопоставления, что соответствует принципу, применяемому во время настройка производительности других кэшированных преобразований.
Правила и ограничения преобразования соединителей
Некоторые ограничения становятся очевидными только при наличии карты.ping Проверено, поэтому дешевле узнать об этом до того, как порты будут связаны.
- Только равенство. В условии объединения порты сравниваются с помощью оператора равенства. Операторы сравнения, такие как «больше», «меньше» или «не равно», в условии не принимаются.
- Соответствие типов данных. Оба порта в условии должны иметь одинаковый тип данных. Конструктор проверяет это, поэтому несовпадающие столбцы сначала необходимо преобразовать, обычно с помощью преобразования выражений.
- Стратегия обновления исходного кода отсутствует. Преобразование Joiner нельзя использовать, если какой-либо из входных конвейеров содержит преобразование Update Strategy.
- Без последовательности Generator непосредственно перед ним. Соединение последовательности Generator Преобразование, выполняемое непосредственно перед Joiner, не поддерживается.
- Отключить кэширование невозможно. Основной конвейер обработки данных всегда кэшируется, поэтому меньший по размеру источник данных должен находиться на стороне основного конвейера, и именно поэтому размер кэша имеет значение при больших операциях объединения.
Для объединения трех источников требуется две связанные между собой преобразования Joiner, поскольку каждое из них принимает ровно один основной и один подробный конвейер обработки. В случае, когда вторым источником является небольшая справочная таблица, считываемая построчно, Преобразование поиска Чаще всего это более простая конструкция.
