
Этапы компиляции с примером, описанием процесса и пошаговым описанием.
 Кайя Церулеан
⚡ Умное резюме
Фазы компиляции описывают, как компилятор преобразует исходный код в машинный код в шесть этапов: лексический анализ, синтаксический анализ, семантический анализ, генерация промежуточного кода, оптимизация кода и генерация кода, поддерживаемая управлением таблицами символов и обработкой ошибок на всех этапах.
Каковы этапы разработки компилятора?
составитель работает в различных фазах, каждая фаза преобразует исходную программу из одного представления в другое. Каждая фаза принимает входные данные от предыдущей стадии и передает выходные данные на следующую фазу компилятора.
В компиляторе 6 фаз. Каждый из этих этапов помогает преобразовать язык высокого уровня в машинный код. Фазы компилятора:
- Лексический анализ
- Синтаксический анализ
- Семантический анализ
- Генератор промежуточного кода
- Code оптимизатор
- Code генератор
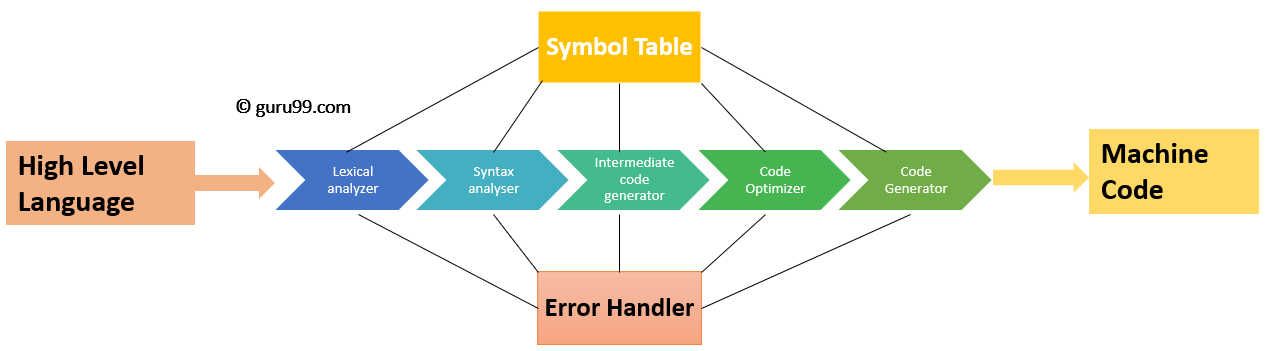
Все эти этапы преобразуют исходный код путем разделения на токены, создания деревьев разбора и оптимизации исходного кода на разных этапах.
Этап 1: Лексический анализ
Лексический анализ — это первый этап, когда компилятор сканирует исходный код. Этот процесс можно выполнять слева направо, символ за символом, и группировать эти символы в токены.
Здесь поток символов из исходной программы группируется в значимые последовательности путем идентификации токенов. Он вносит соответствующие билеты в таблицу символов и передает этот токен на следующий этап.
Основными функциями этого этапа являются:
- Определить лексические единицы в исходном коде
- Классифицируйте лексические единицы по классам, таким как константы, зарезервированные слова, и вводите их в разные таблицы. Он будет игнорировать комментарии в исходной программе.
- Определить токен, который не является частью языка
Пример:
х = у + 10
Лексемы
| X | идентификатор |
| = | Оператор присваивания |
| Y | идентификатор |
| + | Оператор сложения |
| 10 | Номер регистрации |
Этап 2: Синтаксический анализ
Синтаксический анализ направлен на обнаружение структуры кода. Он определяет, соответствует ли текст ожидаемому формату. Основная цель этого этапа — убедиться, что исходный код написан программистом правильно или нет.
Синтаксический анализ основан на правилах, основанных на конкретном языке программирования, путем построения дерева разбора с помощью токенов. Он также определяет структуру исходного языка и грамматику или синтаксис языка.
Вот список задач, выполняемых на этом этапе:
- Получить токены от лексического анализатора
- Проверяет, является ли выражение синтаксически правильным или нет.
- Сообщать обо всех синтаксических ошибках
- Постройте иерархическую структуру, известную как дерево разбора.
Пример
Любой идентификатор/число является выражением
Если x — идентификатор, а y+10 — выражение, то x= y+10 — оператор.
Рассмотрим дерево разбора для следующего примера
(a+b)*c
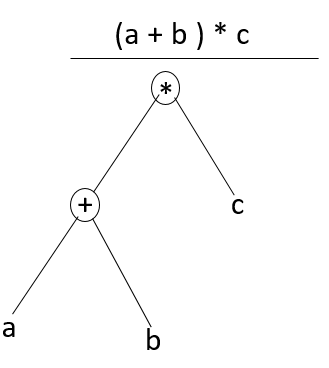
В дереве разбора
- Внутренний узел: запись с полем оператора и двумя дочерними файлами.
- Лист: записи с 2/более полями; один для токена и другой информации о токене
- Убедитесь, что компоненты программы содержательно сочетаются друг с другом.
- Собирает информацию о типах и проверяет совместимость типов.
- Проверяет, что операнды разрешены исходным языком
Этап 3: Семантический анализ
Семантический анализ проверяет семантическую согласованность кода. Он использует синтаксическое дерево предыдущего этапа вместе с таблицей символов для проверки семантической согласованности данного исходного кода. Он также проверяет, передает ли код соответствующее значение.
Семантический анализатор проверит несоответствие типов, несовместимые операнды, функцию, вызванную с неправильными аргументами, необъявленную переменную и т. д.
Функции этапа семантического анализа:
- Помогает хранить собранную информацию о типах и сохранять ее в таблице символов или синтаксическом дереве.
- Позволяет выполнять проверку типа
- В случае несовпадения типов, когда нет точных правил исправления типов, удовлетворяющих желаемой операции, отображается семантическая ошибка.
- Собирает информацию о типе и проверяет совместимость типов.
- Проверяет, разрешает ли исходный язык операнды или нет.
Пример
float x = 20.2;
float y = x*30;
В приведенном выше коде семантический анализатор преобразует целое число 30 в число с плавающей запятой 30.0 перед умножением.
Фаза 4: Промежуточная Code Поколение
После завершения этапа семантического анализа компилятор генерирует промежуточный код для целевой машины. Он представляет собой программу для некоторого абстрактного типа данных.tracмашина Т.
Промежуточный код находится между языком высокого уровня и языком машинного уровня. Этот промежуточный код должен быть сгенерирован таким образом, чтобы его можно было легко преобразовать в целевой машинный код.
Функции на промежуточных Code поколение:
- Он должен быть сгенерирован из семантического представления исходной программы.
- Содержит значения, вычисленные в процессе перевода.
- Помогает вам перевести промежуточный код на целевой язык.
- Позволяет поддерживать порядок приоритета исходного языка.
- Он содержит правильное количество операндов инструкции.
Пример
Например,
total = count + rate * 5
Промежуточный код с помощью метода адресного кода:
t1 := int_to_float(5)
t2 := rate * t1
t3 := count + t2
total := t3
Фаза 5: Code Оптимизация
Следующий этап — оптимизация кода или промежуточный код. На этом этапе удаляется ненужная строка кода и упорядочивается последовательность операторов, чтобы ускорить выполнение программы без потери ресурсов. Основная цель этого этапа — улучшить промежуточный код для создания кода, который работает быстрее и занимает меньше места.
Основными функциями этого этапа являются:
- Это помогает вам найти компромисс между скоростью выполнения и компиляции.
- Улучшает время работы целевой программы
- Генерирует оптимизированный код, все еще находящийся в промежуточном представлении.
- Удаление недостижимого кода и избавление от неиспользуемых переменных
- Удаление операторов, которые не изменяются из цикла
Пример:
Рассмотрим следующий код
a = intofloat(10)
b = c * a
d = e + b
f = d
Может стать
b =c * 10.0
f = e+b
Фаза 6: Code Поколение
Code Генерация — это последняя и заключительная фаза компилятора. Она получает входные данные из фаз оптимизации кода и в результате генерирует страничный код или объектный код. Цель этой фазы — выделить память и сгенерировать перемещаемый машинный код.
Он также выделяет ячейки памяти для переменной. Инструкции промежуточного кода преобразуются в машинные инструкции. На этом этапе оптимизируемый или промежуточный код преобразуется в целевой язык.
Целевой язык — машинный код. Таким образом, на этом этапе также выбираются и распределяются все ячейки памяти и регистры. Код, сгенерированный на этом этапе, выполняется для приема входных данных и генерации ожидаемых выходных данных.
Пример
а = б + 60.0
Возможно было бы переведено в регистры.
MOVF a, R1
MULF #60.0, R2
ADDF R1, R2
Управление таблицей символов
Таблица символов содержит запись для каждого идентификатора с полями для атрибутов идентификатора. Этот компонент упрощает компилятору поиск записи идентификатора и быстрое ее извлечение. Таблица символов также поможет вам в управлении областью действия. Таблица символов и обработчик ошибок взаимодействуют со всеми фазами и обновлением таблицы символов соответственно.
Процедура обработки ошибок
В процессе разработки компилятора ошибка может возникнуть на всех следующих этапах:
- Лексический анализатор: Неправильно написанные токены
- Анализатор синтаксиса: отсутствует скобка
- Генератор промежуточного кода: несовпадающие операнды для оператора
- Code Оптимизатор: Когда оператор недоступен
- Code Generator: Когда память заполнена или не выделены нужные регистры.
- Таблицы символов: ошибка нескольких объявленных идентификаторов
Наиболее распространенными ошибками являются недопустимая последовательность символов при сканировании, недопустимые последовательности токенов в типе, ошибка области и синтаксический анализ при семантическом анализе.
Ошибка может возникнуть на любом из вышеуказанных этапов. После обнаружения ошибок на этом этапе необходимо разобраться с ошибками, чтобы продолжить процесс компиляции. Об этих ошибках необходимо сообщить обработчику ошибок, который обрабатывает ошибку для выполнения процесса компиляции. Обычно об ошибках сообщается в виде сообщения.
