
Informatica でのランク変換の例
 デビッドカーター
⚡ スマートサマリー
Informaticaのランク変換は、アクティブな接続オブジェクトであり、各グループの上位または下位N行のみを保持し、自動RANKINDEX出力ポートを介して各残存行に位置を割り当てます。
ランク変換とは何ですか?
ランク変換は、グループとランクに基づいてデータをフィルタリングする、アクティブかつ接続された変換です。たとえば、給与が最も高い従業員のレコードを10件取得したい場合、ランク変換を使用することでそのようなフィルタリングを実行できます。
ランク変換では、グループに基づいてランキングを作成する機能も提供しています。たとえば、部門別に給与の高い従業員の上位10人を取得したい場合、そのグループをping この変換によって実現可能です。
ランク変換は出力行数に影響を与えるため、アクティブな変換です。
Rank 変換には、行にランクを割り当てる出力ポートがあります。そのポートは RANKINDEX という名前で、変換が追加されるとすぐに Designer によって自動的に作成されます。 地図ping.
ランキングでは、どの行が勝つかを決定する前にグループ内のすべての行を比較する必要があるため、統合サービスは受信データをキャッシュします。グループ値はインデックスキャッシュに、残りの行データはデータキャッシュに格納されます。 ジョイナ変換 マスターパイプラインを保持している。
ランク変換における港湾
具体的な例を見る前に、[ポート] タブの各ポートフラグが実際に何をするのかを知っておくと役立ちます。なぜなら、そのうちの 2 つのフラグが、この変換の実際の処理を行っているからです。
| ポートタイプ | 何それがありません |
|---|---|
| 入力(I) | 上流の変換処理から列を受け取ります。ランク変換処理にリンクされているすべての列は入力ポートです。 |
| 出力(O) | 列を次の変換処理またはターゲットに渡します。 |
| 変数(V) | 式変換と同様に、変換内部にローカル計算を保持します。 |
| ランク(R) | ランキングの計算に使用される列を示します。変換処理において、このフラグを持つことができるポートは1つだけです。 |
| グループ化する | 異なる値ごとにランキングをリセットするため、上位3つのフィルターでは、全体で3行ではなく、グループごとに3行が返されます。 |
| ランクインデックス | デザイナーによって作成される出力専用ポート。グループ内の各行のランキング順位を格納し、接続せずに放置することも可能です。 |
ランキングは単一の港湾のみで行うことができるため、「最高給与、次に最長勤続年数」といった要件を満たすには、2位の港湾ではなく、上流でタイブレーク値を準備しておく必要がある。
Informaticaでランク変換を使用する方法
各部門の給与上位3名の従業員を読み込むことが要件です。これをランク変換を使用して実装します。マップの以下の8つのステップに従って作業を進めてください。ping デザイナー。
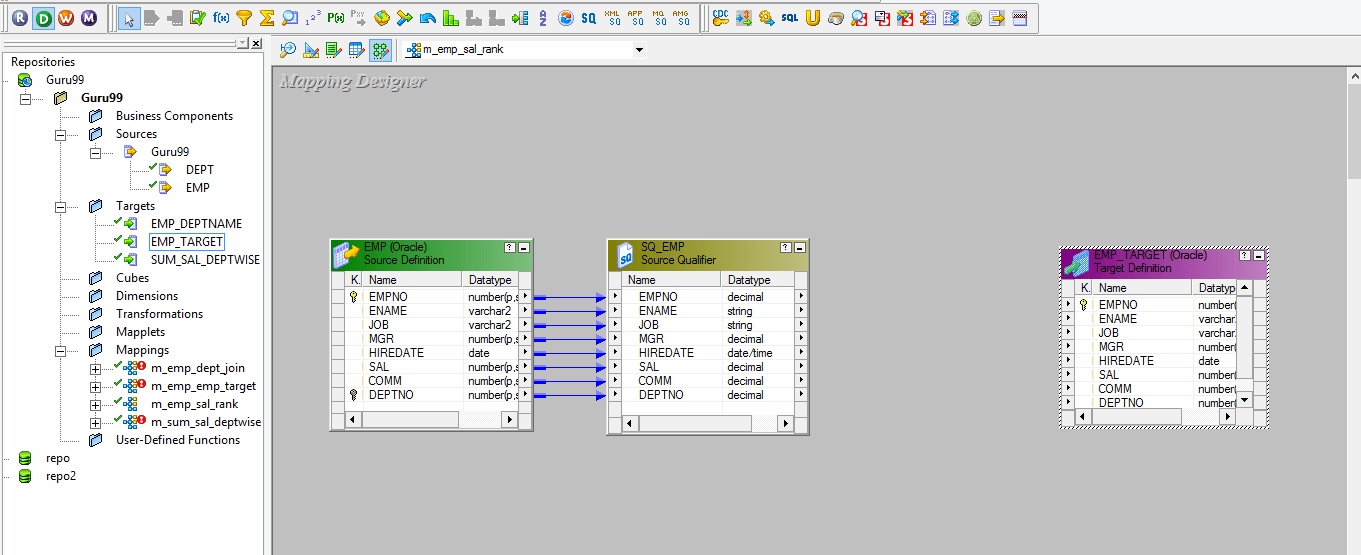
ステップ1) マップを作成するping ソースEMPとターゲットEMP_TARGETを持つ。両方の定義がキャンバス上に配置されている(下図参照)。
ステップ2) 次に地図上でping
- 変換メニューを選択
- 作成オプションを選択
次に、「作成」オプションを含む「変換」メニューが表示されます。

ステップ3) 変換の作成ウィンドウで
- ランク変換の選択
- 変換名「rnk_salary」を入力します
- 「作成」ボタンを選択します

ステップ4) ランク変換はマップ内に作成されますpingウィンドウ内の「完了」ボタンを選択します。すると、空のrnk_salaryオブジェクトがキャンバスに表示されます。

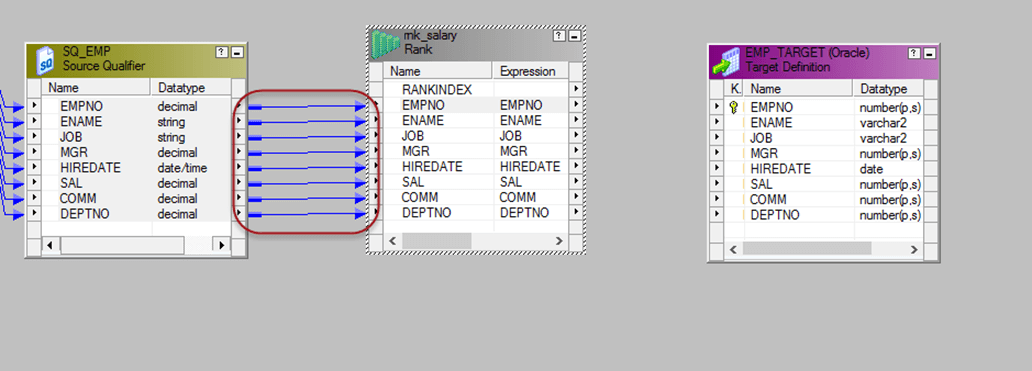
ステップ5) すべてのポートを接続します ソース修飾子 ランク変換を適用することで、すべての従業員列がランキングに使用できるようになります。
ステップ6) Double ランク変換をクリックすると、「変換の編集」ウィンドウが開きます。このウィンドウで
- プロパティメニューを選択
- 上/下プロパティから「上」オプションを選択します
- ランク数に 3 を入力します
スクリーンショットに示すように、「プロパティ」タブには「トップ」と表示され、3つのランクが表示されています。

ステップ7) 再度「変換編集」ウィンドウで
- 「ポート」タブの選択
- 部門番号列のグループ化オプションを選択します
- 給与列でランクを選択します
- [OK]ボタンを選択します
「港湾」タブでは、部門番号にグループフラグが、給与にRフラグが表示されるようになりました。

ステップ8) Rank変換のポートをターゲットテーブルに接続します。マップping 現在は、EMPからrnk_salaryを経由してEMP_TARGETへと処理が実行されます。

それでは、地図を保存してください。ping そして作成後にそれを実行する セッション (NAIST) と ワークフローソース修飾子はすべてのレコードを取得しますが、ランク変換では各部門で給与の高いレコードが3件あるレコードのみが渡されます。
ランク変換の特性
ステップ6で使用する「プロパティ」タブには、例で変更する2つの設定以外にも多くの設定項目があります。以下の設定項目は、保持する行数、文字列の比較方法、キャッシュファイルの書き込み場所などを制御します。
| プロパティ | 制御するもの |
|---|---|
| 上/下 | 順位付け列には、最高値と最低値のどちらを保持するか。この例では「上位」を使用します。 |
| ランク数 | グループごとに返される行数。この例では3を使用しているので、各部署から3人の従業員が返されます。 |
| 大文字小文字を区別する文字列比較 | 文字列比較において、順位付け時に大文字と小文字を区別するかどうか。これは、順位付け対象がテキストである場合にのみ重要になります。 |
| キャッシュディレクトリ | インデックスファイルとデータキャッシュファイルが作成されるディレクトリ。デフォルトはプロセス変数$PMCacheDirです。 |
| ランクデータキャッシュサイズ | 行データを保持するデータキャッシュのサイズ。デフォルトは「自動」で、統合サービスがサイズを決定します。 |
| ランクインデックスキャッシュサイズ | グループ値を保持するインデックスキャッシュのサイズ。デフォルトは自動です。 |
| 変革の範囲 | ランキングを各トランザクション、またはすべての受信データに適用します。 |
| Tracレベル | セッションログに書き込まれる詳細度:簡潔、標準、詳細な初期化、または詳細なデータ。 |
キャッシュサイズは、大規模なソースの場合に再検討する価値のある設定です。キャッシュが小さすぎると、統合サービスはディスクにページを書き込みます。これは、処理中に最初にチェックされる項目の1つです。 性能調整 地図のping.
ランク変換とアグリゲーター変換の比較
どちらの変換処理もアクティブで、入力データをキャッシュし、グループ化ポートも提供しているため、間違った処理を選択しやすい。違いは、それぞれの処理から出力される結果にある。
| 比較のポイント | ランク変換 | アグリゲーター変換 |
|---|---|---|
| 目的 | 各グループの上位または下位N行の完全な行を返します。 | SUMなどの計算値を返します。 AVGグループごとの最大値または最小値 |
| 返された行数 | グループごとのランク数まで、すべての列がそのままの状態 | 通常、グループごとに1行の要約行 |
| ポートが追加されました | RANKINDEXは、各行の位置を保持します。 | なし |
| 順位付けまたは集計された列 | 1つのポートがランクポートとしてフラグ付けされました | 集約式を運ぶポートはいくつでも構いません。 |
簡単に言えば、 アグリゲーター変換 は「この部署で最も高い給与はいくらか」という質問に答えますが、ランク変換は「どの従業員がそれを稼いでいるか」という質問に答えます。単純な条件に基づいて行のサブセットのみを破棄する必要があり、順序付けが関係しない場合は、 フィルタ変換 キャッシュを全く必要としないため、より安価な選択肢です。
