
Informatica でのジョイナー変換の例
 編集チーム
⚡ スマートサマリー
Informaticaにおけるジョイナー変換は、一致する条件に基づいて2つの異種ソースを結合するアクティブな接続オブジェクトであり、詳細パイプラインがそこを通過する間、マスターパイプラインをメモリにキャッシュします。
ジョイナー変換とは何ですか?
ジョイナー変換は、Informaticaで結合を作成するためのアクティブかつ接続された変換です。ジョイナー変換を使用して作成される結合は、データベースにおける結合と類似しています。ジョイナー変換の利点は、異種システム(異なるデータベース)間でも結合を作成できることです。
ジョイナー変換では、結合に使用するソースが 2 つあります。これらの 2 つのソースは、
- マスターソース
- 詳細ソース
ジョイナー変換のプロパティでは、どのデータソースをマスターソースにするか、どのデータソースを詳細ソースにするかを選択できます。
実行時には、マスターソースが結合処理のためにメモリにキャッシュされます。そのため、レコード数の少ないソースをマスターソースとして選択することをお勧めします。マスターパイプラインは2つのキャッシュに保持されます。1つは結合条件で使用される値を格納するインデックスキャッシュ、もう1つは残りの行データを格納するデータキャッシュです。
ジョイナー変換における結合の種類
プロパティタブの「結合タイプ」プロパティは、一致する行が見つからない場合にどう処理するかを決定します。ジョイナー変換を使用すると、以下の結合を作成できます。
- マスター外部結合 マスター外部結合では、詳細ソースからのすべてのレコードが結合によって返され、マスターソースからは一致する行のみが返されます。
- 詳細外部結合 詳細外部結合では、詳細ソースからは一致する行のみが返され、マスターソースからはすべての行が返されます。
- 完全外部結合 フル外部結合では、両方のソースからすべてのレコードが返されます。
- 通常の結合 通常の結合では、両方のソースから一致する行のみが返されます。
マスター外部結合と詳細外部結合は、左外部結合に相当します。 SQL: それぞれが一方のソースの全行を保持し、もう一方のソースからは一致する行のみを保持します。以下の表は、4つのタイプとそれに対応するSQLを対応付けたものです。
| 結合タイプ | マスターから保持された行 | 詳細から除外された行 | SQL相当 |
|---|---|---|---|
| 通常の結合 | マッチングのみ | マッチングのみ | 内部結合 |
| マスター外部結合 | マッチングのみ | すべての行 | 詳細ソースの左外部結合 |
| 詳細外部結合 | すべての行 | マッチングのみ | マスターソースの左外部結合 |
| 完全外部結合 | すべての行 | すべての行 | 完全外部結合 |
結合タイプはプロパティであり、構造的な選択ではないため、マップを再構築することなく後で変更できます。ping または、ポートを再リンクする。
Informaticaでジョイナー変換を使用する方法
この例では、Joiner変換を使用してempテーブルとdeptテーブルを結合します。マップの以下の8つのステップを実行してください。ping デザイナー。
ステップ1) 以下のスクリプトを使用してデータベースに新しいターゲットテーブルEMP_DEPTNAMEを作成し、そのテーブルをInformaticaターゲットにインポートします。
上記の emp_deptname.sql ファイルをダウンロードします。
ステップ2) 新しいを作成します 地図ping そして、ソーステーブル「EMP」と「DEPT」、および前の手順で作成したターゲットテーブルをインポートします。これで、3つの定義すべてがキャンバス上に表示されます(下図参照)。

ステップ3) 変換メニューから「作成」オプションを選択します。次に、以下に示す変換の作成ウィンドウで、
- ジョイナ変換の選択
- 変換名「jnr_emp_dept」を入力します
- 作成オプションを選択

ステップ4) 両方の列からすべての列をドラッグ アンド ドロップします。 ソース修飾子 Joiner変換へ。スクリーンショットに示すように、両方のパイプラインはjnr_emp_deptにリンクされています。

ステップ5) Double ジョイナー変換をクリックし、次に変換の編集ウィンドウで
- 条件タブを選択
- 新しい条件を追加アイコンをクリックします
- マスター列と詳細列のリストで部門番号を選択します
「条件」タブには、deptno の単一の結合条件が表示されます。

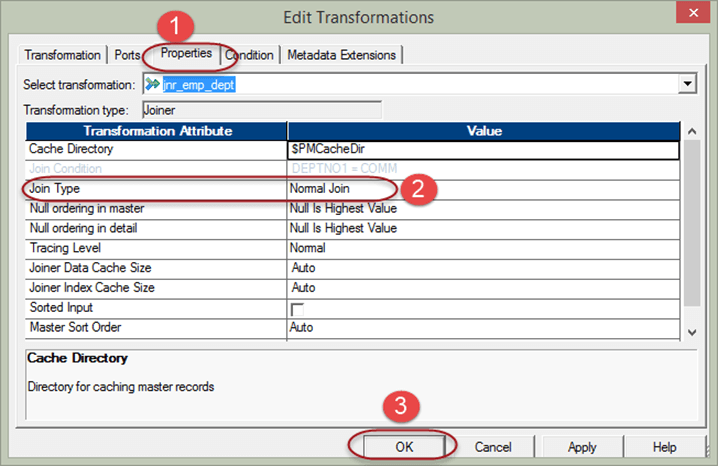
ステップ6) 次に、同じウィンドウで
- プロパティタブを選択します
- 結合タイプとして「通常結合」を選択してください。
- OKボタンを選択してください
次に、結合タイプが設定された「プロパティ」タブが表示されます。
パフォーマンスを最適化するため、レコード数の少ないソーステーブルパイプラインにマスターソースを割り当てます。このタスクを実行するには、次の手順に従ってください。
ステップ7) Double ジョイナー変換をクリックして変換の編集ウィンドウを開き、
- 「ポート」タブの選択
- マスターにしたい特定のソースの列を選択します
- [OK]を選択
「ポート」タブでは、選択したパイプラインがマスターとしてマークされます(下図参照)。

ステップ8) Joiner変換の関連列をターゲットテーブルにリンクします。マップping これで、両方のソースからEMP_DEPTNAMEへの結合を通じて処理が実行されます。
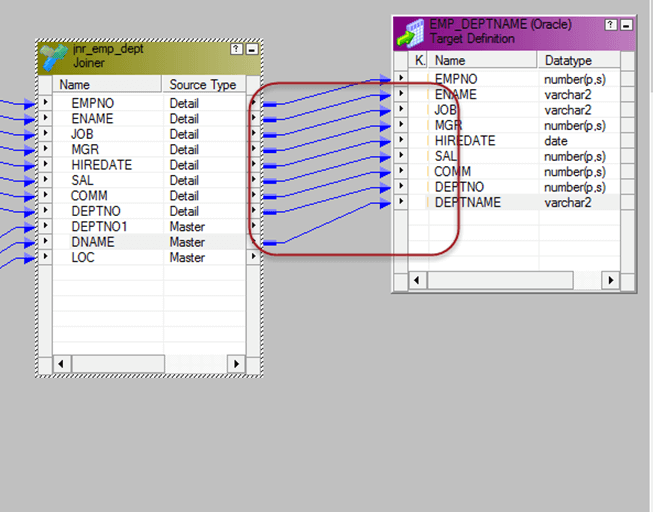
これでマップを保存できますping そして作成後にそれを実行する セッション (NAIST) と ワークフロー そのため、Informatica Joinerを使用して結合が作成され、関連する詳細情報が両方のテーブルから取得されます。
ジョイナー変換プロパティ
プロパティタブには、結合タイプ以外にも多くの情報が含まれています。以下の設定では、結合が使用するメモリ量とキャッシュファイルの書き込み場所を制御します。
| Setting | 制御するもの |
|---|---|
| 結合タイプ | 標準、マスターアウター、詳細アウター、またはフルアウター。一致しない行のうち、どの行を保持するかを決定します。 |
| 結合条件 | マスターポートとディテールポートのペアのリストを等号演算子で比較します。複数の条件がAND演算子で結合されます。 |
| ソートされた入力 | 両方のパイプラインが既に条件ポートでソートされた状態で到着することを宣言します。これにより、統合サービスはディスクの入出力を最小限に抑えることができます。 |
| マスターソート順 | マスターソースデータのソート順。ソート済みの入力データと併用されます。 |
| キャッシュディレクトリ | インデックスファイルとデータキャッシュファイルが作成されるディレクトリ。デフォルトはプロセス変数$PMCacheDirです。 |
| ジョイナーデータキャッシュサイズ | マスター行データを保持するデータキャッシュのサイズ。デフォルトは「自動」で、統合サービスがサイズを決定します。 |
| ジョイナーインデックスキャッシュサイズ | マスター条件値を保持するインデックスキャッシュのサイズ。デフォルトは自動です。 |
| 変革の範囲 | 結合を各トランザクション、すべての受信データ、または行レベルのスコープに適用します。 |
ソートされた入力は、最初に目指すべき設定です。両方のパイプラインが条件ポートによって順序付けされて到着すると、統合サービスはマッチングを開始する前にマスターソース全体を保持する必要がなくなります。これは、処理中に適用されるのと同じ原則です。 性能調整 その他のキャッシュされた変換。
ジョイナー変換のルールと制限
一部の制限は地図がping 検証済みなので、ポートをリンクする前にそれらを把握しておく方がコストが安くなります。
- 平等のみ。 結合条件では、ポートを等号演算子で比較します。より大きい、より小さい、等しくないなどの比較演算子は、この条件では使用できません。
- データ型を一致させています。 条件内の両方のポートは同じデータ型である必要があります。Designer はこれを検証するため、型が一致しない列は、通常は式変換で最初に変換する必要があります。
- 上流に更新戦略はありません。 いずれかの入力パイプラインに更新戦略変換が含まれている場合、結合変換は使用できません。
- シーケンスなし Generator その直前。 シーケンスの接続 Generator Joinerの直前での変換はサポートされていません。
- キャッシュ機能をオフにすることはできません。 マスターパイプラインは常にキャッシュされるため、ソースサイズが小さい方がマスター側に配置され、大規模な結合処理ではキャッシュサイズが重要になります。
3 つのソースを結合するには、2 つの Joiner 変換をチェーンする必要があります。これは、それぞれが正確に 1 つのマスター パイプラインと 1 つの詳細パイプラインを受け入れるためです。2 番目のソースが行ごとに読み取られる小さな参照テーブルである場合、 ルックアップ変換 多くの場合、よりシンプルなデザインである。
