
SAP Modélisation HANA : vues, tables et modèles de données
 Maçon García
⚡ Résumé intelligent
SAP La modélisation HANA crée des vues d'information qui transforment les tables de base de données brutes en modèles fonctionnels. Les vues d'attributs, analytiques et de calcul, la structure des packages, les privilèges requis et les règles de performance sont couverts par des conventions de nommage pratiques.

Qu'est-ce que le SAP Modélisation HANA ?
SAP La modélisation HANA consiste à créer une vue d'informations. Cette vue d'informations est similaire à une dimension, un cube ou un InfoProvider dans BW. Elle sert à créer le modèle de données multidimensionnel.
Les tables physiques à l'intérieur SAP HANA Les données sont conservées telles que fournies par le système source. La modélisation ajoute une couche supplémentaire à ces tables, qui renomme les colonnes, joint les enregistrements associés, applique des filtres et définit les calculs. Les outils de reporting lisent ensuite cette couche au lieu des tables, ce qui permet aux utilisateurs métier de ne jamais avoir à connaître la structure sous-jacente des tables.
SAP Présentation de la modélisation HANA
La modélisation est une activité qui consiste à affiner ou segmenter les données d'une table de base de données en créant une vue de l'information basée sur le scénario métier. Ces vues de l'information peuvent être utilisées à des fins de reporting et de prise de décision.
Une vue d'information est élaborée à partir de diverses combinaisons de données de contenu afin de créer un modèle pour un scénario d'entreprise.
Les données de contenu dans une vue d'informations sont de deux types :
- Attribut: DescriptDonnées mesurables et non mesurables. Par exemple : identifiant du fournisseur, nom du fournisseur, ville, etc.
- Mesure: Des données qui peuvent être quantifiées et calculées. Par exemple, RevEnue, Quantité vendue et Compteurs. Une mesure est dérivée d'une vue analytique et d'une vue de calcul. Il est impossible de créer une mesure dans une vue d'attribut.
Ces deux éléments constitutifs sont définis une seule fois dans la vue et réutilisés par chaque rapport qui l'utilise. Les sections ci-dessous listent les variantes exactes. SAP HANA prend en charge chacun d'eux.
Types d'attribut
SAP HANA prend en charge trois types d'attributs :
| Types d'attributs | Activités |
|---|---|
| Attribut simple | Elle est issue de la fondation de données. |
| Attribut calculé | Il est calculé à partir d'un ou plusieurs attributs et constantes existants. Par exemple, par un calcul arithmétique, ou en obtenant le nom complet à partir du prénom et du nom de famille. |
| Attribut local | Il est utilisé dans les vues de modélisation (vue analytique ou vue de calcul) pour personnaliser le comportement d'un attribut ; il est donc local à la vue. modélisation Cette vue est visible et ne peut être consultée depuis l'extérieur de cette vue. |
Types de mesures
SAP HANA prend en charge quatre types de mesures :
| Types de mesures | Activités |
|---|---|
| Mesure simple | Elle est issue de la fondation de données. |
| Mesure calculée | Elle est dérivée d'une ou plusieurs mesures, constantes et fonctions existantes. Par exemple, un calcul arithmétique. |
| Mesure restreinte | Il sert à filtrer les valeurs en fonction de règles définies par l'utilisateur pour les valeurs d'attributs. |
| Counter | Il s'agit d'un type de colonne particulier affichant un numéro unique pour les colonnes d'attributs (vue analytique ou vue de calcul). Elle sert à compter une ou plusieurs colonnes d'attributs. |
Une fois les attributs et les mesures définis, ils sont assemblés dans l'une des trois vues d'information suivantes :
- Vue des attributs – Ceci est utilisé pour le contexte des données de base.
- Vue analytique – Ceci sert à créer des tables de faits et est similaire à un cube dans BW.
- Vue de calcul – Ceci est utilisé pour créer une vue complexe et est similaire à un MultiProvider dans BW.
Avant que l'une de ces vues puisse être créée, le compte du modeleur a besoin d'un ensemble spécifique d'autorisations.
Privilèges requis pour la modélisation
Les privilèges assurent la sécurité des SAP Base de données HANA, qui permet à un utilisateur autorisé d'accéder uniquement au contenu autorisé.
Privilèges objet
Les privilèges d'objet sont SQL Les privilèges permettant d'accéder en lecture/écriture aux objets de la base de données sont requis pour la modélisation.
- Privilège SELECT sur le schéma _SYS_BI.
- Privilège SELECT sur le schéma _SYS_BIC.
- Privilège EXECUTE sur REPOSITORY_REST (SYS).
- Privilège SELECT sur le schéma de la table.
Privilèges du forfait
Des privilèges d'accès aux packages sont nécessaires pour autoriser les actions sur les packages individuels. Les privilèges d'accès aux packages ci-dessous sont requis pour la modélisation des données.
- Privilège REPO.MAINTAIN_NATIVE_PACKAGES sur le package racine.
- REPO.READ, REPO.EDIT_NATIVE_OBJECTS et REPO.ACTIVATE_NATIVE_OBJECTS sur le package utilisé pour les objets de contenu.
Privilèges analytiques
Pour accéder à un SAP Vue d'informations HANA, privilèges analytiques sont obligatoires.
- Pour accéder à l'intégralité des données et à toutes les vues d'information dans un SAP Le système HANA requiert le privilège analytique « _SYS_BI_CP_ALL ». Pour un accès restreint aux données, des privilèges analytiques doivent être créés et attribués à l'utilisateur.
Autres privilèges
- Accordez l'accès à votre propre schéma à l'utilisateur _SYS_REPO en tant que 'GRANT SELECT ON SCHEMA “Nom du schéma” TO _SYS_REPO WITH GRANT OPTION';
- REPO.MAINTAIN_DELIVERY_UNITS pour la création d'unités de livraison.
- REPO.IMPORT, REPO.EXPORT pour l'importation et l'exportation d'unités de livraison.
- REPO.WORK_IN_FOREIGN_WORKSPACES pour travailler dans des espaces de travail étrangers.
Différence entre la vue attribut, la vue analytique et la vue de calcul
Les trois vues d'information ne sont pas interchangeables. Chacune répond à une question différente, et choisir la mauvaise est l'erreur de modélisation la plus courante chez les débutants.
| Critères | Vue des attributs | Vue analytique | Vue de calcul |
|---|---|---|---|
| Interet | Données de référence et contexte descriptif | Schéma en étoile sur une seule table de faits | Logique complexe à travers de multiples sources |
| Mesures autorisées | Non | Oui | Oui |
| Nombre de tables de faits | N'est pas applicable | Un | Merci beaucoup |
| Le syndicat a soutenu | Non | Non | Oui |
| Peut consulter d'autres vues | Non | Vues d'attributs uniquement | Les trois types |
| équivalent BW | Caractéristique / dimension | InfoCube | Multifournisseur |
Une règle pratique fonctionne bien : construire un vue d'attribut lorsque le résultat est une liste descriptive, un vue analytique lorsqu'une table de faits est comparée à ces descriptions, et une vue de calcul lorsque la réponse nécessite une union, une deuxième table de faits ou une logique qu'un schéma en étoile ne peut pas exprimer.
SAP Les meilleures pratiques HANA pour la création de modèles d'information
An SAP Les bonnes pratiques HANA constituent une norme à suivre lors de la création d'un objet dans le système. SAP Base de données HANA. Les bonnes pratiques ci-dessous s'appliquent à chaque type d'objet.
PAQUET:
- Créez un package de niveau supérieur tel que « Développement » pour les travaux de développement.
- Créez un sous-package sous le package principal pour chaque développeur.
- D'autres sous-packages peuvent également être créés, si nécessaire.
SCHÉMA:
- Concevez votre schéma avant le début du projet. Par exemple : DS_SCHEMA, SLT_SCHEMA, FI_SCHEMA, SD_SCHEMA, etc.
- Les tables personnalisées doivent figurer dans un schéma séparé.
LES TABLES:
- Un tableau qui sera utilisé dans les rapports ou OLAP devrait être de type colonne.
- Une table qui sera utilisée dans les transactions ou OLTP devrait être de type magasin de lignes.
- Pour plus de clarté, veuillez ajouter un commentaire ou une description claire pour les noms de tableaux et de colonnes.
CONVENTION DE NOM :
| OBJETS | Format | Description |
|---|---|---|
| VUES D'ATTRIBUTS | AT_PRODUIT | AT_ signifie vue d'attribut |
| VUES ANALYTIQUES | AN_VENTES | AN_ signifie vue analytique |
| VUES DE CALCUL | CA_VENTES | CA_ signifie vue de calcul |
| PRIVILÈGES ANALYTIQUES | AP_REST_AT (Vue d'attribut) AP_REST_AN (Vue analytique) AP_REST_CA (Vue de calcul) |
AP_ signifie privilèges analytiques |
| HIÉRARCHIE | HI_BNAME_PC (Parent Enfant) HI_BNAME_LV (Niveau) |
HI_ signifie hiérarchie |
| PROCÉDURE | SP_NOM DE LA PROCÉDURE | SP_ signifie procédure stockée |
| PARAMÈTRES D'ENTRÉE | IP_PARA_NAME | IP_ signifie paramètre |
| VARIABLES | VA_VNOM | VA_ signifie nom de variable |
Cette convention d'appellation n'est pertinente que si chaque modèle est intégré à une structure de package planifiée, créée comme indiqué ci-après.
Création d'un package dans SAP Studio Hana
Paquet: Il s'agit d'un conteneur qui regroupe toutes les informations relatives au modèle (vue des attributs, vue analytique, vue de calcul, etc.).
Types de forfaits : Il existe deux types de colis, comme indiqué ci-dessous.
| Type | Description | Icône |
|---|---|---|
| Structural | Dans un package structurel, seul un sous-package peut être créé. Aucune vue d'information (vue d'attributs, vue analytique, etc.) ne peut être créée dans un package structurel. Exemples de paquetage structurel : SAP, system-local, system-local.generated et system-local.private. |
|
| Non structurel | Un paquet non structuré peut contenir des objets d'information et des sous-paquets. Il s'agit du paquet par défaut. |
|


Utilisations d'un paquet : Un paquet regroupe tous les modèles d'information et facilite leur transport. Les deux types de paquets peuvent être utilisés pour le transport.
Étapes de la création d'un package structurel dans SAP Studio HANA :
Étape 1) Dans cette étape,
- Sélectionnez le système HANA, ici il s'agit de HDB.
- Accédez au dossier Contenu.

Étape 2) Dans cette étape,
- Sélectionnez Nouveau.
- Sélectionnez l'option « Package ».

Étape 3) Dans cette étape,
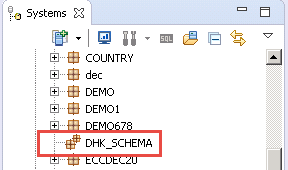
- Saisissez le nom du package. Par exemple : « DHK_SCHEMA ».
- Veuillez saisir une description du colis.
- La langue originale et la personne responsable sont sélectionnées par défaut.

Un package non structurel nommé « DHK_SCHEMA » sera créé dans le nœud Content, comme ci-dessous.

Étape 4) Maintenant, convertissez le paquetage non structurel en un paquetage structurel.
- Sélectionnez le paquet « DHK_SCHEMA » et faites un clic droit dessus.
- Accédez à l'option Modifier du paquet.

Étape 5) Dans cette étape,
- Sélectionnez « Oui » dans le champ Options structurelles.
- Cliquez sur le bouton OK.

Lorsque « DHK_SCHEMA » passe d'un package non structurel à un package structurel, le style des icônes change.  à
 Cela indique que le paquetage non structurel est maintenant converti en paquetage structurel.
Étapes pour créer un paquetage non structurel en tant que sous-paquetage d'un paquetage structurel :
Par défaut, un paquetage est créé comme non structuré. Dans un paquetage non structuré, d'autres paquetages et objets d'information peuvent être créés. Il est préférable de créer d'abord un paquetage structuré, puis d'y créer un sous-paquetage.
Étape 1) Dans cette étape,
- Sélectionnez le package structurel « DHK_SCHEMA » et cliquez dessus avec le bouton droit.
- Sélectionnez Nouveau -> Paquet.

Étape 2) Dans cette étape,
- Saisissez le nom du sous-package dans le champ Nom.
- Saisissez une description.
- Cliquez sur le bouton «OK».

Un nouveau paquet non structurel sera créé en tant que sous-paquet du paquet DHK_SCHEMA.

Comment activer et valider une vue d'information
L'enregistrement d'une vue la stocke uniquement dans le référentiel de conception. Tant qu'elle n'est pas activée, aucun objet d'exécution n'existe et aucun rapport ne peut y accéder. L'activation génère une vue de colonnes sous le schéma _SYS_BIC, et c'est cet objet généré que les outils SQL et de reporting interrogent.
Étape 1) Enregistrez la vue. Appuyez sur Ctrl+S dans SAP HANA Studio. La vue existe désormais en tant qu'objet inactif en mode conception, marqué d'un losange superposé dans le nœud Contenu.
Étape 2) Activer la vue. Cliquez avec le bouton droit sur la vue et sélectionnez Activer, ou appuyez sur Ctrl+F3. Choisissez « Activer » pour déployer uniquement cette vue, ou « Redéployer » pour reconstruire l’objet d’exécution lorsque la définition de conception n’a pas changé mais que l’objet généré est manquant.
Étape 3) Lire le journal des tâches. Le journal des tâches indique la réussite ou l'échec de chaque objet du lot d'activation. En cas d'échec, le nom de l'objet et la raison sont précisés ; il est donc conseillé de toujours développer l'entrée plutôt que de se fier au résumé.
Étape 4) Prévisualiser les données. Cliquez avec le bouton droit sur la vue activée et sélectionnez Aperçu des données. L'onglet Analyse permet de glisser les attributs sur l'axe des étiquettes et les mesures sur l'axe des valeurs, ce qui confirme que les jointures renvoient le nombre de lignes attendu.
Étape 5) Résoudre les erreurs d'activation courantes. Trois types de défaillances sont à l'origine de la plupart des cas :
- Privilèges insuffisants sur le schéma : _SYS_REPO ne dispose pas de l'autorisation SELECT WITH GRANT OPTION sur le schéma contenant les tables de base. Accordez-la et réactivez-la.
- Nom de colonne invalide : Une colonne de la table de base a été renommée ou supprimée après la modélisation de la vue. Actualisez les données de base et réaffectez le champ.
- Dépendance cyclique : Deux vues se référencent mutuellement. Pour rompre la boucle, faites pointer l'une d'elles vers la table sous-jacente.
Après une activation réussie, la vue peut être interrogée directement avec SELECT * FROM “_SYS_BIC”.package/VIEW_NAME”, ce qui est le moyen le plus rapide de confirmer l'existence de l'objet avant qu'un outil de reporting ne s'y connecte.
SAP Technique d'optimisation des performances HANA
Une vue activée qui renvoie des résultats corrects peut néanmoins être lente. Les règles ci-dessous déterminent la manière dont le moteur de calcul exécute le modèle.
- Toutes les vues d'information et les vues tabulaires doivent être utilisées avec un nœud de projection. Un nœud de projection améliore les performances en réduisant le nombre de colonnes.
- Appliquer les filtres aux nœuds de projection.
- Évitez les nœuds de jointure dans une vue de calcul et utilisez plutôt une union lorsque cela est possible.
- Utilisez des paramètres ou des variables d'entrée pour restreindre l'ensemble de données dans une vue analytique ou de calcul.
- Les calculs doivent être effectués avant l'agrégation.
- Les hiérarchies doivent être redéfinies dans une vue de calcul, car les hiérarchies d'une vue d'attribut ne sont pas visibles dans une vue de calcul.
- Les hiérarchies d'une vue d'attribut sont visibles dans une vue analytique.
- Les étiquettes des attributs et les descriptions des mesures définies dans une vue d'attributs, une vue analytique ou une vue de calcul ne s'affichent pas dans la vue de calcul utilisatrice. Il est nécessaire de les réassocier.
- Ne mélangez pas les fonctions CE et SQLScript dans le même modèle d'information.
La conception de la jointure influe également sur le temps d'exécution. Une jointure référentielle peut être entièrement supprimée lorsqu'aucun champ de la table appropriée n'est demandé, c'est pourquoi sélection du type de jointure mérite autant d'attention que le placement des nœuds.
Pourquoi les vues de calcul ont remplacé les vues d'attributs et les vues analytiques
SAP les vues d'attributs et les vues analytiques obsolètes, ainsi que le modèle XS Classic et le SAP Référentiel HANA. La dépréciation a été annoncée pour SAP HANA 1.0 SPS 12 et mis à jour pour SAP HANA 2.0 SPS 02. Déprécié signifie toujours pris en charge sur SAP HANA 2.0, mais pas reporté à la version suivante SAP HANA Cloud.
La raison est la consolidation plutôt que le remplacement de fonctions. Les extensions successives des modules de support ont étendu les vues de calcul jusqu'à absorber les capacités des deux autres types :
- Une vue de calcul de la catégorie de données Dimension, avec un nœud de projection au niveau de la couche sémantique, effectue le travail d'une vue d'attribut.
- Une vue de calcul de la catégorie de données Cube avec une jointure en étoile, avec un nœud d'agrégation au niveau sémantique, effectue le travail d'une vue analytique.
Un type de vue signifie également un chemin d'optimisation unique, un ensemble de modèles à apprendre et une cible de migration unique. SAP Il fournit un outil de migration qui convertit les vues d'attributs, les vues analytiques et les vues de calcul basées sur des scripts existantes en vues de calcul graphiques et en fonctions de table. Les vues existantes restent opérationnelles, ce qui permet de planifier la migration plutôt que de la précipiter. Cependant, tout nouveau développement doit commencer par les vues de calcul.
