
Python RegEx : re.match(), re.search(), re.findall() avec exemple
 Anna Blake
⚡ Résumé intelligent
Python Ce tutoriel sur les expressions régulières aborde les fonctions re.match, re.search, re.findall et re.split à travers des exemples pratiques. LessCes documents expliquent les métacaractères, les classes de caractères, les groupes, les indicateurs, la substitution et les modèles courants pour l'analyse et la validation de texte.
Qu'est-ce que l'expression régulière dans Python?
A Expression régulière (RE) Dans un langage de programmation, un motif de recherche est une chaîne de caractères spéciale utilisée pour décrire un modèle de recherche. Il est extrêmement utile pour…tracextraire des informations à partir de textes tels que du code, des fichiers, des journaux, des feuilles de calcul ou même des documents.
En utilisant le Python expression régulière la première chose à reconnaître est que tout est essentiellement un caractère et que nous écrivons des modèles pour correspondre à une séquence spécifique de caractères également appelée chaîne. Les lettres ascii ou latines sont celles qui se trouvent sur vos claviers et Unicode est utilisé pour faire correspondre le texte étranger. Il comprend les chiffres, la ponctuation et tous les caractères spéciaux comme $#@!%, etc.
Par exemple, un Python une expression régulière pourrait indiquer à un programme de rechercher un texte spécifique dans la chaîne, puis d'imprimer le résultat en conséquence. L'expression peut inclure
- Correspondance de texte
- Répétition
- Branchement
- Composition du motif, etc.
Expression régulière ou RegEx dans Python est noté RE (les RE, les regex ou les modèles d'expressions régulières) sont importés via concernant le module. Python prend en charge l'expression régulière via les bibliothèques. RegEx dans Python prend en charge diverses choses comme Modificateurs, identifiants et espaces blancs.
| Identifiants | Modificateurs | Caractères d'espacement blancs | Évasion requise |
|---|---|---|---|
| \d= n'importe quel nombre (un chiffre) | \d représente un chiffre.Ex : \d{1,5} il déclarera un chiffre compris entre 1,5 comme 424,444,545 etc. | \n = nouvelle ligne | . + * ? [] $ ^ () {} | \ |
| \D= tout sauf un nombre (un non-chiffre) | + = correspond à 1 ou plus | \s= espace | |
| \s = espace (tabulation, espace, nouvelle ligne, etc.) |
? = correspond à 0 ou 1 | \t =onglet | |
| \S= tout sauf un espace | * = 0 ou plus | \e = échapper | |
| \w = lettres ( Correspond au caractère alphanumérique, y compris « _ ») | $ correspond à la fin d'une chaîne | \r = retour chariot | |
| \W = tout sauf les lettres ( Correspond à un caractère non alphanumérique excluant « _ ») | ^ correspond au début d'une chaîne | \f= saut de page | |
| . = tout sauf des lettres (points) | | correspond soit à x/y | ------ | |
| \b = n'importe quel caractère sauf la nouvelle ligne | [] = plage ou « variance » | ------ | |
| \. | {x} = cette quantité de code précédent | ------ |
Syntaxe des expressions régulières (RE)
import re
- Module « re » inclus avec Python principalement utilisé pour la recherche et la manipulation de chaînes
- Également utilisé fréquemment pour la page Web "Scraping" (extrac(une grande quantité de données provenant de sites web)
Nous commencerons le didacticiel sur les expressions par cet exercice simple en utilisant les expressions (w+) et (^).
Exemple d'expression w+ et ^
- « ^ » : Cette expression correspond au début d'une chaîne
- "w +« : Cette expression correspond au caractère alphanumérique de la chaîne
Nous verrons ici un Python RegEx Exemple de la façon dont nous pouvons utiliser les expressions w+ et ^ dans notre code. Nous couvrons la fonction re.findall() dans Python, plus tard dans ce tutoriel, mais pendant un certain temps, nous nous concentrons simplement sur l'expression \w+ et \^.
Par exemple, pour notre chaîne « guru99, education is fun » si nous exécutons le code avec w+ et ^, cela donnera le résultat « guru99 ».
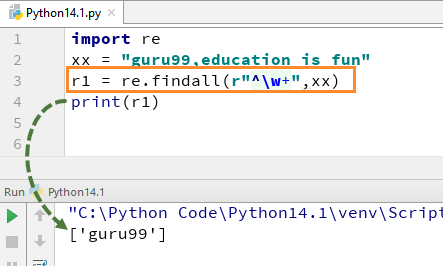
import re
xx = "guru99,education ">is fun"
r1 = re.findall(r"^\w+",xx)
print(r1)
N'oubliez pas que si vous supprimez le signe + du w+, le résultat changera et ne donnera que le premier caractère de la première lettre, c'est-à-dire [g]
Exemple d'expression \s dans la fonction re.split
- « s » : Cette expression est utilisée pour créer un espace dans la chaîne
Pour comprendre comment cette RegEx dans Python fonctionne, nous commençons par un simple Python RegEx Exemple de fonction fractionnée. Dans l'exemple, nous avons divisé chaque mot à l'aide de la fonction « re.split » et en même temps nous avons utilisé l'expression \s qui permet d'analyser chaque mot de la chaîne séparément.

Lorsque vous exécutez ce code, il vous donnera le résultat ['nous', 'sont', 'splitting', 'the', 'words'].
Voyons maintenant ce qui se passe si vous supprimez « \ » de s. Il n'y a pas d'alphabet « s » dans la sortie, c'est parce que nous avons supprimé « \ » de la chaîne, et il évalue « s » comme un caractère régulier et divise ainsi les mots partout où il trouve « s » dans la chaîne.
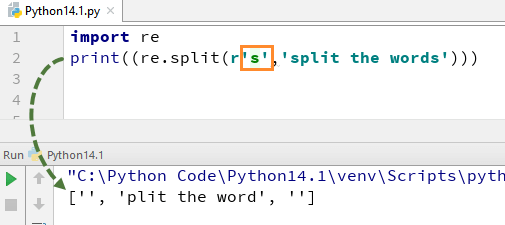
De même, il existe une série d'autres Python expression régulière que vous pouvez utiliser de différentes manières dans Python comme \d,\D,$,\.,\b, etc.
Voici le code complet
import re
xx = "guru99,education ">is fun"
r1 = re.findall(r"^\w+", xx)
print((re.split(r'\s','we are splitting the words')))
print((re.split(r's','split the words')))
Ensuite, nous verrons les types de méthodes utilisées avec les expressions régulières dans Python.
Utiliser des méthodes d'expression régulière
Le package « re » fournit plusieurs méthodes pour effectuer réellement des requêtes sur une chaîne d’entrée. Nous verrons les méthodes de re in Python:
- re.match()
- recherche()
- re.findall()
Note: Basé sur les expressions régulières, Python propose deux opérations primitives différentes. La méthode match recherche une correspondance uniquement au début de la chaîne tandis que la méthode search recherche une correspondance n'importe où dans la chaîne.
re.match()
re.match() fonction de re dans Python recherchera le modèle d'expression régulière et renverra la première occurrence. Le Python La méthode RegEx Match recherche une correspondance uniquement au début de la chaîne. Ainsi, si une correspondance est trouvée dans la première ligne, elle renvoie l'objet de correspondance. Mais si une correspondance est trouvée dans une autre ligne, le Python La fonction RegEx Match renvoie null.
Par exemple, considérons le code suivant de Python fonction re.match(). L'expression « w+ » et « \W » correspondra aux mots commençant par la lettre « g » et par la suite, tout ce qui ne commence pas par « g » n'est pas identifié. Pour vérifier la correspondance de chaque élément de la liste ou de la chaîne, nous exécutons la boucle for dans ce Python re.match() Exemple.

re.search() : recherche d'un modèle dans le texte
recherche() La fonction recherchera le modèle d’expression régulière et renverra la première occurrence. Contrairement à Python re.match(), il vérifiera toutes les lignes de la chaîne d'entrée. Le Python La fonction re.search() renvoie un objet de correspondance lorsque le modèle est trouvé et "null" si le modèle n'est pas trouvé
Comment utiliser la recherche() ?
Pour utiliser la fonction search(), vous devez importer Python re module d'abord, puis exécutez le code. Le Python La fonction re.search() prend le « motif » et le « texte » à analyser à partir de notre chaîne principale
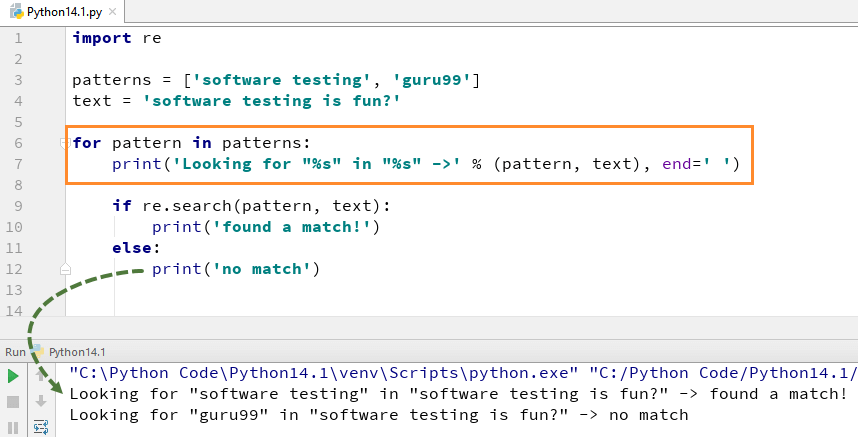
Par exemple, nous recherchons ici deux chaînes littérales « Software testing » « guru99 », dans une chaîne de texte « Software Tests c'est amusant ». Pour les « tests logiciels », nous avons trouvé la correspondance et renvoie donc la sortie de Python re.search() Exemple comme « trouvé une correspondance », tandis que pour le mot « guru99 », nous n'avons pas pu trouver dans la chaîne, il renvoie donc la sortie comme « Aucune correspondance ».
re.findall()
Trouver tout() Le module `findall()` permet de rechercher toutes les occurrences correspondant à un motif donné. À l'inverse, le module `search()` ne renvoie que la première occurrence correspondant au motif spécifié. `findall()` parcourt toutes les lignes du fichier et renvoie toutes les occurrences non superposées.ping Correspondances de motifs en une seule étape.
Comment utiliser re.findall() dans Python?
Ici, nous avons une liste d'adresses e-mail, et nous voulons que toutes les adresses e-mail soient extraites de la liste, nous utilisons la méthode re.findall() dans PythonIl trouvera toutes les adresses e-mail de la liste.
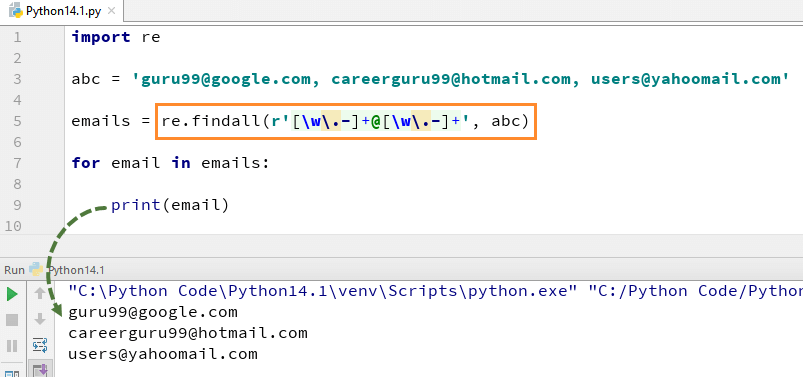
Voici le code complet pour l'exemple de re.findall()
import re

list = ["guru99 get", "guru99 give", "guru Selenium"]
for element in list:
    z = re.match("(g\w+)\W(g\w+)", element)
if z:
    print((z.groups()))

patterns = ['software testing', 'guru99']
text = 'software testing is fun?'
for pattern in patterns:
    print('Looking for "%s" in "%s" ->' % (pattern, text), end=' ')
    if re.search(pattern, text):
        print('found a match!')
else:
    print('no match')
abc = 'guru99@google.com, careerguru99@hotmail.com, users@yahoomail.com'
emails = re.findall(r'[\w\.-]+@[\w\.-]+', abc)
for email in emails:
    print(email)
Python Drapeaux
Merci beaucoup Python Les méthodes Regex et les fonctions Regex prennent un argument facultatif appelé Flags. Ces drapeaux peuvent modifier la signification de ce qui est donné Python Modèle d'expression régulière. Pour les comprendre, nous verrons un ou deux exemples de ces drapeaux.
Divers drapeaux utilisés dans Python inclut
| Syntaxe des indicateurs Regex | A quoi sert ce drapeau |
|---|---|
| [re.M] | Faire en sorte que le début/la fin considère chaque ligne |
| [re.I] | Il ignore le cas |
| [res.S] | Faire [ . ] |
| [re.U] | Make { \w,\W,\b,\B} suit les règles Unicode |
| [re.L] | Faire en sorte que {\w,\W,\b,\B} suive les paramètres régionaux |
| [re.X] | Autoriser les commentaires dans Regex |
Exemple de drapeaux re.M ou multilignes
En multiligne, le caractère de motif [^] correspond au premier caractère de la chaîne et au début de chaque ligne (suivant immédiatement chaque nouvelle ligne). Tandis que l'expression petit « w » est utilisée pour marquer l'espace avec des caractères. Lorsque vous exécutez le code, la première variable « k1 » imprime uniquement le caractère « g » pour le mot guru99, tandis que lorsque vous ajoutez un indicateur multiligne, elle récupère les premiers caractères de tous les éléments de la chaîne.
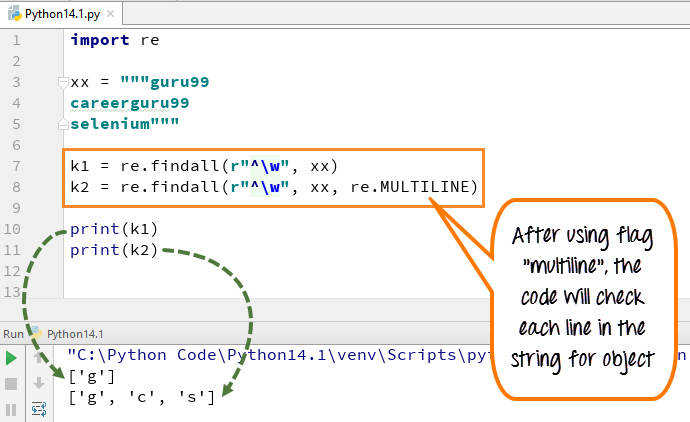
Voici le code
import re
xx = """guru99
careerguru99
selenium"""
k1 = re.findall(r"^\w", xx)
k2 = re.findall(r"^\w", xx, re.MULTILINE)
print(k1)
print(k2)
- Nous avons déclaré la variable xx pour la chaîne « guru99…. carrièregourou99….sélénium »
- Exécutez le code sans utiliser de drapeaux multilignes, il ne donne que le résultat « g » des lignes
- Exécutez le code avec l'indicateur « multiligne », lorsque vous imprimez « k2 », le résultat est « g », « c » et « s ».
- Ainsi, la différence que nous pouvons voir après et avant l’ajout de plusieurs lignes dans l’exemple ci-dessus.
De même, vous pouvez également utiliser d’autres Python des indicateurs comme re.U (Unicode), re.L (Suivre les paramètres régionaux), re.X (Autoriser les commentaires), etc.
Python 2 Exemple
Les codes ci-dessus sont Python 3 exemples, si vous souhaitez courir Python 2 veuillez considérer le code suivant.
# Example of w+ and ^ Expression
import re
xx = "guru99,education ">is fun"
r1 = re.findall(r"^\w+",xx)
print r1

# Example of \s expression in re.split function
import re
xx = "guru99,education ">is fun"
r1 = re.findall(r"^\w+", xx)
print (re.split(r'\s','we are splitting the words'))
print (re.split(r's','split the words'))

# Using re.findall for text
import re

list = ["guru99 get", "guru99 give", "guru Selenium"]
for element in list:
    z = re.match("(g\w+)\W(g\w+)", element)
if z:
    print(z.groups())

patterns = ['software testing', 'guru99']
text = 'software testing is fun?'
for pattern in patterns:
    print 'Looking for "%s" in "%s" ->' % (pattern, text),
    if re.search(pattern, text):
        print 'found a match!'
else:
    print 'no match'
abc = 'guru99@google.com, careerguru99@hotmail.com, users@yahoomail.com'
emails = re.findall(r'[\w\.-]+@[\w\.-]+', abc)
for email in emails:
    print email

# Example of re.M or Multiline Flags
import re
xx = """guru99
careerguru99
selenium"""
k1 = re.findall(r"^\w", xx)
k2 = re.findall(r"^\w", xx, re.MULTILINE)
print k1
print k2
Testez votre Python Connaissances
1. Quelle méthode est utilisée pour trouver toutes les occurrences d'un motif dans une chaîne ?
- recherche()
- re.match()
- re.findall()
- re.split()
2. Que représente la classe de caractères \d dans les expressions régulières ?
- N'importe quel chiffre (0-9)
- Tout caractère non numérique
- Tout caractère d'espacement
- N'importe quelle lettre ou chiffre
3. Quelle fonction utiliseriez-vous pour diviser une chaîne en fonction des espaces ?
- re.split(r'\s', chaîne)
- re.findall(r'\w+', chaîne)
- re.match(r'\s+', chaîne)
- re.split(r'\w+', chaîne)
4. Quelle est la principale différence entre re.match() et re.search() ?
- re.match() recherche un modèle au début d'une chaîne, tandis que re.search() recherche un modèle n'importe où dans la chaîne.
- re.match() renvoie toutes les correspondances, tandis que re.search() renvoie la première correspondance.
- re.search() est plus rapide que re.match().
- Les deux fonctions se comportent de la même manière.
