
Créer et déposer un INDEX dans Cassandra
 Équipe éditoriale
⚡ Résumé intelligent
Créer et supprimer un index dans Cassandra Permet de filtrer les colonnes qui ne font pas partie de la clé primaire. Cette page aborde les commandes CREATE INDEX et DROP INDEX, les règles de nommage, les types d'index disponibles et les cas où la création d'un index est inappropriée.
Cassandra Créer un index
La commande 'Créer un index' crée un index sur la colonne spécifiée par l'utilisateur. Si les données existent déjà pour la colonne que vous souhaitez indexer, Cassandra crée des index sur les données lors de l'exécution de l'instruction 'create index'.
- Après avoir créé un index, Cassandra indexe automatiquement les nouvelles données lorsque les données sont insérées.
- L'index ne peut pas être créé sur la clé primaire car une clé primaire est déjà indexée.
- Les index sur les colonnes de collection sont pris en charge, sous la forme KEYS, VALUES ou ENTRIES, selon ce qui doit être recherché.
- Sans indexation sur la colonne, Cassandra Impossible de filtrer cette colonne sauf s'il s'agit d'une clé primaire.
C'est pourquoi, pour filtrer les colonnes dans CassandraDes index doivent être créés.
Syntaxe
CREATE INDEX IndexName ON KeyspaceName.TableName (ColumnName);
Exemple
Voici l'instantané où il a été essayé de filtrer la colonne « dept » sans créer l'index. En réponse, l'erreur a été renvoyée.

Voici l'instantané où l'index est créé sur la colonne dept.

CREATE INDEX DeptIndex ON University.Student (dept);
Voici l'instantané où il sera filtré avec succès dans la colonne « département ».

SELECT * FROM University.Student WHERE dept = 'CS';
Le nom de l'index est facultatif. L'omettre permet Cassandra Il en génère un automatiquement, ce qui est important lorsque l'index doit être supprimé ultérieurement.
CREATE INDEX IF NOT EXISTS ON University.Student (dept);
Cassandra Supprimer l'index
La commande 'Supprimer l'index' supprime l'index spécifié. Si le nom de l'index n'a pas été donné lors de la création de l'index, alors le nom de l'index est TableName_ColumnName_idx.
- Si l'index n'existe pas, il renverra une erreur à moins que IF EXISTS ne soit utilisé, ce qui renverra no-op.
- Vous devez spécifier le nom de l'espace de clés avec le nom de l'index, sinon l'index sera recherché dans l'espace de clés actuel.
Syntaxe
DROP INDEX IF EXISTS KeyspaceName.IndexName;
Exemple
Voici l'instantané de la commande exécutée 'Drop index' qui supprime l'index DeptIndex.
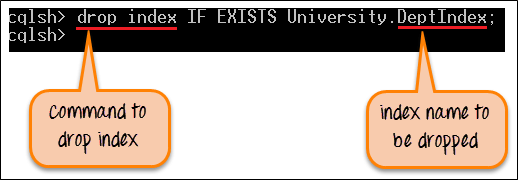
DROP INDEX IF EXISTS University.DeptIndex;
Après une exécution réussie de la commande, DeptIndex sera supprimé de l'espace de clés. Désormais, les données ne peuvent pas être filtrées par le service de colonnes.
Pour confirmer quels index existent avant la suppressionping Premièrement, décrivez le tableau et lisez les définitions d'index au bas du résultat.
DESCRIBE TABLE University.Student;
Types d'index dans Cassandra
La commande ci-dessus crée un index secondaire standard, mais il existe trois mécanismes distincts qui se comportent de manière très différente.
| Type | fonctionnement | Meilleur pour |
|---|---|---|
| Index secondaire | Chaque nœud indexe uniquement ses propres données locales ; par conséquent, une requête sans clé de partition doit contacter chaque nœud. | Colonnes de cardinalité modérée interrogées conjointement avec une clé de partition. |
| Indice SASI | Un index joint prenant en charge la correspondance de préfixes et de suffixes LIKE ainsi que les plages numériques. | Modèles de recherche textuelle. Encore expérimentaux, il est conseillé de les tester avant leur utilisation en production. |
| Index attaché au stockage (SAI) | Introduit en Cassandra 5.0, partage d'une seule structure d'index entre les colonnes avec une surcharge d'écriture réduite. | Le remplacement moderne des deux éléments ci-dessus sur Cassandra 5 groupes. |
L'indexation d'une colonne de collection utilise un modificateur qui indique quelle partie indexer.
CREATE INDEX ON University.Teacher (VALUES(Email));
CREATE INDEX ON University.Course (KEYS(prereq));
CREATE INDEX ON University.Course (ENTRIES(prereq));
VALUES recherche les éléments d'un ensemble ou d'une liste, KEYS recherche les clés d'une carte, et ENTRIES associe une paire clé-valeur. L'indexation des collections est traitée plus en détail dans la section suivante. Cassandra collections tutoriel.
Quand ne pas utiliser d'index dans Cassandra
Un index secondaire est pratique, mais ce n'est pas un index relationnel, et son utilisation inappropriée est une cause fréquente de ralentissements. Quatre situations requièrent une approche différente.
- Cardinalité très élevée. L'indexation d'un élément quasi unique, comme une adresse e-mail, signifie que presque chaque partition contient une ligne correspondante, la requête se propage donc sur l'ensemble du cluster pour renvoyer un seul enregistrement.
- Cardinalité très faible. L'indexation d'un indicateur à deux valeurs tel qu'actif ou inactif produit d'énormes partitions d'index, et la lecture d'une seule d'entre elles renvoie la moitié de la table.
- Colonnes fréquemment mises à jour. Chaque modification crée une entrée d'index et une marque de suppression pour l'ancienne, ce qui dégrade les lectures au fil du temps.
- Requêtes sans clé de partition. Sans cela, le coordinateur doit contacter chaque nœud et fusionner les résultats, ce qui n'est pas viable à mesure que de nouveaux nœuds sont ajoutés.
L'alternative durable consiste en une seconde table indexée par la colonne à rechercher, écrite simultanément à la première. Cela respecte le principe de la requête d'abord décrit dans le Cassandra règles du modèle de donnéeset il limite chaque lecture à une seule partition sur un seul nœud.
En règle générale, un index convient à une colonne de cardinalité modérée interrogée conjointement avec une clé de partition connue. Pour tout autre cas, une table dédiée est préférable.
