
R-tietokehys: Luominen, liittäminen, valinta ja osajoukko
 Toimituksellinen tiimi
⚡ Älykäs yhteenveto
R Data Frame tallentaa erityyppisiä sarakkeita yhtä pitkinä, mikä tekee siitä analyysin standardin suorakaiteen muotoisen rakenteen. Hakasulkeet viipaloivat rivejä ja sarakkeita, dollarimerkki saavuttaa sarakkeen ja subset() suodattaa ehdon mukaan.
Mikä on tietokehys?
A datakehys on lista vektoreita, joiden pituus on sama. Matriisi sisältää vain yhden tyyppistä dataa, kun taas datakehys hyväksyy erityyppisiä datamuotoja (numeerisia, merkki-, tekijä- jne.).
Tuo määritelmä sijoittaa datakehyksen kahden naapurin väliin, jotka kohtaat jatkuvasti R:ssä. A matriisi on suorakaiteen muotoinen, mutta yksityyppinen, ja lista on monityyppinen mutta epätasainen. Tietokehys lainaa yhden ominaisuuden jokaiselta.
| Tuote mallit | Saraketyypit | Elementtien pituudet | Tyypillinen käyttö |
|---|---|---|---|
| vektori | Vain yksi tyyppi | Yksittäinen sekvenssi | Yksi muuttuja |
| Matriisi | Vain yksi tyyppi | Suorakulmainen | Numeerinen algebra |
| Lista | Mikä tahansa tyyppien yhdistelmä | Voi vaihdella elementtikohtaisesti | Mielivaltaiset perinnät |
| Datakehys | Mikä tahansa tyyppien yhdistelmä | Jokainen sarake on yhtä pitkä | Taulukkoanalyysi |
Koska datakehys on itse asiassa alla oleva lista, listoissa käytetyt aksessorit toimivat myös tässä, minkä vuoksi dollarimerkki näkyy uudelleen myöhemmin tässä opetusohjelmassa.
Tietokehyksen luominen
Voimme luoda datakehyksen sisään R välittämällä muuttujat a, b, c ja d data.frame()-funktiolle. Voimme luoda datakehyksen ja nimetä sarakkeet names()-funktiolla, yksinkertaisesti määrittämällä kunkin muuttujan nimen.
data.frame(df, stringsAsFactors = TRUE)
argumentit:
- df: Se voi olla matriisi, joka muunnetaan tietokehykseksi tai kokoelma muuttujia, jotka yhdistetään
- stringsAsFactors: Määrittää, tulevatko merkkivektoreista tekijäsarakkeita. Tehdasasetus oli TRUE vanhemmissa versioissa ja FALSE R 4.0.0:sta lähtien, joten anna se erikseen, kun toiminnalla on merkitystä.
Voimme luoda tietokehyksen R:ssä ensimmäiselle tietojoukollemme yhdistämällä neljä samanpituista muuttujaa.
# Create a, b, c, d variables
a <- c(10,20,30,40)
b <- c('book', 'pen', 'textbook', 'pencil_case')
c <- c(TRUE,FALSE,TRUE,FALSE)
d <- c(2.5, 8, 10, 7)
# Join the variables to create a data frame
df <- data.frame(a,b,c,d)
df
lähtö:
##     a         b     c     d
## 1  10        book  TRUE   2.5
## 2  20         pen  FALSE  8.0
## 3  30    textbook  TRUE   10.0
## 4  40 pencil_case  FALSE  7.0
Jokaisesta vektorista tuli sarake, ja kunkin vektorin neljästä arvosta tuli neljä riviä. Huomaa, että argumentit olivat nimeämättömiä, joten R johti sarakeotsikot itsestään muuttujien nimistä.
Voimme nähdä, että sarakeotsikoilla on sama nimi kuin muuttujilla. Voimme muuttaa sarakkeen nimeä R:ssä funktiolla names(). Tarkista alla oleva R-luontitietokehyksen esimerkki:
# Name the data frame
names(df) <- c('ID', 'items', 'store', 'price')
df
lähtö:
##   ID       items store price
## 1 10        book  TRUE   2.5
## 2 20         pen FALSE   8.0
## 3 30    textbook  TRUE  10.0
## 4 40 pencil_case FALSE   7.0
Funktioon names() tehtävä määritys korvaa kaikki otsikot kerralla, joten korvaavassa vektorissa on oltava täsmälleen yksi merkintä saraketta kohden. Yhden sarakkeen nimeämiseksi uudelleen indeksoi nimivektori, kuten names(df)[2] <- 'product'.
# Print the structure
str(df)
lähtö:
## 'data.frame':    4 obs. of  4 variables:
##  $ ID   : num  10 20 30 40
##  $ items: Factor w/ 4 levels "book","pen","pencil_case",..: 1 2 4 3
##  $ store: logi  TRUE FALSE TRUE FALSE
##  $ price: num  2.5 8 10 7
Versiohuomautus. Yllä oleva tuloste on tuotettu R-versiossa, joka on vanhempi kuin versio 4.0.0, jossa data.frame() muunsi merkkivektorit oletusarvoisesti tekijöiksi, minkä vuoksi kohteet raportoidaan tekijänä, jolla on neljä tasoa. R-perusdokumentaatiossa on kirjattu, että tämä on tehtaan tuore oletusarvo. muutettu muotoon stringsAsFactors = FALSE R 4.0.0:ssaSaman koodin suorittaminen nykyisessä versiossa jättää alkiot tavalliseksi merkkisarakkeeksi ja str() tulostaa sen sijaan merkin chr. Lisää stringsAsFactors = TRUE data.frame()-kutsulle toistaaksesi tulosteen tai lue tekijäopas silloin, kun tekijöitä todella tarvitaan.
Leikkaa tietokehys
Kun kehys on rakennettu, seuraava tehtävä on vetää osia siitä takaisin ulos. Viipalointi on R:n perustapa tehdä se, ja siinä käytetään samoja hakasulkeita kuin vektoreissa, vain kahdessa kohdassa yhden sijaan.
Datakehyksen arvoja on mahdollista viipaloida. Valitsemme palautettavat rivit ja sarakkeet hakasulkeissa, joita edeltää datakehyksen nimi.
Tietokehys koostuu riveistä ja sarakkeista, df[A, B]. A edustaa rivejä ja B sarakkeita. Voimme viipaloida joko määrittämällä rivit ja/tai sarakkeet.
Alla olevasta kuvasta 1 vasen puoli edustaa rivit, ja oikea osa on sarakkeet. Huomaa, että symboli : tarkoittaa että. Esimerkiksi 1:3 aikoo valita arvot 1:stä että 3.

Alla olevassa kaaviossa näytämme, miten datakehyksen eri valintoihin pääsee käsiksi:
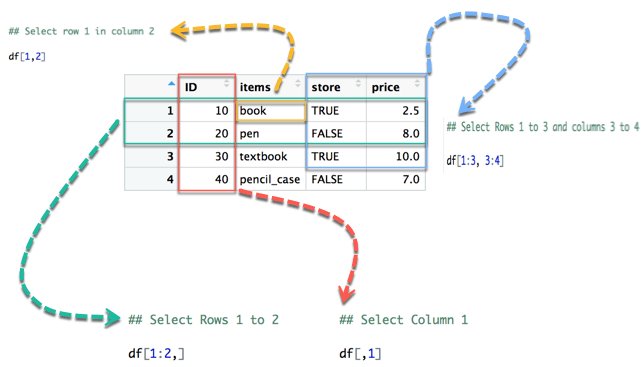
- Keltainen nuoli valitsee rivi 1 vuonna sarake 2
- Vihreä nuoli valitsee riviä 1 ja 2
- Punainen nuoli valitsee sarake 1
- Sininen nuoli valitsee riviä 1-3 ja sarakkeet 3 ja 4
Huomaa, että jos jätämme vasemman osan tyhjäksi, R valitsee kaikki rivit. Analogisesti, jos jätämme oikean osan tyhjäksi, R valitsee kaikki sarakkeet.
Voimme ajaa koodin konsolissa:
## Select row 1 in column 2
df[1,2]
lähtö:
## [1] book
## Levels: book pen pencil_case textbook
Levels-rivi tulee näkyviin, koska items (kohteet) ovat tässä istunnossa mukana. R 4.0.0:ssa ja uudemmissa versioissa sama kutsu tulostaa yksittäisen merkkijonon "book" ilman Levels-riviä.
## Select Rows 1 to 2
df[1:2,]
lähtö:
##   ID items store price
## 1 10  book  TRUE   2.5
## 2 20   pen FALSE   8.0
## Select Columns 1
df[,1]
lähtö:
## [1] 10 20 30 40
Yhden sarakkeen valitseminen df[,1]-funktiolla poistaa kehyskääreen ja palauttaa pelkän vektorin. Lisää drop = FALSE, kuten df[, 1, drop = FALSE], kun tarvitaan yksisarakkeinen datakehys.
## Select Rows 1 to 3 and columns 3 to 4
df[1:3, 3:4]
lähtö:
##   store price
## 1  TRUE   2.5
## 2 FALSE   8.0
## 3  TRUE  10.0
Sarakkeet voidaan valita myös niiden nimien perusteella. Esimerkiksi alla oleva koodi näyttäätrackaksi saraketta: ID ja store.
# Slice with columns name
df[, c('ID', 'store')]
lähtö:
##   ID store
## 1 10  TRUE
## 2 20 FALSE
## 3 30  TRUE
## 4 40 FALSE
Nimet ovat turvallisempia kuin sijainnit tuotantokoodissa, koska sarakkeen lisääminen tai uudelleenjärjestely muuttaa hiljaisesti sitä, mihin df[, 3] viittaa, kun taas df[, 'store'] osoittaa edelleen samaan dataan.
Liitä sarake tietokehykseen
Voit myös lisätä sarakkeen datakehykseen. Sinun on käytettävä symbolia $ uuden muuttujan nimeämiseen ja sarakkeen lisäämiseen datakehykseen R:ssä.
# Create a new vector
quantity <- c(10, 35, 40, 5)

# Add `quantity` to the `df` data frame
df$quantity <- quantity
df
lähtö:
##   ID       items store price quantity
## 1 10        book  TRUE   2.5       10
## 2 20         pen FALSE   8.0       35
## 3 30    textbook  TRUE  10.0       40
## 4 40 pencil_case FALSE   7.0        5
Huomautus: Vektorin elementtien lukumäärän on oltava yhtä suuri kuin datakehyksen elementtien lukumäärä. Seuraavan lauseen suorittaminen sarakkeen lisäämiseksi datakehykseen R:ssä
quantity <- c(10, 35, 40)
# Add `quantity` to the `df` data frame
df$quantity <- quantity
Antaa virheen:
Error in `lt;-.data.frame`(`*tmp*`, quantity, value = c(10, 35, 40))
replacement has 3 rows, data has 4
Viestissä nimetään datakehysten korvausoperaattori ja ilmoitetaan molemmat lukumäärät, joten se kertoo tarkalleen, mitä korjata. R kierrättää korvauksen vain, kun sen pituus jakaa rivien lukumäärän tasan, minkä vuoksi pituus-1-arvo, kuten df$currency <- 'EUR', hyväksytään, kun taas pituus-3-vektori neljää riviä vastaan hylätään. cbind() lisää sarakkeen samalla tavalla, ja rbind() on sen vastine rivien lisäämiseen.
Valitse tietokehyksen sarake
Joskus meidän on tallennettava datakehyksen sarake myöhempää käyttöä varten tai suoritettava sarakkeelle toiminto. Voimme käyttää $-merkkiä valitaksemme sarakkeen datakehyksestä.
# Select the column ID
df$ID
lähtö:
## [1] 1 2 3 4
Lue tuloste huolellisesti. ID muodostettiin vektorista c(10, 20, 30, 40), joten reaaliaikainen konsoli tulostaa tässä arvon 10 20 30 40; yllä näkyvät luvut 1 2 3 4 ovat rivin sijainteja eivätkä tallennettuja arvoja. Rivin alussa oleva [1] on yksinkertaisesti rivin ensimmäisen elementin indeksi, ei osa dataa.
Kolme reittiä päätyy samaan sarakkeeseen: df$ID, df[['ID']] ja df[, 'ID']. Dollarimerkki suorittaa osittaisen täsmäyksen, joten df$I löytäisi silti ID:n, mikä on kätevää konsolissa mutta riskialtista tallennetussa skriptissä.
Alajoukko tietokehys
Edellisessä osiossa valitsimme kokonaisen sarakkeen ilman ehtoja. Onko mahdollista osajoukko sen perusteella, onko tietty ehto totta vai ei.
Käytämme subset()-funktiota.
subset(x, condition)
arguments:
- x: data frame used to perform the subset
- condition: define the conditional statement
Haluamme palauttaa vain yli 5 euron hintaiset tuotteet, joten voimme tehdä seuraavaa:
# Select price above 5
subset(df, subset = price > 5)
lähtö:
ID       items store price
2 20         pen FALSE     8
3 30    textbook  TRUE    10
4 40 pencil_case FALSE     7
Riviotsikot 2, 3 ja 4 ovat alkuperäisiä rivien nimiä, jotka on siirretty df-muuttujasta, joten näin voit päätellä, että ensimmäinen rivi suodatettiin pois. subset() hyväksyy myös select-argumentin sarakkeiden valitsemiseksi samanaikaisesti, ja vastaava sulkeissa käytetty muoto on df[df$price > 5, ]. Suluissa käytetty muoto pitää rivit, joista ehto puuttuu, poissa käytöstä, kun taas subset() poistaa ne, joten nämä kaksi eivät ole aina keskenään vaihdettavissa.
