
PyTorch-opetusohjelma
 Evelyn Clarke
⚡ Älykäs yhteenveto
PyTorch on Metan avoimen lähdekoodin syväoppimiskehys, joka toimii nyt 85 prosentin tekoälytutkimusten pohjana vuonna 2026. LessKurssit kattavat asennuksen, kehyksen perusteet, yksinkertaisen regression, kuvien luokittelun ja AWS SageMakerin käyttöönoton.
Mikä on PyTorh?
PyTorch on avoimen lähdekoodin Torch-pohjainen koneoppimiskirjasto luonnollisen kielen käsittelyyn käyttäen PythonSe on samanlainen kuin NumPy, mutta siinä on tehokas GPU-tuki. Se tarjoaa dynaamisia laskennallisia graafeja, joita voit muokata liikkeellä ollessasi Autogradin avulla. PyTorch on myös nopeampi kuin jotkut muut kehykset. Sen kehitti Facebookin tekoälytutkimusryhmä vuonna 2016.
Tietäen mitä PyTorch tarkastelee tasapainoisesti sen vahvuuksia ja haittoja.
PyTorch:n edut ja haitat
Seuraavassa on Py:n edut ja haitatTorch:
Py:n edutTorch
- Yksinkertainen kirjasto
PyTorch-koodi on yksinkertainen. Se on helppo ymmärtää, ja kirjastoa voi käyttää välittömästi. Katso esimerkiksi alla olevaa koodinpätkää:
class Net(torch.nn.Module):
   def __init__(self):
       super(Net, self).__init__()
       self.layer = torch.nn.Linear(1, 1)

   def forward(self, x):
       x = self.layer(x)
       return x
Kuten edellä mainittiin, voit määrittää verkkomallin helposti ja ymmärrät koodin nopeasti ilman paljon harjoittelua.
- Dynaaminen laskennallinen kuvaaja

Kuvalähde: Syväoppimisen tutkiminen Py:n avullaTorch
PyTorch tarjoaa dynaamisen laskennallisen graafin (DAG). Laskennalliset graafit ovat tapa ilmaista matemaattisia lausekkeita graafimalleissa tai teorioissa, kuten solmuissa ja kaarissa. Solmu suorittaa matemaattisen operaation, ja kaari on tensori, joka syötetään solmuille ja kuljettaa solmun tulosteen tensorissa.
DAG on graafi, jolla on mielivaltainen muoto ja joka pystyy suorittamaan operaatioita eri syötekaavioiden välillä. Jokaisella iteraatiolla luodaan uusi kaavio. Joten on mahdollista käyttää samaa graafirakennetta tai luoda uusi graafi eri toiminnolla, tai voimme kutsua sitä dynaamiseksi graafiksi.
- Parempi suorituskyky
Yhteisöt ja tutkijat vertailemalla kehyksiä nähdäksesi kumpi on nopeampi. GitHub-repo Deep Learning Frameworks ja GPU:iden vertailu kertoi, että PyTorch on nopeampi kuin toinen kehys sekunnissa käsiteltyjen kuvien määrässä.
Kuten alla näet, vertailukaaviot vgg16:n ja resnet152:n kanssa


- Syntyperäinen Python
PyTorch on enemmän Python-pohjainen. Jos esimerkiksi haluat kouluttaa mallia, voit käyttää natiivia ohjauskulkua, kuten looping ja rekursiot ilman, että niiden suorittamiseen tarvitsee lisätä erikoismuuttujia tai istuntoja. Tämä on erittäin hyödyllistä koulutusprosessin kannalta.
PyTorch toteuttaa myös imperatiivista ohjelmointia, ja se on ehdottomasti joustavampi. Joten tensorin arvo voidaan tulostaa kesken laskentaprosessin.
Py:n haittapuoliTorch
PyTorch vaatii visualisointiin kolmannen osapuolen sovelluksia. Se tarvitsee myös API-palvelimen tuotantoa varten.
Seuraava tässä Py:ssäTorch-opetusohjelmassa opimme Py:n jaTorch ja TensorFlow.
PyTorch vs. TensorFlow
| Parametri | PyTorch | TensorFlow |
|---|---|---|
| Mallin määritelmä | Malli on määritelty alaluokkaan ja tarjoaa helppokäyttöisen paketin | Malli on määritelty monilla, ja sinun on ymmärrettävä syntaksi |
| GPU-tuki | Kyllä | Kyllä |
| Kaaviotyyppi | Dynaaminen | Staattinen |
| Työkalut | Ei visualisointityökalua | Voit käyttää Tensorboardin visualisointityökalua |
| yhteisö | Yhteisö kasvaa edelleen | Suuret aktiiviset yhteisöt |
Vertailu mielessä pitäen seuraava askel on saada PyTorch toimii paikallisesti tai pilvessä.
Py:n asentaminenTorch
Linux
Sen asentaminen Linuxiin on helppoa. Voit käyttää virtuaalista ympäristöä tai asentaa sen suoraan pääkäyttäjän oikeuksin. Kirjoita tämä komento terminaaliin
pip3 install --upgrade torch torchvision
AWS Sagemaker
Sagemaker on yksi alustoista Amazon Web-palvelu joka tarjoaa tehokkaan koneoppimismoottorin esiasennetuilla syväoppimiskokoonpanoilla datatieteilijöille tai kehittäjille, jotka voivat rakentaa, kouluttaa ja ottaa käyttöön malleja missä tahansa mittakaavassa.
Avaa ensin Amazon Sagemaker konsoli ja napsauta Luo muistikirjan esiintymä ja täytä kaikki muistikirjasi tiedot.

Seuraava vaihe, napsauta Avaa käynnistääksesi muistikirjan ilmentymä.

Lopuksi In Jupyter, Napsauta Uusi ja valitse conda_pytorch_p36, niin olet valmis käyttämään muistikirjainstanssiasi Py:n kanssa.Torch asennettu.
Seuraava tässä Py:ssäTorch-opetusohjelmassa opimme Py:stäTorch-kehyksen perusteet.
Asennus on tehty, ja seuraava vaihe on itse API.
PyTorch-kehyksen perusteet
Opitaan Py:n peruskäsitteetTorch ennen kuin syvennymme. PyTorch käyttää Tensoria jokaiselle muuttujalle samalla tavalla kuin numpy:n ndarray, mutta GPU-laskentatuella. Tässä selitämme verkkomallin, häviöfunktion, Backpropin ja optimoijan.
Verkkomalli
Verkko voidaan rakentaa alaluokittamalla taskulamppu.nn. Siinä on 2 pääosaa,
- Ensimmäinen osa on määrittää käytettävät parametrit ja tasot
- Toinen osa on päätehtävä, jota kutsutaan eteenpäin prosessiksi, joka ottaa syötteen ja ennustaa lähdön.
Import torch
import torch.nn as nn
import torch.nn.functional as F

class Model(nn.Module):
 def __init__(self):
        super(Model, self).__init__()
        self.conv1 = nn.Conv2d(3, 20, 5)
        self.conv2 = nn.Conv2d(20, 40, 5)
self.fc1 = nn.Linear(320, 10)

def forward(self, x):
       x = F.relu(self.conv1(x))
       x = F.relu(self.conv2(x))
       x = x.view(-1, 320)
       x = F.relu(self.fc1(x))
       return F.log_softmax(x)

net = Model()
Kuten yllä näet, luot nn.Module-luokan nimeltä Model. Se sisältää 2 Conv2d-tasoa ja lineaarisen kerroksen. Ensimmäinen conv2d-kerros ottaa syöttöarvon 3 ja ulostulomuodon 20. Toinen kerros ottaa syöttöarvon 20 ja tuottaa tulosteen muodon 40. Viimeinen kerros on täysin yhdistetty kerros, jonka muoto on 320 ja tuottaa lähtö 10.
Välitysprosessi ottaa X:n syötteen ja syöttää sen conv1-kerrokseen ja suorittaa ReLU-toiminnon,
Samalla tavalla se syöttää myös conv2-kerroksen. Sen jälkeen x muotoillaan uudelleen muotoon (-1, 320) ja syötetään lopulliseen FC-kerrokseen. Ennen kuin lähetät lähdön, käytät softmax-aktivointitoimintoa.
Autograd määrittelee taaksepäin prosessin automaattisesti, joten sinun tarvitsee vain määrittää eteenpäin prosessi.
Menetystoiminto
Häviöfunktiota käytetään mittaamaan, kuinka hyvin ennustusmalli pystyy ennustamaan odotettuja tuloksia. PyTorch:lla on jo useita standardihäviöfunktioita torch.nn-moduulissa. Voit esimerkiksi käyttää Cross-Entropy Loss -funktiota ratkaistaksesi moniluokkaisen Py-ongelman.Torch-luokitteluongelma. Häviöfunktion määrittely ja häviöiden laskeminen on helppoa:
loss_fn = nn.CrossEntropyLoss()

#training process
loss = loss_fn(out, target)
Oman tappiofunktion laskeminen Py:llä on helppoaTorch.
Backprop
Suorittaaksesi backpropagation, sinun tarvitsee vain kutsua los.backward(). Virhe lasketaan, mutta muista tyhjentää olemassa oleva gradientti komennolla zero_grad()
net.zero_grad() # to clear the existing gradient
loss.backward() # to perform backpropragation
Optimizer
Torch.optim tarjoaa yleisiä optimointialgoritmeja. Voit määrittää optimoijan yksinkertaisella vaiheella:
optimizer = torch.optim.SGD(net.parameters(), lr = 0.01, momentum=0.9)
Sinun on välitettävä verkkomallin parametrit ja oppimisnopeus, jotta parametrit päivitetään jokaisessa iteraatiossa backprop-prosessin jälkeen.
Puhtain tapa oppia API on pieni, kokonaisvaltainen esimerkki.
Yksinkertainen regressio Py:lläTorch
Opetellaan yksinkertaista regressiota Py:n avullaTorch-esimerkkejä:
Vaihe 1) Verkkomallimme luominen
Verkkomallimme on yksinkertainen lineaarinen kerros, jonka tulo- ja lähtömuoto on 1.
from __future__ import print_function

import torch
import torch.nn as nn
import torch.nn.functional as F
from torch.autograd import Variable

class Net(nn.Module):
   def __init__(self):
       super(Net, self).__init__()
       self.layer = torch.nn.Linear(1, 1)

   def forward(self, x):
       x = self.layer(x)
       return x

net = Net()
print(net)
Ja verkon lähdön pitäisi olla tällainen
Net(
  (hidden): Linear(in_features=1, out_features=1, bias=True)
)
Vaihe 2) Testitiedot
Ennen kuin aloitat koulutusprosessin, sinun on tiedettävä tietomme. Teet satunnaisen funktion mallimme testaamiseksi. Y = x3 sin(x)+ 3x+0.8 rand(100)
# Visualize our data
import matplotlib.pyplot as plt
import numpy as np

x = np.random.rand(100)
y = np.sin(x) * np.power(x,3) + 3*x + np.random.rand(100)*0.8

plt.scatter(x, y)
plt.show()
Tässä on funktiomme hajontakaavio:

Ennen harjoitusprosessin aloittamista sinun on muunnettava numpy-taulukko muuttujiksi, joita tukee Torch ja autograd, kuten alla olevassa Py-kaaviossa on esitettyTorch-regressioesimerkki.
# convert numpy array to tensor in shape of input size
x = torch.from_numpy(x.reshape(-1,1)).float()
y = torch.from_numpy(y.reshape(-1,1)).float()
print(x, y)
Vaihe 3) Optimoija ja häviö
Seuraavaksi sinun tulee määrittää koulutusprosessimme Optimizer ja Loss Function.
# Define Optimizer and Loss Function
optimizer = torch.optim.SGD(net.parameters(), lr=0.2)
loss_func = torch.nn.MSELoss()
Vaihe 4) Koulutus
Aloitetaan nyt koulutusprosessimme. 250:n aikakaudella toistat tietojamme löytääksesi parhaan arvon hyperparametreillemme.
inputs = Variable(x)
outputs = Variable(y)
for i in range(250):
   prediction = net(inputs)
   loss = loss_func(prediction, outputs)
   optimizer.zero_grad()
   loss.backward()
   optimizer.step()

   if i % 10 == 0:
       # plot and show learning process
       plt.cla()
       plt.scatter(x.data.numpy(), y.data.numpy())
       plt.plot(x.data.numpy(), prediction.data.numpy(), 'r-', lw=2)
       plt.text(0.5, 0, 'Loss=%.4f' % loss.data.numpy(), fontdict={'size': 10, 'color':  'red'})
       plt.pause(0.1)

plt.show()
Vaihe 5) Tulos
Kuten alla näet, suoritit Py:n onnistuneesti.Torch-regressio neuroverkolla. Itse asiassa jokaisella iteraatiolla kuvaajan punainen viiva päivittyy ja muuttaa sijaintiaan datan mukaan. Mutta tässä kuvassa se näyttää vain lopputuloksen, kuten alla olevassa Py-kaaviossa on esitetty.Torch-esimerkki:

Regressio on lämmittelyharjoitus; kuvien luokittelu harjoittaa Py:n syväoppimisen lihaksiaTorch.
Esimerkki kuvien luokittelusta Py:lläTorch
Yksi suosituimmista tavoista oppia perusasiat syvä oppiminen on MNIST-tietojoukon kanssa. Se on "Hei maailma" syvässä oppimisessa. Tietojoukko sisältää käsinkirjoitettuja numeroita 0–9, yhteensä 60,000 10,000 harjoitusnäytettä ja 28 28 testinäytettä, jotka on jo merkitty kooltaan XNUMX × XNUMX pikseliä.

Vaihe 1) Esikäsittele tiedot
Tämän Py:n ensimmäisessä vaiheessaTorch-luokitteluesimerkissä lataat tietojoukon torchvision-moduulilla.
Ennen kuin aloitat koulutusprosessin, sinun on ymmärrettävä data. Torchvision lataa tietojoukon ja muuntaa kuvat verkon vaatimusten, kuten muodon ja kuvien normalisoinnin, mukaisesti.
import torch
import torchvision
import numpy as np
from torchvision import datasets, models, transforms

# This is used to transform the images to Tensor and normalize it
transform = transforms.Compose(
   [transforms.ToTensor(),
    transforms.Normalize((0.5, 0.5, 0.5), (0.5, 0.5, 0.5))])

training = torchvision.datasets.MNIST(root='./data', train=True,
                                       download=True, transform=transform)
train_loader = torch.utils.data.DataLoader(training, batch_size=4,
                                         shuffle=True, num_workers=2)

testing = torchvision.datasets.MNIST(root='./data', train=False,
                                      download=True, transform=transform)
test_loader = torch.utils.data.DataLoader(testing, batch_size=4,
                                        shuffle=False, num_workers=2)

classes = ('0', '1', '2', '3',
          '4', '5', '6', '7', '8', '9')

import matplotlib.pyplot as plt
import numpy as np

#create an iterator for train_loader
# get random training images
data_iterator = iter(train_loader)
images, labels = data_iterator.next()

#plot 4 images to visualize the data
rows = 2
columns = 2
fig=plt.figure()
for i in range(4):
   fig.add_subplot(rows, columns, i+1)
   plt.title(classes[labels[i]])
   img = images[i] / 2 + 0.5     # this is for unnormalize the image
   img = torchvision.transforms.ToPILImage()(img)
   plt.imshow(img)
plt.show()
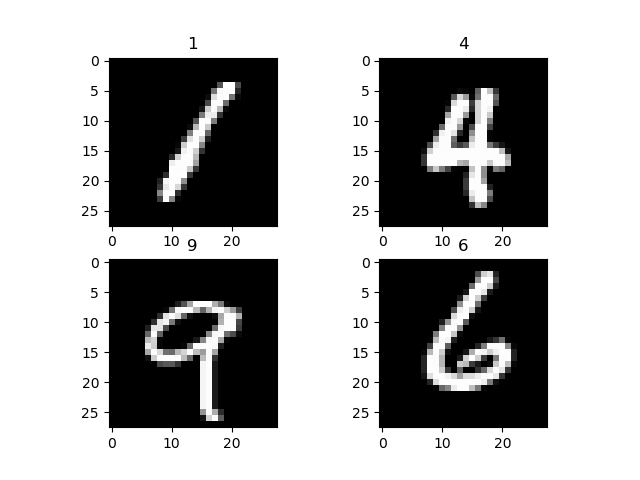
Muunnostoiminto muuntaa kuvat tensoriksi ja normalisoi arvon. Funktio torchvision.transforms.MNIST lataa tietojoukon (jos se ei ole saatavilla) hakemistoon, asettaa tietojoukon tarvittaessa koulutukseen ja suorittaa muunnosprosessin.
Tietojoukon visualisoimiseksi käytät data_iteraattoria saadaksesi seuraavan erän kuvia ja tarroja. Käytät matplotia näiden kuvien piirtämiseen ja niiden asianmukaiseen etikettiin. Kuten näet alla kuvamme ja niiden etiketit.
Vaihe 2) Verkkomallin määritys
Nyt tässä Py:ssäToresimerkissä teet yksinkertaisen neuroverkon Py:lleTorch-kuvan luokittelu.
Tässä esittelemme sinulle toisen tavan luoda verkkomalli Py:ssäTorch. Käytämme nn.Sequential-funktiota sekvenssimallin luomiseen nn.Modulen alaluokan luomisen sijaan.
import torch.nn as nn

# flatten the tensor into
class Flatten(nn.Module):
   def forward(self, input):
       return input.view(input.size(0), -1)

#sequential based model
seq_model = nn.Sequential(
           nn.Conv2d(1, 10, kernel_size=5),
           nn.MaxPool2d(2),
           nn.ReLU(),
           nn.Dropout2d(),
           nn.Conv2d(10, 20, kernel_size=5),
           nn.MaxPool2d(2),
           nn.ReLU(),
           Flatten(),
           nn.Linear(320, 50),
           nn.ReLU(),
           nn.Linear(50, 10),
           nn.Softmax(),
         )

net = seq_model
print(net)
Tässä on verkkomallimme tulos
Sequential(
  (0): Conv2d(1, 10, kernel_size=(5, 5), stride=(1, 1))
  (1): MaxPool2d(kernel_size=2, stride=2, padding=0, dilation=1, ceil_mode=False)
  (2): ReLU()
  (3): Dropout2d(p=0.5)
  (4): Conv2d(10, 20, kernel_size=(5, 5), stride=(1, 1))
  (5): MaxPool2d(kernel_size=2, stride=2, padding=0, dilation=1, ceil_mode=False)
  (6): ReLU()
  (7): Flatten()
  (8): Linear(in_features=320, out_features=50, bias=True)
  (9): ReLU()
  (10): Linear(in_features=50, out_features=10, bias=True)
  (11): Softmax()
)
Verkkoselitys
- Järjestys on, että ensimmäinen kerros on Conv2D-kerros, jonka tulomuoto on 1 ja lähtömuoto 10 ja ytimen koko 5
- Seuraavaksi sinulla on MaxPool2D-taso
- ReLU-aktivointitoiminto
- Dropout-kerros pienen todennäköisyyden arvojen pudottamiseksi.
- Sitten toinen Conv2d, jonka syöttömuoto on 10 viimeisestä kerroksesta ja lähtömuoto 20, ytimen koolla 5
- Seuraavaksi MaxPool2d-taso
- ReLU aktivointitoiminto.
- Tämän jälkeen tasoitat tensorin ennen kuin syötät sen Lineaarikerrokseen
- Linear Layer kartoittaa tulostemme toisessa Lineaarisessa kerroksessa softmax-aktivointitoiminnolla
Vaihe 3) Kouluta malli
Ennen kuin aloitat harjoitusprosessin, sinun on määritettävä kriteeri ja optimointitoiminto.
Kriteerin osalta käytät CrossEntropyLoss-funktiota. Optimoijan osalta käytät SGD:tä, jonka oppimisnopeus on 0.001 ja momentti 0.9, kuten alla olevassa Py-kaaviossa on esitetty.Torch-esimerkki.
import torch.optim as optim

criterion = nn.CrossEntropyLoss()
optimizer = optim.SGD(net.parameters(), lr=0.001, momentum=0.9)
Välitysprosessi ottaa syötemuodon ja välittää sen ensimmäiselle conv2d-kerrokselle. Sieltä se syötetään maxpool2d:hen ja lopulta ReLU-aktivointitoimintoon. Sama prosessi tapahtuu toisessa conv2d-kerroksessa. Sen jälkeen syöte muotoillaan uudelleen muotoon (-1,320 XNUMX) ja syötetään fc-kerrokseen lähdön ennustamiseksi.
Nyt aloitat koulutusprosessin. Toistat tietojoukkomme läpi 2 kertaa tai 2 jaksolla ja tulostat nykyisen häviön joka 2000 erän välein.
for epoch in range(2):

#set the running loss at each epoch to zero
   running_loss = 0.0
# we will enumerate the train loader with starting index of 0
# for each iteration (i) and the data (tuple of input and labels)
   for i, data in enumerate(train_loader, 0):
       inputs, labels = data

# clear the gradient
       optimizer.zero_grad()

#feed the input and acquire the output from network
       outputs = net(inputs)

#calculating the predicted and the expected loss
       loss = criterion(outputs, labels)

#compute the gradient
       loss.backward()

#update the parameters
       optimizer.step()

       # print statistics
       running_loss += loss.item()
       if i % 1000 == 0:
           print('[%d, %5d] loss: %.3f' %
                 (epoch + 1, i + 1, running_loss / 1000))
           running_loss = 0.0
Jokaisella aikakaudella luetteloija saa seuraavan syötteen ja vastaavat nimikkeet. Ennen kuin syötämme syötteen verkkomalliimme, meidän on tyhjennettävä edellinen gradientti. Tämä on tarpeen, koska taaksepäin prosessin (backpropagation) jälkeen gradientti kertyy sen sijaan, että se korvattaisiin. Sitten laskemme häviöt ennustetusta tuotosta odotetusta tuotosta. Sen jälkeen teemme backpropagation laskeaksemme gradientin ja lopuksi päivitämme parametrit.
Tässä harjoitusprosessin tulos
[1, 	1] loss: 0.002
[1,  1001] loss: 2.302
[1,  2001] loss: 2.295
[1,  3001] loss: 2.204
[1,  4001] loss: 1.930
[1,  5001] loss: 1.791
[1,  6001] loss: 1.756
[1,  7001] loss: 1.744
[1,  8001] loss: 1.696
[1,  9001] loss: 1.650
[1, 10001] loss: 1.640
[1, 11001] loss: 1.631
[1, 12001] loss: 1.631
[1, 13001] loss: 1.624
[1, 14001] loss: 1.616
[2, 	1] loss: 0.001
[2,  1001] loss: 1.604
[2,  2001] loss: 1.607
[2,  3001] loss: 1.602
[2,  4001] loss: 1.596
[2,  5001] loss: 1.608
[2,  6001] loss: 1.589
[2,  7001] loss: 1.610
[2,  8001] loss: 1.596
[2,  9001] loss: 1.598
[2, 10001] loss: 1.603
[2, 11001] loss: 1.596
[2, 12001] loss: 1.587
[2, 13001] loss: 1.596
[2, 14001] loss: 1.603
Vaihe 4) Testaa malli
Kun olet kouluttanut mallimme, sinun on testattava tai arvioitava muilla kuvasarjoilla.
Käytämme iteraattoria test_loaderille, ja se luo joukon kuvia ja tarroja, jotka välitetään koulutetulle mallille. Ennustettu tulos näytetään ja sitä verrataan odotettuun tehoon.
#make an iterator from test_loader
#Get a batch of training images
test_iterator = iter(test_loader)
images, labels = test_iterator.next()

results = net(images)
_, predicted = torch.max(results, 1)

print('Predicted: ', ' '.join('%5s' % classes[predicted[j]] for j in range(4)))

fig2 = plt.figure()
for i in range(4):
   fig2.add_subplot(rows, columns, i+1)
   plt.title('truth ' + classes[labels[i]] + ': predict ' + classes[predicted[i]])
   img = images[i] / 2 + 0.5     # this is to unnormalize the image
   img = torchvision.transforms.ToPILImage()(img)
   plt.imshow(img)
plt.show()

