
T-testi R-ohjelmoinnissa: Yksi otos ja paritettu esimerkki
 Toimituksellinen tiimi
⚡ Älykäs yhteenveto
R:n t-testi vertaa keskiarvoja t.test()-funktion avulla, kattaen yhden otoksen kiinteään kohteeseen, kahteen riippumattomaan ryhmään ja parittaisiin toistuviin mittauksiin. Tämä läpikäynti suorittaa jokaisen variantin, lukee p-arvon oikein ja varmistaa taustalla olevat oletukset.
Mikä on tilastollinen päättely?
Tilastollinen päättely on taitoa tehdä johtopäätöksiä datan jakaumasta. Datatieteilijä kohtaa usein kysymyksiä, joihin voidaan vastata vain tieteellisesti. Siksi tilastollinen päättely on strategia, jolla testataan, onko hypoteesi totta eli onko data validoinut sen.
Yleinen strategia hypoteesin arvioimiseksi on t-testi, joka kertoo, ovatko kaksi keskiarvoa yhtä suuret. Se tunnetaan myös nimellä Opiskelijan testiT-testi voidaan laskea seuraaville:
- Yksittäinen vektori kiinteää arvoa vasten (yhden otoksen t-testi)
- Kaksi vektoria kahdesta erillisestä ryhmästä (riippumaton kahden otoksen t-testi)
- Kaksi vektoria mitattuna samoilla koehenkilöillä (paritettu t-testi)
Jokainen t-testi olettaa, että tiedot on otettu satunnaisesti ja että arvot (tai paritestissä erot) tulevat suunnilleen normaalijakautuneesta populaatiosta. Kahden riippumattoman otoksen versio olettaa lisäksi, että kaksi ryhmää ovat toisistaan riippumattomia, ja klassinen muoto olettaa, että niiden varianssit ovat yhtä suuret.
Mikä on T-testi R-ohjelmoinnissa?
T-testin perusideana on käyttää tilastoja kahden päinvastaisen hypoteesin arvioimiseen:
- H0nollahypoteesi, jonka mukaan populaation keskiarvo on yhtä suuri kuin testattava arvo
- H1vaihtoehtoinen hypoteesi, että populaation keskiarvo eroaa tuosta arvosta
T-testi on suunniteltu pienille otoskoille, joissa normaaliapproksimaatio on epäluotettava. Se edellyttää, että data on suunnilleen normaalijakautunut.
T-testin syntaksi R:ssä
R:n t.test():n perussyntaksi on:
t.test(x, y = NULL,
       mu = 0, var.equal = FALSE)
arguments:
- x : A vector to compute the one-sample t-test
- y: A second vector to compute the two sample t-test
- mu: Mean of the population under the null hypothesis
- var.equal: Specify whether the variances of the two vectors are equal. By default, set to `FALSE`
- paired: Set to `TRUE` when the two vectors are repeated measures on the same subjects
Ennen kuin suoritat mitään, sovita datan asettelu testin oikeaan varianttiin.
T-testien tyypit R:ssä
Väärän variantin valitseminen on yleisin t-testin virhe, joten aloita sovittamalla datan asettelu oikeaan kutsuun.
| Tyyppi | Käytä sitä, kun | R-kutsu |
|---|---|---|
| Yhden näytteen | Yksi ryhmä verrattuna tunnettuun tavoitearvoon | t.test(x, mu = arvo) |
| Riippumaton kahden otoksen (Welch) | Kaksi erillistä ryhmää, varianssit mahdollisesti epätasaiset | t.testi(x, y) |
| Riippumaton kahden otoksen (yhdistetty) | Kaksi erillistä ryhmää, joilla on yhtä suuri varianssi | t.test(x, y, muuttuja.yhtä suuri = TOSI) |
| pariksi | Samat koehenkilöt mitattiin kahdesti | t.test(x, y, parillinen = TOSI) |
| Yksipuolinen | Välität vain yhden suunnan eroista | t.test(x, mu = arvo, vaihtoehto = “suurempi”) |
Kolmen ryhmän jälkeen t-testi ei ole enää sopiva. Siirry seuraavaan: ANOVA testi, mikä pitää kokonaisvirhesuhteen 5 prosentissa sen sijaan, että se nousisi toistuvien pareittain tehtyjen vertailujen välillä.
Yksi näyte T-testi R:ssä
One Sample t-testi eli Studentin testi vertaa vektorin keskiarvoa teoreettiseen keskiarvoon,  . T-testin laskemiseen käytetty kaava on:

Täällä
 viittaa keskiarvoon
 teoreettiseen keskiarvoon
- s on keskihajonta
- n havaintojen määrä.
 viittaa keskiarvoon
t-testin tilastollisen merkitsevyyden arvioimiseksi sinun on laskettava p-arvo. p-arvo vaihtelee välillä 0-1, ja se tulkitaan seuraavasti:
- P-arvo, joka on pienempi kuin 0.05, tarkoittaa, että nollahypoteesi voidaan hylätä. Huomaa, että H0:n hylkääminen ei ole sama asia kuin H1:n todistaminen todeksi, se tarkoittaa vain sitä, että data on epätodennäköistä H0:n vallitessa.
- P-arvo, joka on suurempi kuin 0.05, osoittaa, ettei nollahypoteesin hylkäämiseksi ole riittävästi todisteita.
Voit muodostaa p-arvon katsomalla vastaavaa t-testin itseisarvoa Studentin jakaumassa vapausasteilla 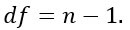
Esimerkiksi viiden havainnon perusteella vertaat t-arvoasi Studentin jakaumaan, jossa on neljä vapausastetta ja 95 prosentin luottamustaso. Nollahypoteesin hylkäämiseksi kaksipuolisessa testissä absoluuttisen t-arvon on oltava yli 2.776.
Katso alla oleva taulukko:

Yksi näyte-T-testiesimerkki kirjassa R
Oletetaan, että olet evästeitä valmistava yritys. Jokaisen keksin pitäisi sisältää 10 grammaa sokeria. Keksit valmistetaan koneella, joka lisää sokerin kulhoon ennen kaiken sekoittamista. Uskot, että kone ei lisää 10 grammaa sokeria jokaiseen evästeeseen. Jos olettamuksesi pitää paikkansa, kone on korjattava. Säilytit kolmenkymmenen keksin sokeritason.
Huomautuksia: Voit luoda satunnaistetun vektorin funktiolla rnorm(). Tämä funktio luo normaalijakauman arvoja. Perussyntaksi on:
rnorm(n, mean, sd)
arguments
- n: Number of observations to generate
- mean: The mean of the distribution. Optional
- sd: The standard deviation of the distribution. Optional
Voit luoda jakauman, jossa on 30 havaintoa, joiden keskiarvo on 9.99 ja keskihajonta 0.04.
set.seed(123)
sugar_cookie <- rnorm(30, mean = 9.99, sd = 0.04)
head(sugar_cookie)
lähtö:
## [1] 9.967581 9.980793 10.052348 9.992820 9.995172 10.058603
Voit käyttää yhden näytteen t-testiä tarkistaaksesi, onko sokeripitoisuus erilainen kuin reseptissä. Voit tehdä hypoteesitestin:
- H0: Keskimääräinen sokeritaso on 10
- H1: Keskimääräinen sokeritaso on eri kuin 10
Käytät merkitsevyystasoa 0.05.
# H0 : mu = 10
t.test(sugar_cookie, mu = 10)
Tässä on tuotos:

Yhden otoksen t-testin p-arvo on 0.1079, joka on yli 0.05 kynnysarvon. Keskiarvon 95 prosentin luottamusväli on 9.973–10.002 grammaa, ja se sisältää tavoitearvon 10. Et siis voi hylätä H0:a: ei ole riittävästi näyttöä siitä, että kone poikkeaa reseptistä.
Riippumaton kahden otoksen t-testi R:ssä
Kahden otoksen riippumaton t-testi on yleisimmin käytetty variantti, ja sitä sovelletaan aina, kun kaksi mittaussarjaa ovat peräisin eri koehenkilöiltä: kahdelta verstaselta, kahdelta koneelta, kahdelta hoitoryhmältä.
Oletetaan, että tehtaalla on kaksi tuotantolinjaa ja haluat tietää, täyttävätkö ne purkkeja samaan painoon.
set.seed(123)
line_a <- rnorm(25, mean = 500, sd = 8)
line_b <- rnorm(25, mean = 505, sd = 8)

# Welch test, the safe default
t.test(line_a, line_b)

# Pooled test, only when the variances are equal
t.test(line_a, line_b, var.equal = TRUE)
Lue tuloste neljässä vaiheessa.
- t on kahden keskiarvon välisen aukon standardoitu koko. Sen etumerkki heijastaa vain järjestystä, jossa vektorit välitettiin.
- df on vapausasteet. Welch tuottaa murtolukuarvon; yhdistetty testi antaa kokonaisluvun, joka on yhtä kuin n1 + n2 – 2.
- p-arvo on todennäköisyys nähdä näin suuri ero, jos todelliset keskiarvot olisivat identtiset.
- Luottamusväli rajaa todellisen eron. Kun se sisältää nollan, ero ei ole merkitsevä kyseisellä tasolla.
Jos datasi sijaitsee yhdessä datakehyksessä, jossa on yksi arvosarake ja yksi tekijäsarake, käytä sen sijaan kaavaliittymää, joka on helpompi lukea eikä vaadi datan jakamista manuaalisesti:
t.test(weight ~ line, data = jars)
Mitä versiota käyttää. Jätä var.equal oletusarvoonsa FALSE, ellet ole testannut ja vahvistanut yhtäläisiä varianssien arvoja. Welchin korjaus ei maksa juuri mitään, kun varianssit sattuvat olemaan samat, ja se suojaa sinua, kun ne eivät ole samat.
Parillinen T-testi R:ssä
Paritettu t-testi, jota kutsutaan myös riippuvan otoksen t-testiksi, soveltuu, kun sama ryhmä mitataan kahdesti. Tyypillisiä sovelluksia ovat:
- / B-testaus: Vertaa kahta versiota
- Tapaus-verrokkitutkimuksetennen ja jälkeen samojen kohteiden käsittelyn
Parillinen T-testiesimerkki kirjassa R
Juomayhtiö on kiinnostunut tietämään alennusohjelman toimivuuden myynnistä. Yritys päätti seurata päivittäistä myyntiä yhdessä ohjelmaa edistävässä liikkeessään. Ohjelman lopussa yritys haluaa tietää, onko kaupan keskimyynnin välillä tilastollista eroa ennen ohjelmaa ja sen jälkeen.
- Yritys tracseurasin myyntiä joka päivä ennen ohjelman alkua. Tämä on ensimmäinen vektorimme.
- Ohjelmaa mainostetaan viikon ajan ja myynti kirjataan joka päivä. Tämä on toinen vektorimme.
- Suoritat t-testin arvioidaksesi ohjelman tehokkuutta. Tätä kutsutaan pari-t-testiksi, koska molempien vektorien arvot tulevat samasta jakaumasta (eli samasta kaupasta).
Hypoteesin testaus on:
- H0: Ei eroa keskiarvossa
- H1: Nämä kaksi keinoa ovat erilaisia
Muista, että klassinen t-testi olettaa tuntemattoman, mutta yhtä suuren varianssin molemmissa ryhmissä. Todelliset tiedot harvoin täyttävät tämän täysin, ja eron huomiotta jättäminen voi vääristää tulosta.
Korjauskeinona on Welchin t-testi, joka lieventää yhtäläisen varianssin oletusta. R käyttää sitä oletusarvoisesti, koska var.equal on EPÄTOSI, ellet toisin mainitse. Tässä aineistossa molemmat vektorit luotiin samalla keskihajonnalla, joten voit turvallisesti asettaa var.equal = TOSI.
Luot Gaussin jakaumasta kaksi satunnaisvektoria, joilla on korkeampi keskiarvo ohjelman jälkeiselle myynnille.
set.seed(123)
# sales before the program
sales_before <- rnorm(7, mean = 50000, sd = 50)
# sales after the program.This has higher mean
sales_after <- rnorm(7, mean = 50075, sd = 50)
# draw the distribution
t.test(sales_before, sales_after,var.equal = TRUE)

p-arvo on 0.04606, juuri alle 0.05:n kynnysarvon, joten hylkäät H0:n ja päättelet, että kaksi keskiarvoa eroavat toisistaan merkittävästi. Alennusohjelma näyttää nostaneen myyntiä.
⚠️ Tärkeää: yllä oleva kutsu vertaa kahta vektoria seuraavasti itsenäinen näytteitä. Koska molemmat sarjat ovat saman työpajan mittauksia, tilastollisesti oikea päätös lisää paritettu = TOSI:
t.test(sales_before, sales_after, paired = TRUE)
Parillinen muoto testaa päivittäisten erojen keskiarvoa kahden keskiarvon erotuksen sijaan. Se poistaa molempien vektorien yhteisen työpaikkakohtaisen vaihtelun ja sillä on siksi enemmän tilastollista tehoa.
T-testin oletusten tarkistaminen R:ssä
T-testin p-arvo on merkityksellinen vain, kun sen oletukset pätevät. Jokaisella on suora tarkistus.
1. Normaalisuus. Yhden ja kahden otoksen testeissä oletetaan arvojen olevan suunnilleen normaaleja; paritettu testi olettaa, että erot ovat. Tutki QQ-kuvaajaa ja vahvista se Shapiro-Wilk-testillä:
qqnorm(sugar_cookie); qqline(sugar_cookie)
shapiro.test(sugar_cookie)

# for a paired design, test the differences
shapiro.test(sales_after - sales_before)
Shapiro-Wilkin p-arvo, joka on yli 0.05, tarkoittaa, että normaaliutta ei voida hylätä. Kun havaintoja ryhmää kohden on yli noin 30, keskeinen raja-arvolause tekee t-testistä joka tapauksessa vankan kohtalaiseen vinoumaan.
2. Yhtäläinen varianssi. Vain yhdistetty kahden otoksen testi tarvitsee tätä. Testaa se F-testillä:
var.test(line_a, line_b)
P-arvo, joka on yli 0.05, tukee yhtä suuria varianssiarvoja, mikä oikeuttaa muuttuja.yhtä suuri = TOSI.
3. Itsenäisyys. Tämä johtuu tutkimusasetelmasta, eikä sitä voida testata jälkikäteen. Jos sama koehenkilö vaikuttaa molempiin vektoreihin, riippumattomuustesti on yksinkertaisesti väärä työkalu ja tarvitaan parillinen = TOSI.
Kun oletus epäonnistuu. Selvästi epänormaalille datalle pienillä otoksilla käytä järjestysperusteisia vaihtoehtoja: wilcox.test(x, y) korvaa kahden otoksen t-testin ja wilcox.test(x, y, paired = TRUE) korvaa paritetun version. Kumpikaan ei vaadi normaaliutta, vaikka molemmat vähentävät hieman potenssia, kun data on todellisuudessa normaalia.
T-testi R:ssä: Keskeiset tiedot ja testiviite
- Tilastollinen päättely on taitoa tehdä johtopäätöksiä tietojen jakautumisesta.
- T-testi kuuluu päättelytilastojen perheeseen. Sitä käytetään yleisesti selvittämään, onko kahden ryhmän keskiarvojen välillä tilastollista eroa.
- Yhden otoksen t-testi eli Studentin testi vertaa vektorin keskiarvoa teoreettiseen keskiarvoon.
- Paritettu t-testi eli riippuvan otoksen t-testi soveltuu, kun sama ryhmä mitataan kahdesti.
Alla oleva taulukko esittää yhteenvedon jokaisesta yllä käsitellystä testistä:
| Testi | Hypoteesi testattavaksi | p-arvo | Code | Valinnainen argumentti |
|---|---|---|---|---|
| yhden otoksen t-testi | Vektorin keskiarvo on eri kuin teoreettinen keskiarvo | 0.05 |
t.test(x, mu = mean)
|
|
| parillinen näyte t-testi | Keskiarvo A eroaa keskiarvosta B samoilla koehenkilöillä | 0.05 |
t.test(A, B, paired = TRUE) |
var.equal = TRUE
|
Jos olet valmis olettamaan yhtä suuret varianssit riippumattomassa kahden otoksen testissä, aseta var.equal = TRUE. Jätä se oletusarvoiseen FALSE-arvoon suorittaaksesi turvallisemman Welch-korjauksen.
