
dplyr R-opetusohjelmassa: Yhdistä ja liitä tietoja esimerkkien avulla
 Evelyn Clarke
⚡ Älykäs yhteenveto
dplyr yhdistää ja liittää datakehyksiä R:ssä neljällä verbillä: left_join(), right_join(), inner_join() ja full_join(). Sen kumppanipaketti tidyr muotoilee sitten liitetyn tuloksen uudelleen käyttämällä gather()-, spread()-, separate()- ja unite()-funktioita.
Tietojen analysoinnin esittely
Ennen liittymistä tai uudelleenjakoaping verbi on järkevä, se auttaa näkemään, mihin datan manipulointi sopii. Tietojen analysointi voidaan jakaa kolmeen osaan:
- ExtracTUKSEN: Ensin meidän on kerättävä tiedot useista lähteistä ja yhdistettävä ne.
- Muuttaa: Tämä vaihe sisältää tietojen käsittelyn. Kun olemme yhdistäneet kaikki tietolähteet, voimme aloittaa tietojen puhdistamisen.
- havainnollistaa: Viimeinen askel on visualisoida tietomme epäsäännöllisyyden tarkistamiseksi.
Alla oleva kaavio näyttää, miten kolme vaihetta yhdistyvät.
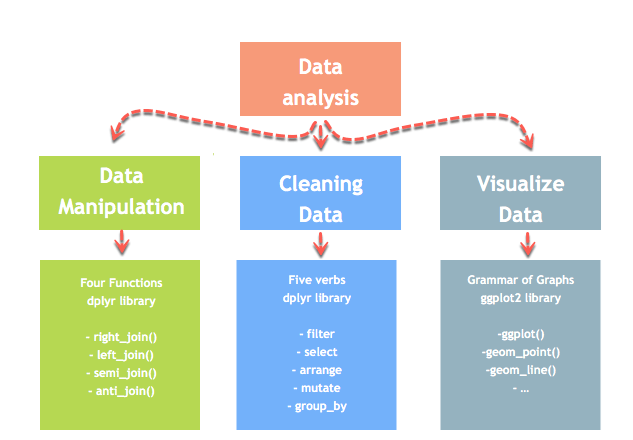
Yksi merkittävimmistä datatieteilijöiden kohtaamista haasteista on datan manipulointi. Dataa ei ole koskaan saatavilla halutussa muodossa. Datatieteilijöiden on käytettävä vähintään puolet ajastaan datan puhdistamiseen ja manipulointiin. Se on yksi työnsä kriittisimmistä tehtävistä. Jos datan manipulointiprosessi ei ole täydellinen, tarkka ja perusteellinen, malli ei toimi oikein.
R-dplyr
R:llä on datamuunnoksia käsittelevä paketti nimeltä dplyr. Se perustuu pieneen joukkoon ydinfunktioita – filter(), select(), arrange(), mutate() ja summarize() – sekä useisiin liitosfunktioihin. Kun data on muotoiltu, ggplot2 voi visualisoida sen.
Opimme käyttämään dplyr-pakettia tiedoston manipulointiin. DatakehysJos R:ää ei ole vielä asennettu, noudata R:n ja RStudion asennusvaiheetja suorita sitten install.packages(“dplyr”).
Yhdistä tiedot dplyr-ohjelmalla
dplyr tarjoaa mukavan ja kätevän tavan yhdistää tietojoukkoja. Meillä voi olla monia syöttötietolähteitä, ja jossain vaiheessa meidän on yhdistettävä ne. Liittäminen dplyr:n kanssa lisää muuttujia alkuperäisen tietojoukon oikealle puolelle.
dplyr-liitokset
Seuraavassa on neljä tärkeää liitostyyppiä, joita käytetään dplyr-funktiossa kahden tietojoukon yhdistämiseen. Kaikki neljä ottavat samat argumentit – kaksi taulukkoa ja avaimen – ja eroavat toisistaan vain siinä, mitkä yhteensopimattomat rivit säilyvät:
| Toiminto | Tavoite | argumentit | Useita näppäimiä |
|---|---|---|---|
| left_join() | Yhdistä kaksi tietojoukkoa. Säilytä kaikki havainnot alkuperätaulukosta | x, y, jonka = ”ID” | x, y, by = c("ID", "ID2") |
| right_join() | Yhdistä kaksi tietojoukkoa. Säilytä kaikki havainnot kohdetaulukosta | x, y, jonka = ”ID” | x, y, by = c("ID", "ID2") |
| inner_join() | Yhdistä kaksi tietojoukkoa. Poista kaikki yhteensopimattomat rivit. | x, y, jonka = ”ID” | x, y, by = c("ID", "ID2") |
| full_join() | Yhdistä kaksi tietojoukkoa. Säilytä kaikki havainnot. | x, y, jonka = ”ID” | x, y, by = c("ID", "ID2") |
Nämä neljä verbiä vastaavat LEFT, RIGHT, INNER ja FULL OUTER -liitoksia SQLKantaluku R pääsee samoihin tuloksiin käyttämällä funktion all-, all.x- ja all.y-argumentteja yhdistää().
Tutkimme kaikkia liitostyyppejä helpon esimerkin avulla.
Ensin rakennamme kaksi datajoukkoa. Taulukko 1 sisältää kaksi muuttujaa, ID:n ja y:n, kun taas taulukko 2 sisältää ID:n ja z:n. Kummassakin tilanteessa tarvitsemme avainpari muuttuja. Meidän tapauksessamme henkilöllisyystodistus on meidän avain muuttuja. Funktio etsii identtisiä arvoja molemmista taulukoista ja sitoo palauttavat arvot taulukon 1 oikealle puolelle. Alla oleva kuva näyttää kaksi taulukkoa vierekkäin.

library(dplyr)
df_primary <- tribble(
  ~ID, ~y,
   "A", 5,
   "B", 5,
   "C", 8,
   "D", 0,
  "F", 9)
df_secondary <- tribble(
  ~ID, ~z,
   "A", 30,
   "B", 21,
   "C", 22,
   "D", 25,
   "E", 29)
dplyr left_join()
Yleisin tapa yhdistää kaksi tietojoukkoa on käyttää left_join()-funktiota. Alla oleva kuva näyttää, että avainpari vastaa rivejä A, B, C ja D, kun taas E ja F jäävät jäljelle. left_join()-funktiolla säilytämme kaikki rivit alkuperäisessä taulukossa ja jätämme huomiotta rivit, joilla ei ole avainparia kohdetaulukossa. Esimerkissämme arvoa E ei ole taulukossa 1, joten kyseinen rivi jätetään pois. Arvo F tulee alkuperäisestä taulukosta, joten se säilytetään left_join()-funktion jälkeen ja palauttaa arvon NA sarakkeessa z.
Esimerkki komennosta dplyr left_join()
Alla oleva kaavio näyttää, mitä left_join()-funktion aikana tapahtuu.

left_join(df_primary, df_secondary, by ='ID')
lähtö:
##
# A tibble: 5 x 3
##      ID   y.x   y.y
##   <chr> <dbl> <dbl>
## 1     A     5    30
## 2     B     5    21
## 3     C     8    22
## 4     D     0    25
## 5     F     9    NA
Huomaa, että kun molemmissa taulukoissa on samanniminen sarake, dplyr yksiselitteistää ne yllä olevilla .x- ja .y-päätteillä.
dplyr oikea_liitos()
Right_join()-funktio toimii täsmälleen kuten left_join(). Ainoa ero on rivi pudonnut. Kohdedatakehyksessä käytettävissä oleva arvo E on uudessa taulukossa ja saa arvon NA sarakkeelle y.
Esimerkki komennosta dplyr right_join()
Alla oleva kaavio näyttää peilikuvan.

right_join(df_primary, df_secondary, by = 'ID')
lähtö:
##
# A tibble: 5 x 3
##      ID   y.x   y.y
##   <chr> <dbl> <dbl>
## 1     A     5    30
## 2     B     5    21
## 3     C     8    22
## 4     D     0    25
## 5     E    NA    29
dplyr inner_join()
Kun yhteensopimattomat havainnot eivät ole lainkaan hyödyllisiä, voimme palata vain rivit, jotka ovat olemassa sekä datajoukot. Tämä on oikea valinta, kun tarvitsemme täydellisen datajoukon emmekä halua implisoida puuttuvia arvoja keskiarvolla tai mediaanilla.
Tässä apuna tulee inner_join()-funktio. Se sulkee pois molempien puolien yhteensopimattomat rivit.
Esimerkki komennosta dplyr inner_join()
Alla oleva kaavio korostaa neljää tunnistetta, jotka säilyvät liittymisen jälkeen.

inner_join(df_primary, df_secondary, by ='ID')
lähtö:
##
# A tibble: 4 x 3
##      ID   y.x   y.y
##   <chr> <dbl> <dbl>
## 1     A     5    30
## 2     B     5    21
## 3     C     8    22
## 4     D     0    25
dplyr full_join()
Lopuksi full_join()-funktio säilyttää kaikki havainnot ja korvaa puuttuvat arvot NA-arvolla.
Esimerkki komennosta dplyr full_join()
Alla oleva kaavio näyttää jokaisen tunnuksen molemmista taulukoista, jotka selviävät liittymisestä.

full_join(df_primary, df_secondary, by = 'ID')
lähtö:
## # A tibble: 6 x 3
##      ID   y.x   y.y
##   <chr> <dbl> <dbl>
## 1     A     5    30
## 2     B     5    21
## 3     C     8    22
## 4     D     0    25
## 5     F     9    NA
## 6     E    NA    29
Useita avainpareja
Viimeisenä muttei vähäisimpänä, datasetissämme voi olla useita avaimia. Tarkastellaan seuraavaa datasetiä, jossa on vuodet ja luettelo asiakkaan ostamista tuotteista. Alla olevassa kuvakaappauksessa näkyvät kaksi taulukkoa sekä ID- ja year-sarakkeet, jotka yhdessä tunnistavat rivin.
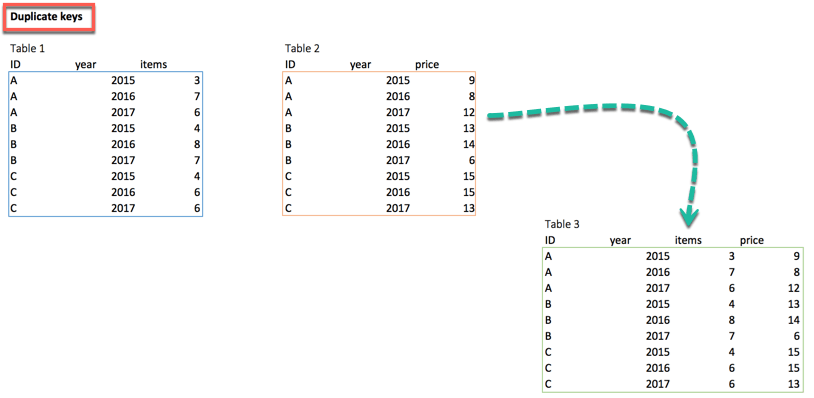
Jos yhdistämme molemmat taulukot pelkästään ID:n perusteella, jokainen vuosi täsmää jokaista vuotta vastaan ja rivimäärä räjähtää. Tilanteen korjaamiseksi voimme välittää kaksi avainparimuuttujaa. Eli ID ja year, jotka esiintyvät molemmissa tietojoukoissa. Voimme käyttää seuraavaa koodia taulukoiden 1 ja 2 yhdistämiseen:
df_primary <- tribble(
  ~ID, ~year, ~items,
  "A", 2015,3,
  "A", 2016,7,
  "A", 2017,6,
  "B", 2015,4,
  "B", 2016,8,
  "B", 2017,7,
  "C", 2015,4,
  "C", 2016,6,
  "C", 2017,6)
df_secondary <- tribble(
  ~ID, ~year, ~prices,
  "A", 2015,9,
  "A", 2016,8,
  "A", 2017,12,
  "B", 2015,13,
  "B", 2016,14,
  "B", 2017,6,
  "C", 2015,15,
  "C", 2016,15,
  "C", 2017,13)
left_join(df_primary, df_secondary, by = c('ID', 'year'))
lähtö:
## # A tibble: 9 x 4
##      ID  year items prices
##   <chr> <dbl> <dbl>  <dbl>
## 1     A  2015     3      9
## 2     A  2016     7      8
## 3     A  2017     6     12
## 4     B  2015     4     13
## 5     B  2016     8     14
## 6     B  2017     7      6
## 7     C  2015     4     15
## 8     C  2016     6     15
## 9     C  2017     6     13
Versiosta dplyr 1.1.0 (tammikuu 2023) lähtien sama avain voidaan kirjoittaa muodossa join_by(ID, year), ja dplyr varoittaa nyt odottamattomista monesta moneen -osumista, koska dplyr 1.1.0:n liittymisilmoitus selittää.
Tietojen puhdistustoiminnot R:ssä
Yhdistäminen ratkaisee vain puolet ongelmasta, koska yhdistettyä taulukkoa on vielä muotoiltava uudelleen. Seuraavassa on neljä tärkeää funktiota datan siistimiseksi (siivoamiseksi):
| Toiminto | Tavoite | argumentit |
|---|---|---|
| kerätä() | Muunna tiedot laajasta pitkiksi | (data, avain, arvo, na.rm = EPÄTOSI) |
| levitän() | Muunna tiedot pitkästä leveäksi | (data, avain, arvo) |
| erillinen() | Jaa yksi muuttuja kahteen | (data, sarake, sisään, erittely = “”, poista = TOSI) |
| yhdistää() | Yhdistä kaksi muuttujaa yhdeksi | (data, col, conc, sep = “”, poista = TRUE) |
Versiohuomautus: gather() ja spread() korvattiin pivot_longer()- ja pivot_wider()-funktioilla tidyr 1.0.0:ssa, ja separate_wider_delim()-perhe korvasi separate()-funktion tidyr 1.3.0:ssa. Korvatut funktiot toimivat edelleen, joten jokainen alla oleva esimerkki toimii, mutta uuden koodin tulisi suosia uudempia funktioperheitä, jotka on esitetty alla. tidyr-kääntyvä vinjetti.unite() pysyy ajan tasalla.
Käytämme tidyr-pakettia, joka on osa tidyverse-kokoelmaa, datan käsittelyyn, puhdistamiseen ja visualisointiin. Jos R asennettiin Anacondan kanssa, paketti on jo saatavilla osoitteesta https://anaconda.org/r/r-tidyr.
Jos et ole jo asennettu, anna seuraava komento asentaaksesi tidyr:
install.packages("tidyr")
kerätä()
gather()-funktion tavoitteena on muuttaa data leveästä pitkäksi.
Syntaksi
gather(data, key, value, na.rm = FALSE)
Arguments:
-data: The data frame used to reshape the dataset
-key: Name of the new column created
-value: Select the columns used to fill the key column
-na.rm: Remove missing values. FALSE by default
esimerkki
Alla voimme visualisoida reshan käsitteenping leveästä pitkään. Haluamme luoda yhden sarakkeen nimeltä kasvu, joka täytetään neljännesmuuttujien riveillä. Alla olevassa kuvassa vasemmalla näkyy leveä taulukko ja oikealla uudelleenmuotoiltu pitkä taulukko.

library(tidyr)
# Create a messy dataset
messy <- data.frame(
  country = c("A", "B", "C"),
  q1_2017 = c(0.03, 0.05, 0.01),
  q2_2017 = c(0.05, 0.07, 0.02),
  q3_2017 = c(0.04, 0.05, 0.01),
  q4_2017 = c(0.03, 0.02, 0.04))
messy
lähtö:
##   country q1_2017 q2_2017 q3_2017 q4_2017
## 1       A    0.03    0.05    0.04    0.03
## 2       B    0.05    0.07    0.05    0.02
## 3       C    0.01    0.02    0.01    0.04
# Reshape the data
tidier <-messy %>%
gather(quarter, growth, q1_2017:q4_2017)
tidier
lähtö:
##    country quarter growth
## 1        A q1_2017   0.03
## 2        B q1_2017   0.05
## 3        C q1_2017   0.01
## 4        A q2_2017   0.05
## 5        B q2_2017   0.07
## 6        C q2_2017   0.02
## 7        A q3_2017   0.04
## 8        B q3_2017   0.05
## 9        C q3_2017   0.01
## 10       A q4_2017   0.03
## 11       B q4_2017   0.02
## 12       C q4_2017   0.04
Funktiossa gather() luomme kaksi uutta muuttujaa, quarter ja growth, koska alkuperäisessä datasetissämme on yksi ryhmämuuttuja, country, ja avain-arvo-parit. Tidyr 1.0.0:ssa ja uudemmissa sama uudelleenmuotoilu kirjoitetaan muodossa pivot_longer(messy, cols = q1_2017:q4_2017, names_to = “quarter”, values_to = “growth”).
levitän()
spread()-funktio toimii päinvastoin kuin gather()-funktio.
Syntaksi
spread(data, key, value)
arguments:
data: The data frame used to reshape the dataset
key: Column to reshape long to wide
value: Rows used to fill the new column
esimerkki
Voimme muokata siistimmän datasetin takaisin sotkuiseksi spread()-funktiolla.
# Reshape the data
messy_1 <- tidier %>%
  spread(quarter, growth)
messy_1
lähtö:
##   country q1_2017 q2_2017 q3_2017 q4_2017
## 1       A    0.03    0.05    0.04    0.03
## 2       B    0.05    0.07    0.05    0.02
## 3       C    0.01    0.02    0.01    0.04
Nykyaikainen vastine on pivot_wider(tidier, names_from = quarter, values_from = growth).
erillinen()
Separate()-funktio jakaa sarakkeen kahteen osaan erottimen mukaan. Tämä funktio on hyödyllinen tilanteissa, joissa muuttuja on päivämäärä. Analyysimme voi vaatia keskittymistä kuukauteen ja vuoteen, ja haluamme erottaa sarakkeen kahdeksi uudeksi muuttujaksi.
Syntaksi
separate(data, col, into, sep= "", remove = TRUE)
arguments:
-data: The data frame used to reshape the dataset
-col: The column to split
-into: The name of the new variables
-sep: Indicates the symbol used that separates the variable, i.e.:  "-", "_", "&"
-remove: Remove the old column. By default sets to TRUE.
esimerkki
Voimme jakaa vuosineljänneksen vuodesta siistimmässä tietojoukossa käyttämällä separat()-funktiota.
separate_tidier <-tidier %>%
separate(quarter, c("Qrt", "year"), sep ="_")
head(separate_tidier)
lähtö:
##   country Qrt year growth
## 1       A  q1 2017   0.03
## 2       B  q1 2017   0.05
## 3       C  q1 2017   0.01
## 4       A  q2 2017   0.05
## 5       B  q2 2017   0.07
## 6       C  q2 2017   0.02
yhdistää()
unite()-funktio yhdistää kaksi saraketta yhdeksi.
Syntaksi
unite(data, col, conc ,sep= "", remove = TRUE)
arguments:
-data: The data frame used to reshape the dataset
-col: Name of the new column
-conc: Name of the columns to concatenate
-sep: Indicates the symbol used that unites the variable, i.e:  "-", "_", "&"
-remove: Remove the old columns. By default, sets to TRUE
esimerkki
Yllä olevassa esimerkissä erottelimme neljänneksen vuodesta. Entä jos haluamme yhdistää ne? Käytämme seuraavaa koodia:
unit_tidier <- separate_tidier %>%
  unite(Quarter, Qrt, year, sep ="_")
head(unit_tidier)
lähtö:
##   country Quarter growth
## 1       A q1_2017   0.03
## 2       B q1_2017   0.05
## 3       C q1_2017   0.01
## 4       A q2_2017   0.05
## 5       B q2_2017   0.07
## 6       C q2_2017   0.02
Muotoiltu datakehys on nyt valmis mallinnusvaiheisiin, joita käsitellään jäljempänä. R-opetusohjelmasarja.
