
¿Qué es TensorFlow? ¿Cómo funciona? ArchiTecnología y características
 evelyn clarke
⚡ Resumen inteligente
TensorFlow es la plataforma de código abierto Google Diseñado para el aprendizaje automático, representa cada cálculo como un grafo de flujo de datos compuesto por tensores. Esta descripción general abarca la arquitectura, los componentes, el proceso de ejecución de un cálculo y la forma de introducir datos a través de una canalización de entrada.
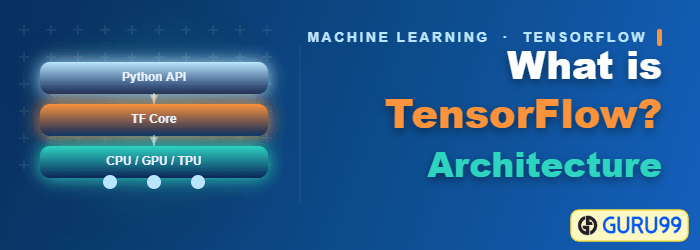
¿Qué es TensorFlow?
TensorFlow es una plataforma de código abierto de un extremo a otro para crear aplicaciones de aprendizaje automático. Es una biblioteca matemática simbólica que utiliza flujo de datos y programación diferenciable para realizar diversas tareas enfocadas al entrenamiento e inferencia de redes neuronales profundas. Permite a los desarrolladores crear aplicaciones de aprendizaje automático utilizando diversas herramientas, bibliotecas y recursos comunitarios.
Actualmente, la biblioteca de aprendizaje profundo más famosa del mundo es GoogleTensorFlow. Google Aplica el aprendizaje automático en todos sus productos para mejorar la búsqueda, la traducción, la generación de subtítulos para imágenes y las recomendaciones.
Ejemplo de TensorFlow
Para dar un ejemplo concreto, Google Los usuarios pueden experimentar una experiencia de búsqueda más rápida y refinada con IA. Si el usuario escribe una palabra clave en la barra de búsqueda, Google Ofrece una recomendación sobre cuál podría ser la siguiente palabra.

Google Quieren utilizar el aprendizaje automático para aprovechar sus enormes conjuntos de datos y ofrecer a los usuarios la mejor experiencia. Tres grupos diferentes utilizan el aprendizaje automático:
- Investigadores
- Científicos de datos
- Programador
Todos pueden utilizar el mismo conjunto de herramientas para colaborar entre sí y mejorar su eficiencia.
Google no solo contiene grandes conjuntos de datos, sino que también ejecuta una enorme infraestructura de computación, por lo que TensorFlow fue diseñado para escalar desde el principio. TensorFlow es una biblioteca desarrollada por la Google El equipo de Brain Team acelerará la investigación en aprendizaje automático y redes neuronales profundas.
Fue creado para ejecutarse en múltiples CPU o GPU e incluso en sistemas operativos móviles, y tiene varios envoltorios en varios idiomas como Python, C++ or Java.
Historia de TensorFlow
Hace un par de años, el aprendizaje profundo comenzó a superar a todos los demás algoritmos de aprendizaje automático cuando se le proporcionaba una cantidad masiva de datos. Google Vio que podía utilizar estas redes neuronales profundas para mejorar sus servicios:
- Gmail
- Fototeca
- Google motor de búsqueda
Construyeron un marco llamado TensorFlow para que investigadores y desarrolladores pudieran trabajar en el mismo modelo y luego implementarlo a una escala que muchas personas pudieran utilizar.
TensorFlow se lanzó públicamente en noviembre de 2015, y la versión 1.0 le siguió en febrero de 2017. El cambio mucho más grande llegó con TensorFlow 2.0 en septiembre de 2019, que hizo que la ejecución inmediata fuera la predeterminada y adoptó Keras como la API estándar de alto nivel. A partir de la versión 2.16, Keras 3 es la predeterminada, y el mismo código del modelo también puede ejecutarse en JAX o PyTorbackends de ch.
TensorFlow se publica bajo la licencia Apache 2.0, por lo que puede usarlo, modificarlo y redistribuirlo, incluso comercialmente, sin pagar. Google.
Cómo funciona TensorFlow
TensorFlow le permite crear estructuras y gráficos de flujo de datos para definir cómo se mueven los datos a través de un gráfico tomando entradas como una matriz multidimensional llamada Tensor. Le permite construir un diagrama de flujo de operaciones que se pueden realizar en estas entradas, que va por un extremo y llega al otro extremo como salida.
TensorFlow Architectura
La arquitectura de TensorFlow funciona en tres partes:
- Preprocesamiento de los datos
- Construye el modelo
- Entrenar y estimar el modelo.
Se llama TensorFlow porque toma la entrada como una matriz multidimensional, también conocida como tensores. Puedes construir una especie de diagrama de flujo de operaciones (llamado Gráfico) que desea realizar en esa entrada. La entrada entra por un extremo, luego fluye a través de este sistema de operaciones múltiples y sale por el otro extremo como salida.
¿Dónde se puede ejecutar TensorFlow?
Los requisitos de hardware y software de TensorFlow se dividen en dos fases:
Fase de desarrollo: esto es cuando se entrena el modelo, normalmente en un ordenador de sobremesa o portátil.
Fase de ejecución o inferenciaUna vez finalizado el entrenamiento, el modelo puede ejecutarse en muchas plataformas:
- Escritorio ejecutándose Windows, macOS o Linux
- La nube como servicio web
- Dispositivos móviles como iOS y Android
Puede entrenarlo en varias máquinas y luego ejecutarlo en una máquina diferente, una vez que tenga el modelo entrenado.
El modelo se puede entrenar y usar tanto en GPU como en CPU. Las GPU se diseñaron inicialmente para videojuegos. Alrededor de 2009, investigadores de Stanford demostraron que las GPU son extremadamente eficientes en las operaciones de álgebra lineal y matricial de las que dependen las redes neuronales. El aprendizaje profundo se basa en mucha multiplicación de matrices. TensorFlow es muy rápido en el cálculo de la multiplicación de matrices porque está escrito en C++. Aunque se implementa en C++, Se puede acceder a TensorFlow y controlarlo principalmente mediante otros lenguajes, Python.
Otra característica importante es TensorTablero, que visualiza el gráfico, las métricas de entrenamiento y la distribución de pesos mientras se ejecuta el modelo.
Componentes de TensorFlow
tensor
El nombre de TensorFlow deriva directamente de su marco de trabajo principal: tensorEn TensorFlow, todos los cálculos involucran tensores. Un tensor es un vector or matriz de n dimensiones que representa todo tipo de datos. Todos los valores de un tensor contienen tipos de datos idénticos con un valor conocido (o parcialmente conocido). dar forma a. La forma de los datos es la dimensionalidad de la matriz o matriz.
Un tensor puede originarse a partir de los datos de entrada o del resultado de un cálculo. En TensorFlow, todas las operaciones se realizan dentro de un gráfica. El gráfico es un conjunto de cálculos que se realizan sucesivamente. Cada operación se llama nodo operativo y están conectados entre sí.
El gráfico describe las operaciones y conexiones entre los nodos. Sin embargo, no muestra los valores. El borde de los nodos es el tensor, es decir, una forma de completar la operación con datos.
Gráficos
TensorFlow utiliza un marco gráfico. El gráfico recoge y describe todos los cálculos en serie realizados durante el entrenamiento. El gráfico tiene muchas ventajas:
- Se ejecuta en múltiples CPU o GPU, e incluso en sistemas operativos móviles.
- La portabilidad del gráfico permite conservar los cálculos para su uso inmediato o posterior. El gráfico puede guardarse para ejecutarse en el futuro.
- Todos los cálculos en el gráfico se realizan conectando tensores entre sí.
- Un grafo tiene nodos y aristas. Cada nodo representa una operación matemática y produce una salida, mientras que las aristas describen las relaciones de entrada y salida entre los nodos. Los tensores se propagan a lo largo de las aristas.
¿Por qué es popular TensorFlow?
TensorFlow goza de gran popularidad gracias a su accesibilidad para usuarios de todos los niveles. Sus API abarcan desde un modelo Keras de tres líneas hasta una CNN o RNN construida manualmente. Dado que la computación se expresa como un grafo, TensorBoard permite visualizar la red y facilita enormemente la depuración. Además, permite una implementación a gran escala, ejecutándose en CPU, GPU y TPU, y en dispositivos móviles mediante TensorFlow Lite.
TensorFlow sigue siendo uno de los dos marcos de aprendizaje profundo más utilizados en GitHub, junto con PyTorch.
TensorFlow Algorithms
TensorFlow incluye estimadores de alto nivel para varios algoritmos clásicos. En TensorFlow 1.x, estos se encontraban bajo tf.estimator:
- Regresión lineal: tf.estimator.LinearRegressor
- Clasificación: tf.estimator.LinearClassifier
- Clasificación de aprendizaje profundo: tf.estimator.DNNClassifier
- Aprendizaje amplio y profundo: tf.estimator.DNNLinearCombinedClassifier
- Regresión de árboles potenciados: tf.estimator.BoostedTreesRegressor
- Clasificación de árbol mejorada: tf.estimator.BoostedTreesClassifier
TensorFlow vs PyTor¿Cuál deberías elegir?
TensorFlow y PythonTorson los dos marcos de aprendizaje profundo dominantes, y las diferencias prácticas se han reducido considerablemente desde que TensorFlow 2.0 adoptó la ejecución inmediata.
| Criterios | TensorFlow | PyTorch |
|---|---|---|
| Desarrollado por | Google Cerebro | Meta IA |
| Ejecución | Ansioso, con compilación de gráficos opcional. | Ansioso, con compilación opcional |
| API de alto nivel | Keras, construido en | Bibliotecas separadas como Lightning |
| Móvil y borde | Maduro, a través de TensorFlow Lite | Mejorando, a través de ExecuTorch |
| Implementación en navegador | TensorFlow.js | Requiere conversión a ONNX |
| Fortaleza típica | Producción y despliegue | Investigación y experimentación |
La respuesta pragmática: elige TensorFlow cuando el modelo tenga que implementarse en dispositivos móviles, navegadores o plataformas de distribución gestionadas, y elige Python.Torch cuando se itera sobre la arquitectura del modelo. Keras 3, el predeterminado desde TensorFlow 2.16 en adelante, suaviza aún más la decisión, porque el mismo código Keras puede ejecutarse en un TensorFlow, JAX o PyTorch backend.
Cómo funcionan los cálculos en TensorFlow
⚠️ Nota de versión: Los tutoriales a continuación utilizan el TensorFlow 1.x estilo gráfico y sesión, que es la forma más clara de ver cómo funciona realmente el gráfico de flujo de datos. Las funciones tf.placeholder(), tf.Session() y make_initializable_iterator() se eliminaron en TensorFlow 2.0. y generará un AttributeError en una instalación actual. La sección TensorFlow 1.x vs TensorFlow 2.x Más abajo se ofrece el equivalente moderno de cada ejemplo.
import numpy as np
import tensorflow as tf
En las dos primeras líneas de código, hemos importado tensorflow como tf. Con Python, es una práctica común utilizar un nombre corto para una biblioteca. La ventaja es evitar escribir el nombre completo de la biblioteca cuando necesitamos usarla. Por ejemplo, podemos importar tensorflow como tf y llamar a tf cuando queramos usar una función de tensorflow.
Practiquemos el flujo de trabajo básico de TensorFlow con ejemplos sencillos. Creemos un grafo computacional que multiplique dos números.
En este ejemplo, multiplicaremos X_1 y X_2. TensorFlow creará un nodo para conectar la operación. En este ejemplo, se llama multiplicación. Cuando se determine el grafo, los motores de cálculo de TensorFlow multiplicarán X_1 y X_2.

Finalmente, ejecutaremos una sesión de TensorFlow que ejecutará el gráfico computacional con los valores de X_1 y X_2 e imprimirá el resultado de la multiplicación.
Vamos a definir los nodos de entrada X_1 y X_2. Al crear un nodo en TensorFlow, debemos elegir qué tipo de nodo crear. Los nodos X1 y X2 serán nodos de marcador de posición. El marcador de posición asigna un nuevo valor cada vez que realizamos un cálculo. Los crearemos como nodos de marcador de posición TF.
Paso 1: definir la variable
X_1 = tf.placeholder(tf.float32, name = "X_1")
X_2 = tf.placeholder(tf.float32, name = "X_2")
Un marcador de posición necesita un tipo de dato. Estos son números, por lo que tf.float32 es la opción correcta. El argumento de nombre es opcional pero útil, ya que es la etiqueta que aparece en la visualización del gráfico en TensorBoard. X_2 se define de la misma manera.
Paso 2: definir el cálculo
multiply = tf.multiply(X_1, X_2, name = "multiply")
Ahora podemos definir el nodo que realiza la operación de multiplicación. En TensorFlow, podemos hacerlo creando un nodo tf.multiply.
Pasaremos los nodos X_1 y X_2 al nodo de multiplicación. Le dice a tensorflow que vincule esos nodos en el gráfico computacional, por lo que le pedimos que extraiga los valores de xey y multiplique el resultado. También le daremos al nodo de multiplicación el nombre de multiplicar. Es la definición completa de nuestro gráfico computacional simple.
Paso 3: ejecutar la operación
Para ejecutar operaciones en el grafo, debemos crear una sesión. En TensorFlow, esto se hace mediante tf.Session(). Ahora que tenemos una sesión, podemos solicitarle que ejecute operaciones en nuestro grafo computacional llamando a session. Para ejecutar el cálculo, necesitamos usar run.
Cuando se ejecuta la operación de multiplicación, se necesitan los valores de los nodos X_1 y X_2, por lo que se proporcionan durante la ejecución. Esto se logra mediante un parámetro llamado feed_dict. Se le pasa el valor 1, 2, 3 para X_1 y 4, 5, 6 para X_2.
Imprimimos los resultados con print(resultado). Deberíamos ver 4, 10 y 18 para 1×4, 2×5 y 3×6
X_1 = tf.placeholder(tf.float32, name = "X_1")
X_2 = tf.placeholder(tf.float32, name = "X_2")

multiply = tf.multiply(X_1, X_2, name = "multiply")

with tf.Session() as session:
    result = session.run(multiply, feed_dict={X_1:[1,2,3], X_2:[4,5,6]})
    print(result)
[ 4. 10. 18.]
Opciones para cargar datos en TensorFlow
El primer paso antes de entrenar a un algoritmo de aprendizaje automático es cargar los datos. Hay dos formas comunes de cargar datos:
1. Cargar datos en la memoriaEs el método más sencillo. Cargas todos tus datos en la memoria como un único array. Escribes código plano. Python Por eso, nada de esto es específico de TensorFlow.
2. Canalización de datos de TensorFlowTensorFlow proporciona una API integrada que carga los datos, aplica transformaciones y alimenta el modelo. Este método funciona muy bien, especialmente cuando se tiene un conjunto de datos grande. Por ejemplo, se sabe que los registros de imágenes son enormes y no caben en la memoria. La canalización de datos gestiona la memoria por sí misma.
¿Qué solución utilizar?
Cargar datos en la memoria
Si su conjunto de datos no es demasiado grande, es decir, menos de 10 gigabytes, puede utilizar el primer método. Los datos pueden caber en la memoria. Puedes utilizar una biblioteca famosa llamada Pandas para importar archivos CSV. Aprenderás más sobre los pandas en el próximo tutorial.
Cargar datos con la canalización de TensorFlow
El segundo método funciona mejor si tiene un conjunto de datos grande. Por ejemplo, si tiene un conjunto de datos de 50 gigabytes y su computadora tiene solo 16 gigabytes de memoria, la máquina fallará.
En esta situación, necesitas crear una canalización de TensorFlow. La canalización cargará los datos por lotes, o pequeños fragmentos. Cada lote se enviará a la canalización y estará listo para el entrenamiento. Crear una canalización es una excelente solución porque permite usar computación paralela. Esto significa que TensorFlow entrenará el modelo en múltiples CPU. Esto acelera el cálculo y hace que sea práctico entrenar redes más grandes.
En resumen: carga conjuntos de datos pequeños en la memoria con pandas y utiliza una canalización de TensorFlow cuando los datos sean grandes o cuando quieras una carga paralela en varios procesadores.
Cómo crear una canalización de TensorFlow
Estos son los pasos para crear una canalización de TensorFlow:
En el ejemplo anterior, agregamos manualmente tres valores para X_1 y X_2. Ahora veremos cómo cargar datos en TensorFlow:
Paso 1) Crea los datos
En primer lugar, usemos la biblioteca numpy para generar dos valores aleatorios.
import numpy as np
x_input = np.random.sample((1,2))
print(x_input)
[[0.8835775 0.23766977]]
Paso 2) Crea el marcador de posición
Como en el ejemplo anterior, creamos un marcador de posición con el nombre X. Necesitamos especificar explícitamente la forma del tensor. En este caso, cargaremos una matriz con solo dos valores. Podemos escribir la forma como forma=[1,2]
# using a placeholder
x = tf.placeholder(tf.float32, shape=[1,2], name = 'X')
Paso 3) Definir el método del conjunto de datos
A continuación, debemos definir el conjunto de datos donde podemos completar el valor del marcador de posición x. Necesitamos usar el método tf.data.Dataset.from_tensor_slices
dataset = tf.data.Dataset.from_tensor_slices(x)
Paso 4) Crear la canalización
En el paso cuatro, necesitamos inicializar la tubería por donde fluirán los datos. Necesitamos crear un iterador con make_initializable_iterator. Lo llamamos iterador. Luego necesitamos llamar a este iterador para alimentar el siguiente lote de datos, get_next. A este paso lo llamamos get_next. Tenga en cuenta que en nuestro ejemplo, solo hay un lote de datos con solo dos valores.
iterator = dataset.make_initializable_iterator()
get_next = iterator.get_next()
Paso 5) Ejecutar la operación
El último paso es similar al ejemplo anterior. Iniciamos una sesión y ejecutamos el iterador de operaciones. Alimentamos el feed_dict con el valor generado por numpy. Estos dos valores llenarán el marcador de posición x. Luego ejecutamos get_next para imprimir el resultado.
with tf.Session() as sess:
    # feed the placeholder with data
    sess.run(iterator.initializer, feed_dict={ x: x_input })
    print(sess.run(get_next))
[0.8835775 0.23766978]
TensorFlow 1.x vs TensorFlow 2.x: ¿Qué ha cambiado?
TensorFlow 2.0 supuso una reescritura radical de la API para el usuario. Es importante comprender la diferencia, ya que gran parte del código de los tutoriales en línea, incluidos los ejemplos anteriores, se basa en el estilo de la versión 1.x.
| Concepto | TensorFlow 1.x | TensorFlow 2.x |
|---|---|---|
| Modelo de ejecución | Define el gráfico y luego ejecútalo. | Por defecto, las operaciones se ejecutan de inmediato. |
| Alimentación de datos | tf.placeholder más feed_dict | Pasó Python valores o tensores directamente |
| Operaciones en marcha | tf.Session().run() | Llama a la función, no se necesita sesión. |
| API de alto nivel | tf.estimator | Keras, tf.keras |
| Optimización de gráficos | Siempre basado en gráficos | Habilitar con el decorador @tf.function |
| Iterar sobre un conjunto de datos | crear_iterador_inicializable() | Natural Python bucle for sobre el conjunto de datos |
El ejemplo de multiplicación, reescrito. Tres pasos y una sesión se convierten en una sola línea, porque la operación se ejecuta en el momento en que se llama:
import tensorflow as tf

X_1 = tf.constant([1, 2, 3], dtype=tf.float32)
X_2 = tf.constant([4, 5, 6], dtype=tf.float32)

result = tf.multiply(X_1, X_2, name="multiply")
print(result.numpy())        # [ 4. 10. 18.]
El proceso de entrada, reescrito. No se requiere ningún objeto de marcador de posición ni ningún objeto iterador:
import numpy as np
import tensorflow as tf

x_input = np.random.sample((1, 2))
dataset = tf.data.Dataset.from_tensor_slices(x_input)

for batch in dataset:
    print(batch.numpy())
Si necesita la velocidad de un gráfico compilado, envuelva la función en @tf.function y TensorFlow. traclo convierte automáticamente en uno. Los scripts heredados de la versión 1.x también se pueden ejecutar sin cambios a través del espacio de nombres tf.compat.v1, aunque esa ruta es solo para mantenimiento y no debe usarse para trabajos nuevos.
TensorFlow: Conclusiones clave y Code Referencias
- Significado de TensorFlow: TensorFlow Es la biblioteca de aprendizaje profundo más famosa de los últimos años. Un profesional que utilice TensorFlow puede crear cualquier estructura de aprendizaje profundo, como CNN, RNN o una simple red neuronal artificial.
- TensorFlow es utilizado principalmente por académicos, empresas emergentes y grandes compañías. Google utiliza TensorFlow en casi todos Google productos diarios incluidos Gmail, Foto y Google Buscador.
- El Google El equipo de Brain desarrolló TensorFlow para acortar la brecha entre investigadores y desarrolladores de productos. En 2015, lo lanzaron al público y su popularidad está creciendo rápidamente. Actualmente, TensorFlow es la biblioteca de aprendizaje profundo con más repositorios en GitHub.
- Los profesionales utilizan TensorFlow porque se implementa fácilmente a gran escala, en la nube, en el navegador o en dispositivos móviles que ejecutan iOS y Android.
TensorFlow funciona en sesiones. Cada sesión se define mediante un grafo con diferentes cálculos. Un ejemplo sencillo puede ser multiplicar por un número. En TensorFlow, se requieren tres pasos:
- Definir la variable
X_1 = tf.placeholder(tf.float32, name = "X_1")
X_2 = tf.placeholder(tf.float32, name = "X_2")
- Definir el cálculo
multiply = tf.multiply(X_1, X_2, name = "multiply")
- Ejecutar la operación
with tf.Session() as session:
    result = session.run(multiply, feed_dict={X_1: [1, 2, 3], X_2: [4, 5, 6]})
    print(result)
Una práctica común en TensorFlow es crear una canalización para cargar los datos. Si sigues estos cinco pasos, podrás cargar datos en TensorFlow:
- Crear los datos
import numpy as np
x_input = np.random.sample((1,2))
print(x_input)
- Crear el marcador de posición
x = tf.placeholder(tf.float32, shape=[1,2], name = 'X')
- Definir el método del conjunto de datos
dataset = tf.data.Dataset.from_tensor_slices(x)
- Crea la canalización
iterator = dataset.make_initializable_iterator()
get_next = iterator.get_next()
- Ejecuta el programa
with tf.Session() as sess:
    sess.run(iterator.initializer, feed_dict={x: x_input})
    print(sess.run(get_next))
