
Κ-μέσα ClusterΠρογραμματισμός σε R με παράδειγμα
 Έβελιν Κλαρκ
⚡ Έξυπνη Σύνοψη
Κ-Μέσα ClusterΟμαδοποιώντας παρατηρήσεις σε R ελαχιστοποιώντας την απόσταση μεταξύ κάθε σημείου και του κέντρου βάρους του συμπλέγματος. Αυτή η αναλυτική παρουσίαση τυποποιεί το σύνολο δεδομένων υπολογιστικών τιμών, ζωντανεύει τον αλγόριθμο, βρίσκει το βέλτιστο k με τη μέθοδο αγκώνα και διαβάζει τις συστάδες μέσω ενός χάρτη θερμότητας.

Τι είναι Cluster ανάλυση?
Cluster η ανάλυση ανήκει σε μη εποπτευόμενη μάθηση. Ένα σύμπλεγμα είναι μια ομάδα δεδομένων που μοιράζονται παρόμοια χαρακτηριστικά. Μπορούμε να πούμε ότι η ανάλυση ομαδοποίησης αφορά περισσότερο την ανακάλυψη παρά μια πρόβλεψη. Το μηχάνημα αναζητά ομοιότητα στα δεδομένα. Για παράδειγμα, μπορείτε να χρησιμοποιήσετε ανάλυση συμπλέγματος για την ακόλουθη εφαρμογή:
- Τμηματοποίηση πελατών: Ψάχνει για ομοιότητα μεταξύ ομάδων πελατών
- Ομαδοποίηση Χρηματιστηρίου: Μετοχές του Ομίλου με βάση τις αποδόσεις
- Μείωση της διαστασιολόγησης ενός συνόλου δεδομένων ανά ομάδαping παρατηρήσεις με παρόμοιες τιμές
ClusterΗ ανάλυση δεν είναι πολύ δύσκολο να εφαρμοστεί και έχει νόημα και είναι χρήσιμη για τις επιχειρήσεις.
Η πιο εντυπωσιακή διαφορά μεταξύ εποπτευόμενης και μη εποπτευόμενης μάθησης βρίσκεται στα αποτελέσματα. Η μάθηση χωρίς επίβλεψη δημιουργεί μια νέα μεταβλητή, την ετικέτα, ενώ η εποπτευόμενη μάθηση προβλέπει ένα αποτέλεσμα. Το μηχάνημα βοηθά τον επαγγελματία στην προσπάθεια να ονομάσει τα δεδομένα με βάση τη στενή σχέση. Εναπόκειται στον αναλυτή να κάνει χρήση των ομάδων και να τους δώσει ένα όνομα.
Ας κάνουμε ένα παράδειγμα για να κατανοήσουμε την έννοια της ομαδοποίησης. Για απλότητα, δουλεύουμε σε δύο διαστάσεις. Έχετε δεδομένα για τις συνολικές δαπάνες των πελατών και τις ηλικίες τους. Για να βελτιώσει τη διαφήμιση, η ομάδα μάρκετινγκ θέλει να στέλνει πιο στοχευμένα μηνύματα ηλεκτρονικού ταχυδρομείου στους πελάτες της.
Στο παρακάτω γράφημα, σχεδιάζετε τη συνολική δαπάνη και την ηλικία των πελατών.
library(ggplot2)
df <- data.frame(age = c(18, 21, 22, 24, 26, 26, 27, 30, 31, 35, 39, 40, 41, 42, 44, 46, 47, 48, 49, 54),
    spend = c(10, 11, 22, 15, 12, 13, 14, 33, 39, 37, 44, 27, 29, 20, 28, 21, 30, 31, 23, 24)
)
ggplot(df, aes(x = age, y = spend)) +
    geom_point()

Ένα μοτίβο είναι ορατό σε αυτό το σημείο
- Κάτω αριστερά, μπορείτε να δείτε νέους με χαμηλότερη αγοραστική δύναμη
- Το ανώτερο-μεσαίο αντικατοπτρίζει άτομα με δουλειά που μπορούν να αντέξουν οικονομικά να ξοδέψουν περισσότερα
- Τέλος, άτομα μεγαλύτερης ηλικίας με χαμηλότερο προϋπολογισμό.

Στο παραπάνω σχήμα, συγκεντρώνετε τις παρατηρήσεις με το χέρι και ορίζετε καθεμία από τις τρεις ομάδες. Αυτό το παράδειγμα είναι κάπως απλό και πολύ οπτικό. Εάν προσαρτηθούν νέες παρατηρήσεις στο σύνολο δεδομένων, μπορείτε να τις επισημάνετε μέσα στους κύκλους. Ορίζετε τον κύκλο με βάση την κρίση μας. Αντίθετα, μπορείτε να χρησιμοποιήσετε Μηχανική μάθηση να ομαδοποιήσετε τα δεδομένα αντικειμενικά.
Σε αυτό το σεμινάριο, θα μάθετε πώς να χρησιμοποιείτε το k-μέσα αλγόριθμος.
Αλγόριθμος K-Means
Ο αλγόριθμος K-means είναι η πιο ευρέως χρησιμοποιούμενη μέθοδος ομαδοποίησης. Ο αλγόριθμος χρονολογείται από τη δεκαετία του 1950 και έχει βελτιωθεί πολλές φορές έκτοτε.
Ο αλγόριθμος προσπαθεί να βρει ομάδες ελαχιστοποιώντας την απόσταση μεταξύ των παρατηρήσεων, που καλούνται τοπική βέλτιστη λύσεις. Οι αποστάσεις μετρώνται με βάση τις συντεταγμένες των παρατηρήσεων. Για παράδειγμα, σε έναν δισδιάστατο χώρο οι συντεταγμένες είναι απλώς x και y.
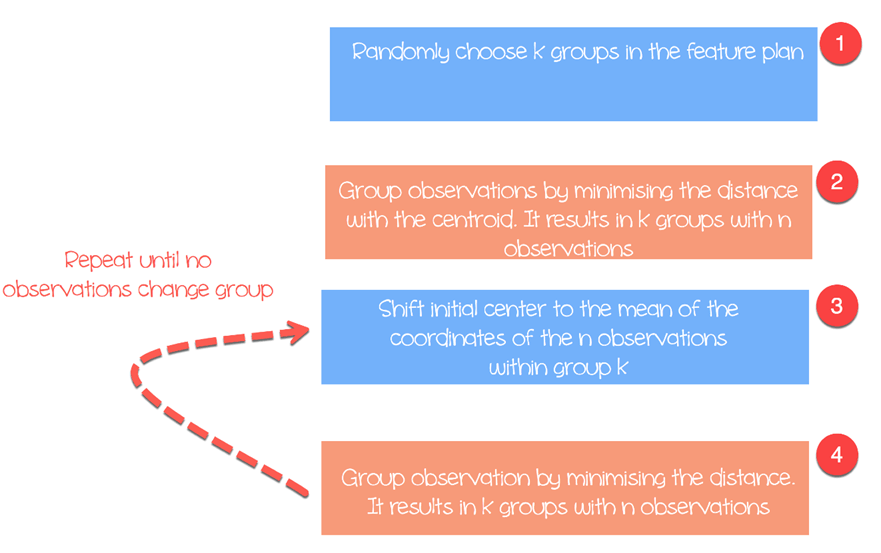
Ο αλγόριθμος λειτουργεί ως εξής:
- Βήμα 1: Επιλέξτε τυχαία k αρχικά κεντροειδή στον χώρο χαρακτηριστικών
- Βήμα 2: Αντιστοιχίστε κάθε παρατήρηση στο πλησιέστερο κέντρο συστάδας, το κεντροειδέςΑυτό παράγει k ομάδες
- Βήμα 3: Shift το αρχικό κέντρο στο μέσο όρο των συντεταγμένων μέσα σε μια ομάδα.
- Βήμα 4: Ελαχιστοποιήστε την απόσταση σύμφωνα με τα νέα centroids. Δημιουργούνται νέα όρια. Έτσι, οι παρατηρήσεις θα μετακινούνται από τη μια ομάδα στην άλλη
- Επαναλάβετε έως ότου καμία παρατήρηση δεν αλλάζει ομάδες
Το K-means μετρά κανονικά την Ευκλείδεια απόσταση μεταξύ δύο παρατηρήσεων x και y:

Άλλα διαθέσιμα μέτρα είναι η απόσταση Manhattan ή Minkowski. Σημειώστε ότι ο K-mean επιστρέφει διαφορετικές ομάδες κάθε φορά που εκτελείτε τον αλγόριθμο. Υπενθυμίζουμε ότι οι πρώτες αρχικές εικασίες είναι τυχαίες και υπολογίζουμε τις αποστάσεις μέχρι ο αλγόριθμος να φτάσει σε ομοιογένεια εντός των ομάδων. Δηλαδή, ο k-mean είναι πολύ ευαίσθητος στην πρώτη επιλογή και, εκτός εάν ο αριθμός των παρατηρήσεων και των ομάδων είναι μικρός, είναι σχεδόν αδύνατο να επιτευχθεί η ίδια ομαδοποίηση.
Επιλογή του αριθμού των συστάδων
Μια άλλη δυσκολία που συναντάται με τον k-μέσο όρο είναι η επιλογή του αριθμού των συστάδων. Μπορείτε να ορίσετε μια υψηλή τιμή k, που σημαίνει μεγάλο αριθμό ομάδων, για να βελτιώσετε την ομοιογένεια εντός της ομάδας, αλλά διατρέχετε τον κίνδυνο υπερβολική τοποθέτηση τα δεδομένα. Η υπερπροσαρμογή σημαίνει ότι η απόδοση μειώνεται απότομα με τα νέα δεδομένα, επειδή το μοντέλο έχει απομνημονεύσει τον θόρυβο σε αυτό το συγκεκριμένο δείγμα και όχι το υποκείμενο μοτίβο.
Ο αριθμός των συμπλεγμάτων εξαρτάται από τη φύση του συνόλου δεδομένων, τον κλάδο, την επιχείρηση και ούτω καθεξής. Ωστόσο, υπάρχει ένας εμπειρικός κανόνας για την επιλογή του κατάλληλου αριθμού συμπλεγμάτων:

όπου n είναι ο αριθμός των παρατηρήσεων στο σύνολο δεδομένων.
Στην πράξη, αξίζει να αφιερώσετε χρόνο αναζητώντας την τιμή του k που ταιριάζει καλύτερα στις επιχειρηματικές ανάγκες.
Θα χρησιμοποιήσουμε το σύνολο δεδομένων Prices of Personal Computers για να εκτελέσουμε την ανάλυση ομαδοποίησης. Αυτό το σύνολο δεδομένων περιέχει 6259 παρατηρήσεις και 10 χαρακτηριστικά. Το σύνολο δεδομένων παρατηρεί την τιμή από το 1993 έως το 1995 486 προσωπικών υπολογιστών στις ΗΠΑ. Οι μεταβλητές είναι τιμή, ταχύτητα, ram, οθόνη, cd μεταξύ άλλων.
Θα προχωρήσετε ως εξής:
- Εισαγωγή δεδομένων
- Εκπαιδεύστε το μοντέλο
- Αξιολογήστε το μοντέλο
Εισαγωγή δεδομένων
Ο K-means δεν είναι κατάλληλος για μεταβλητές παραγόντων, επειδή λειτουργεί σε αποστάσεις και οι διακριτές ετικέτες δεν έχουν σημαντική απόσταση μεταξύ τους. Αφαιρέστε τις τρεις κατηγορικές στήλες (cd, multi, premium) μαζί με τον δείκτη γραμμής X. Αυτό το σύνολο δεδομένων δεν περιέχει τιμές που λείπουν.
library(dplyr)
PATH <-"https://raw.githubusercontent.com/guru99-edu/R-Programming/master/computers.csv"
df <- read.csv(PATH) %>%
select(-c(X, cd, multi, premium))
glimpse(df)
Παραγωγή
## Observations: 6,259
## Variables: 7
## $ price <int> 1499, 1795, 1595, 1849, 3295, 3695, 1720, 1995, 2225, 2...
## $ speed <int> 25, 33, 25, 25, 33, 66, 25, 50, 50, 50, 33, 66, 50, 25, ...
## $ hd <int> 80, 85, 170, 170, 340, 340, 170, 85, 210, 210, 170, 210...
## $ ram <int> 4, 2, 4, 8, 16, 16, 4, 2, 8, 4, 8, 8, 4, 8, 8, 4, 2, 4, ...
## $ screen <int> 14, 14, 15, 14, 14, 14, 14, 14, 14, 15, 15, 14, 14, 14, ...
## $ ads <int> 94, 94, 94, 94, 94, 94, 94, 94, 94, 94, 94, 94, 94, 94, ...
## $ trend  <int> 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1...
Από τα συνοπτικά στατιστικά στοιχεία, μπορείτε να δείτε ότι τα δεδομένα έχουν μεγάλες τιμές. Μια καλή πρακτική πριν από οποιαδήποτε μέθοδο που βασίζεται στην απόσταση είναι η τυποποίηση των δεδομένων έτσι ώστε κάθε μεταβλητή να έχει ένα μέσος όρος μηδέν και τυπική απόκλιση έναΧωρίς αυτήν, η τιμή, της οποίας οι τιμές ανέρχονται σε χιλιάδες, θα κυριαρχούσε στον υπολογισμό της απόστασης και το μέγεθος της οθόνης δεν θα είχε σχεδόν καμία σημασία.
summary(df)
Παραγωγή:
##      price          speed              hd              ram
##  Min.   : 949   Min.   : 25.00   Min.   :  80.0   Min.   : 2.000
##  1st Qu.:1794   1st Qu.: 33.00   1st Qu.: 214.0   1st Qu.: 4.000
##  Median :2144   Median : 50.00   Median : 340.0   Median : 8.000
##  Mean   :2220   Mean   : 52.01   Mean   : 416.6   Mean   : 8.287
##  3rd Qu.:2595   3rd Qu.: 66.00   3rd Qu.: 528.0   3rd Qu.: 8.000
##  Max.   :5399   Max.   :100.00   Max.   :2100.0   Max.   :32.000
##      screen           ads            trend
##  Min.   :14.00   Min.   : 39.0   Min.   : 1.00
##  1st Qu.:14.00   1st Qu.:162.5   1st Qu.:10.00
##  Median :14.00   Median :246.0   Median :16.00
##  Mean   :14.61   Mean   :221.3   Mean   :15.93
##  3rd Qu.:15.00   3rd Qu.:275.0   3rd Qu.:21.50
##  Max.   :17.00   Max.   :339.0   Max.   :35.00
Επανακλιμακώνετε τις μεταβλητές με τη συνάρτηση scale() της βιβλιοθήκης dplyr. Ο μετασχηματισμός μειώνει τον αντίκτυπο των ακραίων τιμών και επιτρέπει τη σύγκριση μιας μοναδικής παρατήρησης έναντι του μέσου όρου. Εάν μια τυποποιημένη τιμή (ή Ζ-σκορ) είναι υψηλό, μπορείτε να είστε βέβαιοι ότι αυτή η παρατήρηση είναι όντως πάνω από τον μέσο όρο (μια μεγάλη βαθμολογία z σημαίνει ότι αυτό το σημείο απέχει πολύ από το μέσο όρο της τυπικής απόκλισης. Μια βαθμολογία z δύο υποδηλώνει ότι η τιμή είναι 2 τυπική Σημειώστε ότι η βαθμολογία z ακολουθεί μια κατανομή Gauss και είναι συμμετρική γύρω από τη μέση τιμή.
# Note: speed is deliberately left out of the scaled data frame
rescale_df <- df %>%
    mutate(price_scal = scale(price),
    hd_scal = scale(hd),
    ram_scal = scale(ram),
    screen_scal = scale(screen),
    ads_scal = scale(ads),
    trend_scal = scale(trend)) %>%
select(-c(price, speed, hd, ram, screen, ads, trend))
Η βάση R έχει μια συνάρτηση για την εκτέλεση του k mean αλγόριθμου. Η βασική συνάρτηση του k mean είναι:
kmeans(df, k)
arguments:
-df: dataset used to run the algorithm
-k: Number of clusters
Εκπαιδεύστε το μοντέλο
Στο σχήμα τρία, περιγράψατε λεπτομερώς πώς λειτουργεί ο αλγόριθμος. Μπορείτε να παρακολουθήσετε κάθε βήμα γραφικά με το πακέτο κινουμένων σχεδίων που γράφτηκε από τον Yihui Xie, ο οποίος δημιούργησε επίσης το knitr για το R Markdown. Το πακέτο δεν βρίσκεται στα κανάλια conda, επομένως εγκαταστήστε το από το CRAN:
install.packages("animation")
Αφού φορτώσετε τη βιβλιοθήκη, προσθέτετε .ani μετά το kmeans και R θα σχεδιάσει όλα τα βήματα. Για λόγους επεξήγησης, εκτελείτε τον αλγόριθμο μόνο με τις αναβαθμισμένες μεταβλητές hd και ram με τρία συμπλέγματα.
set.seed(2345)
library(animation)
kmeans.ani(rescale_df[2:3], 3)
Code εξήγηση
- kmeans.ani(rescale_df[2:3], 3): Επιλέξτε τις στήλες 2 και 3 του συνόλου δεδομένων rescale_df και εκτελέστε τον αλγόριθμο με k σετ στο 3. Σχεδιάστε την κινούμενη εικόνα.


Μπορείτε να ερμηνεύσετε το κινούμενο σχέδιο ως εξής:
- Βήμα 1: Ο R επιλέγει τυχαία τρία σημεία
- Βήμα 2: Υπολογίστε την Ευκλείδεια απόσταση και σχεδιάστε τα συμπλέγματα. Έχετε ένα σύμπλεγμα σε πράσινο χρώμα κάτω αριστερά, ένα μεγάλο σύμπλεγμα με μαύρο χρώμα στα δεξιά και ένα κόκκινο ανάμεσά τους.
- Βήμα 3: Υπολογίστε το κέντρο, δηλαδή τον μέσο όρο των συστάδων
- Επαναλάβετε μέχρι να μην αλλάξουν δεδομένα στο σύμπλεγμα
Ο αλγόριθμος συνέκλινε μετά από επτά επαναλήψεις. Μπορείτε να εκτελέσετε τον αλγόριθμο k-mean στο σύνολο δεδομένων μας με πέντε συμπλέγματα και να τον ονομάσετε pc_cluster.
pc_cluster <-kmeans(rescale_df, 5)
Η λίστα pc_cluster περιέχει επτά χρήσιμα στοιχεία:
- pc_cluster$cluster: Το σύμπλεγμα που έχει αντιστοιχιστεί σε κάθε παρατήρηση
- pc_cluster$centers: Τα κέντρα συμπλέγματος
- pc_cluster$totss: Το συνολικό άθροισμα των τετραγώνων
- pc_cluster$withinss: Εντός του αθροίσματος τετραγώνων, μία τιμή ανά σύμπλεγμα
- pc_cluster$tot.withinss: Το άθροισμα των withinss
- pc_cluster$betweenss: Συνολικό άθροισμα τετραγώνων μείον το άθροισμα τετραγώνων εντός
- pc_cluster$size: Αριθμός παρατήρησης σε κάθε σύμπλεγμα
Θα χρησιμοποιήσετε το άθροισμα του εντός αθροίσματος του τετραγώνου (δηλ. tot.withinss) για να υπολογίσετε τον βέλτιστο αριθμό συστάδων k. Η εύρεση του k είναι πράγματι μια ουσιαστική εργασία.
Πώς να βρείτε το βέλτιστο k με τη μέθοδο του αγκώνα
Μια τεχνική για να επιλέξετε το καλύτερο k ονομάζεται η μέθοδος αγκώνα. Αυτή η μέθοδος χρησιμοποιεί ομοιογένεια εντός ομάδας ή ετερογένεια εντός ομάδας για να αξιολογήσει τη μεταβλητότητα. Με άλλα λόγια, σας ενδιαφέρει το ποσοστό της διακύμανσης που εξηγείται από κάθε συστάδα. Μπορείτε να περιμένετε ότι η μεταβλητότητα θα αυξηθεί με τον αριθμό των συστάδων, εναλλακτικά, η ετερογένεια μειώνεται. Η πρόκληση μας είναι να βρούμε το k που είναι πέρα από τις φθίνουσες αποδόσεις. Η προσθήκη ενός νέου συμπλέγματος δεν βελτιώνει τη μεταβλητότητα στα δεδομένα επειδή απομένουν πολύ λίγες πληροφορίες για να εξηγηθούν.
Σε αυτό το σεμινάριο, βρίσκουμε αυτό το σημείο χρησιμοποιώντας το μέτρο ετερογένειας. Το Σύνολο εντός συστάδων άθροισμα τετραγώνων είναι το σύνολο των τετραγώνων στη λίστα απόδοση με kmean().
Μπορείτε να κατασκευάσετε το γράφημα του αγκώνα και να βρείτε το βέλτιστο k ως εξής:
- Βήμα 1: Κατασκευάστε μια συνάρτηση για να υπολογίσετε το άθροισμα τετραγώνων εντός των συστάδων
- Βήμα 2: Εκτελέστε τον αλγόριθμο σε ένα εύρος k τιμών
- Βήμα 3: Δημιουργήστε ένα πλαίσιο δεδομένων με τα αποτελέσματα του αλγορίθμου
- Βήμα 4: Σχεδιάστε τα αποτελέσματα
Βήμα 1) Κατασκευάστε μια συνάρτηση για να υπολογίσετε το συνολικό άθροισμα τετραγώνων εντός των συστάδων
Δημιουργείτε τη συνάρτηση που εκτελεί τον αλγόριθμο k-mean και αποθηκεύετε το σύνολο μέσα σε συμπλέγματα άθροισμα τετραγώνων
kmean_withinss <- function(k) {
    cluster <- kmeans(rescale_df, k)
    return (cluster$tot.withinss)
}
Code εξήγηση
- function(k): Ορισμός του αριθμού των ορισμάτων στη συνάρτηση
- kmeans(rescale_df, k): Εκτελέστε τον αλγόριθμο για αυτήν την τιμή του k
- return(cluster$tot.withinss): Αποθηκεύστε το συνολικό άθροισμα τετραγώνων εντός των συστάδων
Ελέγξτε τη συνάρτηση με k ίσο με 2.
Παραγωγή:
## Try with 2 cluster
kmean_withinss(2)
Παραγωγή:
## [1] 27087.07
Βήμα 2) Εκτελέστε τον αλγόριθμο n φορές
Θα χρησιμοποιήσετε τη συνάρτηση sapply() για να εκτελέσετε τον αλγόριθμο σε μια περιοχή k. Αυτή η τεχνική είναι πιο γρήγορη από τη δημιουργία βρόχου και αποθήκευση της τιμής.
# Set maximum cluster
max_k <-20
# Run algorithm over a range of k
wss <- sapply(2:max_k, kmean_withinss)
Code εξήγηση
- max_k <- 20: Ορίστε τη μέγιστη τιμή του k σε 20
- sapply(2:max_k, kmean_withinss): Εκτελέστε τη συνάρτηση kmean_withinss() σε ένα εύρος 2:max_k, δηλαδή 2 έως 20.
Βήμα 3) Δημιουργήστε ένα πλαίσιο δεδομένων με τα αποτελέσματα του αλγορίθμου
Αφού γράψετε και δοκιμάσετε τη συνάρτηση, εκτελέστε την σε όλο το εύρος από 2 έως 20 και αποθηκεύστε κάθε τιμή tot.withinss.
# Create a data frame to plot the graph
elbow <-data.frame(2:max_k, wss)
Code εξήγηση
- data.frame(2:max_k, wss): Δημιουργήστε ένα πλαίσιο δεδομένων με την έξοδο του αποθηκευτικού αλγορίθμου στο wss
Βήμα 4) Σχεδιάστε τα αποτελέσματα
Σχεδιάζετε το γράφημα για να οπτικοποιήσετε πού βρίσκεται το σημείο του αγκώνα
# Plot the graph with gglop
ggplot(elbow, aes(x = X2.max_k, y = wss)) +
    geom_point() +
    geom_line() +
    scale_x_continuous(breaks = seq(1, 20, by = 1))

Από το γράφημα, μπορείτε να δείτε το βέλτιστο k είναι επτά, όπου η καμπύλη αρχίζει να έχει φθίνουσα απόδοση.
Μόλις έχετε το βέλτιστο k, εκτελείτε ξανά τον αλγόριθμο με k ίσο με 7 και αξιολογείτε τα συμπλέγματα.
Εξέταση των συστάδων
pc_cluster_2 <-kmeans(rescale_df, 7)
Όπως αναφέρθηκε προηγουμένως, μπορείτε να έχετε πρόσβαση στις υπόλοιπες ενδιαφέρουσες πληροφορίες στη λίστα που επιστρέφεται από την kmean().
pc_cluster_2$cluster
pc_cluster_2$centers
pc_cluster_2$size
Η αξιολόγηση είναι υποκειμενική και εξαρτάται από τον σκοπό των συστάδων. Ο στόχος εδώ είναι η ομαδοποίηση υπολογιστών με παρόμοιες προδιαγραφές. Ένας ειδικός στον τομέα θα μπορούσε να το κάνει αυτό χειροκίνητα, αλλά η διαδικασία θα ήταν αργή και επιρρεπής σε σφάλματα. Το K-means κάνει την ομαδοποίηση.ping αντικειμενικά και αφήνει τον ειδικό να ερμηνεύσει και να ονομάσει το αποτέλεσμα.
Ως προηγούμενη αξιολόγηση, μπορείτε να εξετάσετε το μέγεθος των συμπλεγμάτων.
pc_cluster_2$size
Παραγωγή:
## [1] 608 1596 1231 580 1003 699 542
Η μεγαλύτερη συστάδα, η 2η, περιέχει 1,596 παρατηρήσεις, ενώ η μικρότερη, η 7η, περιέχει μόνο 542 υπολογιστές. Ίσως θα ήταν καλό να υπάρχει ομοιογένεια μεταξύ των συστάδων, διαφορετικά ίσως απαιτείται μια πιο αραιή προετοιμασία δεδομένων.
Με το κεντρικό στοιχείο, μπορείτε να εξετάσετε σε βάθος τα δεδομένα. Οι γραμμές αναφέρονται στην αρίθμηση της συστάδας και οι στήλες στις μεταβλητές που χρησιμοποιούνται από τον αλγόριθμο. Οι τιμές είναι η μέση βαθμολογία κάθε συστάδας για την ενδιαφερόμενη στήλη. Η τυποποίηση διευκολύνει την ερμηνεία. Οι θετικές τιμές υποδεικνύουν ότι η βαθμολογία z για μια δεδομένη συστάδα είναι πάνω από τον συνολικό μέσο όρο. Για παράδειγμα, η συστάδα 4 έχει την υψηλότερη μέση τιμή (price_scal = 1.09), ενώ η συστάδα 5 έχει τη χαμηλότερη (-0.82).
center <-pc_cluster_2$centers
center
Παραγωγή:
##   price_scal    hd_scal     ram_scal screen_scal   ads_scal trend_scal
## 1 -0.6372457 -0.7097995 -0.691520682  -0.4401632  0.6780366 -0.3379751
## 2 -0.1323863  0.6299541  0.004786730   2.6419582 -0.8894946  1.2673184
## 3  0.8745816  0.2574164  0.513105797  -0.2003237  0.6734261 -0.3300536
## 4  1.0912296 -0.2401936  0.006526723   2.6419582  0.4704301 -0.4132057
## 5 -0.8155183  0.2814882 -0.307621003  -0.3205176 -0.9052979  1.2177279
## 6  0.8830191  2.1019454  2.168706085   0.4492922 -0.9035248  1.2069855
## 7  0.2215678 -0.7132577 -0.318050275  -0.3878782 -1.3206229 -1.5490909
Μπορείτε να δημιουργήσετε έναν χάρτη θερμότητας με το ggplot για να μας βοηθήσετε να τονίσουμε τη διαφορά μεταξύ των κατηγοριών.
Τα προεπιλεγμένα χρώματα του ggplot πρέπει να αλλάξουν με τη βιβλιοθήκη RColorBrewer. Μπορείτε να χρησιμοποιήσετε το conda βιβλιοθήκη και τον κωδικό για εκκίνηση στο τερματικό:
conda install -c r r-rcolorbrewer
Για να δημιουργήσετε έναν χάρτη θερμότητας, ακολουθήστε τρία βήματα:
- Δημιουργήστε ένα πλαίσιο δεδομένων με τις τιμές του κέντρου και δημιουργήστε μια μεταβλητή με τον αριθμό του συμπλέγματος
- Αναδιαμορφώστε τα δεδομένα με τη συνάρτηση collect() της βιβλιοθήκης tidyr. Θέλετε να μετατρέψετε δεδομένα από ευρεία σε μεγάλη.
- Δημιουργήστε την παλέτα των χρωμάτων με χρώμαRampΛειτουργία Palette().
Βήμα 1) Δημιουργήστε ένα πλαίσιο δεδομένων
Ας δημιουργήσουμε το σύνολο δεδομένων ανασχηματισμού
library(tidyr)

# create dataset with the cluster number

cluster <- c(1: 7)
center_df <- data.frame(cluster, center)

# Reshape the data

center_reshape <- gather(center_df, features, values, price_scal: trend_scal)
head(center_reshape)
Παραγωγή:
##   cluster   features     values
## 1       1 price_scal -0.6372457
## 2       2 price_scal -0.1323863
## 3       3 price_scal  0.8745816
## 4       4 price_scal  1.0912296
## 5       5 price_scal -0.8155183
## 6       6 price_scal  0.8830191
Βήμα 2) Δημιουργήστε την παλέτα χρωμάτων
Ο παρακάτω κώδικας δημιουργεί την παλέτα χρωμάτων που χρησιμοποιούνται από τον χάρτη θερμότητας.
library(RColorBrewer)
# Create the palette
hm.palette <-colorRampPalette(rev(brewer.pal(10, 'RdYlGn')),space='Lab')
Βήμα 3) Οραματιστείτε
Μπορείτε να σχεδιάσετε το γράφημα και να δείτε πώς μοιάζουν τα συμπλέγματα.
# Plot the heat map
ggplot(data = center_reshape, aes(x = features, y = cluster, fill = values)) +
    scale_y_continuous(breaks = seq(1, 7, by = 1)) +
    geom_tile() +
    coord_equal() +
    scale_fill_gradientn(colours = hm.palette(90)) +
    theme_classic()

Πώς να λάβετε αναπαραγώγιμα αποτελέσματα K-Means με set.seed() και nstart
Το σεμινάριο σημειώνει ότι το k-means επιστρέφει διαφορετικές ομάδες σε κάθε εκτέλεση. Αυτό δεν είναι μια ιδιορρυθμία με την οποία πρέπει να συμβιβαζόμαστε, είναι ένα πρόβλημα με δύο τυπικές διορθώσεις και καμία από τις δύο δεν χρησιμοποιείται στα παραπάνω παραδείγματα.
1. Διορθώστε το σημείο εκκίνησης με την εντολή set.seed(). Τα αρχικά κεντροειδή επιλέγονται τυχαία, επομένως η ίδια κλήση παράγει διαφορετικές συστάδες κάθε φορά. Ο ορισμός ενός seed κάνει ολόκληρη την ανάλυση αναπαραγώγιμη:
set.seed(123)
pc_cluster_2 <- kmeans(rescale_df, 7)
2. Εκτελέστε αρκετές εκκινήσεις και διατηρήστε την καλύτερη με το nstart. Μια μεμονωμένη τυχαία εκκίνηση μπορεί να συγκλίνει σε ένα κακό τοπικό βέλτιστο. Το όρισμα nstart εκτελεί τον αλγόριθμο πολλές φορές από διαφορετικές τυχαίες εκκινήσεις και επιστρέφει αυτόν με το χαμηλότερο άθροισμα εντός του αθροίσματος τετραγώνων:
set.seed(123)
pc_cluster_2 <- kmeans(rescale_df, centers = 7, nstart = 25)
Είκοσι πέντε εκκινήσεις είναι η συνήθης σύσταση και κοστίζουν πολύ λίγο σε ένα σύνολο δεδομένων αυτού του μεγέθους. Χωρίς αυτήν, η ίδια η καμπύλη αγκώνα γίνεται ασταθής, επειδή κάθε σημείο στο γράφημα προέρχεται από μία μόνο άτυχη ή τυχερή εκκίνηση. Η συνάρτηση kmean_withinss() που ορίστηκε νωρίτερα θα πρέπει επομένως να γραφτεί ως:
kmean_withinss <- function(k) {
    cluster <- kmeans(rescale_df, centers = k, nstart = 25)
    return (cluster$tot.withinss)
}
3. Αυξήστε την τιμή iter.max εάν ο αλγόριθμος προειδοποιεί. Εάν η R αναφέρει «δεν συγκλίνει σε 10 επαναλήψεις», περάστε την τιμή iter.max = 50 για να της δώσετε περισσότερο χώρο.
K-Means vs Hierarchical Clusterμπαίνοντας στο R
Το K-means δεν είναι η μόνη διαθέσιμη μέθοδος ομαδοποίησης και η επιλογή συνήθως εξαρτάται από το μέγεθος των δεδομένων και από το αν γνωρίζετε ήδη πόσες ομάδες θέλετε.
| Κριτήρια | Κ-Μέσα | Ιεραρχικός |
|---|---|---|
| Αριθμός συστάδων | Πρέπει να επιλεγεί εκ των προτέρων | Επιλέχθηκε μετά, κόβοντας το δενδρογράφημα |
| Σταθερότητα αποτελέσματος | Ποικίλλει ανάλογα με την τυχαία έναρξη | Ντετερμινιστική |
| Απεριόριστες δυνατότητες | Χειρίζεται πολύ μεγάλα σύνολα δεδομένων | Παλεύει πέρα από μερικές χιλιάδες σειρές |
| Cluster σχήμα | Υποθέτει περίπου σφαιρικές, παρόμοιου μεγέθους ομάδες | πιο ευέλικτη |
| Παραγωγή | Ένα επίπεδο σύνολο ετικετών | Ένα δενδρογράφημα που δείχνει ένθετη δομή |
| Συνάρτηση R | kmeans(df, k) | hclust(dist(df)) |
# Hierarchical alternative on the same scaled data
hc <- hclust(dist(rescale_df), method = "ward.D2")
plot(hc)
groups <- cutree(hc, k = 7)
Με 6,259 παρατηρήσεις, η ιεραρχική ομαδοποίηση πρέπει να δημιουργήσει έναν πίνακα αποστάσεων περίπου 19.6 εκατομμυρίων ζευγών, γι' αυτό και ο k-means είναι η πρακτική επιλογή για αυτό το σύνολο δεδομένων. Σημειώστε επίσης ότι ο k-means υποθέτει συστάδες παρόμοιου μεγέθους και περίπου σφαιρικού σχήματος. Όπου αυτή η υπόθεση αποτυγχάνει, το DBSCAN χειρίζεται ακανόνιστα σχήματα και αναγνωρίζει ακραίες τιμές αντί να αναγκάζει κάθε σημείο να ενταχθεί σε μια ομάδα.
Κ-Μέσα Clustering σε R: Αναφορά συνάρτησης
Κάθε συνάρτηση που χρησιμοποιείται σε αυτό το σεμινάριο παρατίθεται παρακάτω:
| Πακέτο | Σκοπός | Λειτουργία | Διαφωνία |
|---|---|---|---|
| βάση | Τρένο k-μέσο | kmeans () | df, k |
| Σύμπλεγμα πρόσβασης | kmeans()$cluster | ||
| Cluster κέντρα | kmeans()$centers | ||
| Cluster μεγέθη | kmeans()$μέγεθος | ||
| Σύνολο εντός του αθροίσματος των τετραγώνων | kmeans()$tot.withinss | Χρησιμοποιείται με τη μέθοδο του αγκώνα | |
| Μεταξύ αθροίσματος τετραγώνων | kmeans()$betweenss | ||
| βάση | Αναπαραγώγιμη εκτέλεση | set.seed() | αξία σπόρων |
| βάση | Σταθεροποιήστε το αποτέλεσμα | kmeans(df, k, nstart = 25) | nstart |
