
PyTorch Tutorial
 Έβελιν Κλαρκ
⚡ Έξυπνη Σύνοψη
PyTorΤο ch είναι το πλαίσιο βαθιάς μάθησης ανοιχτού κώδικα από την Meta, το οποίο τροφοδοτεί πλέον το 85% των ερευνητικών εργασιών στον τομέα της Τεχνητής Νοημοσύνης το 2026. LessΤα ons καλύπτουν την εγκατάσταση, τα βασικά του framework, την απλή παλινδρόμηση, την ταξινόμηση εικόνων και την ανάπτυξη του AWS SageMaker.
Τι είναι το PyTorη;
PyTorch είναι ανοιχτού κώδικα TorΒιβλιοθήκη Μηχανικής Μάθησης που βασίζεται σε ch για επεξεργασία φυσικής γλώσσας χρησιμοποιώντας PythonΕίναι παρόμοιο με το NumPy αλλά με ισχυρή υποστήριξη GPU. Προσφέρει Δυναμικά Υπολογιστικά Γραφήματα που μπορείτε να τροποποιήσετε εν κινήσει με τη βοήθεια του autograd. PyTorΤο ch είναι επίσης πιο γρήγορο από ορισμένα άλλα frameworks. Αναπτύχθηκε από την ομάδα έρευνας τεχνητής νοημοσύνης του Facebook το 2016.
Γνωρίζοντας τι PyTorΤο ch δίνει μια ισορροπημένη ματιά στα δυνατά και τα μειονεκτήματά του.
PyTorΠλεονεκτήματα και μειονεκτήματα
Ακολουθούν τα πλεονεκτήματα και τα μειονεκτήματα του Py:Torch:
Πλεονεκτήματα του PyTorch
- Απλή Βιβλιοθήκη
PyTorΟ κώδικας ch είναι απλός. Είναι εύκολος στην κατανόηση και χρησιμοποιείτε τη βιβλιοθήκη αμέσως. Για παράδειγμα, ρίξτε μια ματιά στο παρακάτω απόσπασμα κώδικα:
class Net(torch.nn.Module):
   def __init__(self):
       super(Net, self).__init__()
       self.layer = torch.nn.Linear(1, 1)

   def forward(self, x):
       x = self.layer(x)
       return x
Όπως αναφέρθηκε παραπάνω, μπορείτε να ορίσετε το μοντέλο δικτύου εύκολα και μπορείτε να κατανοήσετε τον κώδικα γρήγορα χωρίς πολλή εκπαίδευση.
- Δυναμικό Υπολογιστικό Γράφημα

Πηγή εικόνας: Εξερευνώντας τη Βαθιά Μάθηση με PyTorch
PyTorΤο ch προσφέρει Δυναμικό Υπολογιστικό Γράφημα (DAG). Τα υπολογιστικά γραφήματα είναι ένας τρόπος έκφρασης μαθηματικών εκφράσεων σε μοντέλα γραφημάτων ή θεωρίες όπως κόμβοι και ακμές. Ο κόμβος θα εκτελέσει τη μαθηματική πράξη και η ακμή είναι ένας Tensor που θα τροφοδοτηθεί στους κόμβους και θα μεταφέρει την έξοδο του κόμβου στο Tensor.
Το DAG είναι ένα γράφημα που έχει αυθαίρετο σχήμα και μπορεί να κάνει πράξεις μεταξύ διαφορετικών γραφημάτων εισόδου. Κάθε επανάληψη δημιουργείται ένα νέο γράφημα. Έτσι, είναι δυνατόν να έχουμε την ίδια δομή γραφήματος ή να δημιουργήσουμε ένα νέο γράφημα με διαφορετική λειτουργία ή μπορούμε να το ονομάσουμε δυναμικό γράφημα.
- καλύτερη απόδοση
Κοινότητες και ερευνητές, μετρήστε και συγκρίνετε πλαίσια για να δείτε ποιο είναι πιο γρήγορο. Ένα αποθετήριο GitHub Σημείο αναφοράς σε πλαίσια Deep Learning και GPU ανέφερε ότι ο PyTorΤο ch είναι ταχύτερο από το άλλο πλαίσιο όσον αφορά τις εικόνες που επεξεργάζονται ανά δευτερόλεπτο.
Όπως μπορείτε να δείτε παρακάτω, τα γραφήματα σύγκρισης με το vgg16 και το resnet152


- Native Python
PyTorΤο ch βασίζεται περισσότερο σε python. Για παράδειγμα, αν θέλετε να εκπαιδεύσετε ένα μοντέλο, μπορείτε να χρησιμοποιήσετε εγγενή ροή ελέγχου όπως το loo.ping και αναδρομές χωρίς την ανάγκη προσθήκης περισσότερων ειδικών μεταβλητών ή συνεδριών για την εκτέλεσή τους. Αυτό είναι πολύ χρήσιμο για τη διαδικασία εκπαίδευσης.
PyTorΤο ch εφαρμόζει επίσης Προστακτικό Προγραμματισμό, και είναι σίγουρα πιο ευέλικτο. Έτσι, είναι δυνατό να εκτυπώσετε την τιμή του τανυστήρα στη μέση μιας υπολογιστικής διαδικασίας.
Μειονέκτημα του PyTorch
PyTorΤο ch απαιτεί εφαρμογές τρίτων για οπτικοποίηση. Χρειάζεται επίσης έναν διακομιστή API για παραγωγή.
Επόμενο σε αυτό το PyTorch tutorial, θα μάθουμε για τη διαφορά μεταξύ PyTorch και TensorFlow.
PyTorch εναντίον TensorFlow
| Παράμετρος | PyTorch | TensorFlow |
|---|---|---|
| Ορισμός μοντέλου | Το μοντέλο ορίζεται σε μια υποκατηγορία και προσφέρει εύχρηστο πακέτο | Το μοντέλο ορίζεται με πολλά και πρέπει να κατανοήσετε τη σύνταξη |
| Υποστήριξη GPU | Ναι | Ναι |
| Τύπος γραφήματος | Δυναμικός | Στατικός |
| Κόλλα | Χωρίς εργαλείο οπτικοποίησης | Μπορείτε να χρησιμοποιήσετε το εργαλείο οπτικοποίησης Tensorboard |
| Κοινότητα | Η κοινότητα εξακολουθεί να μεγαλώνει | Μεγάλες ενεργές κοινότητες |
Έχοντας κατά νου τη σύγκριση, το επόμενο βήμα είναι να βρούμε την PyTorch που εκτελείται τοπικά ή στο cloud.
Εγκατάσταση PyTorch
Linux
Είναι εύκολο να το εγκαταστήσετε σε Linux. Μπορείτε να επιλέξετε να χρησιμοποιήσετε ένα εικονικό περιβάλλον ή να το εγκαταστήσετε απευθείας με πρόσβαση root. Πληκτρολογήστε αυτήν την εντολή στο τερματικό
pip3 install --upgrade torch torchvision
AWS Sagemaker
Το Sagemaker είναι μία από τις πλατφόρμες Amazon Υπηρεσία Ιστού που προσφέρει μια ισχυρή μηχανή μηχανικής εκμάθησης με προεγκατεστημένες διαμορφώσεις βαθιάς εκμάθησης για επιστήμονες δεδομένων ή προγραμματιστές για την κατασκευή, την εκπαίδευση και την ανάπτυξη μοντέλων σε οποιαδήποτε κλίμακα.
Πρώτα ανοίξτε το Amazon Ψαλίδι κονσόλα και κάντε κλικ στο Create notebook instance και συμπληρώστε όλα τα στοιχεία για το notebook σας.

Επόμενο βήμα, κάντε κλικ στο Άνοιγμα για να εκκινήσετε την παρουσία του φορητού υπολογιστή σας.

Τέλος, το In Jupyter, Κάντε κλικ στο Νέο και επιλέξτε conda_pytorch_p36 και είστε έτοιμοι να χρησιμοποιήσετε την παρουσία του σημειωματάριού σας με PyTorch εγκατεστημένο.
Επόμενο σε αυτό το PyTorch tutorial, θα μάθουμε για το PyTorΒασικά στοιχεία πλαισίου ch.
Αφού εγκατασταθεί, το ίδιο το API είναι η επόμενη στάση.
PyTorΒασικά στοιχεία πλαισίου ch
Ας μάθουμε τις βασικές έννοιες του PyTorch πριν βουτήξουμε βαθιά. PyTorΤο ch χρησιμοποιεί Tensor για κάθε μεταβλητή παρόμοια με την ndarray του numpy αλλά με υποστήριξη υπολογισμού GPU. Εδώ θα εξηγήσουμε το μοντέλο δικτύου, τη συνάρτηση απώλειας, το Backprop και το Optimizer.
Μοντέλο δικτύου
Το δίκτυο μπορεί να κατασκευαστεί με υποκατηγορία του φακού.nn. Υπάρχουν 2 κύρια μέρη,
- Το πρώτο μέρος είναι να ορίσετε τις παραμέτρους και τα επίπεδα που θα χρησιμοποιήσετε
- Το δεύτερο μέρος είναι η κύρια εργασία που ονομάζεται διαδικασία προώθησης που θα λάβει μια είσοδο και θα προβλέψει την έξοδο.
Import torch
import torch.nn as nn
import torch.nn.functional as F

class Model(nn.Module):
 def __init__(self):
        super(Model, self).__init__()
        self.conv1 = nn.Conv2d(3, 20, 5)
        self.conv2 = nn.Conv2d(20, 40, 5)
self.fc1 = nn.Linear(320, 10)

def forward(self, x):
       x = F.relu(self.conv1(x))
       x = F.relu(self.conv2(x))
       x = x.view(-1, 320)
       x = F.relu(self.fc1(x))
       return F.log_softmax(x)

net = Model()
Όπως μπορείτε να δείτε παραπάνω, δημιουργείτε μια κλάση nn.Module που ονομάζεται Model. Περιέχει 2 επίπεδα Conv2d και ένα Γραμμικό επίπεδο. Το πρώτο στρώμα conv2d έχει είσοδο 3 και το σχήμα εξόδου 20. Το δεύτερο στρώμα θα λάβει μια είσοδο 20 και θα παράγει ένα σχήμα εξόδου 40. Το τελευταίο στρώμα είναι ένα πλήρως συνδεδεμένο στρώμα σε σχήμα 320 και θα παράγει έξοδο 10.
Η διαδικασία προώθησης θα λάβει μια είσοδο του X και θα την τροφοδοτήσει στο επίπεδο μετατροπής και θα εκτελέσει τη λειτουργία ReLU,
Ομοίως, θα τροφοδοτήσει επίσης το επίπεδο conv2. Μετά από αυτό, το x θα αναδιαμορφωθεί σε (-1, 320) και θα τροφοδοτηθεί στο τελικό στρώμα FC. Πριν στείλετε την έξοδο, θα χρησιμοποιήσετε τη λειτουργία ενεργοποίησης softmax.
Η διαδικασία προς τα πίσω ορίζεται αυτόματα από το autograd, επομένως χρειάζεται μόνο να ορίσετε τη διαδικασία προώθησης.
Λειτουργία απώλειας
Η συνάρτηση απώλειας χρησιμοποιείται για να μετρήσει πόσο καλά το μοντέλο πρόβλεψης είναι σε θέση να προβλέψει τα αναμενόμενα αποτελέσματα. PyTorΤο ch έχει ήδη πολλές τυπικές συναρτήσεις απώλειας στην ενότητα torch.nn. Για παράδειγμα, μπορείτε να χρησιμοποιήσετε την Απώλεια Διασταυρούμενης Εντροπίας για να λύσετε ένα πρόβλημα Py πολλαπλών κλάσεων.Torπρόβλημα ταξινόμησης ch. Είναι εύκολο να ορίσετε τη συνάρτηση απώλειας και να υπολογίσετε τις απώλειες:
loss_fn = nn.CrossEntropyLoss()

#training process
loss = loss_fn(out, target)
Είναι εύκολο να χρησιμοποιήσετε τον δικό σας υπολογισμό συνάρτησης απώλειας με PyTorch.
Στήριγμα πλάτης
Για να εκτελέσετε την backpropagation, καλείτε απλώς το los.backward(). Το σφάλμα θα υπολογιστεί, αλλά θυμηθείτε να διαγράψετε την υπάρχουσα διαβάθμιση με zero_grad()
net.zero_grad() # to clear the existing gradient
loss.backward() # to perform backpropragation
Optimizer
Το torch.optim παρέχει κοινούς αλγόριθμους βελτιστοποίησης. Μπορείτε να ορίσετε έναν βελτιστοποιητή με ένα απλό βήμα:
optimizer = torch.optim.SGD(net.parameters(), lr = 0.01, momentum=0.9)
Πρέπει να μεταβιβάσετε τις παραμέτρους του μοντέλου δικτύου και τον ρυθμό εκμάθησης, έτσι ώστε σε κάθε επανάληψη οι παράμετροι να ενημερώνονται μετά τη διαδικασία backprop.
Ο πιο καθαρός τρόπος για να μάθετε το API είναι ένα μικρό, ολοκληρωμένο παράδειγμα.
Απλή Παλινδρόμηση με PyTorch
Ας μάθουμε απλή παλινδρόμηση με PyTorπαραδείγματα ch:
Βήμα 1) Δημιουργία μοντέλου δικτύου
Το μοντέλο δικτύου μας είναι ένα απλό Γραμμικό επίπεδο με σχήμα εισόδου και εξόδου 1.
from __future__ import print_function

import torch
import torch.nn as nn
import torch.nn.functional as F
from torch.autograd import Variable

class Net(nn.Module):
   def __init__(self):
       super(Net, self).__init__()
       self.layer = torch.nn.Linear(1, 1)

   def forward(self, x):
       x = self.layer(x)
       return x

net = Net()
print(net)
Και η έξοδος δικτύου θα πρέπει να είναι έτσι
Net(
  (hidden): Linear(in_features=1, out_features=1, bias=True)
)
Βήμα 2) Δεδομένα δοκιμής
Πριν ξεκινήσετε τη διαδικασία εκπαίδευσης, πρέπει να γνωρίζετε τα δεδομένα μας. Δημιουργείτε μια τυχαία συνάρτηση για να δοκιμάσετε το μοντέλο μας. Υ = x3 sin(x)+ 3x+0.8 rand(100)
# Visualize our data
import matplotlib.pyplot as plt
import numpy as np

x = np.random.rand(100)
y = np.sin(x) * np.power(x,3) + 3*x + np.random.rand(100)*0.8

plt.scatter(x, y)
plt.show()
Εδώ είναι το διάγραμμα διασποράς της συνάρτησής μας:

Πριν ξεκινήσετε τη διαδικασία εκπαίδευσης, πρέπει να μετατρέψετε τον πίνακα numpy σε μεταβλητές που υποστηρίζονται από Torch και autograd όπως φαίνεται στο παρακάτω PyTorπαράδειγμα παλινδρόμησης ch.
# convert numpy array to tensor in shape of input size
x = torch.from_numpy(x.reshape(-1,1)).float()
y = torch.from_numpy(y.reshape(-1,1)).float()
print(x, y)
Βήμα 3) Optimizer and Loss
Στη συνέχεια, θα πρέπει να ορίσετε το Optimizer και τη συνάρτηση απώλειας για τη διαδικασία εκπαίδευσής μας.
# Define Optimizer and Loss Function
optimizer = torch.optim.SGD(net.parameters(), lr=0.2)
loss_func = torch.nn.MSELoss()
Βήμα 4) Εκπαίδευση
Τώρα ας ξεκινήσουμε την προπονητική μας διαδικασία. Με μια εποχή 250, θα επαναλάβετε τα δεδομένα μας για να βρείτε την καλύτερη τιμή για τις υπερπαραμέτρους μας.
inputs = Variable(x)
outputs = Variable(y)
for i in range(250):
   prediction = net(inputs)
   loss = loss_func(prediction, outputs)
   optimizer.zero_grad()
   loss.backward()
   optimizer.step()

   if i % 10 == 0:
       # plot and show learning process
       plt.cla()
       plt.scatter(x.data.numpy(), y.data.numpy())
       plt.plot(x.data.numpy(), prediction.data.numpy(), 'r-', lw=2)
       plt.text(0.5, 0, 'Loss=%.4f' % loss.data.numpy(), fontdict={'size': 10, 'color':  'red'})
       plt.pause(0.1)

plt.show()
Βήμα 5) Αποτέλεσμα
Όπως μπορείτε να δείτε παρακάτω, εκτελέσατε με επιτυχία την PyTorπαλινδρόμηση ch με ένα νευρωνικό δίκτυο. Στην πραγματικότητα, σε κάθε επανάληψη, η κόκκινη γραμμή στο διάγραμμα θα ενημερώνεται και θα αλλάζει τη θέση της ώστε να ταιριάζει στα δεδομένα. Αλλά σε αυτήν την εικόνα, σας δείχνει μόνο το τελικό αποτέλεσμα όπως φαίνεται στο παρακάτω Py.Torπαράδειγμα ch:

Η παλινδρόμηση είναι μια προθέρμανση· η ταξινόμηση εικόνων ασκεί τους μύες βαθιάς μάθησης του Py.Torch.
Παράδειγμα Ταξινόμησης Εικόνων με PyTorch
Μία από τις δημοφιλείς μεθόδους για να μάθετε τα βασικά βαθιά μάθηση είναι με το σύνολο δεδομένων MNIST. Είναι το «Hello World» στη βαθιά μάθηση. Το σύνολο δεδομένων περιέχει χειρόγραφους αριθμούς από το 0 έως το 9 με το σύνολο των 60,000 δειγμάτων εκπαίδευσης και 10,000 δειγμάτων δοκιμής που έχουν ήδη επισημανθεί με το μέγεθος 28×28 pixel.

Βήμα 1) Προεπεξεργαστείτε τα Δεδομένα
Στο πρώτο βήμα αυτού του PyTorΣτο παράδειγμα ταξινόμησης ch, θα φορτώσετε το σύνολο δεδομένων χρησιμοποιώντας τη μονάδα torchvision.
Πριν ξεκινήσετε τη διαδικασία εκπαίδευσης, πρέπει να κατανοήσετε τα δεδομένα. TorΤο chvision θα φορτώσει το σύνολο δεδομένων και θα μετασχηματίσει τις εικόνες με τις κατάλληλες απαιτήσεις για το δίκτυο, όπως το σχήμα και την ομαλοποίηση των εικόνων.
import torch
import torchvision
import numpy as np
from torchvision import datasets, models, transforms

# This is used to transform the images to Tensor and normalize it
transform = transforms.Compose(
   [transforms.ToTensor(),
    transforms.Normalize((0.5, 0.5, 0.5), (0.5, 0.5, 0.5))])

training = torchvision.datasets.MNIST(root='./data', train=True,
                                       download=True, transform=transform)
train_loader = torch.utils.data.DataLoader(training, batch_size=4,
                                         shuffle=True, num_workers=2)

testing = torchvision.datasets.MNIST(root='./data', train=False,
                                      download=True, transform=transform)
test_loader = torch.utils.data.DataLoader(testing, batch_size=4,
                                        shuffle=False, num_workers=2)

classes = ('0', '1', '2', '3',
          '4', '5', '6', '7', '8', '9')

import matplotlib.pyplot as plt
import numpy as np

#create an iterator for train_loader
# get random training images
data_iterator = iter(train_loader)
images, labels = data_iterator.next()

#plot 4 images to visualize the data
rows = 2
columns = 2
fig=plt.figure()
for i in range(4):
   fig.add_subplot(rows, columns, i+1)
   plt.title(classes[labels[i]])
   img = images[i] / 2 + 0.5     # this is for unnormalize the image
   img = torchvision.transforms.ToPILImage()(img)
   plt.imshow(img)
plt.show()
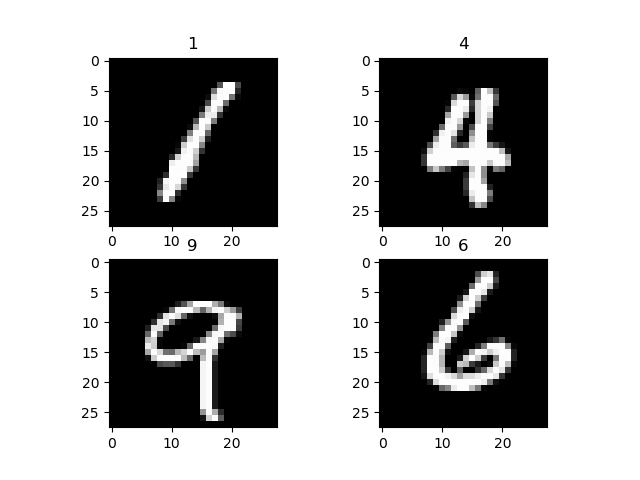
Η συνάρτηση μετασχηματισμού μετατρέπει τις εικόνες σε τανυστή και κανονικοποιεί την τιμή. Η συνάρτηση torchvision.transforms.MNIST, θα κατεβάσει το σύνολο δεδομένων (εάν δεν είναι διαθέσιμο) στον κατάλογο, θα ορίσει το σύνολο δεδομένων για εκπαίδευση εάν είναι απαραίτητο και θα κάνει τη διαδικασία μετασχηματισμού.
Για να οπτικοποιήσετε το σύνολο δεδομένων, χρησιμοποιείτε το data_iterator για να λάβετε την επόμενη παρτίδα εικόνων και ετικετών. Χρησιμοποιείτε matplot για να σχεδιάσετε αυτές τις εικόνες και την κατάλληλη ετικέτα τους. Όπως μπορείτε να δείτε παρακάτω τις εικόνες μας και τις ετικέτες τους.
Βήμα 2) Διαμόρφωση μοντέλου δικτύου
Τώρα σε αυτό το PyTorπαράδειγμα, θα δημιουργήσετε ένα απλό νευρωνικό δίκτυο για PyTorταξινόμηση εικόνας ch.
Εδώ, σας παρουσιάζουμε έναν άλλο τρόπο δημιουργίας του μοντέλου δικτύου στο PyTorκεφ. Θα χρησιμοποιήσουμε την nn.Sequential για να δημιουργήσουμε ένα μοντέλο ακολουθίας αντί να δημιουργήσουμε μια υποκλάση της nn.Module.
import torch.nn as nn

# flatten the tensor into
class Flatten(nn.Module):
   def forward(self, input):
       return input.view(input.size(0), -1)

#sequential based model
seq_model = nn.Sequential(
           nn.Conv2d(1, 10, kernel_size=5),
           nn.MaxPool2d(2),
           nn.ReLU(),
           nn.Dropout2d(),
           nn.Conv2d(10, 20, kernel_size=5),
           nn.MaxPool2d(2),
           nn.ReLU(),
           Flatten(),
           nn.Linear(320, 50),
           nn.ReLU(),
           nn.Linear(50, 10),
           nn.Softmax(),
         )

net = seq_model
print(net)
Εδώ είναι η έξοδος του μοντέλου δικτύου μας
Sequential(
  (0): Conv2d(1, 10, kernel_size=(5, 5), stride=(1, 1))
  (1): MaxPool2d(kernel_size=2, stride=2, padding=0, dilation=1, ceil_mode=False)
  (2): ReLU()
  (3): Dropout2d(p=0.5)
  (4): Conv2d(10, 20, kernel_size=(5, 5), stride=(1, 1))
  (5): MaxPool2d(kernel_size=2, stride=2, padding=0, dilation=1, ceil_mode=False)
  (6): ReLU()
  (7): Flatten()
  (8): Linear(in_features=320, out_features=50, bias=True)
  (9): ReLU()
  (10): Linear(in_features=50, out_features=10, bias=True)
  (11): Softmax()
)
Επεξήγηση δικτύου
- Η ακολουθία είναι ότι το πρώτο στρώμα είναι ένα στρώμα Conv2D με σχήμα εισόδου 1 και σχήμα εξόδου 10 με μέγεθος πυρήνα 5
- Στη συνέχεια, έχετε ένα επίπεδο MaxPool2D
- Μια λειτουργία ενεργοποίησης ReLU
- ένα επίπεδο εγκατάλειψης για πτώση τιμών χαμηλών πιθανοτήτων.
- Στη συνέχεια, ένα δεύτερο Conv2d με το σχήμα εισόδου 10 από το τελευταίο στρώμα και το σχήμα εξόδου 20 με μέγεθος πυρήνα 5
- Στη συνέχεια, ένα στρώμα MaxPool2d
- Λειτουργία ενεργοποίησης ReLU.
- Μετά από αυτό, θα ισοπεδώσετε τον τανυστήρα πριν τον τροφοδοτήσετε στο Γραμμικό στρώμα
- Το Linear Layer θα χαρτογραφήσει την έξοδο μας στο δεύτερο Linear layer με τη λειτουργία ενεργοποίησης softmax
Βήμα 3) Εκπαιδεύστε το μοντέλο
Πριν ξεκινήσετε τη διαδικασία εκπαίδευσης, απαιτείται να ρυθμίσετε το κριτήριο και τη λειτουργία βελτιστοποίησης.
Για το κριτήριο, θα χρησιμοποιήσετε το CrossEntropyLoss. Για τον Optimizer, θα χρησιμοποιήσετε το SGD με ρυθμό εκμάθησης 0.001 και ορμή 0.9 όπως φαίνεται στο παρακάτω Py.Torπαράδειγμα ch.
import torch.optim as optim

criterion = nn.CrossEntropyLoss()
optimizer = optim.SGD(net.parameters(), lr=0.001, momentum=0.9)
Η διαδικασία προώθησης θα πάρει το σχήμα εισόδου και θα το περάσει στο πρώτο επίπεδο conv2d. Στη συνέχεια, από εκεί, θα τροφοδοτηθεί στο maxpool2d και τελικά θα τεθεί στη λειτουργία ενεργοποίησης ReLU. Η ίδια διαδικασία θα συμβεί στο δεύτερο επίπεδο conv2d. Μετά από αυτό, η είσοδος θα αναδιαμορφωθεί σε (-1,320) και θα τροφοδοτηθεί στο επίπεδο fc για να προβλέψει την έξοδο.
Τώρα, θα ξεκινήσετε τη διαδικασία εκπαίδευσης. Θα επαναλάβετε το σύνολο δεδομένων μας 2 φορές ή με μια εποχή 2 και θα εκτυπώσετε την τρέχουσα απώλεια σε κάθε παρτίδα 2000.
for epoch in range(2):

#set the running loss at each epoch to zero
   running_loss = 0.0
# we will enumerate the train loader with starting index of 0
# for each iteration (i) and the data (tuple of input and labels)
   for i, data in enumerate(train_loader, 0):
       inputs, labels = data

# clear the gradient
       optimizer.zero_grad()

#feed the input and acquire the output from network
       outputs = net(inputs)

#calculating the predicted and the expected loss
       loss = criterion(outputs, labels)

#compute the gradient
       loss.backward()

#update the parameters
       optimizer.step()

       # print statistics
       running_loss += loss.item()
       if i % 1000 == 0:
           print('[%d, %5d] loss: %.3f' %
                 (epoch + 1, i + 1, running_loss / 1000))
           running_loss = 0.0
Σε κάθε εποχή, ο απαριθμητής θα λάβει την επόμενη πλειάδα εισόδου και τις αντίστοιχες ετικέτες. Πριν τροφοδοτήσουμε την είσοδο στο μοντέλο δικτύου μας, πρέπει να καθαρίσουμε την προηγούμενη κλίση. Αυτό απαιτείται γιατί μετά τη διαδικασία προς τα πίσω (διαδικασία backpropagation), η κλίση θα συσσωρευτεί αντί να αντικατασταθεί. Στη συνέχεια, θα υπολογίσουμε τις απώλειες από την προβλεπόμενη παραγωγή από την αναμενόμενη παραγωγή. Μετά από αυτό, θα κάνουμε backpropagation για να υπολογίσουμε την κλίση και, τέλος, θα ενημερώσουμε τις παραμέτρους.
Εδώ είναι το αποτέλεσμα της εκπαιδευτικής διαδικασίας
[1, 	1] loss: 0.002
[1,  1001] loss: 2.302
[1,  2001] loss: 2.295
[1,  3001] loss: 2.204
[1,  4001] loss: 1.930
[1,  5001] loss: 1.791
[1,  6001] loss: 1.756
[1,  7001] loss: 1.744
[1,  8001] loss: 1.696
[1,  9001] loss: 1.650
[1, 10001] loss: 1.640
[1, 11001] loss: 1.631
[1, 12001] loss: 1.631
[1, 13001] loss: 1.624
[1, 14001] loss: 1.616
[2, 	1] loss: 0.001
[2,  1001] loss: 1.604
[2,  2001] loss: 1.607
[2,  3001] loss: 1.602
[2,  4001] loss: 1.596
[2,  5001] loss: 1.608
[2,  6001] loss: 1.589
[2,  7001] loss: 1.610
[2,  8001] loss: 1.596
[2,  9001] loss: 1.598
[2, 10001] loss: 1.603
[2, 11001] loss: 1.596
[2, 12001] loss: 1.587
[2, 13001] loss: 1.596
[2, 14001] loss: 1.603
Βήμα 4) Δοκιμάστε το μοντέλο
Αφού εκπαιδεύσετε το μοντέλο μας, πρέπει να δοκιμάσετε ή να αξιολογήσετε με άλλα σύνολα εικόνων.
Θα χρησιμοποιήσουμε έναν επαναλήπτη για το test_loader και θα δημιουργήσει μια παρτίδα εικόνων και ετικετών που θα περάσουν στο εκπαιδευμένο μοντέλο. Η προβλεπόμενη έξοδος θα εμφανιστεί και θα συγκριθεί με την αναμενόμενη έξοδο.
#make an iterator from test_loader
#Get a batch of training images
test_iterator = iter(test_loader)
images, labels = test_iterator.next()

results = net(images)
_, predicted = torch.max(results, 1)

print('Predicted: ', ' '.join('%5s' % classes[predicted[j]] for j in range(4)))

fig2 = plt.figure()
for i in range(4):
   fig2.add_subplot(rows, columns, i+1)
   plt.title('truth ' + classes[labels[i]] + ': predict ' + classes[predicted[i]])
   img = images[i] / 2 + 0.5     # this is to unnormalize the image
   img = torchvision.transforms.ToPILImage()(img)
   plt.imshow(img)
plt.show()

