
Sådan installeres Hadoop på UbuntuDownload- og opsætningstrin
 Prafulla Ranadive
⚡ Smart opsummering
Installation af Apache Hadoop på Ubuntu tager to gennemgange: udpak udgivelsen under en dedikeret systemkonto med adgangskodefri SSH, rediger derefter fire XML-filer før formatering af HDFS og start af single-node-klyngen.
I denne vejledning vil vi trin for trin gennemgå processen med at installere Apache Hadoop på en Linux-computer (Ubuntu). Dette er en proces i to dele: først download og installer versionen, derefter konfigurer den.
Der er to forudsætninger:
- Du skal have Ubuntu installeret og løber.
- Du skal have Java installeret.
Hadoop 3.x-versionsnoter for denne opsætning
Skærmbillederne i denne gennemgang blev taget på Hadoop 2.2.0. Trinrækkefølgen er uændret i de nuværende versioner, men en håndfuld navne og standardindstillinger er flyttet. Tjek tabellen nedenfor, før du kopierer en kommando ordret.
| Indstilling eller trin | I denne vejledning (Hadoop 2.x) | Nuværende Hadoop 3.x |
|---|---|---|
| Udgivelsesarkiv | hadoop-2.2.0.tar.gz |
hadoop-3.5.0.tar.gz, den første stabile 3.5-udgivelse, udgivet 2. april 2026 |
| Standard filsystemegenskab | fs.default.name i prosaen, fs.defaultFS i XML-filen |
fs.defaultFS kun; fs.default.name er udfaset |
| MapReduce-egenskaben | mapreduce.jobtracker.address |
mapreduce.framework.name indstillet til yarn; jobbetTracker eksisterer ikke længere, når YARN planlægger arbejdet |
| mapred-site.xml | Kopieret fra mapred-site.xml.template |
Sender ind etc/hadoop allerede, så kopieringstrinnet er unødvendigt |
| NameNode web UI-port | 50070 | 9870 |
| Java | Java 6 eller Java 7 | Java 8 eller Java 11 |
Alt andet i denne vejledning opfører sig på samme måde på Hadoop 3: den dedikerede konto, SSH-nøglen, de fire konfigurationsfiler og start- og stop-scripts.
Del 1) Download og installer Hadoop
Trin 1) Tilføj en Hadoop-systembruger
Tilføj en Hadoop-systembruger ved hjælp af kommandoen nedenfor.
sudo addgroup hadoop_

sudo adduser --ingroup hadoop_ hduser_
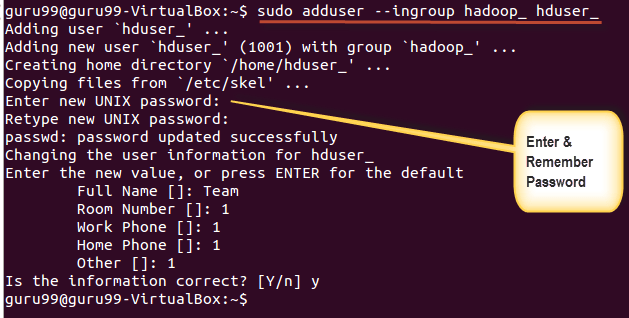
Indtast din adgangskode, navn og andre detaljer.
BEMÆRK VENLIGST: Der er mulighed for nedenstående fejl i denne opsætnings- og installationsproces.
"hduser er ikke i sudoers-filen. Denne hændelse vil blive rapporteret."

Denne fejl kan løses ved at logge ind som root-bruger.
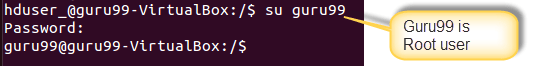
Udfør kommandoen
sudo adduser hduser_ sudo

Re-login as hduser_

Trin 2) Konfigurer SSH
For at administrere noder i en klynge kræver Hadoop SSH-adgang.
Først, skift bruger, indtast følgende kommando
su - hduser_

Denne kommando vil oprette en ny nøgle.
ssh-keygen -t rsa -P ""

Aktiver SSH-adgang til den lokale maskine ved hjælp af denne nøgle.
cat $HOME/.ssh/id_rsa.pub >> $HOME/.ssh/authorized_keys

Test nu SSH-opsætningen ved at oprette forbindelse til localhost som 'hduser_'-brugeren.
ssh localhost

Bemærk: Hvis du ser fejlen nedenfor som svar på 'ssh localhost', er der en mulighed for, at SSH ikke er tilgængelig på dette system.

For at løse dette –
Tøm SSH ved hjælp af,
sudo apt-get purge openssh-server
Det er god praksis at rense ud, inden installationen påbegyndes.

Installer SSH ved hjælp af kommandoen-
sudo apt-get install openssh-server

Trin 3) Download Hadoop
Det næste trin er at downloade Hadoop fra Apache Hadoop-udgivelsesside.

Vælg Stabil

Vælg tar.gz-filen (ikke filen, der ender på src).

Når downloadingen er færdig, skal du navigere til den mappe, der indeholder tar-filen.

Enter,
sudo tar xzf hadoop-2.2.0.tar.gz

Omdøb nu hadoop-2.2.0 til hadoop.
sudo mv hadoop-2.2.0 hadoop

Til sidst skal du give mappen til den nye konto.
sudo chown -R hduser_:hadoop_ hadoop

Erstat den version, du rent faktisk downloadede hadoop-2.2.0 i de tre ovenstående kommandoer.
Del 2) Konfigurer Hadoop
Trin 1) Rediger ~/.bashrc-filen
Tilføj følgende linjer til slutningen af filen ~/.bashrc.
#Set HADOOP_HOME
export HADOOP_HOME=<Installation Directory of Hadoop>
#Set JAVA_HOME
export JAVA_HOME=<Installation Directory of Java>
# Add bin/ directory of Hadoop to PATH
export PATH=$PATH:$HADOOP_HOME/bin
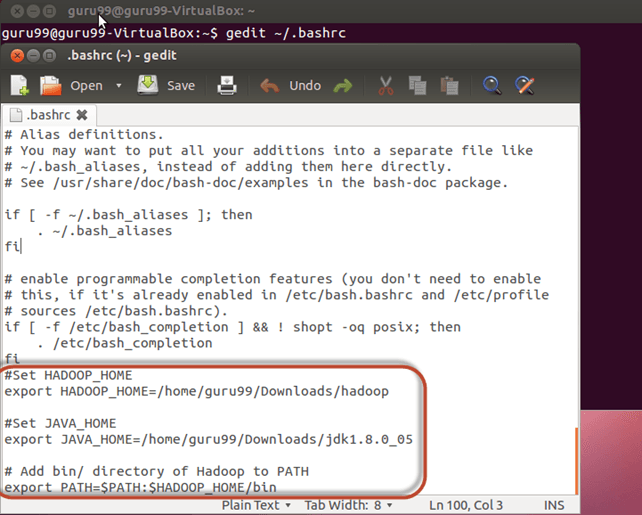
Opret nu kilde til denne miljøkonfiguration ved hjælp af kommandoen nedenfor.
. ~/.bashrc

Trin 2) Konfigurationer relateret til HDFS
Sæt JAVA_HOME i filen $HADOOP_HOME/etc/hadoop/hadoop-env.sh, som vist nedenfor.


Med

Der er to parametre i $HADOOP_HOME/etc/hadoop/core-site.xml, som skal indstilles-
1. 'hadoop.tmp.dir' – Bruges til at angive en mappe, som Hadoop vil bruge til at gemme sine datafiler.
2. 'fs.defaultFS' – Dette angiver standardfilsystemet. Det ældre navn for den samme egenskab, 'fs.default.name', er udfaset.
For at indstille disse parametre skal du åbne core-site.xml
sudo gedit $HADOOP_HOME/etc/hadoop/core-site.xml

Kopier linjerne nedenfor ind mellem tags.
<property>
<name>hadoop.tmp.dir</name>
<value>/app/hadoop/tmp</value>
<description>Parent directory for other temporary directories.</description>
</property>
<property>
<name>fs.defaultFS </name>
<value>hdfs://localhost:54310</value>
<description>The name of the default file system. </description>
</property>

Naviger til mappen $HADOOP_HOME/etc/hadoop.

Opret nu den mappe, der er nævnt i core-site.xml.
sudo mkdir -p <Path of Directory used in above setting>

Giv tilladelser til mappen.
sudo chown -R hduser_:Hadoop_ <Path of Directory created in above step>

sudo chmod 750 <Path of Directory created in above step>

Trin 3) MapReduce-konfiguration
Før du begynder med disse konfigurationer, lad os indstille HADOOP_HOME-stien.
sudo gedit /etc/profile.d/hadoop.sh
Og Enter
export HADOOP_HOME=/home/guru99/Downloads/Hadoop

Indtast derefter
sudo chmod +x /etc/profile.d/hadoop.sh

Afslut terminalen og genstart.
Skriv echo $HADOOP_HOME for at bekræfte stien.

Kopier nu filer
sudo cp $HADOOP_HOME/etc/hadoop/mapred-site.xml.template $HADOOP_HOME/etc/hadoop/mapred-site.xml

Åbn mapred-site.xml-filen
sudo gedit $HADOOP_HOME/etc/hadoop/mapred-site.xml

Tilføj indstillingerne nedenfor mellem og tags.
<property>
<name>mapreduce.jobtracker.address</name>
<value>localhost:54311</value>
<description>MapReduce job tracker runs at this host and port.
</description>
</property>

Åbn $HADOOP_HOME/etc/hadoop/hdfs-site.xml som vist nedenfor,
sudo gedit $HADOOP_HOME/etc/hadoop/hdfs-site.xml

Tilføj indstillingerne nedenfor mellem og tags.
<property>
<name>dfs.replication</name>
<value>1</value>
<description>Default block replication.</description>
</property>
<property>
<name>dfs.datanode.data.dir</name>
<value>/home/hduser_/hdfs</value>
</property>

Opret den mappe, der er angivet i ovenstående indstilling.
sudo mkdir -p <Path of Directory used in above setting>
sudo mkdir -p /home/hduser_/hdfs

Giv derefter ejerskab og tilladelser til det.
sudo chown -R hduser_:hadoop_ <Path of Directory created in above step>
sudo chown -R hduser_:hadoop_ /home/hduser_/hdfs

sudo chmod 750 <Path of Directory created in above step>
sudo chmod 750 /home/hduser_/hdfs

Trin 4) Formatér HDFS
Før vi starter Hadoop for første gang, formaterer du HDFS ved hjælp af kommandoen nedenfor.
$HADOOP_HOME/bin/hdfs namenode -format

Trin 5) Start Hadoop-klyngen med én node
Start Hadoop-klyngen med én node ved hjælp af kommandoen nedenfor.
$HADOOP_HOME/sbin/start-dfs.sh
Outputtet af ovenstående kommando er vist nedenfor.

Start derefter YARN-dæmonerne.
$HADOOP_HOME/sbin/start-yarn.sh

Brug værktøjet 'jps' til at kontrollere, om alle Hadoop-relaterede processer kører.
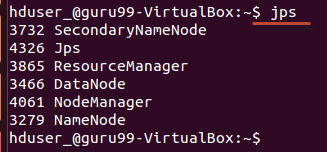
Hvis Hadoop er startet korrekt, bør jps-outputtet vise NameNode, NodeManager, ResourceManager, SecondaryNameNode og DataNode.
Trin 6) Stopping Hadoop
Luk klyngen ned i omvendt rækkefølge.
$HADOOP_HOME/sbin/stop-dfs.sh

$HADOOP_HOME/sbin/stop-yarn.sh

Sådan verificerer du, at Hadoop kører, og retter almindelige fejl
jps-outputtet bekræfter, at processer er startet, men ikke at klyngen er brugbar. Fire ekstra kontroller afgør dette spørgsmål.
- Åbn NameNode-webgrænsefladen på
http://localhost:9870(port 50070 på Hadoop 2.x) og bekræft opsummeringsrapporterne for én live node. - Åbn ResourceManager-grænsefladen på
http://localhost:8088for at bekræfte at YARN accepterede NodeManager. - Kør
hdfs dfsadmin -reportfor kapacitet, live DataNodes og eventuelle underreplikerede blokke. - Skriv noget:
hdfs dfs -mkdir /testefterfulgt afhdfs dfs -ls /beviser at navnerummet accepterer ændringer.
De fleste førstegangsfejl falder ind under en af fem kategorier.
| Symptom | Årsag | Fix |
|---|---|---|
| JAVA_HOME er ikke angivet og kunne ikke findes | Variablen eksporteres i .bashrc, men ikke i hadoop-env.sh | Angiv også den absolutte JDK-sti i hadoop-env.sh |
| Tilladelse nægtet (offentlig nøgle, adgangskode) på ssh localhost | authorized_keys mangler eller er for tilladende | Tilføj id_rsa.pub igen, og kør derefter chmod 600 på ~/.ssh/authorized_keys |
| Forbindelse afvist på port 22 | openssh-serveren er ikke installeret eller kører ikke | Installer openssh-server og start ssh-tjenesten |
| DataNode mangler i jps efter en omformatering | Cluster ID-uoverensstemmelse mellem den formaterede NameNode og den gamle DataNode-mappe | Tøm mappen dfs.datanode.data.dir, og formater den igen |
| start-dfs.sh: kommandoen blev ikke fundet | HADOOP_HOME og PATH blev aldrig hentet i den nuværende shell | Kør .~/.bashrc eller åbn en ny terminal |
