
Apache Flume Tutorial: Hvad er, Architecture & Hadoop Eksempel
 Prafulla Ranadive
⚡ Smart opsummering
Apache Flume er en distribueret tjeneste til indsamling, aggregering og flytning af store mængder logdata til HDFS, bygget op omkring agenter, der kæder en kilde, en kanal og en sink sammen.
Hvad er Apache Flume i Hadoop?
Apache Flume er et pålideligt og distribueret system til indsamling, aggregering og flytning af enorme mængder logdata. Det har en simpel, men fleksibel arkitektur baseret på streaming af datastrømme. Apache Flume bruges til at indsamle logdata, der findes i logfiler fra webservere, og aggregere dem til ... HDFS til analyse.
Flume i Hadoop understøtter flere kilder, herunder:
- 'tail' (som overfører data fra en lokal fil og skriver dem til HDFS via Flume, svarende til Unix-kommandoen 'tail')
- System logs
- Apache log4j (hvilket muliggør Java applikationer til at skrive hændelser til filer i HDFS via Flume).
Den nuværende udgivelse er Flume 1.11.0, offentliggjort den 25. oktober 2022 og tilgængelig fra Apache Flume downloadsideDenne gennemgang blev skrevet til version 1.4.0, så flere trin nedenfor indeholder en note, hvor en aktuel udgivelse opfører sig anderledes.
Flume Architecture
Et Flume-middel er et FMV proces med tre komponenter – rendekilde, rendekanal og rendedræn – hvorigennem begivenheder udbredes efter at være blevet initieret ved en ekstern kilde. Diagrammet nedenfor viser, hvordan de forbinder.
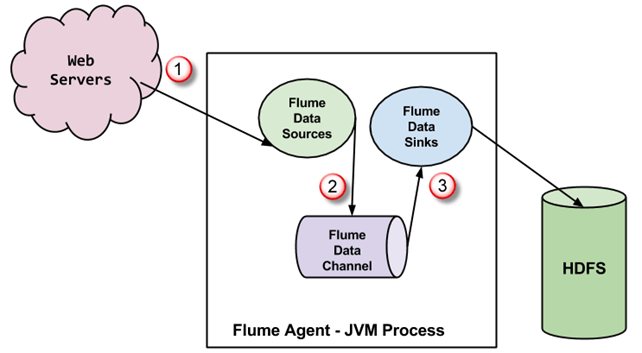
- De hændelser, der genereres af den eksterne kilde (en webserver), forbruges af Flume-kilden. Den eksterne kilde sender hændelser til Flume-kilden i et format, som målkilden genkender.
- Flume-kilden modtager en hændelse og gemmer den i en eller flere kanaler. Kanalen fungerer som et lager, der opbevarer hændelsen, indtil den forbruges af Flume-sinken. Denne kanal kan bruge et lokalt filsystem til at gemme disse hændelser.
- Flume-sinken fjerner hændelsen fra en kanal og gemmer den i et eksternt arkiv, f.eks. HDFS. Der kan være flere Flume-agenter, i hvilket tilfælde Flume-sinken videresender hændelsen til Flume-kilden for den næste agent i flowet.
Nogle vigtige funktioner ved Flume
- Flume har et fleksibelt design baseret på streaming af datastrømme. Det er fejltolerant og robust med flere failover- og gendannelsesmekanismer. Flume tilbyder forskellige niveauer af pålidelighed, herunder 'best-effort levering' og 'ende-til-ende levering'. Bedste-indsats levering tolererer ikke nogen Flume-knudefejl, hvorimod ende-til-ende levering garanterer levering selv i tilfælde af flere nodefejl.
- Flume overfører data mellem kilder og sinke. Denne dataindsamling kan enten være planlagt eller hændelsesdrevet. Flume har sin egen forespørgselsbehandlingsmotor, hvilket gør det nemt at transformere hver ny databatch, før den flyttes til den tilsigtede sink.
- Mulig Flume synker inkluderer HDFS og HBaseFlume kan også transportere hændelsesdata såsom netværkstrafikdata, data genereret af sociale mediewebsteder og e-mails.
Rør, bibliotek og kildekode opsætning
Før vi starter med den egentlige proces, skal du sørge for at have Hadoop installeret. Hvis ikke, så arbejd dig igennem hvordan man installerer Hadoop først. Skift bruger til 'hduser' (id'et, der blev brugt under konfigurationen af Hadoop; du kan skifte til det brugerid, der blev brugt under din egen Hadoop-konfiguration).

Trin 1) Opret en ny mappe med navnet 'FlumeTutorial'.
sudo mkdir FlumeTutorial
- Giv læse-, skrive- og udførelsestilladelser.
sudo chmod -R 777 FlumeTutorial
- Kopier filerne MyTwitterSource.java og MyTwitterSourceForFlume.java ind i denne mappe.
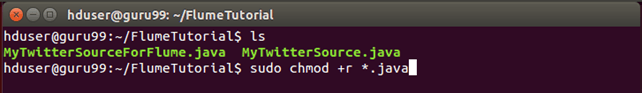
Kontrollér filtilladelserne for alle disse filer, som vist nedenfor, og giv 'læse'-tilladelse, hvis den mangler.
Trin 2) Download 'Apache Flume' fra https://flume.apache.org/download.html.
Apache Flume 1.4.0 er blevet brugt i denne Flume-tutorial.

Klik derefter videre til et spejl.

Trin 3) Kopier den downloadede tarball til den valgte mappe, og f.eks.tracindholdet ved hjælp af følgende kommando.
sudo tar -xvf apache-flume-1.4.0-bin.tar.gz

Dette opretter en ny mappe med navnet apache-flume-1.4.0-bin og extracts filerne ind i den. Den mappe kaldes i resten af artiklen.
Trin 4) Opsætning af Flume-bibliotek. Kopier twitter4j-core-4.0.1.jar, flume-ng-configuration-1.4.0.jar, flume-ng-core-1.4.0.jar og flume-ng-sdk-1.4.0.jar til
/lib/
En eller alle de kopierede JAR-filer kan have udførelsestilladelsen sat, hvilket kan forårsage et problem med kompilering af kode, så tilbagekald den. I mit tilfælde havde twitter4j-core-4.0.1.jar udførelsestilladelsen. Jeg tilbagekaldte den som vist nedenfor.
sudo chmod -x twitter4j-core-4.0.1.jar

Derefter giver kommandoen nedenfor alle 'læse'-tilladelse på twitter4j-core-4.0.1.jar.
sudo chmod +rrr /usr/local/apache-flume-1.4.0-bin/lib/twitter4j-core-4.0.1.jar
Bemærk venligst, at jeg downloadede twitter4j-core-4.0.1.jar fra Maven-arkivetog alle Flume JAR'er, dvs. flume-ng-*-1.4.0.jar, fra org.apache.flume-artefakterne.
Indlæs data fra Twitter ved hjælp af Flume
Trin 1) Gå til den mappe, der indeholder kildekodefilerne.
Trin 2) Indstil CLASSPATH til at indeholde /lib/* og ~/FlumeTutorial/flume/mytwittersource/*.
export CLASSPATH="/usr/local/apache-flume-1.4.0-bin/lib/*:~/FlumeTutorial/flume/mytwittersource/*"

Trin 3) Kompilér kildekoden ved hjælp af kommandoen nedenfor.
javac -d . MyTwitterSourceForFlume.java MyTwitterSource.java

Trin 4) Opret en JAR-fil. Opret først en Manifest.txt-fil ved hjælp af en teksteditor efter eget valg, og tilføj linjen nedenfor til den.
Main-Class: flume.mytwittersource.MyTwitterSourceForFlume
Her er flume.mytwittersource.MyTwitterSourceForFlume navnet på hovedklassen. Bemærk venligst, at du skal trykke på Enter-tasten i slutningen af denne linje, som vist nedenfor.

Opret nu JAR-filen 'MyTwitterSourceForFlume.jar' som følger.
jar cfm MyTwitterSourceForFlume.jar Manifest.txt flume/mytwittersource/*.class

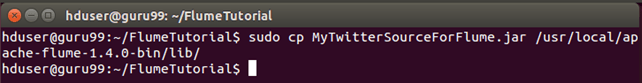
Trin 5) Kopier denne JAR-fil til /lib/.
sudo cp MyTwitterSourceForFlume.jar <Flume Installation Directory>/lib/
Trin 6) Gå til konfigurationsmappen for Flume, /konf.
Hvis flume.conf ikke findes, skal du kopiere flume-conf.properties.template og omdøbe den til flume.conf.
sudo cp flume-conf.properties.template flume.conf

Hvis flume-env.sh ikke findes, skal du kopiere flume-env.sh.template og omdøbe den til flume-env.sh.
sudo cp flume-env.sh.template flume-env.sh

Oprettelse af en Twitter-applikation
Læs dette først. V1.1-streamingen statuses/filter endpoint, som twitter4j 4.0.1 har brug for, blev udfaset den 9. marts 2023, og den API v2-filtrerede strøm, der erstattede det, nu på udvikler.x.com, sidder bag et betalt niveau. Behandl skærmbillederne nedenfor som et brugerdefineret kildemønster, og peg derefter den samme agent mod en fil, exec eller Kafka-kilde.
Trin 1) Opret en Twitter-applikation ved at logge ind på udviklerportalen.


Trin 2) Gå til 'Mine applikationer' (denne mulighed vises, når du klikker på knappen 'Æg' i øverste højre hjørne).

Trin 3) Opret en ny applikation ved at klikke på 'Opret ny app'.
Trin 4) Udfyld ansøgningsoplysningerne ved at angive ansøgningens navn, en beskrivelse og et websted. Du kan se noterne under hvert inputfelt.
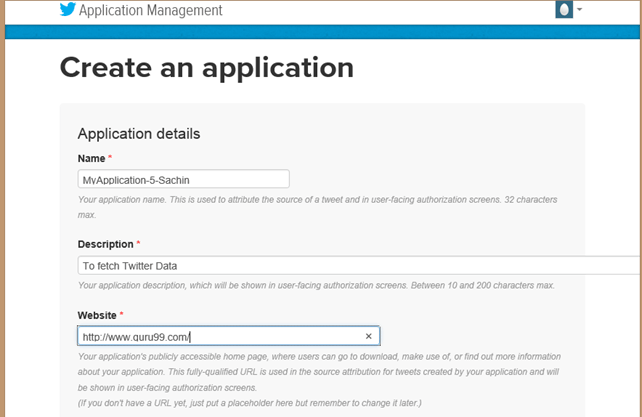
Trin 5) Rul ned på siden, accepter vilkårene ved at markere 'Ja, jeg accepterer', og klik på knappen 'Opret din Twitter-applikation'.

Trin 6) I vinduet for den nyoprettede applikation skal du gå til fanen 'API-nøgler', rulle ned på siden og klikke på knappen 'Opret min adgangstoken'.


Trin 7) Opdatér siden.
Trin 8) Klik på 'Test OAuth'. Dette viser applikationens 'OAuth'-indstillinger.

Trin 9) Rediger 'flume.conf' ved hjælp af disse OAuth-indstillinger. Trinene til at ændre 'flume.conf' er angivet nedenfor.

Vi skal kopiere forbrugernøglen, forbrugerhemmeligheden, adgangstokenet og adgangstokenhemmeligheden for at opdatere 'flume.conf'.
Bemærk: Disse værdier tilhører brugeren og er derfor fortrolige, så de bør ikke deles.
Rediger 'flume.conf' fil
Trin 1) Åbn 'flume.conf' i skrivetilstand og indstil værdier for parametrene nedenfor.
sudo gedit flume.conf
Kopier indholdet nedenfor.
MyTwitAgent.sources = Twitter
MyTwitAgent.channels = MemChannel
MyTwitAgent.sinks = HDFS
MyTwitAgent.sources.Twitter.type = flume.mytwittersource.MyTwitterSourceForFlume
MyTwitAgent.sources.Twitter.channels = MemChannel
MyTwitAgent.sources.Twitter.consumerKey = <Copy consumer key value from Twitter App>
MyTwitAgent.sources.Twitter.consumerSecret = <Copy consumer secret value from Twitter App>
MyTwitAgent.sources.Twitter.accessToken = <Copy access token value from Twitter App>
MyTwitAgent.sources.Twitter.accessTokenSecret = <Copy access token secret value from Twitter App>
MyTwitAgent.sources.Twitter.keywords = guru99
MyTwitAgent.sinks.HDFS.channel = MemChannel
MyTwitAgent.sinks.HDFS.type = hdfs
MyTwitAgent.sinks.HDFS.hdfs.path = hdfs://localhost:54310/user/hduser/flume/tweets/
MyTwitAgent.sinks.HDFS.hdfs.fileType = DataStream
MyTwitAgent.sinks.HDFS.hdfs.writeFormat = Text
MyTwitAgent.sinks.HDFS.hdfs.batchSize = 1000
MyTwitAgent.sinks.HDFS.hdfs.rollSize = 0
MyTwitAgent.sinks.HDFS.hdfs.rollCount = 10000
MyTwitAgent.channels.MemChannel.type = memory
MyTwitAgent.channels.MemChannel.capacity = 10000
MyTwitAgent.channels.MemChannel.transactionCapacity = 1000

Trin 2) Indstil også TwitterAgent.sinks.HDFS.hdfs.path som vist nedenfor.
TwitterAgent.sinks.HDFS.hdfs.path = hdfs:// : / /flume/tweets/

At finde , og , se værdien af parameteren 'fs.defaultFS' angivet i $HADOOP_HOME/etc/hadoop/core-site.xml, vist nedenfor.

Trin 3) For at overføre dataene til HDFS, når de kommer, skal du slette nedenstående post, hvis den findes.
TwitterAgent.sinks.HDFS.hdfs.rollInterval = 600
Eksempel: Streaming af Twitter-data ved hjælp af Flume
Trin 1) Åbn 'flume-env.sh' i skrivetilstand, og indstil værdier for parametrene nedenfor.
JAVA_HOME=<Installation directory of Java>
FLUME_CLASSPATH="<Flume Installation Directory>/lib/MyTwitterSourceForFlume.jar"

Trin 2) Start Hadoop.
$HADOOP_HOME/sbin/start-dfs.sh
$HADOOP_HOME/sbin/start-yarn.sh
Trin 3) To af JAR-filerne fra Flume-tarballen er ikke kompatible med Hadoop 2.2.0, så i dette Apache Flume-eksempel følger vi nedenstående trin for at gøre Flume kompatibel med Hadoop 2.2.0. Denne JAR-swap er en rettelse fra 1.4.0-æraen; Flume 1.11.0 leverer allerede aktuelle protobuf- og Guava-builds, så en moderne tarball behøver normalt ikke noget af det.
a. Flyt protobuf-java-2.4.1.jar ud af ' /lib'. Gå først til den mappe.
cd /lib
sudo mv protobuf-java-2.4.1.jar ~/

b. Find JAR-filen 'guava' som vist nedenfor.
find . -name "guava*"

Flyt guava-10.0.1.jar ud af ' /lib'.
sudo mv guava-10.0.1.jar ~/

c. Download guava-17.0.jar fra Maven-arkivet, vist nedenfor.

Kopier nu denne downloadede JAR-fil til ' /lib'.
Trin 4) Gå til ' /bin' og start Flume som følger.
./flume-ng agent -n MyTwitAgent -c conf -f <Flume Installation Directory>/conf/flume.conf

Kommandopromptvinduet, hvor Flume henter tweets, ser sådan ud.

Fra kommandovinduets besked kan vi se, at outputtet er skrevet til mappen /user/hduser/flume/tweets/. Åbn nu denne mappe ved hjælp af en webbrowser.
Trin 5) For at se resultatet af dataindlæsningen skal du åbne http://localhost:50070/ i en browser, gennemse filsystemet og derefter gå til den mappe, hvor dataene er blevet indlæst, dvs.
/flume/tweets/
Port 50070 er NameNode-webgrænsefladen på Hadoop 2; Hadoop 3 flyttede den samme side til port 9870.

Flume er den ene halvdel af indtagelse: Sqoop importerer tabeller i batches, Flume streamer hændelser, og derefter Gris or Hive form filerne og Oozie planlægger kæden. Se også værktøjer til big data-analyse, MapReduce-joins og -tællere og Talent.
