
最高の無料ウェブスクレイピング10選ping ツール (2026)
 編集チーム
情報開示: Guru99は読者の皆様のご支援によって運営されています。このページに掲載されているリンクから商品をご購入いただくと、当社に手数料が発生する場合があります。 さらに詳しく
ウェブスクレイピングping ツールは時間を節約できますが、間違った選択をすると、不完全なレコードが返されたり、IPブロックがトリガーされたり、クレジットが無駄になったり、重要な制限が隠されたり、初心者が混乱したダッシュボードの中に取り残されたりすることがよくあります。不安定なセレクタや一貫性のないレンダリングも、警告なしにレポートを壊す可能性があります。読者は、リクエストコストを見落としたまま、見出しの許容量を比較することがよくあります。 Javaスクリプトのサポート、データ保持、コンプライアンス管理。より明確なレビューを行うことで、これらのトレードオフが明らかになり、各ワークフローに最適なサービスを選択できるようになり、不確かな候補リストを管理しやすい次のステップへと変えることができます。
私は18種類以上のツールを55時間以上かけて調査し、公式製品ページ、アクセス制限、ワークフロー、定期的なレビューパターンなどを確認しました。綿密な調査の結果、最高の無料Webスクレイピングツール10選を選出しました。ping ツールオプションの機能、メリット・デメリット、そして現在のプランの詳細を解説しています。このガイドでは、永久無料プランとトライアルクレジット、有料テストを分けて説明しているので、より明確な期待値を持ってご利用いただけます。 続きを読む...
Oxylabs は、市場をリードする Web インテリジェンス収集プラットフォームです。最高レベルのビジネス、倫理、コンプライアンス標準に基づいて運営されており、世界中の企業がデータに基づく洞察を解き放つことができます。IP ブロックの処理と回避に役立つ自動再試行メカニズムを備えています。
最高の無料ウェブスクレイピングping ソフトウェアとツール
| 名前 | 以下のためにベスト | 他社とのちがい | 使いやすさ | Free Trial | リンク |
|---|---|---|---|---|---|
???? Oxylabs |
大規模データtrac生産 | 高い成功率、ジオターゲティング、構造化データ | 穏健派 | 無制限 | もっと詳しく知る |
 👍 デコド |
高度なデータスクレイピングping ソリューション | IPローテーション、高い成功率、プロキシ管理 | 初級 | 7日間の無料トライアル | もっと詳しく知る |
 👍 NodeMaven |
プレミアム住宅用およびモバイルプロキシスクラッチping | IP品質フィルター、7日間のスティッキーセッション、190カ国以上 | 初級 | 750MBで3.50ドル | もっと詳しく知る |
 Webshare |
スクレイピング向けのお手頃価格のプロキシネットワークping | 80万以上のIPアドレス、ジオターゲティング、IPローテーション | 初級 | 10 個の無料プロキシ | もっと詳しく知る |
 Apify |
開発者と自動化愛好家 | 高度なデータ例tracAPI呼び出し | 穏健派 | 生涯無料基本プラン | もっと詳しく知る |
1) Oxylabs
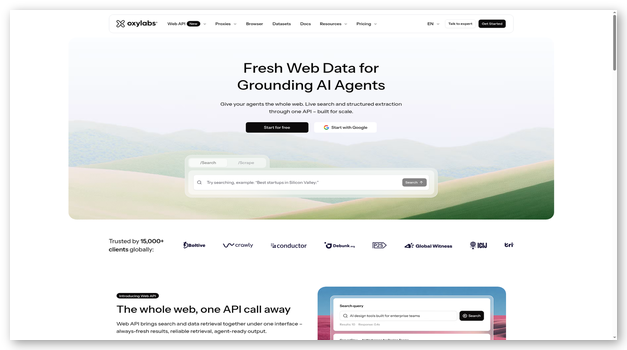
Oxylabs 管理されたWebを提供する Scraper 困難なウェブサイトから公開データを収集するチーム向けのAPIです。プロキシルーティング、ブラウザレンダリング、リトライ、構造化配信を単一のAPIで処理します。小売監視チームは、個別のブラウザ群を管理することなく、ローカライズされた製品ページをリクエストできます。
そのダッシュボードは、使用状況、リクエスト、およびパーサー制御を中心に構成されています。バッチクエリとスケジューリングは定期的なジョブをサポートし、OxyCopilotはリクエストの生成を支援します。このサービスは、単発のプロジェクトよりも本番環境のワークロードに適しています。特に、スクラッチの所有権よりも予測可能な納品が重要な場合に最適です。ping 大規模なインフラストラクチャ。
機能と特徴:
- 管理されたリクエスト: APIは適切なインフラストラクチャを経由してリクエストをルーティングし、ブロックされた試行を再試行します。チームは、大規模なプロキシリストやブラウザワーカーを管理することなく、利用可能なレスポンスを受け取ることができます。
- ヘッドレスブラウザ: ブラウザのレンダリングが読み込まれます Java例の前にスクリプトが多用されたページtracこれにより、動的な商品リスト、インタラクティブな旅行ページ、および生の HTML には含まれていないその他のコンテンツがサポートされます。
- カスタムパーサー: カスタム解析ルールにより、サポートされているページが構造化フィールドに変換されます。アナリストは、結果をデータベースやレポートに読み込む前に、マークアップのクリーンアップに費やす時間を短縮できます。
- バッチクエリ: バッチ送信グループは多くのターゲットをグループ化します URL複数の情報を1つのワークフローに統合します。これにより、チームが価格、在庫、検索結果、または出品情報を監視する際の調整作業が軽減されます。
- スケジューラ: スケジュールされたジョブは、定義された間隔で定期的にデータ収集を実行します。これにより、チームはプロジェクトごとに個別のcronサービスに頼ることなく、データセットを更新できます。
- 地域ターゲティング: 位置情報パラメータを使用すると、選択した市場のページをリクエストできます。研究者は、同じAPI連携を通じて、地域ごとの価格、在庫状況、検索結果を比較できます。
- 使用状況のコントロール: ダッシュボードには、結果の消費とリクエストのアクティビティが表示されます。チームは trac生産的なデータ収集実行中に、制限値に達する前のkボリュームが予期せぬ事態となる。
メリット
デメリット
👉 入手方法 Oxylabs 無料で?
- Video Cloud Studioで Oxylabs ウェブ Scraper API料金ページ。
- アカウントを作成し、クレジットカード情報を登録せずに無料トライアルを選択してください。
- この試験には、サポートされているスクレイピングの結果が最大2,000件含まれています。ping ワークフロー。
最大2,000件の結果まで無料トライアル
2) デコド
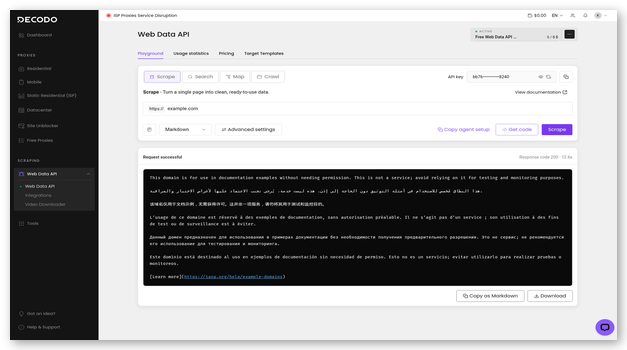
デコド プロキシインフラストラクチャとWeb Scraを組み合わせるping 開発者、アナリスト、AIワークフロー向けに構築されたAPI。スクレイピング、検索、マッピング、クロールといったエンドポイントは、単一ページから複数ページにわたるデータ探索までを網羅しています。既製のテンプレートを使用することで、カスタムパーサーを必要とせずに、一般的なターゲット向けの構造化データを取得できます。
ダッシュボードには、APIキー、リクエスト設定、使用状況、および出力オプションが表示されます。 Javaスクリプトレンダリングとマネージドプロキシ選択により、複雑なページもスムーズに処理でき、Markdown出力は言語モデルパイプラインをサポートします。Decodoは永久無料プランが用意されているため、チームがより多くのリクエスト量を安定的に処理できるようになる前に、プロトタイプ開発に活用できます。
機能と特徴:
- 4つの終点: スクレイピング、検索、マップ、クロールエンドポイントは、特定のtracデータの収集とサイト検出。開発者は、1つのAPIキーで複数のデータタスクを管理できます。
- 準備済みのテンプレート: 100種類以上のテンプレートが整備されており、一般的なウェブサイトやデータタイプに対応しています。これらのテンプレートを使用することで、セレクターの作業が軽減され、初期段階の概念実証プロジェクトを迅速に進めることができます。
- Javaスクリプトレンダリング: オプションレンダリングでは、配信前に動的コンテンツを読み込みます。チームは、独自のヘッドレスブラウザクラスタを運用することなく、クライアントレンダリングされたページからデータを収集できます。
- 柔軟な出力: レスポンスには、サポートされている場合、HTML、Markdown、JSON、CSV、PNG、またはXHRデータを含めることができます。各ワークフローは、分析に適した形式を選択できます。
- プロキシ処理: 組み込みのプロキシ選択機能とアンチボット制御機能により、手動でのローテーション作業が軽減されます。APIがインフラストラクチャの決定を管理することで、リクエストは地域制限のあるページにもアクセスできます。
- AIとの連携: MCPをはじめとする様々な統合パスにより、最新のウェブデータを対応するAIツールに取り込むことができます。これは、リアルタイムのデータソースを必要とする調査エージェントや検索ワークフローに適しています。
- リクエストコントロール: 各プランには、利用制限と使用量合計が表示されます。チームは、帯域幅だけから推測するのではなく、クロール量に基づいてプロジェクトの規模を決定できます。
メリット
デメリット
👉 Decodoを無料で入手するには?
- DecodoのWeb Scraにアクセスしてくださいping API料金ページ。
- 無料アカウントを作成し、生成されたAPI認証情報をコピーしてください。
- 無料プランでは、月間5,000回のクロール、または10,000ページのスクレイピングが可能です。
最大10,000ページまで利用できる無料プラン
3) ノードメイヴン
ノードメイヴン はスクレイピング用のプロキシプラットフォームですping すでに元tracプロトコルコードまたはブラウザの自動化に対応。住宅用、モバイル用、ISP用オプションは、広範囲の地理的範囲でHTTPおよびSOCKS5接続をサポートします。IP品質フィルタは、割り当て前にアドレスをスクリーニングし、回避可能な障害を削減します。
ダッシュボードは、解析されたデータセットではなく、トラフィック、認証情報、ターゲティング、およびローテーション設定に焦点を当てています。スティッキーセッションはアカウントまたはロケーションの継続性に適しており、リクエストごとのローテーションは広範囲のクロールに適しています。NodeMavenは、既製のスクレイピングよりもプロキシの品質とセッション制御が重要な場合に最も効果を発揮します。ping APIです。
機能と特徴:
- 品質フィルター: IP品質フィルタは、割り当て前に利用可能なアドレスをスクリーニングします。クリーンなプールは、無駄な再試行とCAを削減できます。PTC長時間のデータ収集実行中にHAが中断される。
- プロキシタイプ: 住宅用、モバイル用、ISPプロキシは1つのアカウントで管理されます。チームは、評判、安定性、コストに基づいて各プロキシをマッチングできます。ping ターゲット。
- 回転制御: 接続はリクエストごとに切り替わることも、長時間のセッションでも維持することも可能です。これにより、大規模なクロール処理と、一貫したIDを必要とするワークフローの両方に対応できます。
- 地域ターゲティング: 国、都市、ISPによる制限によって、出口の位置を絞り込むことができます。研究者は、地域ごとの価格、広告、検索結果、または利用可能性に関するデータを収集できます。
- プロトコルのサポート: HTTPとSOCKS5のサポートは、一般的なスクリプトや自動化ツールと連携します。既存のクローラーは、設定を変更することなく接続できます。trac論理。
- 交通渋滞: 現在のプランでは、未使用のトラフィックは次の請求期間に繰り越されます。これにより、月ごとの請求スケジュールが不規則なプロジェクトでも、購入した容量を有効活用できます。
- 使用状況ダッシュボード: トラフィックと接続の詳細はアカウントダッシュボードに表示されます。チームは使用状況を監視し、クロールが許容量を使い切る前にローテーションを調整できます。
メリット
デメリット
👉 NodeMavenを無料で入手する方法は?
- NodeMavenの料金ページを開き、アカウントを作成してください。
- 自宅およびモバイル端末でのプロキシアクセスに関するトライアルを選択してください。
- 有料トライアルは3.50ドルで、750MBの帯域幅が含まれています。
750MBのお試し版が3.50ドル
4) Webshare
Webshare スクリプト、クローラー、ブラウザ自動化ツール向けに、データセンター、住宅、ISPプロキシ接続を提供します。無料プランでは、小規模プロジェクト向けに10個のデータセンタープロキシと月間帯域幅が提供されます。ユーザーは認証情報または承認済みIPアドレスで認証できます。
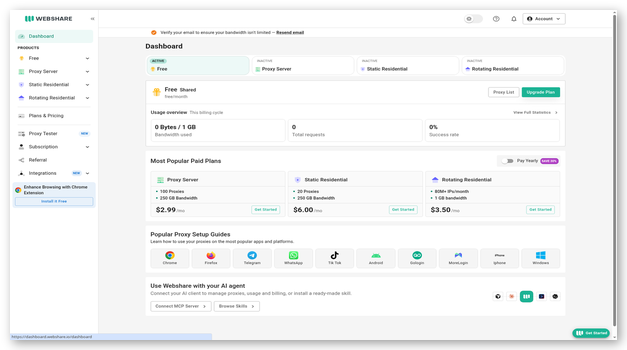
ダッシュボードには、プロキシリスト、接続の詳細、使用状況、APIアクセス情報が一箇所に表示されます。ローテーション制御によりリクエストの分散が可能になり、ロケーションフィルターは地域ごとのデータ収集をサポートします。 Webshare 信頼性の高いプロキシアクセスを必要とする学習者や軽量ジョブに適していますが、パーサーや完全なスクレイピングを置き換えるものではありません。ping ワークフロー。
機能と特徴:
- 無料プロキシ: 永久無料プランには、10個のデータセンタープロキシと月間1GBのトラフィックが含まれています。小規模な実験は、試用期間の期限切れを気にすることなく継続できます。
- プロキシの選択肢: 有料オプションには、データセンター、住宅用、ISP接続が含まれます。チームは、目標の難易度、安定性、予算に基づいてプールを選択できます。
- 回転: 対応プランでは、エンドポイントのローテーションによりアドレスが自動的に変更されます。これにより、大規模なリクエストセットや頻繁に繰り返されるリクエストセットにおけるプロキシリストの手動メンテナンス作業が軽減されます。
- 地理制御: 地域フィルターを使用すると、リクエストを関連する国や地域にルーティングできます。市場調査担当者は、同じ接続ワークフローを使用して、地域に特化したコンテンツを比較できます。
- APIアクセス: このAPIは、自動化のためにプロキシの詳細情報とアカウント操作を公開します。開発者は、ダッシュボードからリストをコピーすることなく、接続をプロビジョニングまたは取得できます。
- 認証: ユーザー名認証情報とIP認証は、さまざまな展開パターンをサポートします。チームは、サーバー、ラップトップ、または分散スクレイピングへのアクセスを保護できます。ping 労働者。
- 使用法 trac王: ダッシュボードのメトリクスには、帯域幅とプロキシのアクティビティが表示されます。ユーザーは、重要なデータ収集実行中にクローラーが停止する前に、制限に近づいていることを確認できます。
メリット
デメリット
👉 入手方法 Webshare 無料で?
- 店は開いています Webshare カードなしで無料アカウントを登録できます。
- プロキシリストにアクセスして、割り当てられた接続の詳細を取得してください。
- 無料プランには、10個のデータセンタープロキシと月間1GBのデータ容量が含まれています。
無料プロキシ10個と月間1GB
5) Apify
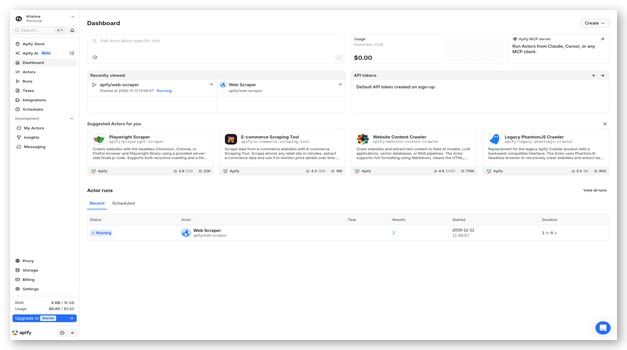
Apify Crawleeは、アクターと呼ばれる再利用可能なスクレイパーを実行するためのクラウドプラットフォームです。公開されているストアには一般的なウェブサイトが網羅されており、開発者はCrawleeやその他の対応ツールを使用してカスタムアクターを構築できます。スケジュール、データセット、キュー、Webhookにより、個々の実行を繰り返し可能なデータワークフローに変換できます。
コンソールには、各アクターの入力、実行ログ、ストレージ、コスト、出力が表示されます。チームはレコードをエクスポートしたり、APIを介して接続したりできます。 Apify 幅広い柔軟性を提供するが、マーケットプレイスの品質や利用コストは変動する。既製のスクレイパーとプログラム可能な自動化プラットフォームの両方を必要とするユーザーに適している。
機能と特徴:
- 俳優ストア: ストアでは、多くの一般的なウェブサイトやタスクに対応した既製のスクレイパーを提供しています。ユーザーは、コレクターを一つ一つコーディングする代わりに、既存のアクターから始めることができます。
- カスタムアクター: 開発者は独自のスクラッチをパッケージ化できますping ロジックを再利用可能なアクターとして扱う。バージョン管理された入力とビルドにより、同じワークフローを繰り返し実行することが容易になる。
- スケジューリング: 組み込みのスケジュール機能により、指定した時刻または間隔でアクターが起動されます。価格、出品状況、コンテンツの定期的な監視は、外部スケジューラを使用せずに実行できます。
- データストレージ: データセット、キーバリューストア、およびリクエストキューは、出力とクロール状態を整理します。各実行は、エクスポートまたは後続処理のためにレコードにアクセス可能な状態に保持します。
- 統合: API、Webhook、コネクタは、結果を他のシステムに送信します。チームは、実行の成功または失敗後に、後続のジョブをトリガーできます。
- プロキシオプション: プラットフォーム内では、データセンターおよび住宅用プロキシサービスが利用可能です。ユーザーは、別途管理するプロキシプロバイダーを利用することなく、接続をローテーションできます。
- 監視を実行する: 各実行ごとに、ログ、ステータス、コンピューティングリソースの使用状況、およびコストが表示されます。開発者は、障害の原因を特定し、繰り返し実行されるジョブが消費するリソースを推定できます。
メリット
デメリット
👉 入手方法 Apify 無料で?
- ロケーション選択 Apifyの料金ページにアクセスし、無料プランを選択してください。
- クレジットカード情報を入力せずにアカウントを作成できます。
- このプランは、毎月5ドルのクレジットと5回の同時利用権が付与されて更新されます。
毎月5ドルの無料クレジット
6) Novada
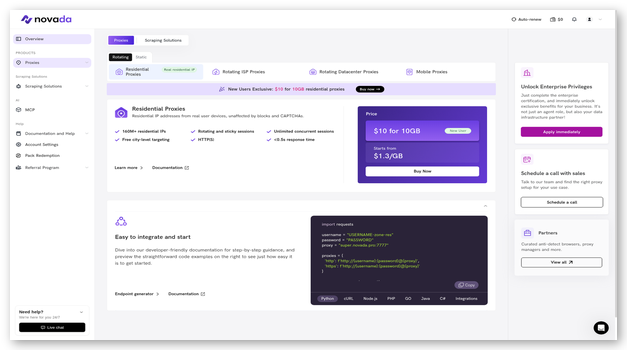
Novada グループa Scraper API、Web Unblocker、およびブラウザAPIが1つのクレジット残高で利用できます。 Scraper API はサポートされているターゲットに対して構造化レコードを返し、ブラウザ API はインタラクティブな Java使い慣れた自動化プロトコルを使用してページをスクリプト化します。管理されたアンチボット制御により、インフラストラクチャ作業が軽減されます。
そのダッシュボード tracks製品の消費量、ドメイン数、クレジット数、同時リクエスト数などを管理します。統合課金により、チームは個別のサブスクリプションなしで課金方法を切り替えることができます。 Novada は混合型に便利ですtracキャンペーンのニーズに応じて利用できますが、トライアルアクセスにはキャンペーンの共有とサポートの承認が必要です。購入したクレジットは、記載されている有効期間が過ぎると失効します。
機能と特徴:
- Scraper API: その Scraper APIは、サポートされている検索、コマース、ソーシャルターゲット向けに、クリーンアップされたデータを返します。チームはHTML解析の多くの段階を省略できます。
- ウェブブロッカー解除: Web Unblockerは、一般的なアクセス制限を処理しながら、生のページを返します。独自の解析ロジックを維持したいチームに適しています。
- ブラウザAPI: クラウドブラウザは、PuppeteerやPlaywrightのような接続をサポートしています。開発者は、ページのレンダリング、要素のクリック、スクロール、複雑なインタラクティブコンテンツのキャプチャなどを行うことができます。
- 統一クレジット: 1つの残高でスクラッチをカバーpingブロック解除やブラウザ製品など。チームは、各サービスごとに別途利用枠を購入することなく、方法を変更できます。
- 成功時の請求: Novadaは、公開されているルールに基づいてリクエストがデータを返した場合にクレジットを請求します。失敗したプラットフォームリクエストでは、同じ残高は消費されません。
- 構造化された出力: サポートされているテンプレートは、生のマークアップではなく、JSONまたはCSV形式のレコードを提供します。アナリストは、より少ないデータ整理で結果をレポートに読み込むことができます。
- 並行処理制御: プランの階層は、各製品の並列リクエスト容量を定義します。チームは、クローラーのボリュームと予想される応答時間に合わせて、許容容量を選択できます。
メリット
デメリット
👉 入手方法 Nova無料でdaを入手できますか?
- 作る Novaアカウントを作成し、無料トライアルキャンペーンページを開きます。
- キャンペーンを3つのグループと共有し、その後スクリーンショットをサポートチームに送信してください。
- 承認後、 Novadaはプロキシとスクラッチに15ドルのクレジットを追加ping ツール。
15ドルのトライアルクレジット
7) Bright Data
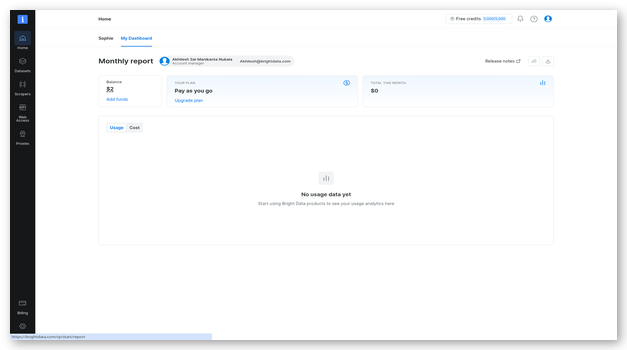
Bright Data 既製のWebを提供する Scraper API、Scraping ブラウザ、 Scraper スタジオ、プロキシ、データセット。チームは、構造化レコードを選択したり、PlaywrightとPuppeteerを使用してリモートブラウザを制御したりできます。組み込みのアクセス処理により、ローテーション、ブラウザのフィンガープリント、アクセスチャレンジが管理されます。
コントロールパネルでは、製品、認証情報、使用状況、コレクター、配信設定が個別に管理されます。事前構築済みのAPIにより、サポート対象に対するメンテナンスが軽減され、ブラウザアクセスによってカスタム操作が可能になります。 Bright Data 幅広い範囲とサポートニーズを持つ要求の厳しいプロジェクトに適しています。その膨大な製品カタログとエンタープライズオプションは、単純な個人用スクラッチには過剰に感じられるかもしれません。ping.
機能と特徴:
- Scraper API: 事前に構築されたAPIは、サポートされているWebサイトとカテゴリの構造化レコードを返します。チームは、ターゲットを変更するたびにセレクタやブラウザロジックを管理する必要がなくなります。
- スクラping ブラウザ: ホストされたブラウザは、Playwright または Puppeteer を介して接続します。開発者は、 Javaスクリプトを作成してインタラクションを自動化しながら Bright Data アクセスインフラストラクチャを管理します。
- Scraper スタジオ: Studioツールは、カスタムコレクターの構築とデプロイを支援します。ビジュアルおよびAI支援オプションにより、APIが用意されていないターゲットのセットアップ時間を短縮できます。
- プロキシネットワーク: 統合プロキシサービスは、複数の接続タイプと場所に対応しています。ワークフローにより、複数のベンダー間で認証情報をやり取りすることなくトラフィックをルーティングできます。
- 配送オプション: 収集されたデータは、API、Webhook、またはサポートされているクラウドストレージを経由して転送できます。チームは、各実行後に既存のデータウェアハウスや分析パイプラインにデータを供給できます。
- 支出コントロール: 従量課金制と月額制限により、消費量を管理できます。ダッシュボードの使用状況ビューでは、コレクターがプロジェクト予算にどのような影響を与えているかを確認できます。
- 無料レコード: ウェブ Scraper APIの無料プランでは、毎月5,000件のレコードを利用できます。この無料プランの利用開始に際し、クレジットカード情報の入力は不要です。
メリット
デメリット
👉 入手方法 Bright Data 無料で?
- 店は開いています Bright Dataのウェブ Scraper API料金ページ。
- 「無料で始める」を選択して、支払いカード情報を入力せずに登録してください。
- 無料プランには5,000ウェブが含まれます Scraper APIは毎月記録されます。
毎月5,000件の無料レコード
8) PrivateProxy
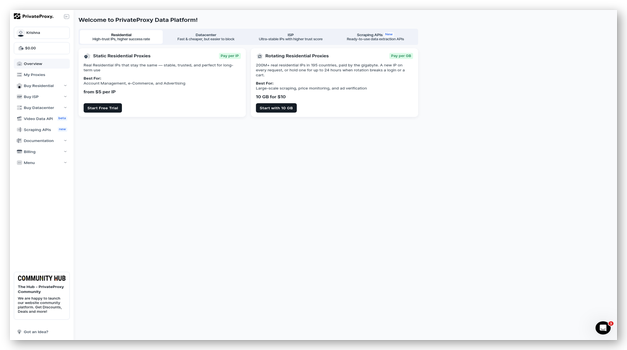
PrivateProxy スクリプトやブラウザの自動化向けに、静的プロキシとローテーションプロキシのパッケージを提供します。静的な住宅用およびデータセンター用トライアルでは、契約前に1つのアドレスをテストできます。有料のローテーションプランでは、リクエストベースまたは帯域幅ベースのトラフィックに対応しています。接続は一般的な認証パターンをサポートしています。
アカウントエリアでは、パッケージ、ロケーション、認証情報、使用状況、およびサブスクリプションステータスに焦点が当てられています。固定アドレスが必要なジョブには専用の静的オプションが適しており、より広範囲のクロールにはローテーションサービスが適しています。 PrivateProxy これは完全なスクレイパーではなくインフラストラクチャコンポーネントであるため、チームはtrac処理ロジック、再試行、ストレージ、およびデータ検証。
機能と特徴:
- 静的プロキシ: 固定データセンターおよびISPオプションでは、契約期間中、同じアドレスが維持されます。継続性が必要なセッションや、許可リストに登録されたアクセスが必要なセッションに適しています。
- ローテーションアクセス: ローテーションパッケージは、リクエストやセッションごとにアドレスを変更します。これにより、個別のローカルプロキシリストを維持することなく、クローラーのトラフィックを分散させることができます。
- トライアルの選択肢: 一部の固定プランには、カード認証による2日間の無料トライアルが含まれています。一方、ローテーション型の試用プランは、初回限定の特別価格が適用されます。
- 認証: ユーザー名認証とIPアドレス認証は、一般的なサーバー展開に対応しています。各チームは、クローラー環境に最適な方法を選択できます。
- 場所の選択: 利用可能なパッケージでは、注文時に地域を選択できます。ユーザーは、調査対象の市場またはウェブサイトに合わせて、プロキシの場所を指定できます。
- 購読管理: ダッシュボードには、有効なパッケージと更新状況が表示されます。トライアルユーザーは、更新前にキャンセルすることで、表示されている月額料金を回避できます。
- プロトコルのサポート: HTTP、HTTPS、SOCKS接続は多くのスクラッチをカバーしていますping ライブラリとブラウザ。既存のツールはベンダー固有の拡張機能なしで接続できます。traction SDK。
メリット
デメリット
👉 入手方法 PrivateProxy 無料で?
- 店は開いています PrivateProxyヘルプページにアクセスし、対象となる静的トライアルを選択してください。
- 場所の詳細を選択し、認証用のカードを追加してください。
- 無料トライアル期間は2日間で、速やかに解約しない限り自動更新されます。
2日無料トライアル
9) ScraperAPI
ScraperAPI 開発者は、管理プロキシプールを介してページを取得するための単一のエンドポイントを利用できます。アドレスローテーション、自動再試行、CA を処理します。PTCHA、ジオターゲティング、およびオプション Javaスクリプトレンダリング。構造化されたエンドポイントは、選択されたコマースおよび検索ターゲットをカバーし、非同期APIはより大きなリクエストバッチをサポートします。
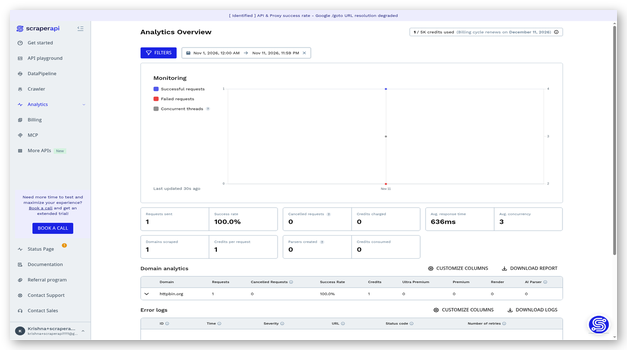
ダッシュボードには、API認証情報、クレジット使用状況、同時実行数、およびリクエスト分析が表示されます。DataPipelineは、別途クローラーサービスを用意することなく、スケジューリングと配信機能を追加します。 ScraperAPI リクエストするページが既に分かっているものの、プロキシ操作を避けたいチームに適しています。クレジット料金は、ターゲットと有効化する機能によって異なります。
機能と特徴:
- 単一エンドポイント: 標準のAPIリクエストはターゲットを送信します URL 認証キー。 ScraperAPI プロキシの選択を管理し、結果として得られるページ応答を返します。
- 自動再試行: 失敗またはブロックされた試行は、別の接続を介して再試行できます。これにより、呼び出し元のscra内部のカスタム再試行ロジックが削減されます。ping アプリケーション。
- Javaスクリプトレンダリング: オプションレンダリングでは、レスポンスを返す前にクライアント側のコンテンツが読み込まれます。動的な製品ページやアプリケーションインターフェースも、同じAPIを通じてアクセスできるようになります。
- 構造化データ: 専用エンドポイントは、サポートされているターゲットに対して解析済みのレコードを返します。これにより、チームは共通の製品ページ、検索ページ、および一覧ページ用のセレクターを管理する必要がなくなります。
- データパイプライン: DataPipelineはデータ収集をスケジュールし、完了したファイルをサポートされている宛先に配信します。アナリストは、本格的なオーケストレーションレイヤーを構築することなく、定期的なジョブを実行できます。
- コスト見積もりツール: ダッシュボードツールは、 URL およびパラメータセット。これにより、チームはレンダリング、プレミアムプロキシ、およびバイパスのコストを比較できます。
- 無料手当: 公開されている無料プランには、1,000 APIクレジットと5つの同時接続が含まれています。ユーザーは有料プランを選択する前に、標準的なリクエストをテストできます。
メリット
デメリット
👉 入手方法 ScraperAPI 無料で?
- ロケーション選択 ScraperAPIの料金ページにアクセスして、無料アカウントを作成してください。
- APIキーをコピーして、標準的なリクエストをテストしてください。
- 無料プランには、月間1,000クレジットと5台の同時接続が含まれています。
毎月1,000クレジット無料
10) ScrapingBee
ScrapingBee これは、ブラウザ、プロキシ、または位置情報制御を必要とするページを収集するためのAPIです。 Javaスクリプトレンダリングはインタラクティブなコンテンツを読み込み、クラシック、プレミアム、ステルス接続はそれぞれ異なる難易度レベルに対応します。スクリーンショットおよび検索APIは、HTML取得にとどまらず、同じアカウントの機能を拡張します。
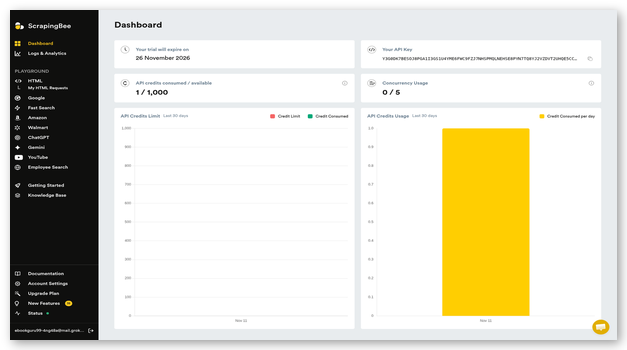
ダッシュボードには、API キー、リクエストビルダー、クレジット見積もり、使用履歴が表示されます。開発者はカスタム ヘッダーを追加したり、 Javaクリックとスクロールのスクリプトシナリオ。AI extractionは平易な言葉で書かれた現場指示を受け入れます。 ScrapingBee APIユーザーにとっては利用しやすいが、有効にするオプションによってはクレジットコストが大幅に変動する可能性がある。
機能と特徴:
- HTML API: HTML APIは、レンダリング済みまたは未レンダリングのページコンテンツを単一のエンドポイントを通じて返します。開発者は、プロキシレベル、ロケーション、ヘッダー、およびブラウザの動作を制御できます。
- JavaScriptのシナリオ: カスタム額装 Javaスクリプトシナリオでは、キャプチャ前にクリック、スクロール、待機、またはインタラクションを実行できます。これにより、ユーザー操作後にのみコンテンツが表示されるページをサポートします。
- プロキシレベル: クラシック、プレミアム、ステルスの各ルートは、それぞれ異なるレベルのブロックに対応しています。チームは低コストのアクセスから始め、必要に応じてレベルを上げることができます。
- AI 元tracる: 平易な言葉によるクエリと例trac選択ルールは要求されたフィールドを識別します。これにより、チームがページを切り替えて構造化された結果を迅速に取得する必要がある場合に、セレクターの作業が軽減されます。
- スクリーンショット API: スクリーンショット要求では、ページ全体または選択した要素がキャプチャされます。監視チームは、視覚的な証拠をデータとともに保存できます。tracテッド値と変更記録。
- リクエストビルダー: ダッシュボードビルダーはコードを生成し、推定されるクレジットコストを表示します。開発者は、アプリケーションに追加する前にパラメータを確認できます。
- 無料クレジット: 新規アカウントには、支払いカードなしで1,000 APIクレジットが付与されます。このクレジットは評価目的での利用に使用されますが、期間限定のトライアルとして自動更新されることはありません。
メリット
デメリット
👉 入手方法 ScrapingBee 無料で?
- 店は開いています ScrapingBee そして、カードなしで新規アカウントを登録します。
- ダッシュボードのリクエストビルダーを使用して、テスト呼び出しを生成します。
- 新規アカウントごとに、評価用として1,000クレジットの無料APIクレジットが付与されます。
無料登録クレジット1,000ポイント
主要Webスクレイピングツールの機能比較表ping ツール
最高の無料ウェブスクレイピングをどのように選んだかping ツール?

At Guru99は、ユーザーが情報に基づいた意思決定を行えるよう、正確で関連性が高く客観的な情報を提供することに尽力しています。編集プロセスでは、有益で信頼性の高いリソースを提供することに重点を置き、コンテンツの信頼性と信頼性を確保しています。 18以上の最高のウェブスクレイピングをレビューping 豊富なツール群無料版と有料版を含め、機能、メリット、デメリット、価格に基づいて包括的な選択肢をまとめました。このガイドでは、各ツールの詳細な理解を深め、ニーズに最適なツールの選択を支援します。機能性、使いやすさ、汎用性に基づいてツールをレビューする際には、以下の要素を重視しています。
- 使いやすさ: 初心者から専門家までがスムーズにデータをスクレイピングできる、ユーザーフレンドリーなインターフェースに基づいてツールを選択しました。
- 効率性: 当チームの専門家は、効率性を最適化するツールを優先し、迅速かつ正確なデータ抽出を保証します。trac妥協のない取り組み。
- セキュリティ: 機密データを保護し、プライバシーを維持するために、強力なセキュリティ機能を備えたツールを厳選しました。
- 適応性: 多様なウェブサイトや環境に対応できる能力に基づいてツールを選択しました。tracさまざまな形式のデータを簡単に処理できます。
- コミュニティサポート: 私たちのチームは、問題を効果的に解決するために、アクティブなコミュニティと信頼できるカスタマー サポートを備えたツールを検討しました。
- 柔軟性: さまざまなユーザーやプロジェクトの特定のニーズを満たすように、カスタマイズが可能なツールを選択しました。
ウェブスクレイピングとは何ですか?ping それはどのようなツールで、どのように機能するのですか?
ウェブスクレイピングping ツールはウェブページを要求し、そのコンテンツを読み取り、trac選択したフィールドを構造化された形式に変換します。一部のツールは HTML を直接解析します。他のツールはブラウザを実行して Javaスクリプトは最初にロードできます。マネージド API はプロキシをローテーションし、ブロックされたリクエストを再試行し、結果を 1 つのエンドポイント経由で返します。ワークフローは通常、 URL そして例trac処理ルール。JSON、CSV、またはデータベース形式のレコードで終了します。初心者はまず、ページ、構造化フィールド、スクリーンショット、または繰り返し監視が必要かどうかを判断する必要があります。その選択によって、適切なツールタイプが決まります。
どの無料アクセスモデルがあなたのウェブスクレイピングに適していますか?ping プロジェクト?
無料アクセスには、毎月の永続的な利用枠、一度限りの登録クレジット、期間限定のトライアル、有料の評価など、さまざまな形態があります。これらのモデルは互換性がありません。更新可能なプランは、小規模で定期的な作業に適しています。一度限りのクレジットは、統合テストに最適です。期間限定のトライアルは、サポートや難易度の高いターゲットを迅速に評価するのに役立ちます。有料トライアルは、無料プランよりも高品質なプロキシトラフィックを提供することがよくあります。クレジットカードが必要かどうか、クレジットの消費方法、未使用容量の有効期限などを確認してください。最適なオプションは、リクエストの頻度、ターゲットの難易度、後で再構築する際の許容度によって異なります。
ウェブスクレイピングで注目すべき機能は何ですか?ping ツール?
有用な機能は用途によって異なるため、まずは目標と必要な成果物から始めましょう。以下のチェック項目は、主な購入決定事項を網羅しています。
- レンダリング: Java必要なデータが最初のHTMLレスポンスの後に表示される場合、スクリプトのサポートが重要になります。
- アクセス制御: プロキシのローテーション、セッション、およびロケーションターゲティングによって、リクエストが地域限定ページまたは保護されたページに到達するかどうかが決まります。
- 出力: JSON、CSV、Markdown、スクリーンショット、および生のHTMLは、それぞれ異なる分析および証拠のニーズに対応します。
- Operaション: スケジュール設定、再試行、ログ記録、アラート、および支出制限により、定期的なジョブを監視および制御できます。
- サポート: 明確なドキュメントと迅速なサポートにより、目標やリクエストルールが変更された際のダウンタイムを削減できます。
スクラッチはどのようにping APIはプロキシやブラウザツールと比べてどうですか?
スクラping API はリクエスト、リトライ、そして多くの場合レンダリングを単一のエンドポイントの背後で管理します。ネットワークインフラストラクチャを運用せずに結果を得たいチームに適しています。プロキシサービスはトラフィックをルーティングするだけなので、ユーザーはクローラー、パーサー、ストレージ、エラー処理を別途用意する必要があります。ブラウザツールは Javaクリックやスクロールなどの操作をスクリプト化してシミュレートします。インタラクティブなページを処理できますが、より多くのコンピューティングリソースを消費します。多くの本番システムでは、これらのアプローチを組み合わせて使用しています。プロキシはカスタムクローラーをサポートでき、マネージドブラウザは複雑なページを処理します。必要なデータを確実に取得できる、最もシンプルな方法を選択してください。
AIはウェブスクレイピングをどのように改善できるかping ワークフロー?
AI は平易な言語のフィールドリクエストを翻訳できますtracAIは、ルールに基づいて乱雑な値を正規化し、よりクリーンなJSONまたはMarkdownを生成します。また、ページレイアウトが変更された場合にセレクターを修復するのにも役立ちます。これらの機能により、特にプロトタイプや調査におけるセットアップ時間を短縮できます。ただし、検証の必要性がなくなるわけではありません。モデルは、フィールドのラベルを間違えたり、非表示のページネーションを見落としたり、無関係な値をマージしたりする可能性があります。チームはサンプルをソースページと比較し、時間の経過に伴う変更を監視する必要があります。AIは、制御されたリクエスト、明確なスキーマ、再現可能な品質チェックの周りのアシスタントとして最も効果を発揮します。
ウェブスクレイピングの方法ping ツールはデータワークフローと連携しますか?
ウェブスクレイピングping ツールは通常、REST API、SDK、Webhook、クラウドストレージ、または自動化プラットフォームを介して接続します。スケジュールされたジョブは、ページを収集し、レコードをデータセットに保存し、完了Webhookを送信します。その後、別のサービスがデータを検証、変換、またはデータウェアハウスにロードできます。AIワークフローでは、MCPまたはMarkdown出力を使用して、最新のページをリサーチエージェントに提供することが増えています。統合には、実行ステータス、タイムスタンプ、およびエラーも含まれる必要があります。これらのコンテキストがないと、下流のシステムは、新しいレコードと不完全なまたは失敗した収集を区別できません。
ウェブスクレイピングはping 合法かつ安全ですか?
ウェブスクレイピングping 合法である場合もあるが、合法性はデータ、アクセス方法、管轄区域、および意図された用途によって異なる。責任あるプロジェクトでは、これらの確認事項を文書化する必要がある。
- パブリック・アクセス: 合法的に入手可能で、かつ明確に定められた事業目的または研究目的に関連する情報のみを収集すること。
- サイトルール: Revサービス利用規約、ロボットガイダンス、tracデータ収集前に、法的制限および適用される現地法を確認してください。
- 個人データ: 個人情報の収集を最小限に抑え、保管する記録を安全に管理し、個人を特定できる情報についてはプライバシーに関する義務を遵守する。
- リクエストの負荷: 自動トラフィックがターゲットウェブサイトに支障をきたさないよう、適切な料金設定とキャッシュを活用してください。
- 法務レビュー: プロジェクトに機密データ、アカウント、認証、または不明確な制限事項が関係する場合は、資格のある専門家の助言を求めてください。
ウェブスクレイピングを保護するにはどうすればいいですか?ping データ品質?
データ品質は、明確なスキーマと代表的なテストページから始まります。スケーリングを行う前に、フィールドタイプ、必須値、ページネーション、重複、タイムスタンプを検証します。解析済みレコードの横に小さな生のレスポンスサンプルを保存して、エラーが記録されるようにします。 trac実行全体を通してレコード数とフィールド欠落率を監視します。レイアウトの変更は、もっともらしく見えるが誤った出力を生成することが多く、これは失敗したリクエストよりも見つけにくいです。バージョン extrac変更ルールを検証し、変更のたびにサンプルを比較してください。重要なデータセットについては、結論を公開する前に、信頼できる情報源ページに対して独立した検証を追加してください。
ウェブスクレイピングの方法ping プロジェクトの規模が大きくなると、コストも変わりますか?
リクエスト量、レンダリングされたページ数、プレミアムプロキシ、同時実行数、ストレージ、サポートによってコストは上昇します。 URL クレジットを複数消費する場合があります Javaスクリプト、ロケーションターゲティング、または高度なバイパスが有効になっています。APIによっては、試行失敗が無料となる場合と、有料となる場合があります。コストは、単純なリクエスト数ではなく、代表的なサンプルに基づいて計算してください。パーサーの保守と監視にかかるエンジニアリング時間も考慮に入れてください。マネージドAPIは、結果あたりのコストは高くなる可能性がありますが、運用作業は削減できます。支出制限を設定し、ターゲットごとに使用状況を確認し、実験用認証情報と本番環境用認証情報を分離してください。
ウェブが引き起こす問題とは Scraper失敗する要因と、それらを修正する方法は?
Scraper通常、ページの動作、アクセスルール、またはtrac前提条件が変更されました。修正は、闇雲に再試行するのではなく、観測された原因に対処する必要があります。
- 問題: ページは空の HTML を返します。 Java最初の応答後のスクリプト。
解決策: オペレーターはブラウザのレンダリングを有効にし、安定したセレクタを待ってから実行する必要があります。trac要求されたフィールドを記述します。 - 問題: 繰り返しのリクエストがCAをトリガーするPTC大規模収集実行時のHA(高可用性)、レート制限、または一時的なブロック。
解決策: チームはリクエスト速度を下げ、適切なプロキシをローテーションし、セッションを慎重に再利用し、サイトのアクセスルールに従うべきである。 - 問題: デザインが変更されたページでは、フィールドの位置が変更され、空白の値や不一致の値が通知なく生成される。
解決策: 管理者はセレクターのバージョン管理を行い、生のサンプルを保持し、必須フィールドの入力完了率が合意されたしきい値を下回った場合に警告を発するべきである。 - 問題: ページネーションが途中で停止するため、後続の商品、コメント、またはリストが最終的なデータセットに含まれない。
解決策: 開発者は、次のページへの遷移ロジックをテストし、ページ数を記録し、収集した合計値を視覚的に確認できるソースインジケーターと比較する必要があります。 - 問題: レンダリング、プレミアムルート、または難易度の高いターゲットを有効にすると、クレジット消費量が予想外に増加します。
解決策: オーナーはまず代表的な要望を概算し、支出限度額を設定し、高額な対象を監視対象のワークフローに分割すべきである。 - 問題: 重複ファイル URLs や再試行は重複レコードを作成し、カウントや下流の分析を歪めます。
解決策: パイプラインは安定したレコードキーを割り当て、正規化する必要があります URLレコードがレポートやストレージに取り込まれる前に、重複排除を行います。
ウェブスクレイピングを形作るトレンドとは?ping 次はツールですか?
ウェブスクレイピングping プラットフォームはAI誘導型へと移行しているtracエージェント接続や、より柔軟なブラウザインフラストラクチャなど。平易な言語のスキーマはセットアップを短縮でき、MCP統合により、研究エージェントは制御されたツールを介して現在のページを要求できます。ベンダーはまた、スクレイピングとエージェント接続を組み合わせています。ping共有アカウントの背後にある検索、クローリング、ブラウザ操作。自動化された収集がビジネス上の意思決定に利用されるにつれて、コンプライアンスとデータリネージへの注目が高まります。有用なトレンドは可観測性の向上です。チームは明確なリクエストコスト、ソースタイムスタンプ、例を必要とします。tracバージョン情報や障害原因など。自動化が進めば、これらの管理はより容易になり、隠蔽されることはなくなるはずです。
評決
アクセス制限、ワークフローの深さ、スケーリング要件に基づいて候補リストを検討しました。3つのオプションが、それぞれ異なるスクレイピングに最も適していました。ping ニーズ。
- Oxylabs: 私はその管理されたWebサイトを好みました Scraper 複雑なターゲットへの対応、構造化された配信、および個別のブラウザやプロキシのインフラストラクチャを維持することなく運用管理を行うためのAPI。
- デコド: 私のレビューでは、アクセスしやすい無料の API アクセス、準備されたテンプレート、 Javaスクリプトのレンダリング、およびデータまたはAIワークフローに適した出力。
- ノードメイヴン: 私は既にスクラッチを所有しているチームのためにこれを選びましたping コードには、詳細な位置情報ターゲティング、ローテーション制御、およびスクリーニングされたプロキシアドレスが必要です。
