
Scikit-Learn Tutorial: How to Install & Scikit-Learn Examples
 Συντακτική ομάδα
⚡ Έξυπνη Σύνοψη
Το Scikit-learn είναι ανοιχτού κώδικα Python βιβλιοθήκη που καλύπτει την προεπεξεργασία, την ταξινόμηση, την παλινδρόμηση, την ομαδοποίηση και την επιλογή μοντέλου πίσω από μια ενιαία συνεπή διεπαφή εκτιμητή, η οποία διατηρεί μια πλήρη ροή εργασίας μηχανικής μάθησης σύντομη, ευανάγνωστη και αναπαραγώγιμη από ακατέργαστα δεδομένα έως βαθμολογημένες προβλέψεις.
Τι είναι το Scikit-learn;
Scikit-μάθετε είναι ανοιχτού κώδικα Python βιβλιοθήκη για μάθηση μηχανήςΥποστηρίζει καθιερωμένους αλγόριθμους όπως KNN, ενίσχυση διαβάθμισης, τυχαίο δάσος και SVM, και είναι χτισμένο πάνω σε μουδιασμένος και SciPy. Το Scikit-learn χρησιμοποιείται ευρέως σε διαγωνισμούς Kaggle, καθώς και σε εξέχουσες εταιρείες τεχνολογίας. Καλύπτει την προεπεξεργασία, τη μείωση διαστάσεων, την ταξινόμηση, την παλινδρόμηση, την ομαδοποίηση και την επιλογή μοντέλου.
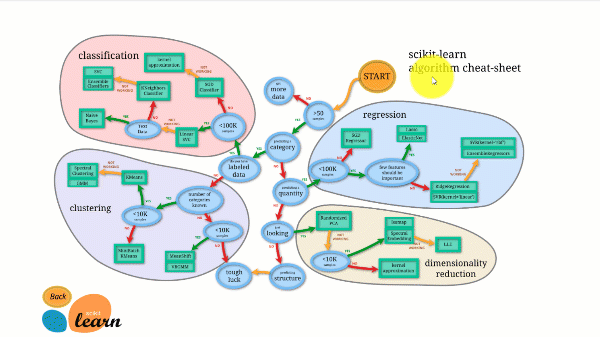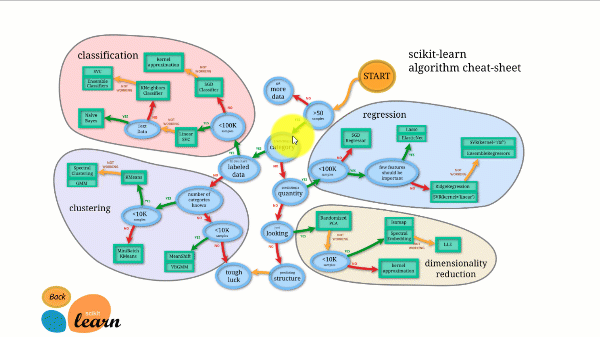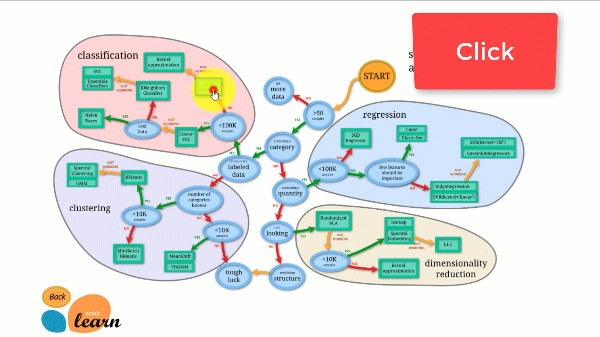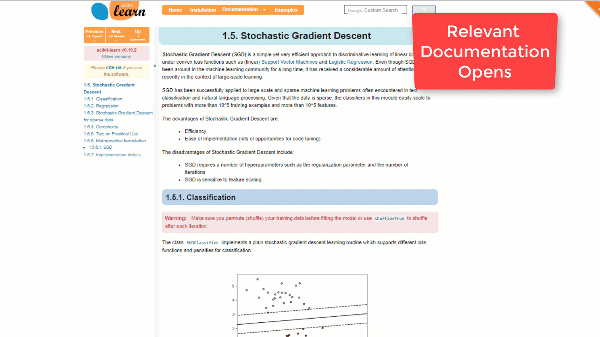
Το Scikit-learn έχει από τα καλύτερα έγγραφα από οποιαδήποτε βιβλιοθήκη ανοιχτού κώδικα. Παρέχει ακόμη και ένα διαδραστικό διάγραμμα εκτίμησης, Επιλέγοντας τον σωστό εκτιμητή, που σας καθοδηγεί από το μέγεθος του συνόλου δεδομένων σας σε μια σύντομη λίστα αλγορίθμων που αξίζει να δοκιμάσετε.
Το παρακάτω σχήμα δείχνει πώς λειτουργεί το Scikit-learn.
Το Scikit-learn δεν είναι δύσκολο στη χρήση και δίνει εξαιρετικά αποτελέσματα. Ωστόσο, εκπαιδεύεται στην CPU: η εργασία παραλληλίζεται μεταξύ πυρήνων με το όρισμα n_jobs και όχι σε μια GPU. Η εκτέλεση ενός αλγορίθμου βαθιάς μάθησης με αυτό είναι δυνατή αλλά σπάνια βέλτιστη, ειδικά αν ήδη γνωρίζετε πώς να το χρησιμοποιείτε. TensorFlow.
Πώς να κατεβάσετε και να εγκαταστήσετε το Scikit-learn
Τώρα σε αυτό Python Εκπαιδευτικό σεμινάριο Scikit-learn, θα μάθετε πώς να κατεβάσετε και να εγκαταστήσετε το Scikit-learn:
Επιλογή 1: AWS
Το Scikit-learn μπορεί να χρησιμοποιηθεί μέσω AWS. Μια εικόνα Docker με προεγκατεστημένο το scikit-learn αποθηκεύει πλήρως την εργασία εγκατάστασης.
Για να εγκαταστήσετε την έκδοση προγραμματιστή, εκτελέστε την παρακάτω εντολή μέσα Jupyter:
import sys
!{sys.executable} -m pip install git+git://github.com/scikit-learn/scikit-learn.git
Επιλογή 2: Mac ή Windows χρησιμοποιώντας το Anaconda
Για να μάθετε περισσότερα σχετικά με την εγκατάσταση του Anaconda, ανατρέξτε στο Πώς να κατεβάσετε και να εγκαταστήσετε το TensorFlow.
Την εποχή που γράφτηκε αυτή η αναλυτική παρουσίαση, οι προγραμματιστές του scikit είχαν κυκλοφορήσει μια έκδοση ανάπτυξης που διόρθωσε προβλήματα που υπήρχαν στην τότε τρέχουσα έκδοση, επομένως τα παρακάτω βήματα χρησιμοποιούν αυτήν την έκδοση προγραμματιστή. Σε ένα νέο μηχάνημα σήμερα, η τρέχουσα σταθερή έκδοση περιέχει ήδη κάθε μετασχηματιστή που χρησιμοποιείται εδώ, και εγκατάσταση pip -U scikit-learn είναι αρκετό.
Πώς να εγκαταστήσετε το scikit-learn με το Conda Environment
Εάν εγκαταστήσατε το scikit-learn με το περιβάλλον conda, ακολουθήστε τα παρακάτω βήματα για να ενημερώσετε στην έκδοση 0.20.
Βήμα 1) Ενεργοποίηση του περιβάλλοντος tensorflow
source activate hello-tf
Βήμα 2) Καταργήστε το scikit-learn χρησιμοποιώντας την εντολή conda
conda remove scikit-learn
Βήμα 3) Εγκαταστήστε την έκδοση προγραμματιστή
Εγκαταστήστε την έκδοση προγραμματιστή scikit-learn μαζί με τις απαραίτητες βιβλιοθήκες.
conda install -c anaconda git
pip install Cython
pip install h5py
pip install git+git://github.com/scikit-learn/scikit-learn.git
ΣΗΜΕΊΩΣΗ: Windows οι χρήστες χρειάζονται Microsoft Οπτικό C++ 14. Μπορείς να το αποκτήσεις εδώ.
Παράδειγμα Scikit-Learn με Μηχανική Μάθηση
Αυτό το σεμινάριο Scikit χωρίζεται σε δύο μέρη:
- Μηχανική μάθηση με scikit-learn
- Πώς να εμπιστευτείτε το μοντέλο σας με το LIME
Το πρώτο μέρος περιγράφει λεπτομερώς τον τρόπο κατασκευής ενός αγωγού, τη δημιουργία ενός μοντέλου και τη ρύθμιση των υπερπαραμέτρων, ενώ το δεύτερο μέρος καλύπτει την ερμηνεία του μοντέλου.
Βήμα 1) Εισαγάγετε τα δεδομένα
Κατά τη διάρκεια αυτού του σεμιναρίου εκμάθησης Scikit, θα χρησιμοποιήσετε το σύνολο δεδομένων της απογραφής ενηλίκων.
Το αρχείο διαβάζεται απευθείας από το Αποθετήριο Μηχανικής Μάθησης UCI στον παρακάτω κώδικα, επομένως δεν απαιτείται χειροκίνητη λήψη. Αν ενδιαφέρεστε για τα περιγραφικά στατιστικά στοιχεία, αξίζει να δείτε τα εργαλεία Dive και Overview. Ανατρέξτε στο αυτό το σεμινάριο για να μάθετε περισσότερα για την Κατάδυση και την Επισκόπηση.
Εισάγετε το σύνολο δεδομένων με pandas. Σημειώστε ότι πρέπει να μετατρέψετε τις συνεχείς μεταβλητές σε μορφή float.
Αυτό το σύνολο δεδομένων περιλαμβάνει οκτώ κατηγορικές μεταβλητές, οι οποίες παρατίθενται στην κατηγορία CATE_FEATURES:
- τάξη εργασίας
- εκπαίδευση
- συζυγικός
- επάγγελμα
- σχέση
- αγώνας
- φύλο
- χώρα ιθαγένειας
Περιλαμβάνει επίσης έξι συνεχείς μεταβλητές, που παρατίθενται στο CONTI_FEATURES:
- την ηλικία του
- fnlwgt
- εκπαίδευση_αριθμ
- κεφαλαιακό κέρδος
- απώλεια_κεφαλαίου
- ώρες_εβδομάδα
Οι λίστες συμπληρώνονται χειροκίνητα εδώ, ώστε να έχετε μια πιο σαφή εικόνα για το ποιες στήλες είναι ενεργές. Ένας πιο γρήγορος τρόπος για να δημιουργήσετε μια λίστα κατηγορικών ή συνεχών στηλών είναι:
## List Categorical
CATE_FEATURES = df_train.iloc[:,:-1].select_dtypes('object').columns
print(CATE_FEATURES)

## List continuous
CONTI_FEATURES =  df_train._get_numeric_data()
print(CONTI_FEATURES)
Εδώ είναι ο κώδικας για την εισαγωγή των δεδομένων:
# Import dataset
import pandas as pd

## Define path data
COLUMNS = ['age','workclass', 'fnlwgt', 'education', 'education_num', 'marital',
           'occupation', 'relationship', 'race', 'sex', 'capital_gain', 'capital_loss',
           'hours_week', 'native_country', 'label']
### Define continuous list
CONTI_FEATURES  = ['age', 'fnlwgt','capital_gain', 'education_num', 'capital_loss', 'hours_week']
### Define categorical list
CATE_FEATURES = ['workclass', 'education', 'marital', 'occupation', 'relationship', 'race', 'sex', 'native_country']

## Prepare the data
features = ['age','workclass', 'fnlwgt', 'education', 'education_num', 'marital',
           'occupation', 'relationship', 'race', 'sex', 'capital_gain', 'capital_loss',
           'hours_week', 'native_country']

PATH = "https://archive.ics.uci.edu/ml/machine-learning-databases/adult/adult.data"

df_train = pd.read_csv(PATH, skipinitialspace=True, names = COLUMNS, index_col=False)
df_train[CONTI_FEATURES] =df_train[CONTI_FEATURES].astype('float64')
df_train.describe()
Η κλήση της συνάρτησης describe() στο πλαίσιο επιστρέφει τα συνοπτικά στατιστικά στοιχεία για τις έξι συνεχόμενες στήλες:
| την ηλικία του | fnlwgt | εκπαίδευση_αριθμ | κεφαλαιακό κέρδος | απώλεια_κεφαλαίου | ώρες_εβδομάδα | |
|---|---|---|---|---|---|---|
| μετράνε | 32561.000000 | 3.256100e + 04 | 32561.000000 | 32561.000000 | 32561.000000 | 32561.000000 |
| εννοώ | 38.581647 | 1.897784e + 05 | 10.080679 | 1077.648844 | 87.303830 | 40.437456 |
| std | 13.640433 | 1.055500e + 05 | 2.572720 | 7385.292085 | 402.960219 | 12.347429 |
| πρακτικά | 17.000000 | 1.228500e + 04 | 1.000000 | 0.000000 | 0.000000 | 1.000000 |
| 25% | 28.000000 | 1.178270e + 05 | 9.000000 | 0.000000 | 0.000000 | 40.000000 |
| 50% | 37.000000 | 1.783560e + 05 | 10.000000 | 0.000000 | 0.000000 | 40.000000 |
| 75% | 48.000000 | 2.370510e + 05 | 12.000000 | 0.000000 | 0.000000 | 45.000000 |
| max | 90.000000 | 1.484705e + 06 | 16.000000 | 99999.000000 | 4356.000000 | 99.000000 |
Μπορείτε να ελέγξετε τον αριθμό των μοναδικών τιμών της λειτουργίας native_country. Μόνο ένα νοικοκυριό προέρχεται από την Ολλανδία. Αυτό το νοικοκυριό δεν φέρνει πληροφορίες και θα εμφανίσει σφάλμα κατά την εκπαίδευση.
df_train.native_country.value_counts()
United-States                 29170
Mexico                          643
?                               583
Philippines                     198
Germany                         137
Canada                          121
Puerto-Rico                     114
El-Salvador                     106
India                           100
Cuba                             95
England                          90
Jamaica                          81
South                            80
China                            75
Italy                            73
Dominican-Republic               70
Vietnam                          67
Guatemala                        64
Japan                            62
Poland                           60
Columbia                         59
Taiwan                           51
Haiti                            44
Iran                             43
Portugal                         37
Nicaragua                        34
Peru                             31
France                           29
Greece                           29
Ecuador                          28
Ireland                          24
Hong                             20
Cambodia                         19
Trinadad&Tobago                  19
Thailand                         18
Laos                             18
Yugoslavia                       16
Outlying-US(Guam-USVI-etc)       14
Honduras                         13
Hungary                          13
Scotland                         12
Holand-Netherlands                1
Name: native_country, dtype: int64
Μπορείτε να εξαιρέσετε αυτήν τη μη ενημερωτική γραμμή από το σύνολο δεδομένων:
## Drop Netherland, because only one row
df_train = df_train[df_train.native_country != "Holand-Netherlands"]
Στη συνέχεια, αποθηκεύετε τη θέση των συνεχών δυνατοτήτων σε μια λίστα. Θα το χρειαστείτε στο επόμενο βήμα για την κατασκευή του αγωγού.
Ο παρακάτω κώδικας επαναλαμβάνει όλα τα ονόματα στηλών στο CONTI_FEATURES, διαβάζει κάθε τοποθεσία (δηλαδή, τον αριθμό της στήλης της) και την προσθέτει σε μια λίστα που ονομάζεται conti_features.
## Get the column index of the categorical features
conti_features = []
for i in CONTI_FEATURES:
    position = df_train.columns.get_loc(i)
    conti_features.append(position)
print(conti_features)
[0, 2, 10, 4, 11, 12]
Το επόμενο μπλοκ κάνει την ίδια δουλειά για τις κατηγορικές μεταβλητές.
## Get the column index of the categorical features
categorical_features = []
for i in CATE_FEATURES:
    position = df_train.columns.get_loc(i)
    categorical_features.append(position)
print(categorical_features)
[1, 3, 5, 6, 7, 8, 9, 13]
Τώρα, εξετάστε το ίδιο το σύνολο δεδομένων. Κάθε κατηγορηματικό χαρακτηριστικό είναι μια συμβολοσειρά και σε ένα μοντέλο δεν μπορεί να δοθεί μια τιμή συμβολοσειράς, επομένως το σύνολο δεδομένων πρέπει να μετασχηματιστεί με εικονικές μεταβλητές.
df_train.head(5)
Στην πραγματικότητα, χρειάζεστε μία στήλη για κάθε ομάδα σε κάθε χαρακτηριστικό. Αρχικά, εκτελέστε τον παρακάτω κώδικα για να υπολογίσετε τον συνολικό αριθμό στηλών που απαιτούνται.
print(df_train[CATE_FEATURES].nunique(),
      'There are',sum(df_train[CATE_FEATURES].nunique()), 'groups in the whole dataset')
workclass          9
education         16
marital            7
occupation        15
relationship       6
race               5
sex                2
native_country    41
dtype: int64 There are 101 groups in the whole dataset
Ολόκληρο το σύνολο δεδομένων περιέχει 101 ομάδες, όπως φαίνεται παραπάνω. Μόνο η λειτουργία της κλάσης εργασίας έχει εννέα ομάδες. Μπορείτε να παραθέσετε τα ονόματα των ομάδων με τον παρακάτω κώδικα. Η unique() επιστρέφει τις διακριτές τιμές κάθε κατηγορικού χαρακτηριστικού.
for i in CATE_FEATURES:
    print(df_train[i].unique())
['State-gov' 'Self-emp-not-inc' 'Private' 'Federal-gov' 'Local-gov' '?'
 'Self-emp-inc' 'Without-pay' 'Never-worked']
['Bachelors' 'HS-grad' '11th' 'Masters' '9th' 'Some-college' 'Assoc-acdm'
 'Assoc-voc' '7th-8th' 'Doctorate' 'Prof-school' '5th-6th' '10th'
 '1st-4th' 'Preschool' '12th']
['Never-married' 'Married-civ-spouse' 'Divorced' 'Married-spouse-absent'
 'Separated' 'Married-AF-spouse' 'Widowed']
['Adm-clerical' 'Exec-managerial' 'Handlers-cleaners' 'Prof-specialty'
 'Other-service' 'Sales' 'Craft-repair' 'Transport-moving'
 'Farming-fishing' 'Machine-op-inspct' 'Tech-support' '?'
 'Protective-serv' 'Armed-Forces' 'Priv-house-serv']
['Not-in-family' 'Husband' 'Wife' 'Own-child' 'Unmarried' 'Other-relative']
['White' 'Black' 'Asian-Pac-Islander' 'Amer-Indian-Eskimo' 'Other']
['Male' 'Female']
['United-States' 'Cuba' 'Jamaica' 'India' '?' 'Mexico' 'South'
 'Puerto-Rico' 'Honduras' 'England' 'Canada' 'Germany' 'Iran'
 'Philippines' 'Italy' 'Poland' 'Columbia' 'Cambodia' 'Thailand' 'Ecuador'
 'Laos' 'Taiwan' 'Haiti' 'Portugal' 'Dominican-Republic' 'El-Salvador'
 'France' 'Guatemala' 'China' 'Japan' 'Yugoslavia' 'Peru'
 'Outlying-US(Guam-USVI-etc)' 'Scotland' 'Trinadad&Tobago' 'Greece'
 'Nicaragua' 'Vietnam' 'Hong' 'Ireland' 'Hungary']
Το σύνολο δεδομένων εκπαίδευσης θα περιέχει επομένως 101 + 6 στήλες: τις ομάδες ενός θερμού συν τα έξι συνεχή χαρακτηριστικά.
Το Scikit-learn μπορεί να αναλάβει τη μετατροπή σε δύο βήματα:
- Μετατρέψτε τη συμβολοσειρά σε ID. Το State-gov γίνεται ID 1, το Self-emp-not-inc γίνεται ID 2 και ούτω καθεξής. Το LabelEncoder το κάνει αυτό για εσάς.
- Μεταφέρετε κάθε αναγνωριστικό σε μια νέα στήλη. Το σύνολο δεδομένων έχει 101 αναγνωριστικά ομάδας, επομένως θα υπάρχουν 101 στήλες που θα καταγράφουν κάθε κατηγορική ομάδα χαρακτηριστικών. Το Scikit-learn παρέχει το OneHotEncoder για αυτήν τη λειτουργία.
Βήμα 2) Δημιουργήστε το σετ τρένου/δοκιμών
Τώρα που το σύνολο δεδομένων είναι έτοιμο, χωρίστε το σε 80/20: 80 τοις εκατό για το σύνολο εκπαίδευσης και 20 τοις εκατό για το σύνολο δοκιμών.
Μπορείτε να χρησιμοποιήσετε το train_test_split. Το πρώτο όρισμα είναι το dataframe των features και το δεύτερο είναι η ετικέτα. Ορίζετε το μέγεθος του συνόλου δοκιμών με το test_size.
from sklearn.model_selection import train_test_split
X_train, X_test, y_train, y_test = train_test_split(df_train[features],
                                                    df_train.label,
                                                    test_size = 0.2,
                                                    random_state=0)
X_train.head(5)
print(X_train.shape, X_test.shape)
(26048, 14) (6512, 14)
Βήμα 3) Κατασκευάστε τον αγωγό
Η διοχέτευση διευκολύνει την τροφοδοσία του μοντέλου με συνεπή δεδομένα. Η ιδέα είναι να προωθηθούν τα ακατέργαστα δεδομένα μέσω ενός αντικειμένου που εκτελεί κάθε λειτουργία με τη σειρά.
Με αυτό το σύνολο δεδομένων πρέπει να τυποποιήσετε τις συνεχείς μεταβλητές και να μετατρέψετε τις κατηγορικές. Οποιαδήποτε λειτουργία μπορεί να υπάρχει μέσα σε μια σωλήνωση: οι τιμές που λείπουν μπορούν να αντικατασταθούν με τον μέσο όρο ή τη διάμεσο και μπορούν να δημιουργηθούν νέες μεταβλητές.
Έχετε μια επιλογή: να δημιουργήσετε έναν σκληρό κώδικα για τις δύο διεργασίες ή να δημιουργήσετε μια διοχέτευση. Η σκληρή κωδικοποίηση μπορεί να διαρρεύσει δεδομένα δοκιμών στα προσαρμοσμένα στατιστικά στοιχεία και να δημιουργήσει ασυνέπειες με την πάροδο του χρόνου, επομένως η διοχέτευση είναι η καλύτερη επιλογή.
from sklearn.preprocessing import StandardScaler, OneHotEncoder, LabelEncoder
from sklearn.compose import ColumnTransformer, make_column_transformer
from sklearn.pipeline import make_pipeline
from sklearn.linear_model import LogisticRegression
Ο αγωγός εκτελεί δύο λειτουργίες πριν τροφοδοτήσει τον λογιστικό ταξινομητή:
- Τυποποιήστε τη μεταβλητή: StandardScaler()
- Μετατροπή των κατηγορικών χαρακτηριστικών: OneHotEncoder(sparse=False)
Εκτελείτε και τα δύο βήματα με το make_column_transformer. Όταν γράφτηκε αυτή η αναλυτική παρουσίαση, η συνάρτηση δεν υπήρχε στην κυκλοφορήσιμη έκδοση του scikit-learn (0.19), γι' αυτό και χρησιμοποιήθηκε η έκδοση προγραμματιστή. Έχει συμπεριληφθεί σε κάθε σταθερή έκδοση από την έκδοση 0.20.
Η make_column_transformer είναι απλή: δηλώνετε ποιες στήλες θα μετασχηματίσετε και ποιον μετασχηματισμό θα εφαρμόσετε. Για να τυποποιήσετε τα συνεχή χαρακτηριστικά που μεταβιβάζετε:
- conti_features, StandardScaler() μέσα στο make_column_transformer
- conti_features: η λίστα συνεχόμενων στηλών
- StandardScaler: τυποποιεί αυτές τις στήλες
Το αντικείμενο OneHotEncoder μέσα στο make_column_transformer κωδικοποιεί αυτόματα τις ετικέτες.
preprocess = make_column_transformer(
    (conti_features, StandardScaler()),
    ### Need to be numeric not string to specify columns name
    (categorical_features, OneHotEncoder(sparse=False))
)
Σημείωση έκδοσης: Δύο ορίσματα στο παραπάνω μπλοκ έχουν μετακινηθεί. Οι τρέχουσες εκδόσεις αναμένουν τον μετασχηματιστή πρώτο και τις στήλες δεύτερο, και αραιός μετονομάστηκε αραιή_έξοδος στο scikit-learn 1.2 και αφαιρέθηκε στο 1.4, επομένως ο νεότερος κώδικας διαβάζεται OneHotEncoder(sparse_output=False).
Μπορείτε να ελέγξετε αν ο αγωγός λειτουργεί με την εντολή fit_transform. Η έξοδος θα πρέπει να έχει το σχήμα 26048, 107.
preprocess.fit_transform(X_train).shape
(26048, 107)
Ο μετασχηματιστής δεδομένων είναι έτοιμος. Δημιουργείτε τον αγωγό με το make_pipeline και, μόλις μετασχηματιστούν τα δεδομένα, τροφοδοτείτε τη λογιστική παλινδρόμηση.
model = make_pipeline(
    preprocess,
    LogisticRegression())
Η εκπαίδευση ενός μοντέλου με το scikit-learn είναι επομένως απλή: καλέστε την προσαρμογή στον αγωγό. Μπορείτε να εκτυπώσετε την ακρίβεια με τη μέθοδο score.
model.fit(X_train, y_train)
print("logistic regression score: %f" % model.score(X_test, y_test))
logistic regression score: 0.850891
Τέλος, μπορείτε να προβλέψετε τις κλάσεις με την predict_proba, η οποία επιστρέφει την πιθανότητα κάθε κλάσης. Σημειώστε ότι το άθροισμα των δύο πιθανοτήτων είναι ένα.
model.predict_proba(X_test)
array([[0.83576663, 0.16423337],
       [0.94582765, 0.05417235],
       [0.64760587, 0.35239413],
       ...,
       [0.99639252, 0.00360748],
       [0.02072181, 0.97927819],
       [0.56781353, 0.43218647]])
Βήμα 4) Χρήση του αγωγού μας σε μια αναζήτηση πλέγματος
Η ρύθμιση των υπερπαραμέτρων, των τιμών που καθορίζουν τη δομή του μοντέλου, μπορεί να είναι κουραστική και εξαντλητική.
Ένας τρόπος για να αξιολογήσετε το μοντέλο θα ήταν να αλλάξετε το μέγεθος του συνόλου εκπαίδευσης και να μετρήσετε την απόδοση, επαναλαμβάνοντας την άσκηση δέκα φορές για να δείτε την εξάπλωση της βαθμολογίας. Αυτή είναι πολλή χειρωνακτική εργασία.
Αντίθετα, το scikit-learn παρέχει συναρτήσεις που πραγματοποιούν ρύθμιση παραμέτρων και διασταυρούμενη επικύρωση για εσάς.
Διασταυρωμένη επικύρωση
Η διασταυρούμενη επικύρωση σημαίνει ότι κατά τη διάρκεια της εκπαίδευσης το σύνολο εκπαίδευσης χωρίζεται n φορές σε πτυχές και το μοντέλο αξιολογείται n φορές. Εάν το cv οριστεί σε 10, το μοντέλο εκπαιδεύεται και αξιολογείται δέκα φορές. Σε κάθε γύρο, ο ταξινομητής εκπαιδεύεται σε εννέα πτυχές που επιλέγονται τυχαία και η δέκατη πτυχή διατηρείται για αξιολόγηση.
Αναζήτηση πλέγματος
Κάθε ταξινομητής έχει υπερπαραμέτρους προς ρύθμιση. Μπορείτε να δοκιμάσετε τιμές μία κάθε φορά ή να ορίσετε ένα πλέγμα παραμέτρων. Η τεκμηρίωση scikit-learn παραθέτει όλες τις παραμέτρους που δέχεται ο λογιστικός ταξινομητής. Για να διατηρηθεί η εκπαίδευση γρήγορη, αυτό το παράδειγμα ρυθμίζει μόνο την παράμετρο C, η οποία ελέγχει την κανονικοποίηση. Πρέπει να είναι θετική και μια μικρή τιμή δίνει μεγαλύτερο βάρος στον κανονικοποιητή.
Χρησιμοποιείτε το αντικείμενο GridSearchCV, το οποίο δέχεται ένα λεξικό των υπερπαραμέτρων για ρύθμιση. Παραθέστε κάθε υπερπαράμετρο ακολουθούμενη από τις τιμές που θέλετε να δοκιμάσετε. Για να ρυθμίσετε το C γράφετε:
- 'logisticregression__C': [0.001, 0.01, 0.1, 1.0] — πριν από το όνομα της παραμέτρου, προηγείται το όνομα του ταξινομητή με πεζά γράμματα και δύο υπογράμμισης.
Το μοντέλο θα δοκιμάσει τέσσερις διαφορετικές τιμές: 0.001, 0.01, 0.1 και 1. Εκπαιδεύεται με 10 πτυχώσεις, δηλαδή cv=10.
from sklearn.model_selection import GridSearchCV
# Construct the parameter grid
param_grid = {
    'logisticregression__C': [0.001, 0.01,0.1, 1.0],
    }
Μπορείτε τώρα να εκπαιδεύσετε το μοντέλο χρησιμοποιώντας το GridSearchCV με την παράμετρο grid και cv.
# Train the model
grid_clf = GridSearchCV(model,
                        param_grid,
                        cv=10,
                        iid=False)
grid_clf.fit(X_train, y_train)
Παραγωγή:
GridSearchCV(cv=10, error_score='raise-deprecating',
       estimator=Pipeline(memory=None,
     steps=[('columntransformer', ColumnTransformer(n_jobs=1, remainder='drop', transformer_weights=None,
         transformers=[('standardscaler', StandardScaler(copy=True, with_mean=True, with_std=True), [0, 2, 10, 4, 11, 12]), ('onehotencoder', OneHotEncoder(categorical_features=None, categories=None,...ty='l2', random_state=None, solver='liblinear', tol=0.0001,
          verbose=0, warm_start=False))]),
       fit_params=None, iid=False, n_jobs=1,
       param_grid={'logisticregression__C': [0.001, 0.01, 0.1, 1.0]},
       pre_dispatch='2*n_jobs', refit=True, return_train_score='warn',
       scoring=None, verbose=0)
Σημείωση έκδοσης: ο iid Το όρισμα που είναι ορατό σε αυτήν την έξοδο είχε καταργηθεί στο scikit-learn 0.22 και αφαιρέθηκε στο 0.24, επομένως θα πρέπει απλώς να αφαιρεθεί από την κλήση GridSearchCV στις τρέχουσες εκδόσεις.
Για να αποκτήσετε πρόσβαση στις βέλτιστες παραμέτρους, χρησιμοποιείτε την best_params_.
grid_clf.best_params_
Παραγωγή:
{'logisticregression__C': 1.0}
Μετά την εκπαίδευση του μοντέλου με τέσσερις διαφορετικές τιμές κανονικοποίησης, η βέλτιστη παράμετρος δίνει:
print("best logistic regression from grid search: %f" % grid_clf.best_estimator_.score(X_test, y_test))
καλύτερη λογιστική παλινδρόμηση από την αναζήτηση πλέγματος: 0.850891
Για πρόσβαση στις προβλεπόμενες πιθανότητες:
grid_clf.best_estimator_.predict_proba(X_test)
array([[0.83576677, 0.16423323],
       [0.9458291 , 0.0541709 ],
       [0.64760416, 0.35239584],
       ...,
       [0.99639224, 0.00360776],
       [0.02072033, 0.97927967],
       [0.56782222, 0.43217778]])
Μοντέλο XGBoost με scikit-learn
Τώρα δοκιμάστε έναν από τους ισχυρότερους ταξινομητές στην αγορά. Το XGBoost είναι μια βελτίωση που ενισχύει την κλίση στο τυχαίο δάσος. Το θεωρητικό του υπόβαθρο είναι εκτός του πεδίου εφαρμογής αυτού. Python Εκπαιδευτικό βίντεο Scikit, αλλά να θυμάστε ότι το XGBoost έχει κερδίσει πολλούς διαγωνισμούς Kaggle. Σε ένα σύνολο δεδομένων μεσαίου μεγέθους, μπορεί να αποδώσει εξίσου καλά με έναν αλγόριθμο βαθιάς μάθησης ή και καλύτερα.
Ο ταξινομητής είναι δύσκολος στην εκπαίδευση επειδή εκθέτει έναν μεγάλο αριθμό παραμέτρων. Μπορείτε φυσικά να χρησιμοποιήσετε το GridSearchCV για να τις επιλέξετε για εσάς.
Μια καλύτερη επιλογή εδώ είναι το RandomizedSearchCV. Το GridSearchCV γίνεται αργό όταν το πλέγμα είναι μεγάλο, επειδή ο χώρος αναζήτησης μεγαλώνει με κάθε παράμετρο που προστίθεται. Το RandomizedSearchCV αντίθετα λαμβάνει δείγματα από τις τιμές κάθε υπερπαραμέτρου τυχαία σε κάθε επανάληψη, έτσι ώστε 1,000 επαναλήψεις να αξιολογούν 1,000 συνδυασμούς. Κατά τα άλλα, λειτουργεί πολύ όπως το GridSearchCV.
Πρέπει να εισαγάγετε το xgboost. Εάν η βιβλιοθήκη δεν είναι εγκατεστημένη, εκτελέστε την εντολή pip3 install xgboost ή εγκαταστήστε την από μέσα σε ένα Jupyter σημειωματάριο με:
use import sys
!{sys.executable} -m pip install xgboost
Στη συνέχεια, εισαγάγετε τον ταξινομητή και τους δύο βοηθούς αναζήτησης:
import xgboost
from sklearn.model_selection import RandomizedSearchCV
from sklearn.model_selection import StratifiedKFold
Το επόμενο βήμα σε αυτό το Scikit Python Το σεμινάριο είναι να καθορίσετε τις παραμέτρους που θα ρυθμιστούν. Η επίσημη τεκμηρίωση του XGBoost τις παραθέτει όλες. Για λόγους αυτού Python Στο σεμινάριο Sklearn επιλέγετε μόνο δύο υπερπαραμέτρους με δύο τιμές η καθεμία, επειδή το XGBoost χρειάζεται πολύ χρόνο για να εκπαιδευτεί και κάθε επιπλέον σημείο πλέγματος προσθέτει στην αναμονή.
params = {
        'xgbclassifier__gamma': [0.5, 1],
        'xgbclassifier__max_depth': [3, 4]
        }
Στη συνέχεια, κατασκευάζετε μια νέα αγωγό με τον ταξινομητή XGBoost και 600 εκτιμητές. Το n_estimators είναι από μόνο του ρυθμιζόμενο και μια υψηλή τιμή μπορεί να οδηγήσει σε υπερπροσαρμογή. Μπορείτε να δοκιμάσετε άλλες τιμές, αλλά να γνωρίζετε ότι μπορεί να χρειαστούν ώρες. Κάθε άλλη παράμετρος διατηρεί την προεπιλεγμένη της τιμή.
model_xgb = make_pipeline(
    preprocess,
    xgboost.XGBClassifier(
                          n_estimators=600,
                          objective='binary:logistic',
                          silent=True,
                          nthread=1)
)
Μπορείτε να βελτιώσετε την διασταυρούμενη επικύρωση με το εργαλείο διασταυρούμενης επικύρωσης Stratified K-Folds. Εδώ χρησιμοποιούνται μόνο τρεις αναδιπλώσεις για να επιταχυνθεί ο υπολογισμός, με κάποιο κόστος στην ποιότητα. Αυξήστε αυτήν την τιμή σε 5 ή 10 στο δικό σας μηχάνημα για καλύτερα αποτελέσματα. Το μοντέλο εκπαιδεύεται σε τέσσερις επαναλήψεις.
skf = StratifiedKFold(n_splits=3,
                      shuffle = True,
                      random_state = 1001)

random_search = RandomizedSearchCV(model_xgb,
                                   param_distributions=params,
                                   n_iter=4,
                                   scoring='accuracy',
                                   n_jobs=4,
                                   cv=skf.split(X_train, y_train),
                                   verbose=3,
                                   random_state=1001)
Η τυχαία αναζήτηση είναι έτοιμη, ώστε να μπορείτε να εκπαιδεύσετε το μοντέλο.
#grid_xgb = GridSearchCV(model_xgb, params, cv=10, iid=False)
random_search.fit(X_train, y_train)
Fitting 3 folds for each of 4 candidates, totalling 12 fits
[CV] xgbclassifier__max_depth=3, xgbclassifier__gamma=0.5 ............
[CV] xgbclassifier__max_depth=3, xgbclassifier__gamma=0.5 ............
[CV] xgbclassifier__max_depth=3, xgbclassifier__gamma=0.5 ............
[CV] xgbclassifier__max_depth=4, xgbclassifier__gamma=0.5 ............
[CV]  xgbclassifier__max_depth=3, xgbclassifier__gamma=0.5, score=0.8759645283888057, total= 1.0min
[CV] xgbclassifier__max_depth=4, xgbclassifier__gamma=0.5 ............
[CV]  xgbclassifier__max_depth=3, xgbclassifier__gamma=0.5, score=0.8729701715996775, total= 1.0min
[CV]  xgbclassifier__max_depth=3, xgbclassifier__gamma=0.5, score=0.8706519235199263, total= 1.0min
[CV] xgbclassifier__max_depth=4, xgbclassifier__gamma=0.5 ............
[CV] xgbclassifier__max_depth=3, xgbclassifier__gamma=1 ..............
[CV]  xgbclassifier__max_depth=4, xgbclassifier__gamma=0.5, score=0.8735460094437406, total= 1.3min
[CV] xgbclassifier__max_depth=3, xgbclassifier__gamma=1 ..............
[CV]  xgbclassifier__max_depth=3, xgbclassifier__gamma=1, score=0.8722791661868018, total=  57.7s
[CV] xgbclassifier__max_depth=3, xgbclassifier__gamma=1 ..............
[CV]  xgbclassifier__max_depth=3, xgbclassifier__gamma=1, score=0.8753886905447426, total= 1.0min
[CV] xgbclassifier__max_depth=4, xgbclassifier__gamma=1 ..............
[CV]  xgbclassifier__max_depth=4, xgbclassifier__gamma=0.5, score=0.8697304768486523, total= 1.3min
[CV] xgbclassifier__max_depth=4, xgbclassifier__gamma=1 ..............
[CV]  xgbclassifier__max_depth=4, xgbclassifier__gamma=0.5, score=0.8740066797189912, total= 1.4min
[CV] xgbclassifier__max_depth=4, xgbclassifier__gamma=1 ..............
[CV]  xgbclassifier__max_depth=3, xgbclassifier__gamma=1, score=0.8707671043538355, total= 1.0min
[CV]  xgbclassifier__max_depth=4, xgbclassifier__gamma=1, score=0.8729701715996775, total= 1.2min
[Parallel(n_jobs=4)]: Done  10 out of  12 | elapsed:  3.6min remaining:   43.5s
[CV]  xgbclassifier__max_depth=4, xgbclassifier__gamma=1, score=0.8736611770125533, total= 1.2min
[CV]  xgbclassifier__max_depth=4, xgbclassifier__gamma=1, score=0.8692697535130154, total= 1.2min
[Parallel(n_jobs=4)]: Done  12 out of  12 | elapsed:  3.6min finished
/Users/Thomas/anaconda3/envs/hello-tf/lib/python3.6/site-packages/sklearn/model_selection/_search.py:737: DeprecationWarning: The default of the `iid` parameter will change from True to False in version 0.22 and will be removed in 0.24. This will change numeric results when test-set sizes are unequal. DeprecationWarning)
RandomizedSearchCV(cv=<generator object _BaseKFold.split at 0x1101eb830>,
          error_score='raise-deprecating',
          estimator=Pipeline(memory=None,
     steps=[('columntransformer', ColumnTransformer(n_jobs=1, remainder='drop', transformer_weights=None,
         transformers=[('standardscaler', StandardScaler(copy=True, with_mean=True, with_std=True), [0, 2, 10, 4, 11, 12]), ('onehotencoder', OneHotEncoder(categorical_features=None, categories=None,...
       reg_alpha=0, reg_lambda=1, scale_pos_weight=1, seed=None,
       silent=True, subsample=1))]),
          fit_params=None, iid='warn', n_iter=4, n_jobs=4,
          param_distributions={'xgbclassifier__gamma': [0.5, 1], 'xgbclassifier__max_depth': [3, 4]},
          pre_dispatch='2*n_jobs', random_state=1001, refit=True,
          return_train_score='warn', scoring='accuracy', verbose=3)
Όπως μπορείτε να δείτε, το XGBoost βαθμολογείται καλύτερα από την προηγούμενη λογιστική παλινδρόμηση.
print("καλυτερα parameter", random_search.best_params_)
print("best logistic regression from grid search: %f" % random_search.best_estimator_.score(X_test, y_test))
καλυτερα parameter {'xgbclassifier__max_depth': 3, 'xgbclassifier__gamma': 0.5}
best logistic regression from grid search: 0.873157
random_search.best_estimator_.predict(X_test)
array(['<=50K', '<=50K', '<=50K', ..., '<=50K', '>50K', '<=50K'], dtype=object)
Δημιουργήστε DNN με τον MLPClassifier στο scikit-learn
Τέλος, μπορείτε να εκπαιδεύσετε ένα νευρωνικό δίκτυο με το ίδιο το scikit-learn. Η μέθοδος είναι η ίδια όπως και για οποιονδήποτε άλλο ταξινομητή και ο εκτιμητής είναι ο MLPClassifier.
from sklearn.neural_network import MLPClassifier
Το παρακάτω δίκτυο ορίζεται ως εξής:
- Αδάμ λύτης
- Λειτουργία ενεργοποίησης ReLU
- Άλφα = 0.0001
- Μέγεθος παρτίδας 150
- Δύο κρυφά στρώματα με 200 και 100 νευρώνες αντίστοιχα
model_dnn = make_pipeline(
    preprocess,
    MLPClassifier(solver='adam',
                  alpha=0.0001,
                  activation='relu',
                    batch_size=150,
                    hidden_layer_sizes=(200, 100),
                    random_state=1))
Μπορείτε να αλλάξετε τον αριθμό των επιπέδων για να βελτιώσετε το μοντέλο.
model_dnn.fit(X_train, y_train)
  print("DNN regression score: %f" % model_dnn.score(X_test, y_test))
Βαθμολογία παλινδρόμησης DNN: 0.821253
LIME: Εμπιστευτείτε το μοντέλο σας
Τώρα που έχετε ένα καλό μοντέλο, χρειάζεστε έναν τρόπο να το εμπιστευτείτε. Οι αλγόριθμοι μηχανικής μάθησης, ειδικά τα τυχαία δάση και τα νευρωνικά δίκτυα, είναι γνωστοί ως μοντέλα μαύρου κουτιού: λειτουργούν, αλλά κανείς δεν μπορεί να καταλάβει γιατί.
Τρεις ερευνητές δημιούργησαν ένα εργαλείο που δείχνει πώς ο υπολογιστής καταλήγει σε μια πρόβλεψη. Η εργασία τους είναι «Γιατί να σε εμπιστευτώ;», και ο αλγόριθμος που δημοσίευσαν ονομάζεται Τοπικές Ερμηνευόμενες Μοντέλο-Αγνωστικές Επεξηγήσεις (LIME).
Πάρτε ένα παράδειγμα. Μερικές φορές δεν γνωρίζετε αν μια πρόβλεψη μηχανικής μάθησης μπορεί να είναι αξιόπιστη. Ένας γιατρός δεν μπορεί να αποδεχτεί μια διάγνωση απλώς και μόνο επειδή την παρήγαγε ένας υπολογιστής και πρέπει να γνωρίζετε αν ένα μοντέλο είναι αξιόπιστο πριν το θέσετε σε παραγωγή.
Φανταστείτε να μπορείτε να δείτε γιατί οποιοσδήποτε ταξινομητής έκανε μια πρόβλεψη, ακόμα και για μοντέλα τόσο περίπλοκα όσο νευρωνικά δίκτυα, τυχαία δάση ή SVM με αυθαίρετο πυρήνα. Γίνεται πολύ πιο εύκολο να εμπιστευτείτε μια πρόβλεψη όταν οι λόγοι πίσω από αυτήν είναι ορατοί και εξίσου πιο εύκολο να αποφασίσετε πότε ένα μοντέλο δεν πρέπει να είναι αξιόπιστο. Το LIME σας λέει ποια χαρακτηριστικά οδήγησαν στην απόφαση του ταξινομητή.
Προετοιμασία δεδομένων
Υπάρχουν μερικά πράγματα που πρέπει να αλλάξετε για να εκτελέσετε το LIME με PythonΑρχικά, εγκαταστήστε το lime στο τερματικό με το pip install lime.
Το Lime χρησιμοποιεί ένα αντικείμενο LimeTabularExplainer για να προσεγγίσει το μοντέλο τοπικά. Αυτό το αντικείμενο απαιτεί:
- ένα σύνολο δεδομένων σε μουδιασμένος μορφή
- Το όνομα των χαρακτηριστικών: feature_names
- Το όνομα των κλάσεων: class_names
- Το ευρετήριο της στήλης των κατηγορικών χαρακτηριστικών: categorical_features
- Το όνομα της ομάδας για κάθε κατηγορηματικό χαρακτηριστικό: categorical_names
Δημιουργήστε το σετ τρένων NumPy
Μπορείτε να αντιγράψετε και να μετατρέψετε το df_train από pandas σε NumPy πολύ εύκολα.
df_train.head(5)
# Create numpy data
df_lime = df_train
df_lime.head(3)
Λάβετε το όνομα της τάξης
Η ετικέτα είναι προσβάσιμη μέσω της συνάρτησης unique(). Θα πρέπει να δείτε:
- '<=50 χιλιάδες'
- '>50 χιλιάδες'
# Get the class name
class_names = df_lime.label.unique()
class_names
array(['<=50K', '>50K'], dtype=object)
Ευρετηριάστε τις στήλες κατηγορικών χαρακτηριστικών
Χρησιμοποιήστε τη μέθοδο που μάθατε νωρίτερα για να λάβετε το όνομα κάθε ομάδας. Κωδικοποιείτε την ετικέτα με το LabelEncoder και επαναλαμβάνετε τη λειτουργία σε κάθε κατηγορικό χαρακτηριστικό.
##
import sklearn.preprocessing as preprocessing
categorical_names = {}
for feature in CATE_FEATURES:
    le = preprocessing.LabelEncoder()
    le.fit(df_lime[feature])
    df_lime[feature] = le.transform(df_lime[feature])
    categorical_names[feature] = le.classes_
print(categorical_names)
{'workclass': array(['?', 'Federal-gov', 'Local-gov', 'Never-worked', 'Private',
       'Self-emp-inc', 'Self-emp-not-inc', 'State-gov', 'Without-pay'],
      dtype=object), 'education': array(['10th', '11th', '12th', '1st-4th', '5th-6th', '7th-8th', '9th',
       'Assoc-acdm', 'Assoc-voc', 'Bachelors', 'Doctorate', 'HS-grad',
       'Masters', 'Preschool', 'Prof-school', 'Some-college'],
      dtype=object), 'marital': array(['Divorced', 'Married-AF-spouse', 'Married-civ-spouse',
       'Married-spouse-absent', 'Never-married', 'Separated', 'Widowed'],
      dtype=object), 'occupation': array(['?', 'Adm-clerical', 'Armed-Forces', 'Craft-repair',
       'Exec-managerial', 'Farming-fishing', 'Handlers-cleaners',
       'Machine-op-inspct', 'Other-service', 'Priv-house-serv',
       'Prof-specialty', 'Protective-serv', 'Sales', 'Tech-support',
       'Transport-moving'], dtype=object), 'relationship': array(['Husband', 'Not-in-family', 'Other-relative', 'Own-child',
       'Unmarried', 'Wife'], dtype=object), 'race': array(['Amer-Indian-Eskimo', 'Asian-Pac-Islander', 'Black', 'Other',
       'White'], dtype=object), 'sex': array(['Female', 'Male'], dtype=object), 'native_country': array(['?', 'Cambodia', 'Canada', 'China', 'Columbia', 'Cuba',
       'Dominican-Republic', 'Ecuador', 'El-Salvador', 'England',
       'France', 'Germany', 'Greece', 'Guatemala', 'Haiti', 'Honduras',
       'Hong', 'Hungary', 'India', 'Iran', 'Ireland', 'Italy', 'Jamaica',
       'Japan', 'Laos', 'Mexico', 'Nicaragua',
       'Outlying-US(Guam-USVI-etc)', 'Peru', 'Philippines', 'Poland',
       'Portugal', 'Puerto-Rico', 'Scotland', 'South', 'Taiwan',
       'Thailand', 'Trinadad&Tobago', 'United-States', 'Vietnam',
       'Yugoslavia'], dtype=object)}

df_lime.dtypes
age               float64
workclass           int64
fnlwgt            float64
education           int64
education_num     float64
marital             int64
occupation          int64
relationship        int64
race                int64
sex                 int64
capital_gain      float64
capital_loss      float64
hours_week        float64
native_country      int64
label              object
dtype: object
Τώρα που το σύνολο δεδομένων είναι έτοιμο, μπορείτε να δημιουργήσετε τα διαφορετικά σύνολα δεδομένων που εμφανίζονται στα παραδείγματα εκμάθησης Scikit παρακάτω. Τα δεδομένα μετασχηματίζονται εκτός της αγωγιμότητας εδώ, προκειμένου να αποφευχθούν σφάλματα με το LIME: το σύνολο εκπαίδευσης που διαβιβάζεται στο LimeTabularExplainer πρέπει να είναι ένας πίνακας NumPy χωρίς συμβολοσειρές και η παραπάνω μέθοδος έχει ήδη παράγει έναν.
from sklearn.model_selection import train_test_split
X_train_lime, X_test_lime, y_train_lime, y_test_lime = train_test_split(df_lime[features],
                                                    df_lime.label,
                                                    test_size = 0.2,
                                                    random_state=0)
X_train_lime.head(5)
Μπορείτε να δημιουργήσετε τον αγωγό με τις βέλτιστες παραμέτρους που βρέθηκαν από το XGBoost.
model_xgb = make_pipeline(
    preprocess,
    xgboost.XGBClassifier(max_depth = 3,
                          gamma = 0.5,
                          n_estimators=600,
                          objective='binary:logistic',
                          silent=True,
                          nthread=1))

model_xgb.fit(X_train_lime, y_train_lime)
/Users/Thomas/anaconda3/envs/hello-tf/lib/python3.6/site-packages/sklearn/preprocessing/_encoders.py:351: FutureWarning: The handling of integer data will change in version 0.22. Currently, the categories are determined based on the range [0, max(values)], while in the future they will be determined based on the unique values.
If you want the future behavior and silence this warning, you can specify "categories='auto'."In case you used a LabelEncoder before this OneHotEncoder to convert the categories to integers, then you can now use the OneHotEncoder directly.
  warnings.warn(msg, FutureWarning)
Pipeline(memory=None,
     steps=[('columntransformer', ColumnTransformer(n_jobs=1, remainder='drop', transformer_weights=None,
         transformers=[('standardscaler', StandardScaler(copy=True, with_mean=True, with_std=True), [0, 2, 10, 4, 11, 12]), ('onehotencoder', OneHotEncoder(categorical_features=None, categories=None,...
       reg_alpha=0, reg_lambda=1, scale_pos_weight=1, seed=None,
       silent=True, subsample=1))])
Λαμβάνετε μια προειδοποίηση. Εξηγεί ότι δεν χρειάζεται να δημιουργήσετε έναν κωδικοποιητή ετικετών πριν από τη διοχέτευση. Εάν δεν χρησιμοποιείτε LIME, η μέθοδος από το πρώτο μέρος αυτού του σεμιναρίου Μηχανικής Μάθησης με Scikit-learn είναι μια χαρά. Διαφορετικά, διατηρήστε αυτήν την προσέγγιση: δημιουργήστε πρώτα ένα κωδικοποιημένο σύνολο δεδομένων και, στη συνέχεια, εφαρμόστε τον κωδικοποιητή μίας χρήσης μέσα στη διοχέτευση.
print("best logistic regression from grid search: %f" % model_xgb.score(X_test_lime, y_test_lime))
best logistic regression from grid search: 0.873157
model_xgb.predict_proba(X_test_lime)
array([[7.9646105e-01, 2.0353897e-01],
       [9.5173013e-01, 4.8269872e-02],
       [7.9344827e-01, 2.0655173e-01],
       ...,
       [9.9031430e-01, 9.6856682e-03],
       [6.4581633e-04, 9.9935418e-01],
       [9.7104281e-01, 2.8957171e-02]], dtype=float32)
Πριν θέσετε σε λειτουργία το LIME, δημιουργήστε έναν πίνακα NumPy που περιέχει τα χαρακτηριστικά των λανθασμένα ταξινομημένων γραμμών. Μπορείτε να χρησιμοποιήσετε αυτήν τη λίστα αργότερα για να πάρετε μια ιδέα για το τι παραπλάνησε τον ταξινομητή.
temp = pd.concat([X_test_lime, y_test_lime], axis= 1)
temp['predicted'] = model_xgb.predict(X_test_lime)
temp['wrong']=  temp['label'] != temp['predicted']
temp = temp.query('wrong==True').drop('wrong', axis=1)
temp= temp.sort_values(by=['label'])
temp.shape
(826, 16)
Στη συνέχεια, δημιουργείτε μια συνάρτηση λάμδα που ανακτά την πρόβλεψη από το μοντέλο για νέα δεδομένα. Θα τη χρειαστείτε σύντομα.
predict_fn = lambda x: model_xgb.predict_proba(x).astype(float)
X_test_lime.dtypes
age               float64
workclass           int64
fnlwgt            float64
education           int64
education_num     float64
marital             int64
occupation          int64
relationship        int64
race                int64
sex                 int64
capital_gain      float64
capital_loss      float64
hours_week        float64
native_country      int64
dtype: object
predict_fn(X_test_lime)
array([[7.96461046e-01, 2.03538969e-01],
       [9.51730132e-01, 4.82698716e-02],
       [7.93448269e-01, 2.06551731e-01],
       ...,
       [9.90314305e-01, 9.68566816e-03],
       [6.45816326e-04, 9.99354184e-01],
       [9.71042812e-01, 2.89571714e-02]])
Μετατρέπετε το πλαίσιο δεδομένων pandas σε έναν πίνακα NumPy.
X_train_lime = X_train_lime.values
X_test_lime = X_test_lime.values
X_test_lime
array([[4.00000e+01, 5.00000e+00, 1.93524e+05, ..., 0.00000e+00,
        4.00000e+01, 3.80000e+01],
       [2.70000e+01, 4.00000e+00, 2.16481e+05, ..., 0.00000e+00,
        4.00000e+01, 3.80000e+01],
       [2.50000e+01, 4.00000e+00, 2.56263e+05, ..., 0.00000e+00,
        4.00000e+01, 3.80000e+01],
       ...,
       [2.80000e+01, 6.00000e+00, 2.11032e+05, ..., 0.00000e+00,
        4.00000e+01, 2.50000e+01],
       [4.40000e+01, 4.00000e+00, 1.67005e+05, ..., 0.00000e+00,
        6.00000e+01, 3.80000e+01],
       [5.30000e+01, 4.00000e+00, 2.57940e+05, ..., 0.00000e+00,
        4.00000e+01, 3.80000e+01]])
model_xgb.predict_proba(X_test_lime)
array([[7.9646105e-01, 2.0353897e-01],
       [9.5173013e-01, 4.8269872e-02],
       [7.9344827e-01, 2.0655173e-01],
       ...,
       [9.9031430e-01, 9.6856682e-03],
       [6.4581633e-04, 9.9935418e-01],
       [9.7104281e-01, 2.8957171e-02]], dtype=float32)
print(features,
      class_names,
      categorical_features,
      categorical_names)
['age', 'workclass', 'fnlwgt', 'education', 'education_num', 'marital', 'occupation', 'relationship', 'race', 'sex', 'capital_gain', 'capital_loss', 'hours_week', 'native_country'] ['<=50K' '>50K'] [1, 3, 5, 6, 7, 8, 9, 13] {'workclass': array(['?', 'Federal-gov', 'Local-gov', 'Never-worked', 'Private',
       'Self-emp-inc', 'Self-emp-not-inc', 'State-gov', 'Without-pay'],
      dtype=object), 'education': array(['10th', '11th', '12th', '1st-4th', '5th-6th', '7th-8th', '9th',
       'Assoc-acdm', 'Assoc-voc', 'Bachelors', 'Doctorate', 'HS-grad',
       'Masters', 'Preschool', 'Prof-school', 'Some-college'],
      dtype=object), 'marital': array(['Divorced', 'Married-AF-spouse', 'Married-civ-spouse',
       'Married-spouse-absent', 'Never-married', 'Separated', 'Widowed'],
      dtype=object), 'occupation': array(['?', 'Adm-clerical', 'Armed-Forces', 'Craft-repair',
       'Exec-managerial', 'Farming-fishing', 'Handlers-cleaners',
       'Machine-op-inspct', 'Other-service', 'Priv-house-serv',
       'Prof-specialty', 'Protective-serv', 'Sales', 'Tech-support',
       'Transport-moving'], dtype=object), 'relationship': array(['Husband', 'Not-in-family', 'Other-relative', 'Own-child',
       'Unmarried', 'Wife'], dtype=object), 'race': array(['Amer-Indian-Eskimo', 'Asian-Pac-Islander', 'Black', 'Other',
       'White'], dtype=object), 'sex': array(['Female', 'Male'], dtype=object), 'native_country': array(['?', 'Cambodia', 'Canada', 'China', 'Columbia', 'Cuba',
       'Dominican-Republic', 'Ecuador', 'El-Salvador', 'England',
       'France', 'Germany', 'Greece', 'Guatemala', 'Haiti', 'Honduras',
       'Hong', 'Hungary', 'India', 'Iran', 'Ireland', 'Italy', 'Jamaica',
       'Japan', 'Laos', 'Mexico', 'Nicaragua',
       'Outlying-US(Guam-USVI-etc)', 'Peru', 'Philippines', 'Poland',
       'Portugal', 'Puerto-Rico', 'Scotland', 'South', 'Taiwan',
       'Thailand', 'Trinadad&Tobago', 'United-States', 'Vietnam',
       'Yugoslavia'], dtype=object)}
import lime
import lime.lime_tabular
### Train should be label encoded not one hot encoded
explainer = lime.lime_tabular.LimeTabularExplainer(X_train_lime ,
                                                   feature_names = features,
                                                   class_names=class_names,
                                                   categorical_features=categorical_features,
                                                   categorical_names=categorical_names,
                                                   kernel_width=3)
Τώρα επιλέξτε ένα τυχαίο νοικοκυριό από το σύνολο δοκιμών και δείτε τόσο την πρόβλεψη όσο και τον τρόπο με τον οποίο ο υπολογιστής κατέληξε σε αυτήν.
import numpy as np
np.random.seed(1)
i = 100
print(y_test_lime.iloc[i])
>50K
X_test_lime[i]
array([4.20000e+01, 4.00000e+00, 1.76286e+05, 7.00000e+00, 1.20000e+01,
       2.00000e+00, 4.00000e+00, 0.00000e+00, 4.00000e+00, 1.00000e+00,
       0.00000e+00, 0.00000e+00, 4.00000e+01, 3.80000e+01])
Μπορείτε να χρησιμοποιήσετε τον επεξηγητή με την συνάρτηση explain_instance για να ελέγξετε τη συλλογιστική πίσω από το μοντέλο. Το διάγραμμα που αποδίδει εμφανίζεται παρακάτω.
exp = explainer.explain_instance(X_test_lime[i], predict_fn, num_features=6)
exp.show_in_notebook(show_all=False)

Ο ταξινομητής προέβλεψε σωστά αυτό το νοικοκυριό: το εισόδημα είναι πράγματι πάνω από 50.
Το πρώτο πράγμα που πρέπει να σημειωθεί είναι ότι ο ταξινομητής δεν είναι πολύ σίγουρος για τον εαυτό του. Προβλέπει εισόδημα άνω των 50 με πιθανότητα 64%, και αυτό το 64% καθορίζεται από το κεφαλαιακό κέρδος και την οικογενειακή κατάσταση. Το μπλε χρώμα συμβάλλει αρνητικά στην θετική κατηγορία και η πορτοκαλί γραμμή θετικά.
Ο ταξινομητής διστάζει επειδή το κεφαλαιακό κέρδος αυτού του νοικοκυριού είναι μηδενικό, ενώ το κεφαλαιακό κέρδος είναι συνήθως ένας καλός προγνωστικός δείκτης πλούτου. Το νοικοκυριό εργάζεται επίσης λιγότερες από 40 ώρες την εβδομάδα. Η ηλικία, το επάγγελμα και το φύλο συμβάλλουν θετικά.
Εάν η οικογενειακή κατάσταση ήταν άγαμη, ο ταξινομητής θα είχε προβλέψει εισόδημα κάτω των 50 (0.64 – 0.18 = 0.46).
Τώρα δοκιμάστε ένα άλλο νοικοκυριό, ένα που ταξινομήθηκε λανθασμένα. Ο επεξηγηματικός πίνακας ακολουθεί τον κώδικα.
temp.head(3)
temp.iloc[1,:-2]
age                  58
workclass             4
fnlwgt            68624
education            11
education_num         9
marital               2
occupation            4
relationship          0
race                  4
sex                   1
capital_gain          0
capital_loss          0
hours_week           45
native_country       38
Name: 20931, dtype: object
i = 1
print('This observation is', temp.iloc[i,-2:])
This observation is label        <=50K
predicted     >50K
Name: 20931, dtype: object
exp = explainer.explain_instance(temp.iloc[1,:-2], predict_fn, num_features=6)
exp.show_in_notebook(show_all=False)

Ο ταξινομητής προέβλεψε εισόδημα κάτω των 50, κάτι που είναι λάθος. Αυτό το νοικοκυριό είναι ασυνήθιστο: δεν έχει ούτε κεφαλαιακό κέρδος ούτε κεφαλαιακή ζημία, το άτομο είναι διαζευγμένο, κοντά στα 60 έτη και μορφωμένο, δηλαδή education_num > 12. Ακολουθώντας το συνολικό μοτίβο, ο ταξινομητής τοποθέτησε το νοικοκυριό κάτω των 50.
Παίξε μόνος σου με το LIME και θα παρατηρήσεις πολλά λάθη στον ταξινομητή. Το αποθετήριο GitHub του δημιουργού της βιβλιοθήκης περιέχει επιπλέον τεκμηρίωση για την ταξινόμηση εικόνων και κειμένου.
Αναφορά εντολών Scikit-learn
Παρακάτω είναι μια λίστα με χρήσιμες εντολές που ισχύουν για το scikit-learn έκδοση 0.20 και νεότερες εκδόσεις.
| Έργο | Συνάρτηση ή κλάση |
|---|---|
| Δημιουργήστε το σύνολο δεδομένων τρένου/δοκιμής | train_test_split |
| Φτιάξτε έναν αγωγό | |
| Επιλέξτε τις στήλες και εφαρμόστε τον μετασχηματισμό | μετασχηματιστής_δημιουργίας_στήλης |
| Τύπος μετασχηματισμού | |
| Τυποποιώ | StandardScaler |
| Ελάχιστη-μέγιστη κλιμάκωση | MinMaxScaler |
| Ομαλύνω | Κανονοποιητής |
| Υπολογισμός τιμών που λείπουν | Απλός υπολογιστής |
| Μετατροπή κατηγοριών | OneHotEncoder |
| Προσαρμογή και μετατροπή των δεδομένων | fit_transform |
| Φτιάξτε τον αγωγό | make_pipeline |
| Βασικό μοντέλο | |
| Λογιστική παλινδρόμηση | Λογιστική παλινδρόμηση |
| XGBoost | XGBClassifier |
| Νευρικό δίκτυο | MLPClassifier |
| Αναζήτηση πλέγματος | GridSearchCV |
| Τυχαιοποιημένη αναζήτηση | Τυχαιοποιημένη Αναζήτηση CV |
