
Gaussian Kernel στη Μηχανική Μάθηση: Python Μέθοδοι πυρήνα
 Έβελιν Κλαρκ
⚡ Έξυπνη Σύνοψη
Οι μέθοδοι Gaussian kernel καθιστούν τα μη διαχωρίσιμα δεδομένα γραμμικά διαχωρίσιμα χωρίς ποτέ να δημιουργηθεί ο χάρτης χαρακτηριστικών υψηλής διάστασης. Αυτή η αναλυτική παρουσίαση δείχνει τον χάρτη πολυωνύμων.ping χειροκίνητα, στη συνέχεια εκπαιδεύει έναν τυχαίο ταξινομητή πυρήνα Fourier στο TensorFlow.
Ο σκοπός αυτού του σεμιναρίου είναι να κάνει ένα σύνολο δεδομένων γραμμικά διαχωρίσιμο. Το σεμινάριο χωρίζεται σε δύο μέρη:
- Μεταμόρφωση χαρακτηριστικών
- Εκπαιδεύστε έναν ταξινομητή πυρήνα με το TensorFlow
Στο πρώτο μέρος, θα κατανοήσετε την ιδέα πίσω από μια μέθοδο πυρήνα στη Μηχανική Μάθηση, ενώ στο δεύτερο μέρος θα δείτε πώς να εκπαιδεύσετε έναν ταξινομητή πυρήνα με TensorFlowΘα χρησιμοποιήσετε το σύνολο δεδομένων ενηλίκων. Ο στόχος αυτού του συνόλου δεδομένων είναι να ταξινομήσει τα έσοδα κάτω και πάνω από 50, γνωρίζοντας τη συμπεριφορά κάθε νοικοκυριού.
Γιατί χρειάζεστε τις μεθόδους πυρήνα;
Στόχος κάθε ταξινομητή είναι η σωστή πρόβλεψη των κλάσεων. Για αυτό, το σύνολο δεδομένων θα πρέπει να είναι διαχωρίσιμο. Κοιτάξτε το παρακάτω διάγραμμα. Είναι αρκετά απλό να δούμε ότι όλα τα σημεία πάνω από τη μαύρη γραμμή ανήκουν στην πρώτη κλάση και τα άλλα σημεία στη δεύτερη. Ωστόσο, είναι εξαιρετικά σπάνιο να έχουμε ένα τόσο απλό σύνολο δεδομένων. Στις περισσότερες περιπτώσεις, τα δεδομένα δεν είναι διαχωρίσιμα, και τα δεδομένα που δεν είναι διαχωρίσιμα δυσκολεύουν τους αφελείς ταξινομητές όπως η λογιστική παλινδρόμηση.
import numpy as np
  import matplotlib.pyplot as plt
  from mpl_toolkits.mplot3d import Axes3D
  x_lin = np.array([1,2,3,4,5,6,7,8,9,10])
  y_lin = np.array([2,2,3,2,2,9,6,8,8,9])
  label_lin = np.array([0,0,0,0,0,1,1,1,1,1])

  fig = plt.figure()
  ax=fig.add_subplot(111)
  plt.scatter(x_lin, y_lin, c=label_lin, s=60)
  plt.plot([-2.5, 10], [12.5, -2.5], 'k-', lw=2)
  ax.set_xlim([-5,15])
  ax.set_ylim([-5,15])plt.show()

Στο παρακάτω σχήμα, απεικονίζουμε ένα σύνολο δεδομένων που δεν είναι γραμμικά διαχωρίσιμο. Αν σχεδιάσουμε μια ευθεία γραμμή, τα περισσότερα σημεία δεν θα ταξινομηθούν στη σωστή κατηγορία.
Ένας τρόπος για να αντιμετωπίσετε αυτό το πρόβλημα είναι να πάρετε το σύνολο δεδομένων και να τα μετασχηματίσετε σε έναν άλλο χάρτη χαρακτηριστικών. Αυτό σημαίνει ότι θα χρησιμοποιήσετε μια συνάρτηση για να μετακινήσετε τα δεδομένα σε ένα άλλο επίπεδο, ένα επίπεδο που θα πρέπει να είναι γραμμικά διαχωρίσιμο.
x = np.array([1,1,2,3,3,6,6,6,9,9,10,11,12,13,16,18])
y = np.array([18,13,9,6,15,11,6,3,5,2,10,5,6,1,3,1])
label = np.array([1,1,1,1,0,0,0,1,0,1,0,0,0,1,0,1])
fig = plt.figure()
plt.scatter(x, y, c=label, s=60)
plt.show()
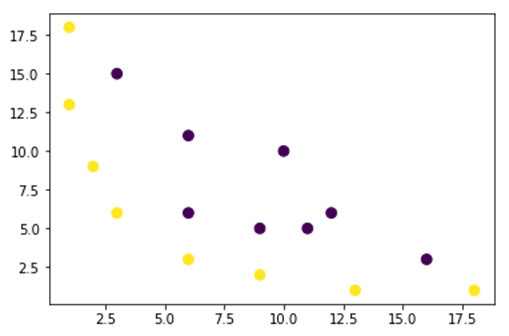
Τα δεδομένα από το παραπάνω σχήμα βρίσκονται σε ένα δισδιάστατο επίπεδο και δεν είναι διαχωρίσιμα. Μπορείτε να δοκιμάσετε να μετατρέψετε αυτά τα δεδομένα σε τρεις διαστάσεις, πράγμα που σημαίνει ότι δημιουργείτε ένα σχήμα με 3 άξονες.
Στο παράδειγμα Gaussian Kernel, θα εφαρμόσουμε έναν πολυωνυμικό χάρτηping για να φέρουμε τα δεδομένα μας σε μια τρίτη διάσταση. Ο τύπος για τον μετασχηματισμό των δεδομένων έχει ως εξής.

Ορίζετε μια συνάρτηση στον πυρήνα του Gauss Python για να δημιουργήσετε τους νέους χάρτες χαρακτηριστικών.
Μπορείς να χρησιμοποιήσεις μουδιασμένος για να κωδικοποιήσετε τον παραπάνω τύπο. Κάθε γραμμή παρακάτω συνδυάζει έναν όρο του χάρτηping με την παράσταση πίνακα που την παράγει, και η μικρή εικόνα σηματοδοτεί την τετραγωνική ρίζα του παράγοντα δύο.
| Τύπος | Ισοδύναμος κωδικός NumPy |
|---|---|
| x | x[:,0] |
| y | x[:,1] |
| x² | x[:,0]**2 |
 |
np.sqrt(2)* |
| xy | x[:,0]*x[:,1] |
| y² | x[:,1]**2 |
### illustration purpose
def mapping(x, y):
	x = np.c_[(x, y)]
    if len(x) >	2:
    	x_1 = x[:,0]**2
        x_2 = np.sqrt(2)*x[:,0]*x[:,1]
        x_3 = x[:,1]**2
    else:
    	x_1 = x[0]**2
        x_2 = np.sqrt(2)*x[0]*x[1]
        x_3 = x[1]**2
   trans_x = np.array([x_1, x_2, x_3])
   return trans_x
Ο νέος χάρτηςping έχει 3 διαστάσεις και 16 σημεία.
x_1  = mapping(x, y)
x_1.shape
(3, 16)
Τώρα φτιάξτε ένα νέο διάγραμμα με 3 άξονες, x, y και z αντίστοιχα.
# plot
fig = plt.figure()
ax = fig.add_subplot(111, projection='3d')
ax.scatter(x_1[0], x_1[1], x_1[2], c=label, s=60)
ax.view_init(30, 185)ax.set_xlabel('X Label')
ax.set_ylabel('Y Label')
ax.set_zlabel('Z Label')
plt.show()

Βλέπουμε μια βελτίωση, αλλά αν αλλάξουμε τον προσανατολισμό του γραφήματος γίνεται σαφές ότι το σύνολο δεδομένων είναι πλέον διαχωρίσιμο.
# plot
fig = plt.figure()
ax = fig.add_subplot(111, projection='3d')
ax.scatter(x_1[0], x_1[1], x_1[1], c=label, s=60)
ax.view_init(0, -180)ax.set_ylim([150,-50])
ax.set_zlim([-10000,10000])
ax.set_xlabel('X Label')
ax.set_ylabel('Y Label')
ax.set_zlabel('Z Label')plt.show()

Αν πρέπει να χειριστείτε ένα μεγάλο σύνολο δεδομένων και να δημιουργήσετε περισσότερες από 2 διαστάσεις, θα αντιμετωπίσετε ένα μεγάλο πρόβλημα με την παραπάνω μέθοδο. Στην πραγματικότητα, πρέπει να μετασχηματίσετε όλα τα σημεία δεδομένων, κάτι που σαφώς δεν είναι βιώσιμο. Θα σας πάρει πολύ χρόνο και ο υπολογιστής σας μπορεί να ξεμείνει από μνήμη.
Ο πιο συνηθισμένος τρόπος για να ξεπεραστεί αυτό το πρόβλημα είναι η χρήση ενός πυρήνα.
Τι είναι ο πυρήνας στη μηχανική εκμάθηση;
Η ιδέα είναι να χρησιμοποιηθεί ένας χώρος χαρακτηριστικών υψηλότερης διάστασης για να γίνουν τα δεδομένα σχεδόν γραμμικά διαχωρίσιμα, όπως φαίνεται στο παραπάνω σχήμα.
Υπάρχουν πολλοί χώροι υψηλότερης διάστασης που καθιστούν τα σημεία δεδομένων διαχωρίσιμα. Για παράδειγμα, έχουμε δείξει ότι ο πολυωνυμικός χάρτηςping είναι μια υπέροχη αρχή.
Έχουμε επίσης δείξει ότι με πολλά δεδομένα, αυτοί οι μετασχηματισμοί δεν είναι αποτελεσματικοί. Αντίθετα, μπορείτε να χρησιμοποιήσετε μια συνάρτηση πυρήνα στη Μηχανική Μάθηση για να τροποποιήσετε τα δεδομένα χωρίς να μετακινηθείτε σε ένα νέο επίπεδο χαρακτηριστικών.
Η μαγεία του πυρήνα έγκειται στην εύρεση μιας συνάρτησης που αποφεύγει όλα τα προβλήματα που συνεπάγεται ο υπολογισμός υψηλών διαστάσεων. Το αποτέλεσμα ενός πυρήνα είναι μια βαθμωτή τιμή, ή αλλιώς, επιστρέφουμε στον μονοδιάστατο χώρο.
Αφού βρείτε αυτήν τη συνάρτηση, μπορείτε να την συνδέσετε στον τυπικό γραμμικό ταξινομητή.
Ακολουθεί ένα παράδειγμα που καθιστά την έννοια της Μηχανικής Μάθησης Πυρήνα συγκεκριμένη. Έχετε δύο διανύσματα, x1 και x2. Ο στόχος είναι να δημιουργήσετε μια υψηλότερη διάσταση χρησιμοποιώντας έναν πολυωνυμικό χάρτη.pingΗ έξοδος ισούται με το γινόμενο των κουκκίδων του νέου χάρτη χαρακτηριστικών. Από την παραπάνω μέθοδο, πρέπει να:
- Μετατρέψτε τα x1 και x2 σε μια νέα διάσταση
- Υπολογίστε το γινόμενο κουκίδων: κοινό για όλους τους πυρήνες
Μετατρέψτε τα x1 και x2 σε μια νέα διάσταση
Μπορείτε να χρησιμοποιήσετε τη συνάρτηση που δημιουργήθηκε παραπάνω για να υπολογίσετε την υψηλότερη διάσταση.
## Kernel
x1 = np.array([3,6])
x2 = np.array([10,10])

x_1 = mapping(x1, x2)
print(x_1)
Παραγωγή
[[  9.         100.        ]
      [ 25.45584412 141.42135624]
      [ 36.         100.        ]]
Υπολογίστε το γινόμενο με τελείες
Μπορείτε να χρησιμοποιήσετε την κουκκίδα αντικειμένου από μουδιασμένος για να υπολογίσετε το ακιδωτό γινόμενο μεταξύ του πρώτου και του δεύτερου διανύσματος που είναι αποθηκευμένο στο x_1.
print(np.dot(x_1[:,0], x_1[:,1]))
8100.0
Η έξοδος είναι 8100. Βλέπετε το πρόβλημα: πρέπει να αποθηκεύσετε έναν νέο χάρτη χαρακτηριστικών στη μνήμη για να υπολογίσετε το τελικό γινόμενο. Εάν έχετε ένα σύνολο δεδομένων με εκατομμύρια εγγραφές, είναι υπολογιστικά αναποτελεσματικό.
Αντ' αυτού, μπορείτε να χρησιμοποιήσετε τον πυρήνα πολυωνύμου για να υπολογίσετε το τετράγωνο γινόμενο χωρίς να μετασχηματίσετε το διάνυσμα. Αυτή η συνάρτηση υπολογίζει το τετράγωνο γινόμενο των x1 και x2 σαν αυτά τα δύο διανύσματα να είχαν μετασχηματιστεί στην ανώτερη διάσταση. Με άλλα λόγια, μια συνάρτηση πυρήνα υπολογίζει το αποτέλεσμα του τετράγωνου γινομένου από έναν άλλο χώρο χαρακτηριστικών.
Μπορείτε να γράψετε τη συνάρτηση πολυωνυμικού πυρήνα μέσα Python ως εξής.
def polynomial_kernel(x, y, p=2):
	return (np.dot(x, y)) ** p
Είναι η ισχύς του γινόμενου κουκίδων δύο διανυσμάτων. Παρακάτω, επιστρέφετε τον δεύτερο βαθμό του πολυωνυμικού πυρήνα. Η έξοδος είναι ίση με την άλλη μέθοδο. Αυτή είναι η μαγεία του πυρήνα.
polynomial_kernel(x1, x2, p=2)
8100
Τύποι μεθόδων πυρήνα
Υπάρχουν πολλές διαφορετικές τεχνικές πυρήνα διαθέσιμες. Η πιο απλή είναι ο γραμμικός πυρήνας. Αυτή η συνάρτηση λειτουργεί αρκετά καλά για την ταξινόμηση κειμένου. Οι άλλοι πυρήνες είναι:
- Πολυωνυμικός πυρήνας
- Gaussian Kernel
Ο παρακάτω πίνακας συνοψίζει τι κάνει το καθένα και πότε οι επαγγελματίες το επιλέγουν.
| Πυρήνας | Τι υπολογίζει | Τυπική χρήση |
|---|---|---|
| Γραμμικός | Το απλό γινόμενο κουκκίδων στον αρχικό χώρο χαρακτηριστικών | Ήδη διαχωρίσιμα δεδομένα και χαρακτηριστικά κειμένου υψηλής διάστασης |
| Πολυώνυμος | Το γινόμενο των κουκκίδων ανυψωμένο σε βαθμό p, καταγράφοντας τις αλληλεπιδράσεις των χαρακτηριστικών | Καμπύλα όρια όταν οι αλληλεπιδράσεις είναι γνωστό ότι έχουν σημασία |
| Γκαουσιανή (RBF) | Μια ομοιότητα που βασίζεται στην απόσταση και η οποία μειώνεται προς το μηδέν καθώς τα σημεία απομακρύνονται | Η συνήθης πρώτη επιλογή όταν το σχήμα των ορίων είναι άγνωστο |
Στο παράδειγμα με το TensorFlow, θα χρησιμοποιήσουμε τυχαία χαρακτηριστικά Fourier. Το TensorFlow έχει έναν ενσωματωμένο εκτιμητή για τον υπολογισμό του νέου χώρου χαρακτηριστικών. Ο τυχαίος χαρτογράφος χαρακτηριστικών Fourier είναι μια προσέγγιση της συνάρτησης πυρήνα Gauss που φαίνεται παρακάτω.

Η συνάρτηση φιλτραρίσματος Gauss υπολογίζει την ομοιότητα μεταξύ των σημείων δεδομένων σε ένα χώρο πολύ υψηλότερων διαστάσεων.
Αφού η θεωρία έχει εδραιωθεί, το υπόλοιπο αυτής της αναλυτικής παρουσίασης θέτει έναν Γκαουσιανό πυρήνα σε λειτουργία σε ένα πραγματικό σύνολο δεδομένων.
Εκπαιδεύστε τον ταξινομητή Gaussian Kernel με το TensorFlow
Ο στόχος του αλγορίθμου είναι να ταξινομήσει το νοικοκυριό που κερδίζει περισσότερα ή λιγότερα από 50 χιλιάδες.
Αρχικά, θα αξιολογήσετε μια λογιστική παλινδρόμηση για να έχετε ένα μοντέλο αναφοράς. Στη συνέχεια, θα εκπαιδεύσετε έναν ταξινομητή πυρήνα για να δείτε αν μπορείτε να έχετε καλύτερα αποτελέσματα.
Χρησιμοποιείτε τις ακόλουθες μεταβλητές από το σύνολο δεδομένων για ενήλικες:
- την ηλικία του
- τάξη εργασίας
- fnlwgt
- εκπαίδευση
- εκπαίδευση_αριθμ
- συζυγικός
- επάγγελμα
- σχέση
- αγώνας
- φύλο
- κεφαλαιακό κέρδος
- απώλεια_κεφαλαίου
- ώρες_εβδομάδα
- χώρα ιθαγένειας
- επιγραφή
Θα προχωρήσετε ως εξής πριν από την εκπαίδευση και την αξιολόγηση του μοντέλου:
- Εισαγάγετε τις βιβλιοθήκες
- Εισαγάγετε τα δεδομένα
- Προετοιμάστε τα δεδομένα
- Κατασκευάστε το λογιστικό μοντέλο: βασικό μοντέλο
- Αξιολογήστε το μοντέλο
- Κατασκευάστε και αξιολογήστε τον ταξινομητή πυρήνα
Σημείωση έκδοσης: Κάθε τμήμα κώδικα παρακάτω στοχεύει στο TensorFlow 1.x. Ο χώρος ονομάτων tf.contrib, ο οποίος παρέχει τα real_valued_column, RandomFourierFeatureMapper και KernelLinearClassifier, αφαιρέθηκε στο TensorFlow 2.0 και το ίδιο το tf.estimator αφαιρέθηκε στο TensorFlow 2.16. Σε μια τρέχουσα έκδοση, δημιουργήστε τον ίδιο αγωγό με το επίπεδο tf.keras.layers.experimental.RandomFourierFeatures ακολουθούμενο από ένα επίπεδο εξόδου Dense ή με το ζεύγος RBFSampler και SGDClassifier από το scikit-learn.
Βήμα 1) Εισαγάγετε τις βιβλιοθήκες
Για εισαγωγή και εκπαίδευση μοντέλων πυρήνα Τεχνητή νοημοσύνη, πρέπει να εισαγάγετε το TensorFlow, Πάντα και NumPy.
#import numpy as np
from sklearn.model_selection
import train_test_split
import tensorflow as tf
import pandas as pd
import numpy as np
Βήμα 2) Εισαγάγετε τα δεδομένα
Κατεβάζετε τα δεδομένα από το Σελίδα συνόλου δεδομένων ενηλίκων UCI και εισαγάγετέ το ως pandas DataFrame.
## Define path data
COLUMNS = ['age','workclass', 'fnlwgt', 'education', 'education_num', 'marital', 'occupation', 'relationship', 'race', 'sex', 'capital_gain', 'capital_loss', 'hours_week', 'native_country', 'label']
PATH = "https://archive.ics.uci.edu/ml/machine-learning-databases/adult/adult.data"
PATH_test ="https://archive.ics.uci.edu/ml/machine-learning-databases/adult/adult.test
"## Import
df_train = pd.read_csv(PATH, skipinitialspace=True, names = COLUMNS, index_col=False)
df_test = pd.read_csv(PATH_test,skiprows = 1, skipinitialspace=True, names = COLUMNS, index_col=False)
Τώρα που η ακολουθία και το σύνολο δοκιμών έχουν οριστεί, μπορείτε να αλλάξετε την ετικέτα της στήλης από συμβολοσειρά σε ακέραιο. Το TensorFlow δεν δέχεται τιμές συμβολοσειράς για την ετικέτα.
label = {'<=50K': 0,'>50K': 1}
df_train.label = [label[item] for item in df_train.label]
label_t = {'<=50K.': 0,'>50K.': 1}
df_test.label = [label_t[item] for item in df_test.label]
df_train.shape
(32561, 15)
Βήμα 3) Προετοιμάστε τα δεδομένα
Το σύνολο δεδομένων περιέχει συνεχή και κατηγορικά χαρακτηριστικά. Μια καλή πρακτική είναι η τυποποίηση των τιμών των συνεχών μεταβλητών. Μπορείτε να χρησιμοποιήσετε τη συνάρτηση StandardScaler από scikit-μάθετεΔημιουργείτε επίσης μια συνάρτηση οριζόμενη από τον χρήστη για να διευκολύνετε τη μετατροπή της συνάρτησης τρένου και του συνόλου δοκιμών. Σημειώστε ότι συνενώνετε τις συνεχείς και κατηγορικές μεταβλητές σε ένα κοινό σύνολο δεδομένων και ο πίνακας πρέπει να είναι τύπου float32.
COLUMNS_INT = ['age','fnlwgt','education_num','capital_gain', 'capital_loss', 'hours_week']
CATE_FEATURES = ['workclass', 'education', 'marital', 'occupation', 'relationship', 'race', 'sex', 'native_country']
from sklearn.preprocessing import StandardScaler
from sklearn import preprocessing

def prep_data_str(df):
	scaler = StandardScaler()
    le = preprocessing.LabelEncoder()
    df_toscale = df[COLUMNS_INT]
    df_scaled = scaler.fit_transform(df_toscale.astype(np.float64))
    X_1 = df[CATE_FEATURES].apply(le.fit_transform)
    y = df['label'].astype(np.int32)
    X_conc = np.c_[df_scaled, X_1].astype(np.float32)
    return X_conc, y
Η συνάρτηση μετασχηματιστή είναι έτοιμη, επομένως μπορείτε να μετατρέψετε το σύνολο δεδομένων και να δημιουργήσετε τη συνάρτηση input_fn.
X_train, y_train = prep_data_str(df_train)
X_test, y_test = prep_data_str(df_test)
print(X_train.shape)
(32561, 14)
Στο επόμενο βήμα, θα εκπαιδεύσετε μια λογιστική παλινδρόμηση. Θα σας δώσει μια βασική ακρίβεια. Ο στόχος είναι να νικήσουμε τη γραμμή βάσης με έναν διαφορετικό αλγόριθμο, δηλαδή έναν ταξινομητή πυρήνα.
Βήμα 4) Κατασκευάστε το λογιστικό μοντέλο: Μοντέλο βάσης
Κατασκευάζετε τη στήλη χαρακτηριστικών με το αντικείμενο real_valued_column. Θα διασφαλίσει ότι όλες οι μεταβλητές είναι πυκνά αριθμητικά δεδομένα.
feat_column = tf.contrib.layers.real_valued_column('features', dimension=14)
Ο εκτιμητής ορίζεται χρησιμοποιώντας το API TensorFlow Estimator. Εσείς παρέχετε τις στήλες χαρακτηριστικών και πού θα αποθηκευτεί το γράφημα.
estimator = tf.estimator.LinearClassifier(feature_columns=[feat_column],
                                          n_classes=2,
                                          model_dir = "kernel_log"
                                         )
INFO:tensorflow:Using default config.INFO:tensorflow:Using config: {'_model_dir': 'kernel_log', '_tf_random_seed': None, '_save_summary_steps': 100, '_save_checkpoints_steps': None, '_save_checkpoints_secs': 600, '_session_config': None, '_keep_checkpoint_max': 5, '_keep_checkpoint_every_n_hours': 10000, '_log_step_count_steps': 100, '_train_distribute': None, '_service': None, '_cluster_spec': <tensorflow.python.training.server_lib.ClusterSpec object at 0x1a2003f780>, '_task_type': 'worker', '_task_id': 0, '_global_id_in_cluster': 0, '_master': '', '_evaluation_master': '', '_is_chief': True, '_num_ps_replicas': 0, '_num_worker_replicas': 1}
Θα εκπαιδεύσετε την λογιστική παλινδρόμηση χρησιμοποιώντας μίνι-παρτίδες μεγέθους 200.
# Train the model
train_input_fn = tf.estimator.inputs.numpy_input_fn(
	x={"features": X_train},
    y=y_train,
    batch_size=200,
    num_epochs=None,
    shuffle=True)
Μπορείτε να εκπαιδεύσετε το μοντέλο με 1,000 επαναλήψεις.
estimator.train(input_fn=train_input_fn, steps=1000)
INFO:tensorflow:Calling model_fn.
INFO:tensorflow:Done calling model_fn.
INFO:tensorflow:Create CheckpointSaverHook.
INFO:tensorflow:Graph was finalized.
INFO:tensorflow:Running local_init_op.
INFO:tensorflow:Done running local_init_op.
INFO:tensorflow:Saving checkpoints for 1 into kernel_log/model.ckpt.
INFO:tensorflow:loss = 138.62949, step = 1
INFO:tensorflow:global_step/sec: 324.16
INFO:tensorflow:loss = 87.16762, step = 101 (0.310 sec)
INFO:tensorflow:global_step/sec: 267.092
INFO:tensorflow:loss = 71.53657, step = 201 (0.376 sec)
INFO:tensorflow:global_step/sec: 292.679
INFO:tensorflow:loss = 69.56703, step = 301 (0.340 sec)
INFO:tensorflow:global_step/sec: 225.582
INFO:tensorflow:loss = 74.615875, step = 401 (0.445 sec)
INFO:tensorflow:global_step/sec: 209.975
INFO:tensorflow:loss = 76.49044, step = 501 (0.475 sec)
INFO:tensorflow:global_step/sec: 241.648
INFO:tensorflow:loss = 66.38373, step = 601 (0.419 sec)
INFO:tensorflow:global_step/sec: 305.193
INFO:tensorflow:loss = 87.93341, step = 701 (0.327 sec)
INFO:tensorflow:global_step/sec: 396.295
INFO:tensorflow:loss = 76.61518, step = 801 (0.249 sec)
INFO:tensorflow:global_step/sec: 359.857
INFO:tensorflow:loss = 78.54885, step = 901 (0.277 sec)
INFO:tensorflow:Saving checkpoints for 1000 into kernel_log/model.ckpt.
INFO:tensorflow:Loss for final step: 67.79706.


<tensorflow.python.estimator.canned.linear.LinearClassifier at 0x1a1fa3cbe0>
Βήμα 5) Αξιολογήστε το μοντέλο
Ορίζετε τη συνάρτηση εισόδου NumPy για να αξιολογήσετε το μοντέλο. Χρησιμοποιείτε ολόκληρο το σύνολο δοκιμών για την αξιολόγηση.
# Evaluation
test_input_fn = tf.estimator.inputs.numpy_input_fn(
    x={"features": X_test},
    y=y_test,
    batch_size=16281,
    num_epochs=1,
    shuffle=False)
estimator.evaluate(input_fn=test_input_fn, steps=1)
INFO:tensorflow:Calling model_fn.
WARNING:tensorflow:Trapezoidal rule is known to produce incorrect PR-AUCs; please switch to "careful_interpolation" instead.
WARNING:tensorflow:Trapezoidal rule is known to produce incorrect PR-AUCs; please switch to "careful_interpolation" instead.
INFO:tensorflow:Done calling model_fn.
INFO:tensorflow:Starting evaluation at 2018-07-12-15:58:22
INFO:tensorflow:Graph was finalized.
INFO:tensorflow:Restoring parameters from kernel_log/model.ckpt-1000
INFO:tensorflow:Running local_init_op.
INFO:tensorflow:Done running local_init_op.
INFO:tensorflow:Evaluation [1/1]
INFO:tensorflow:Finished evaluation at 2018-07-12-15:58:23
INFO:tensorflow:Saving dict for global step 1000: accuracy = 0.82353663, accuracy_baseline = 0.76377374, auc = 0.84898686, auc_precision_recall = 0.67214864, average_loss = 0.3877216, global_step = 1000, label/mean = 0.23622628, loss = 6312.495, precision = 0.7362797, prediction/mean = 0.21208474, recall = 0.39417577
{'accuracy': 0.82353663,
 'accuracy_baseline': 0.76377374,
 'auc': 0.84898686,
 'auc_precision_recall': 0.67214864,
 'average_loss': 0.3877216,
 'global_step': 1000,
 'label/mean': 0.23622628,
 'loss': 6312.495,
 'precision': 0.7362797,
 'prediction/mean': 0.21208474,
 'recall': 0.39417577}
Έχετε ακρίβεια 82%. Στην επόμενη ενότητα, θα προσπαθήσετε να ξεπεράσετε τον λογιστικό ταξινομητή με έναν ταξινομητή πυρήνα.
Βήμα 6) Κατασκευάστε τον ταξινομητή πυρήνα
Ο εκτιμητής πυρήνα δεν διαφέρει τόσο πολύ από τον παραδοσιακό γραμμικό ταξινομητή, τουλάχιστον όσον αφορά την κατασκευή. Η ιδέα πίσω από αυτόν είναι να συνδυάσει τη δύναμη ενός σαφούς χάρτη πυρήνα.ping με τον γραμμικό ταξινομητή.
Χρειάζεστε δύο προκαθορισμένους εκτιμητές διαθέσιμους στο TensorFlow για να εκπαιδεύσετε τον ταξινομητή πυρήνα:
- RandomFourierFeatureMapper
- KernelLinearClassifier
Στην πρώτη ενότητα μάθατε ότι πρέπει να μετασχηματίσετε τη χαμηλή διάσταση σε υψηλή χρησιμοποιώντας μια συνάρτηση πυρήνα. Πιο συγκεκριμένα, θα χρησιμοποιήσετε τυχαία χαρακτηριστικά Fourier, τα οποία προσεγγίζουν τη Γκαουσιανή συνάρτηση. Το TensorFlow 1.x παρέχει αυτήν την αντιστοίχισηping ως RandomFourierFeatureMapper, και το μοντέλο μπορεί να εκπαιδευτεί χρησιμοποιώντας τον εκτιμητή KernelLinearClassifier.
Για να δημιουργήσετε το μοντέλο, θα ακολουθήσετε τα εξής βήματα:
- Ρυθμίστε τη συνάρτηση πυρήνα υψηλής διάστασης
- Ορίστε την υπερπαράμετρο L2
- Δημιουργήστε το μοντέλο
- Εκπαιδεύστε το μοντέλο
- Αξιολογήστε το μοντέλο
Βήμα Α) Ορίστε τη συνάρτηση πυρήνα υψηλής διάστασης
Το τρέχον σύνολο δεδομένων περιέχει 14 χαρακτηριστικά που θα μετασχηματίσετε σε ένα νέο διάνυσμα 5,000 διαστάσεων. Χρησιμοποιείτε τα τυχαία χαρακτηριστικά Fourier για να επιτύχετε τον μετασχηματισμό. Αν θυμάστε τον τύπο Gaussian Kernel, παρατηρείτε ότι υπάρχει μια παράμετρος τυπικής απόκλισης που πρέπει να οριστεί. Αυτή η παράμετρος ελέγχει το μέτρο ομοιότητας που χρησιμοποιείται κατά την ταξινόμηση: μια μικρή τυπική απόκλιση κάνει τον πυρήνα να αντιμετωπίζει μόνο πολύ κοντινά σημεία ως παρόμοια, ενώ μια μεγάλη εξομαλύνει το όριο απόφασης.
Μπορείτε να συντονίσετε όλες τις παραμέτρους στο RandomFourierFeatureMapper με:
- input_dim = 14
- output_dim = 5000
- τυπική απόκλιση = 4
### Prep Kernel
kernel_mapper = tf.contrib.kernel_methods.RandomFourierFeatureMapper(input_dim=14, output_dim=5000, stddev=4, name='rffm')
Πρέπει να κατασκευάσετε τον αντιστοιχιστή πυρήνα χρησιμοποιώντας τις στήλες χαρακτηριστικών που δημιουργήθηκαν πριν: feat_column
### Map Kernel
kernel_mappers = {feat_column: [kernel_mapper]}
Βήμα Β) Ορισμός της υπερπαραμέτρου L2
Για να αποτρέψετε την υπερπροσαρμογή, τιμωρείτε τη συνάρτηση απώλειας με τον κανονικοποιητή L2. Ορίζετε την υπερπαράμετρο L2 σε 0.1 και τον ρυθμό εκμάθησης σε 5.
optimizer = tf.train.FtrlOptimizer(learning_rate=5, l2_regularization_strength=0.1)
Βήμα Γ) Κατασκευάστε το μοντέλο
Το επόμενο βήμα είναι παρόμοιο με τη γραμμική ταξινόμηση. Χρησιμοποιείτε τον ενσωματωμένο εκτιμητή KernelLinearClassifier. Σημειώστε ότι προσθέτετε τον mapper πυρήνα που ορίστηκε προηγουμένως και αλλάζετε τον κατάλογο μοντέλου.
### Prep estimator
estimator_kernel = tf.contrib.kernel_methods.KernelLinearClassifier(
    n_classes=2,
    optimizer=optimizer,
    kernel_mappers=kernel_mappers,
    model_dir="kernel_train")
Οι παρακάτω προειδοποιήσεις κατάργησης αναμένονται στο TensorFlow 1.x, επειδή η ενότητα kernel_methods βασίζεται στους παλαιότερους εκτιμητές tf.contrib.learn.
WARNING:tensorflow:From /Users/Thomas/anaconda3/envs/hello-tf/lib/python3.6/site-packages/tensorflow/contrib/kernel_methods/python/kernel_estimators.py:305: multi_class_head (from tensorflow.contrib.learn.python.learn.estimators.head) is deprecated and will be removed in a future version. Instructions for updating: Please switch to tf.contrib.estimator.*_head. WARNING:tensorflow:From /Users/Thomas/anaconda3/envs/hello-tf/lib/python3.6/site-packages/tensorflow/contrib/learn/python/learn/estimators/estimator.py:1179: BaseEstimator.__init__ (from tensorflow.contrib.learn.python.learn.estimators.estimator) is deprecated and will be removed in a future version. Instructions for updating: Please replace uses of any Estimator from tf.contrib.learn with an Estimator from tf.estimator.* WARNING:tensorflow:From /Users/Thomas/anaconda3/envs/hello-tf/lib/python3.6/site-packages/tensorflow/contrib/learn/python/learn/estimators/estimator.py:427: RunConfig.__init__ (from tensorflow.contrib.learn.python.learn.estimators.run_config) is deprecated and will be removed in a future version. Instructions for updating: When switching to tf.estimator.Estimator, use tf.estimator.RunConfig instead. INFO:tensorflow:Using default config. INFO:tensorflow:Using config: {'_task_type': None, '_task_id': 0, '_cluster_spec': <tensorflow.python.training.server_lib.ClusterSpec object at 0x1a200ae550>, '_master': '', '_num_ps_replicas': 0, '_num_worker_replicas': 0, '_environment': 'local', '_is_chief': True, '_evaluation_master': '', '_train_distribute': None, '_tf_config': gpu_options { per_process_gpu_memory_fraction: 1.0 } , '_tf_random_seed': None, '_save_summary_steps': 100, '_save_checkpoints_secs': 600, '_log_step_count_steps': 100, '_session_config': None, '_save_checkpoints_steps': None, '_keep_checkpoint_max': 5, '_keep_checkpoint_every_n_hours': 10000, '_model_dir': 'kernel_train'}
Βήμα Δ) Εκπαίδευση του μοντέλου
Τώρα που ο ταξινομητής πυρήνα έχει δημιουργηθεί, είστε έτοιμοι να τον εκπαιδεύσετε. Επιλέγετε να επαναλάβετε το μοντέλο 2,000 φορές.
### estimate
estimator_kernel.fit(input_fn=train_input_fn, steps=2000)
WARNING:tensorflow:Casting <dtype: 'int32'> labels to bool. WARNING:tensorflow:Casting <dtype: 'int32'> labels to bool. WARNING:tensorflow:Trapezoidal rule is known to produce incorrect PR-AUCs; please switch to "careful_interpolation" instead. WARNING:tensorflow:Trapezoidal rule is known to produce incorrect PR-AUCs; please switch to "careful_interpolation" instead. WARNING:tensorflow:From /Users/Thomas/anaconda3/envs/hello-tf/lib/python3.6/site-packages/tensorflow/contrib/learn/python/learn/estimators/head.py:678: ModelFnOps.__new__ (from tensorflow.contrib.learn.python.learn.estimators.model_fn) is deprecated and will be removed in a future version. Instructions for updating: When switching to tf.estimator.Estimator, use tf.estimator.EstimatorSpec. You can use the `estimator_spec` method to create an equivalent one. INFO:tensorflow:Create CheckpointSaverHook. INFO:tensorflow:Graph was finalized. INFO:tensorflow:Running local_init_op. INFO:tensorflow:Done running local_init_op. INFO:tensorflow:Saving checkpoints for 1 into kernel_train/model.ckpt. INFO:tensorflow:loss = 0.6931474, step = 1 INFO:tensorflow:global_step/sec: 86.6365 INFO:tensorflow:loss = 0.39374447, step = 101 (1.155 sec) INFO:tensorflow:global_step/sec: 80.1986 INFO:tensorflow:loss = 0.3797774, step = 201 (1.247 sec) INFO:tensorflow:global_step/sec: 79.6376 INFO:tensorflow:loss = 0.3908726, step = 301 (1.256 sec) INFO:tensorflow:global_step/sec: 95.8442 INFO:tensorflow:loss = 0.41890752, step = 401 (1.043 sec) INFO:tensorflow:global_step/sec: 93.7799 INFO:tensorflow:loss = 0.35700393, step = 501 (1.066 sec) INFO:tensorflow:global_step/sec: 94.7071 INFO:tensorflow:loss = 0.35535482, step = 601 (1.056 sec) INFO:tensorflow:global_step/sec: 90.7402 INFO:tensorflow:loss = 0.3692882, step = 701 (1.102 sec) INFO:tensorflow:global_step/sec: 94.4924 INFO:tensorflow:loss = 0.34746957, step = 801 (1.058 sec) INFO:tensorflow:global_step/sec: 95.3472 INFO:tensorflow:loss = 0.33655524, step = 901 (1.049 sec) INFO:tensorflow:global_step/sec: 97.2928 INFO:tensorflow:loss = 0.35966292, step = 1001 (1.028 sec) INFO:tensorflow:global_step/sec: 85.6761 INFO:tensorflow:loss = 0.31254214, step = 1101 (1.167 sec) INFO:tensorflow:global_step/sec: 91.4194 INFO:tensorflow:loss = 0.33247527, step = 1201 (1.094 sec) INFO:tensorflow:global_step/sec: 82.5954 INFO:tensorflow:loss = 0.29305756, step = 1301 (1.211 sec) INFO:tensorflow:global_step/sec: 89.8748 INFO:tensorflow:loss = 0.37943482, step = 1401 (1.113 sec) INFO:tensorflow:global_step/sec: 76.9761 INFO:tensorflow:loss = 0.34204718, step = 1501 (1.300 sec) INFO:tensorflow:global_step/sec: 73.7192 INFO:tensorflow:loss = 0.34614792, step = 1601 (1.356 sec) INFO:tensorflow:global_step/sec: 83.0573 INFO:tensorflow:loss = 0.38911164, step = 1701 (1.204 sec) INFO:tensorflow:global_step/sec: 71.7029 INFO:tensorflow:loss = 0.35255936, step = 1801 (1.394 sec) INFO:tensorflow:global_step/sec: 73.2663 INFO:tensorflow:loss = 0.31130585, step = 1901 (1.365 sec) INFO:tensorflow:Saving checkpoints for 2000 into kernel_train/model.ckpt. INFO:tensorflow:Loss for final step: 0.37795097. KernelLinearClassifier(params={'head': <tensorflow.contrib.learn.python.learn.estimators.head._BinaryLogisticHead object at 0x1a2054cd30>, 'feature_columns': {_RealValuedColumn(column_name='features_MAPPED', dimension=5000, default_value=None, dtype=tf.float32, normalizer=None)}, 'optimizer': <tensorflow.python.training.ftrl.FtrlOptimizer object at 0x1a200aec18>, 'kernel_mappers': {_RealValuedColumn(column_name='features', dimension=14, default_value=None, dtype=tf.float32, normalizer=None): [<tensorflow.contrib.kernel_methods.python.mappers.random_fourier_features.RandomFourierFeatureMapper object at 0x1a200ae400>]}})
Βήμα Ε) Αξιολόγηση του μοντέλου
Τελευταίο αλλά όχι λιγότερο σημαντικό, αξιολογείτε την απόδοση του μοντέλου σας. Θα πρέπει να είστε σε θέση να νικήσετε την υλικοτεχνική παλινδρόμηση.
# Evaluate and report metrics.
eval_metrics = estimator_kernel.evaluate(input_fn=test_input_fn, steps=1)
WARNING:tensorflow:Casting <dtype: 'int32'> labels to bool. WARNING:tensorflow:Casting <dtype: 'int32'> labels to bool. WARNING:tensorflow:Trapezoidal rule is known to produce incorrect PR-AUCs; please switch to "careful_interpolation" instead. WARNING:tensorflow:Trapezoidal rule is known to produce incorrect PR-AUCs; please switch to "careful_interpolation" instead. INFO:tensorflow:Starting evaluation at 2018-07-12-15:58:50 INFO:tensorflow:Graph was finalized. INFO:tensorflow:Restoring parameters from kernel_train/model.ckpt-2000 INFO:tensorflow:Running local_init_op. INFO:tensorflow:Done running local_init_op. INFO:tensorflow:Evaluation [1/1] INFO:tensorflow:Finished evaluation at 2018-07-12-15:58:51 INFO:tensorflow:Saving dict for global step 2000: accuracy = 0.83975184, accuracy/baseline_label_mean = 0.23622628, accuracy/threshold_0.500000_mean = 0.83975184, auc = 0.8904007, auc_precision_recall = 0.72722375, global_step = 2000, labels/actual_label_mean = 0.23622628, labels/prediction_mean = 0.23786618, loss = 0.34277728, precision/positive_threshold_0.500000_mean = 0.73001117, recall/positive_threshold_0.500000_mean = 0.5104004
Η τελική ακρίβεια είναι 84%, περίπου 1.6 ποσοστιαίες μονάδες πάνω από τη γραμμή βάσης της λογιστικής παλινδρόμησης (0.83975184 έναντι 0.82353663). Υπάρχει μια αντιστάθμιση μεταξύ της βελτίωσης της ακρίβειας και του υπολογιστικού κόστους. Πρέπει να σκεφτείτε αν αυτή η βελτίωση αξίζει τον χρόνο που καταναλώνεται από τον βαρύτερο ταξινομητή και αν έχει πειστικό αντίκτυπο στην επιχείρησή σας.
