
Εκμάθηση Τεχνητών Νευρωνικών Δικτύων (ANN) με το TensorFlow
 Έβελιν Κλαρκ
⚡ Έξυπνη Σύνοψη
Τα Τεχνητά Νευρωνικά Δίκτυα μαθαίνουν προωθώντας δεδομένα εισόδου μέσω συνδεδεμένων επιπέδων, βαθμολογώντας το αποτέλεσμα με μια συνάρτηση απώλειας και διορθώνοντας τα βάρη με έναν βελτιστοποιητή. Αυτή η αναλυτική παρουσίαση δημιουργεί ένα τέτοιο σύστημα στο TensorFlow και ταξινομεί τα ψηφία MNIST.
Τι είναι το τεχνητό νευρωνικό δίκτυο;
An Τεχνητό Νευρωνικό Δίκτυο (ANN) είναι ένα σύστημα υπολογιστή εμπνευσμένο από βιολογικά νευρωνικά δίκτυα για τη δημιουργία τεχνητών εγκεφάλων που βασίζονται στη συλλογή συνδεδεμένων μονάδων που ονομάζονται τεχνητοί νευρώνες. Έχει σχεδιαστεί για να αναλύει και να επεξεργάζεται πληροφορίες με τον τρόπο που το κάνουν οι άνθρωποι. Ένα Τεχνητό Νευρωνικό Δίκτυο έχει δυνατότητες αυτομάθησης για να παράγει καλύτερα αποτελέσματα καθώς περισσότερα δεδομένα είναι διαθέσιμα.
Το παρακάτω διάγραμμα tracείναι ένα πλήρες πέρασμα μέσα από ένα τέτοιο δίκτυο, από την ακατέργαστη είσοδο μέχρι τον βελτιστοποιητή που διορθώνει τα βάρη.

Ένα τεχνητό νευρωνικό δίκτυο (ANN) αποτελείται από τέσσερα κύρια αντικείμενα:
- Επίπεδα: Όλη η μάθηση λαμβάνει χώρα στα επίπεδα. Υπάρχουν 3 επίπεδα: 1) Είσοδος, 2) Κρυφό και 3) Έξοδος.
- Χαρακτηριστικό και ετικέτα: Είσοδος δεδομένων στο δίκτυο (χαρακτηριστικά) και έξοδος από το δίκτυο (ετικέτες)
- Λειτουργία απώλειας: Μετρική που χρησιμοποιείται για την εκτίμηση της απόδοσης της φάσης μάθησης
- Βελτιστοποιητής: Βελτιώστε τη μάθηση ενημερώνοντας τις γνώσεις στο δίκτυο
Ένα νευρωνικό δίκτυο λαμβάνει τα δεδομένα εισόδου και τα ωθεί σε ένα σύνολο επιπέδων. Στη συνέχεια, το δίκτυο αξιολογεί την απόδοσή του με μια συνάρτηση απώλειας. Η συνάρτηση απώλειας δίνει στο δίκτυο μια ιδέα για την πορεία που πρέπει να ακολουθήσει πριν κατακτήσει τη γνώση. Το δίκτυο βελτιώνει αυτή τη γνώση με τη βοήθεια ενός βελτιστοποιητή.
Αν ρίξετε μια ματιά στο παραπάνω σχήμα, θα καταλάβετε τον υποκείμενο μηχανισμό.
Το πρόγραμμα λαμβάνει ορισμένες τιμές εισόδου και τις ωθεί σε δύο πλήρως συνδεδεμένα επίπεδα. Φανταστείτε ότι έχετε ένα μαθηματικό πρόβλημα. Το πρώτο πράγμα που κάνετε είναι να διαβάσετε το αντίστοιχο κεφάλαιο για να το λύσετε. Στη συνέχεια, εφαρμόζετε τις νέες σας γνώσεις στο πρόβλημα. Υπάρχει μεγάλη πιθανότητα να μην έχετε πολύ καλή βαθμολογία. Το ίδιο ισχύει και για ένα δίκτυο: την πρώτη φορά που βλέπει τα δεδομένα και κάνει μια πρόβλεψη, το αποτέλεσμα δεν θα ταιριάζει απόλυτα με τα πραγματικά δεδομένα.
Για να βελτιώσει τις γνώσεις του, το δίκτυο χρησιμοποιεί έναν βελτιστοποιητή. Σε αυτήν την αναλογία, ένας βελτιστοποιητής μπορεί να θεωρηθεί ως η επανάληψη της ανάγνωσης του κεφαλαίου. Αποκτάτε νέες γνώσεις διαβάζοντας ξανά. Ομοίως, το δίκτυο χρησιμοποιεί τον βελτιστοποιητή, ενημερώνει τις γνώσεις του και δοκιμάζει αυτές τις νέες γνώσεις για να ελέγξει πόσα χρειάζεται ακόμα να μάθει. Το πρόγραμμα επαναλαμβάνει αυτό το βήμα μέχρι να κάνει το χαμηλότερο δυνατό σφάλμα.
Στην αναλογία με τα μαθηματικά προβλήματα, αυτό σημαίνει ότι διαβάζετε το κεφάλαιο του εγχειριδίου πολλές φορές μέχρι να κατανοήσετε πλήρως το περιεχόμενο του μαθήματος. Ακόμα και μετά από πολλές διαβάσεις, αν συνεχίσετε να κάνετε λάθος, σημαίνει ότι έχετε φτάσει στην ικανότητα γνώσης της τρέχουσας ύλης. Πρέπει να χρησιμοποιήσετε ένα διαφορετικό εγχειρίδιο ή να δοκιμάσετε μια διαφορετική μέθοδο για να βελτιώσετε τη βαθμολογία σας. Για ένα νευρωνικό δίκτυο, είναι η ίδια διαδικασία. Εάν το σφάλμα σταματήσει να μειώνεται και η καμπύλη απώλειας γίνει επίπεδη, η τρέχουσα αρχιτεκτονική δεν μπορεί να μάθει τίποτα άλλο. Το δίκτυο πρέπει να βελτιστοποιηθεί καλύτερα για να βελτιωθεί η γνώση.
Αυτά τα τέσσερα αντικείμενα αντιστοιχίζονται απευθείας στα στοιχεία που διαμορφώνετε κατά τον σχεδιασμό ενός δικτύου.
Νευρικό σύστημα Archiδομή
Η αρχιτεκτονική του Τεχνητού Νευρωνικού Δικτύου αποτελείται από τα ακόλουθα στοιχεία:
- Επίπεδα
- Λειτουργία ενεργοποίησης
- Λειτουργία απώλειας
- Optimizer
Επίπεδα
Ένα επίπεδο είναι το σημείο όπου λαμβάνει χώρα όλη η μάθηση. Μέσα σε ένα επίπεδο βρίσκεται ένας αυθαίρετος αριθμός νευρώνων, ο καθένας από τους οποίους έχει το δικό του βάρος. Ένα τυπικό νευρωνικό δίκτυο συχνά υποβάλλεται σε επεξεργασία από πυκνά συνδεδεμένα επίπεδα (που ονομάζονται επίσης πλήρως συνδεδεμένα επίπεδα). Αυτό σημαίνει ότι όλες οι είσοδοι είναι συνδεδεμένες με την έξοδο.
Ένα τυπικό νευρωνικό δίκτυο δέχεται ένα διάνυσμα εισόδου και μια βαθμωτή τιμή που περιέχει τις ετικέτες. Η απλούστερη ρύθμιση είναι μια δυαδική ταξινόμηση με μόνο δύο κλάσεις: 0 και 1.
Το δίκτυο λαμβάνει μια είσοδο, την στέλνει σε όλους τους συνδεδεμένους κόμβους και υπολογίζει το σήμα με μια συνάρτηση ενεργοποίησης. Το αριθμημένο διάγραμμα παρακάτω αναπτύσσει έναν μόνο κόμβο, ώστε να μπορείτε να δείτε το σταθμισμένο άθροισμα και το βήμα ενεργοποίησης ξεχωριστά.

Το παραπάνω σχήμα απεικονίζει αυτή την ιδέα. Το πρώτο επίπεδο περιέχει τις τιμές εισόδου. Το δεύτερο επίπεδο, που ονομάζεται κρυφό επίπεδο, λαμβάνει την σταθμισμένη είσοδο από το προηγούμενο επίπεδο.
- Ο πρώτος κόμβος είναι οι τιμές εισόδου.
- Ο νευρώνας αναλύεται στο μέρος εισόδου και στη συνάρτηση ενεργοποίησης. Το αριστερό μέρος λαμβάνει όλα τα δεδομένα εισόδου από το προηγούμενο επίπεδο. Το δεξί μέρος είναι το άθροισμα των δεδομένων εισόδου που διαβιβάζονται σε μια συνάρτηση ενεργοποίησης.
- Τιμή εξόδου που υπολογίζεται από τα κρυφά επίπεδα και χρησιμοποιείται για την πραγματοποίηση μιας πρόβλεψης. Για την ταξινόμηση, ισούται με τον αριθμό των κλάσεων. Για την παλινδρόμηση, προβλέπεται μόνο μία τιμή.
Λειτουργία ενεργοποίησης
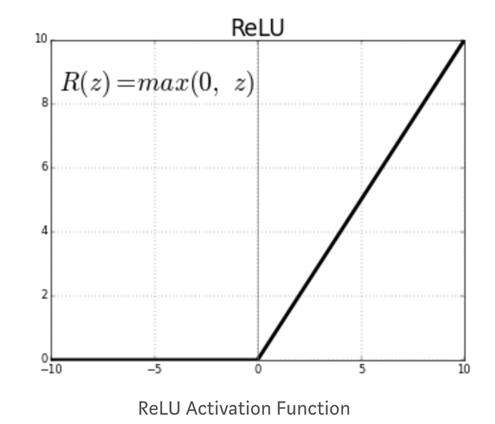
Η συνάρτηση ενεργοποίησης ενός κόμβου ορίζει την έξοδο δεδομένου ενός συνόλου εισόδων. Χρειάζεστε μια συνάρτηση ενεργοποίησης για να επιτρέψετε στο δίκτυο να μάθει μη γραμμικά μοτίβα. Μια κοινή συνάρτηση ενεργοποίησης είναι η ReLU, η Ανορθωμένη Γραμμική Μονάδα. Η συνάρτηση δίνει μηδέν για όλες τις αρνητικές τιμές.
Οι άλλες λειτουργίες ενεργοποίησης είναι:
- Τεμάχιο Γραμμικό
- Σιγμοειδές
- Tanh
- Διαρροή ReLU
Το παρακάτω διάγραμμα δείχνει γιατί το ReLU περιγράφεται με αυτόν τον τρόπο: η καμπύλη είναι επίπεδη στο μηδέν για κάθε αρνητική είσοδο και ανεβαίνει γραμμικά στη συνέχεια.
Η κρίσιμη απόφαση που πρέπει να ληφθεί κατά την κατασκευή ενός νευρωνικού δικτύου είναι:
- Πόσα επίπεδα στο νευρωνικό δίκτυο
- Πόσες κρυφές μονάδες για κάθε επίπεδο
Τα νευρωνικά δίκτυα με πολλά επίπεδα και κρυφές μονάδες μπορούν να μάθουν μια σύνθετη αναπαράσταση των δεδομένων, αλλά καθιστούν τους υπολογισμούς του δικτύου πολύ ακριβούς.
Λειτουργία απώλειας
Αφού ορίσετε τα κρυφά επίπεδα και τη συνάρτηση ενεργοποίησης, πρέπει να καθορίσετε τη συνάρτηση απώλειας και το βελτιστοποιητή.
Για την δυαδική ταξινόμηση, είναι κοινή πρακτική να χρησιμοποιείται μια δυαδική συνάρτηση απώλειας διασταυρούμενης εντροπίας. γραμμικής παλινδρόμησης, χρησιμοποιείτε το μέσο τετραγωνικό σφάλμα.
Η συνάρτηση απώλειας είναι μια σημαντική μέτρηση για την εκτίμηση της απόδοσης του βελτιστοποιητή. Κατά τη διάρκεια της εκπαίδευσης, αυτή η μέτρηση θα ελαχιστοποιηθεί. Πρέπει να επιλέξετε αυτή την ποσότητα προσεκτικά ανάλογα με το είδος του προβλήματος που αντιμετωπίζετε.
Optimizer
Η συνάρτηση απώλειας είναι ένα μέτρο της απόδοσης του μοντέλου. Ο βελτιστοποιητής θα βοηθήσει στη βελτίωση των βαρών του δικτύου, προκειμένου να μειωθεί η απώλεια. Υπάρχουν διαφορετικοί διαθέσιμοι βελτιστοποιητές, αλλά ο πιο συνηθισμένος είναι ο Stochastic Gradient Descent.
Οι συμβατικοί βελτιστοποιητές είναι:
- Momentum βελτιστοποίηση
- Επιταχυνόμενη κλίση Nesterov
- AdaGrad
- Βελτιστοποίηση Adam
ArchiΗ κατασκευή από μόνη της δεν εγγυάται ένα εύχρηστο μοντέλο.
Περιορισμοί Νευρωνικού Δικτύου
Οι περιορισμοί ενός νευρωνικού δικτύου είναι οι εξής:
Υπερβολική τοποθέτηση
Ένα συνηθισμένο πρόβλημα με ένα σύνθετο νευρωνικό δίκτυο είναι η δυσκολία γενίκευσης σε μη ορατά δεδομένα. Ένα νευρωνικό δίκτυο με πολλά βάρη μπορεί να αναγνωρίσει πολύ καλά συγκεκριμένες λεπτομέρειες στο σύνολο δεδομένων, αλλά αυτό συχνά οδηγεί σε υπερπροσαρμογή. Εάν τα δεδομένα είναι ανισορροπημένα εντός ομάδων (δηλαδή, δεν υπάρχουν αρκετά δεδομένα διαθέσιμα σε ορισμένες ομάδες), το δίκτυο θα μάθει πολύ καλά κατά τη διάρκεια της εκπαίδευσης, αλλά δεν θα έχει την ικανότητα να γενικεύσει τέτοια μοτίβα σε δεδομένα που δεν έχουν ξαναδεί.
Υπάρχει μια ανταλλαγή στο μάθηση μηχανής μεταξύ βελτιστοποίησης και γενίκευσης.
- Η βελτιστοποίηση ενός μοντέλου απαιτεί την εύρεση των καλύτερων παραμέτρων που ελαχιστοποιούν την απώλεια του συνόλου εκπαίδευσης.
- Η γενίκευση, ωστόσο, λέει πώς συμπεριφέρεται το μοντέλο για αόρατα δεδομένα.
Για να αποτρέψετε την καταγραφή συγκεκριμένων λεπτομερειών ή ανεπιθύμητων μοτίβων των δεδομένων εκπαίδευσης από το μοντέλο, μπορείτε να χρησιμοποιήσετε διαφορετικές τεχνικές. Η καλύτερη μέθοδος είναι να έχετε ένα ισορροπημένο σύνολο δεδομένων με επαρκή ποσότητα δεδομένων. Η τέχνη της μείωσης της υπερπροσαρμογής ονομάζεται κανονικοποίηση. Οι τρεις τεχνικές που ακολουθούν αποτελούν τα συμβατικά σημεία εκκίνησης.
| Τεχνική | Τι περιορίζει | Τυπική ρύθμιση σε αυτό το σεμινάριο |
|---|---|---|
| Μέγεθος δικτύου | Ο αριθμός των στρώσεων και των κρυφών μονάδων | Δύο κρυμμένα επίπεδα, 300 και 100 μονάδες |
| Κανονικοποίηση βάρους L1 / L2 | Το μέγεθος των συντελεστών βάρους | l1_regularization_strength και l2_regularization_strength 0.01 |
| Απόσυρση | Το μερίδιο των μονάδων που απενεργοποιούνται ανά βήμα εκπαίδευσης | απόρριψη 0.3 |
Μέγεθος δικτύου
Ένα νευρωνικό δίκτυο με πάρα πολλά επίπεδα και κρυφές μονάδες είναι γνωστό ότι είναι εξαιρετικά περίπλοκο. Ένας απλός τρόπος για να μειωθεί η πολυπλοκότητα του μοντέλου είναι να μειωθεί το μέγεθός του. Δεν υπάρχει μία και μοναδική βέλτιστη πρακτική για τον ορισμό του αριθμού των επιπέδων. Πρέπει να ξεκινήσετε με έναν μικρό αριθμό επιπέδων και να αυξήσετε το μέγεθος μέχρι να διαπιστώσετε ότι το μοντέλο υπερκαλύπτει.
Ρύθμιση βάρους
Μια τυπική τεχνική για την αποφυγή της υπερπροσαρμογής είναι η προσθήκη περιορισμών στα βάρη του δικτύου. Ο περιορισμός αναγκάζει τα βάρη του δικτύου να λαμβάνουν μόνο μικρές τιμές. Ο περιορισμός προστίθεται στη συνάρτηση απώλειας του σφάλματος. Υπάρχουν δύο είδη κανονικοποίησης:
- L1 (Λάσο): Το κόστος είναι ανάλογο με την απόλυτη τιμή των συντελεστών βάρους.
- L2 (Κορυφογραμμή): Το κόστος είναι ανάλογο με το τετράγωνο της τιμής των συντελεστών βάρους.
Απόσυρση
Η απόρριψη είναι μια περίεργη αλλά χρήσιμη τεχνική. Ένα δίκτυο με απόρριψη σημαίνει ότι ορισμένες μονάδες θα απενεργοποιηθούν τυχαία κατά τη διάρκεια ενός βήματος εκπαίδευσης, επομένως το εξερχόμενο σήμα τους γίνεται μηδέν. Φανταστείτε ότι έχετε έναν πίνακα βαρών [0.1, 1.7, 0.7, -0.9]. Εάν το νευρωνικό δίκτυο έχει απόρριψη, θα γίνει [0.1, 0, 0, -0.9] με τυχαία κατανεμημένο 0. Η παράμετρος που ελέγχει την απόρριψη είναι ο ρυθμός απόρριψης. Ο ρυθμός καθορίζει πόσες μονάδες απενεργοποιούνται. Είναι συνηθισμένο να υπάρχει ρυθμός μεταξύ 0.2 και 0.5.
Ένα μικρό διαδραστικό παράδειγμα κάνει την παρακολούθηση του βρόχου εκπαίδευσης εύκολη.
Παράδειγμα νευρωνικού δικτύου στο TensorFlow
Ακολουθεί ένα παράδειγμα Τεχνητού Νευρωνικού Δικτύου σε δράση, που δείχνει πώς λειτουργεί ένα νευρωνικό δίκτυο σε ένα τυπικό πρόβλημα ταξινόμησης. Υπάρχουν δύο είσοδοι, x1 και x2, καθεμία με τυχαία τιμή. Η έξοδος είναι μια δυαδική κλάση. Ο στόχος είναι να ταξινομηθεί η ετικέτα με βάση τα δύο χαρακτηριστικά. Για την εκτέλεση αυτής της εργασίας, η αρχιτεκτονική του νευρωνικού δικτύου ορίζεται ως εξής:
- Δύο κρυφά στρώματα
- Το πρώτο στρώμα έχει τέσσερις πλήρως συνδεδεμένους νευρώνες
- Το δεύτερο στρώμα έχει δύο πλήρως συνδεδεμένους νευρώνες
- Η λειτουργία ενεργοποίησης είναι μια ReLU
- Προσθέστε ένα L2 Regularization με ρυθμό εκμάθησης 0.003
Το δίκτυο θα βελτιστοποιήσει τα βάρη κατά τη διάρκεια 180 εποχών με μέγεθος παρτίδας 10. Στο παρακάτω παράδειγμα κινούμενης εικόνας ANN, μπορείτε να δείτε πώς εξελίσσονται τα βάρη με την πάροδο του χρόνου και πώς το δίκτυο βελτιώνει τον χάρτη ταξινόμησης.ping.

Πρώτα απ 'όλα, το δίκτυο εκχωρεί τυχαίες τιμές σε όλα τα βάρη.
- Με τα τυχαία βάρη, δηλαδή, χωρίς βελτιστοποίηση, η απώλεια εξόδου είναι 0.453. Η παρακάτω εικόνα αναπαριστά το δίκτυο με διαφορετικά χρώματα.
- Γενικά, το πορτοκαλί χρώμα αντιπροσωπεύει αρνητικές τιμές ενώ τα μπλε χρώματα δείχνουν τις θετικές τιμές.
- Τα σημεία δεδομένων έχουν την ίδια αναπαράσταση: τα μπλε είναι οι θετικές ετικέτες και τα πορτοκαλί οι αρνητικές ετικέτες.

Μέσα στο δεύτερο κρυφό επίπεδο, οι γραμμές χρωματίζονται ακολουθώντας το σύμβολο των βαρών. Οι πορτοκαλί γραμμές φέρουν αρνητικά βάρη και οι μπλε θετικά βάρη.
Όπως μπορείτε να δείτε, στον χάρτη εξόδουping, το δίκτυο κάνει αρκετά λάθη. Τώρα δείτε πώς συμπεριφέρεται το δίκτυο μετά τη βελτιστοποίηση.
Η εικόνα του παραδείγματος ANN παρακάτω απεικονίζει τα αποτελέσματα του βελτιστοποιημένου δικτύου. Πρώτα απ 'όλα, παρατηρείτε ότι το δίκτυο έχει μάθει με επιτυχία πώς να ταξινομεί τα σημεία δεδομένων. Συγκρίνοντάς το με την προηγούμενη εικόνα, το αρχικό βάρος ήταν -0.43, ενώ μετά τη βελτιστοποίηση προκύπτει βάρος -0.95.

Η ιδέα μπορεί να γενικευτεί για δίκτυα με περισσότερα κρυφά επίπεδα και νευρώνες. Μπορείτε να πειραματιστείτε με τις ρυθμίσεις μόνοι σας στο Παιδική χαρά TensorFlow.
Η παρακάτω αναλυτική παρουσίαση αναπτύσσει την ίδια ιδέα σε κώδικα σε σχέση με ένα πραγματικό σύνολο δεδομένων.
Πώς να εκπαιδεύσετε ένα νευρωνικό δίκτυο με το TensorFlow
Εδώ είναι η βήμα προς βήμα διαδικασία για το πώς να εκπαιδεύσετε ένα νευρωνικό δίκτυο με TensorFlow ANN χρησιμοποιώντας τον εκτιμητή DNNClassifier του API.
Θα χρησιμοποιήσουμε το σύνολο δεδομένων MNIST για να εκπαιδεύσουμε το πρώτο σας νευρωνικό δίκτυο. Εκπαίδευση νευρωνικού δικτύου με TensorFlow δεν είναι πολύ περίπλοκο. Το βήμα προεπεξεργασίας μοιάζει ακριβώς με τα προηγούμενα μαθήματα. Θα προχωρήσετε ως εξής:
- Εισαγάγετε τα δεδομένα
- Μεταμορφώστε τα δεδομένα
- Κατασκευάστε τον τανυστήρα
- Δημιουργήστε το μοντέλο
- Εκπαιδεύστε και αξιολογήστε το μοντέλο
- Βελτιώστε το μοντέλο
Σημείωση έκδοσης: Ο κώδικας σε αυτήν την αναλυτική παρουσίαση στοχεύει στο API TensorFlow 1.x Estimator. Η τελική έκδοση του πακέτου tf-estimator που συνοδεύει το TensorFlow 2.15 και το tf.estimator αφαιρέθηκε στο TensorFlow 2.16. Για να εκτελέσετε αυτά τα βήματα σε μια τρέχουσα έκδοση, είτε καρφιτσώστε το TensorFlow 2.15 είτε ανακατασκευάστε το ίδιο δίκτυο δύο επιπέδων με τις συναρτήσεις tf.keras.layers.Dense και model.fit().
Βήμα 1) Εισαγάγετε τα δεδομένα
Πρώτα απ 'όλα, πρέπει να εισαγάγετε την απαραίτητη βιβλιοθήκη. Μπορείτε να εισαγάγετε το σύνολο δεδομένων MNIST χρησιμοποιώντας scikit-μάθετε όπως φαίνεται στο παράδειγμα του Νευρωνικού Δικτύου TensorFlow παρακάτω.
Το σύνολο δεδομένων MNIST είναι το σύνολο δεδομένων που χρησιμοποιείται συχνότερα για τη δοκιμή νέων τεχνικών ή αλγορίθμων. Είναι μια συλλογή εικόνων 28×28 pixel, καθεμία από τις οποίες δείχνει ένα χειρόγραφο ψηφίο από το 0 έως το 9. Μια επιτροπή από βαθιά συνελικτικά δίκτυα που έχουν εκπαιδευτεί με ελαστικές παραμορφώσεις μείωσε το σφάλμα δοκιμής στο 0.27%.
import numpy as np
import tensorflow as tf
np.random.seed(1337)
Η αρχική αναλυτική παρουσίαση κατέβασε τα αρχεία MNIST χειροκίνητα και έδειξε το fetch_mldata σε αυτόν τον φάκελο.
from sklearn.datasets import fetch_mldata
mnist = fetch_mldata(' /Users/Thomas/Dropbox/Learning/Upwork/tuto_TF/data/mldata/MNIST original')
print(mnist.data.shape)
print(mnist.target.shape)
Σημείωση API: Το mldata.org δεν είναι πλέον διαθέσιμο στο διαδίκτυο και η συνάρτηση fetch_mldata αφαιρέθηκε στο scikit-learn 0.22. Σε μια τρέχουσα εγκατάσταση, αντικαταστήστε την παραπάνω κλήση με την συνάρτηση fetch_openml('mnist_784', έκδοση=1), η οποία κατεβάζει τα ίδια 70,000 ψηφία και εκθέτει τα ίδια δεδομένα και χαρακτηριστικά-στόχους.
Στη συνέχεια, διαχωρίζετε τα δεδομένα και λαμβάνετε το σχήμα και των δύο συνόλων δεδομένων.
from sklearn.model_selection import train_test_split

X_train, X_test, y_train, y_test = train_test_split(mnist.data, mnist.target, test_size=0.2, random_state=42)
y_train  = y_train.astype(int)
y_test  = y_test.astype(int)
batch_size =len(X_train)

print(X_train.shape, y_train.shape,y_test.shape )
Βήμα 2) Μετασχηματίστε τα δεδομένα
Στο προηγούμενο σεμινάριο, μάθατε ότι πρέπει να μετασχηματίσετε τα δεδομένα για να περιορίσετε την επίδραση των ακραίων τιμών. Σε αυτό το σεμινάριο για τα Νευρωνικά Δίκτυα, θα μετασχηματίσετε τα δεδομένα χρησιμοποιώντας την κλίμακα min-max. Ο τύπος είναι:
(X-min_x)/(max_x - min_x)
Το scikit-learn έχει ήδη μια συνάρτηση για αυτό: MinMaxScaler()
## resclae
from sklearn.preprocessing import MinMaxScaler
scaler = MinMaxScaler()
# Train
X_train_scaled = scaler.fit_transform(X_train.astype(np.float64))
# test
X_test_scaled = scaler.fit_transform(X_test.astype(np.float64))
Βήμα 3) Κατασκευάστε τον τανυστή
Τώρα είστε εξοικειωμένοι με τον τρόπο δημιουργίας τεντωτήρες στο TensorFlow. Μπορείτε να μετατρέψετε το σύνολο συρμών σε αριθμητική στήλη.
feature_columns = [tf.feature_column.numeric_column('x', shape=X_train_scaled.shape[1:])]
Βήμα 4) Κατασκευάστε το μοντέλο
Η αρχιτεκτονική του νευρωνικού δικτύου περιέχει 2 κρυφά επίπεδα με 300 μονάδες για το πρώτο επίπεδο και 100 μονάδες για το δεύτερο. Αυτές οι τιμές προέρχονται από την εμπειρία και όχι από έναν τύπο. Μπορείτε να τις ρυθμίσετε και να δείτε πώς επηρεάζουν την ακρίβεια του δικτύου.
Για να δημιουργήσετε το μοντέλο, χρησιμοποιείτε τον εκτιμητή DNNClassifier. Πρέπει να ορίσετε τον αριθμό των κλάσεων σε 10, καθώς υπάρχουν δέκα κλάσεις στο σύνολο εκπαίδευσης. Είστε ήδη εξοικειωμένοι με τη σύνταξη του αντικειμένου εκτιμητή. Τα ορίσματα feature_columns, n_classes και model_dir είναι ακριβώς τα ίδια με αυτά του προηγούμενου σεμιναρίου. Το όρισμα hidden_units είναι το νέο: ελέγχει τόσο τον αριθμό των επιπέδων όσο και τον αριθμό των κόμβων που συνδέεται κάθε επίπεδο στο νευρωνικό δίκτυο. Στον παρακάτω κώδικα, υπάρχουν δύο κρυφά επίπεδα, το πρώτο που συνδέει 300 κόμβους και το δεύτερο 100 κόμβους.
Για να δημιουργήσετε τον εκτιμητή, χρησιμοποιήστε το tf.estimator.DNNClassifier με τις ακόλουθες παραμέτρους:
- στήλες_χαρακτηριστικών: Ορίστε τις στήλες που θα χρησιμοποιηθούν στο δίκτυο
- κρυφές_μονάδες: Ορίστε τον αριθμό των κρυφών νευρώνων
- n_κλάσεις: Ορίστε τον αριθμό των κλάσεων που θα προβλεφθούν
- μοντέλο_κατάλογος: Ορίστε την πορεία του TensorBoard
estimator = tf.estimator.DNNClassifier(
    feature_columns=feature_columns,
    hidden_units=[300, 100],
    n_classes=10,
    model_dir = '/train/DNN')
Βήμα 5) Εκπαιδεύστε και αξιολογήστε το μοντέλο
Μπορείτε να χρησιμοποιήσετε τη συνάρτηση εισόδου NumPy για να εκπαιδεύσετε το μοντέλο και να το αξιολογήσετε.
# Train the estimator
train_input = tf.estimator.inputs.numpy_input_fn(
    x={"x": X_train_scaled},
    y=y_train,
    batch_size=50,
    shuffle=False,
    num_epochs=None)
estimator.train(input_fn = train_input,steps=1000)
eval_input = tf.estimator.inputs.numpy_input_fn(
    x={"x": X_test_scaled},
    y=y_test,
    shuffle=False,
    batch_size=X_test_scaled.shape[0],
    num_epochs=1)
estimator.evaluate(eval_input,steps=None)
Παραγωγή:
{'accuracy': 0.9637143,
 'average_loss': 0.12014342,
 'loss': 1682.0079,
 'global_step': 1000}
Η τρέχουσα αρχιτεκτονική οδηγεί σε ακρίβεια στο σύνολο αξιολόγησης περίπου 96%.
Βήμα 6) Βελτιώστε το μοντέλο
Μπορείτε να προσπαθήσετε να βελτιώσετε το μοντέλο προσθέτοντας παραμέτρους τακτοποίησης.
Εδώ, ο εκτιμητής χρησιμοποιεί έναν βελτιστοποιητή Proximal AdaGrad με ποσοστό εγκατάλειψης 0.3 και οι δύο δυνάμεις L1 και L2 έχουν οριστεί σε 0.01. Σε ένα νευρωνικό δίκτυο TensorFlow, φτάνετε στον βελτιστοποιητή μέσω του αντικειμένου train ακολουθούμενου από το όνομα του βελτιστοποιητή. Το TensorFlow παρέχει ένα ενσωματωμένο API για τον βελτιστοποιητή Proximal AdaGrad.
Για να προσθέσετε κανονικοποίηση στο βαθύ νευρωνικό δίκτυο, μπορείτε να χρησιμοποιήσετε το tf.train.ProximalAdagradOptimizer με τις ακόλουθες παραμέτρους:
- Ρυθμός εκμάθησης: βαθμός μάθησης
- Κανονικοποίηση L1: l1_κανονικοποίηση_δύναμη
- Κανονικοποίηση L2: l2_κανονικοποίηση_δύναμη
estimator_imp = tf.estimator.DNNClassifier(
    feature_columns=feature_columns,
    hidden_units=[300, 100],
    dropout=0.3,
    n_classes = 10,
    optimizer=tf.train.ProximalAdagradOptimizer(
      learning_rate=0.01,
      l1_regularization_strength=0.01,
      l2_regularization_strength=0.01
    ),
    model_dir = '/train/DNN1')
estimator_imp.train(input_fn = train_input,steps=1000)
estimator_imp.evaluate(eval_input,steps=None)
Παραγωγή:
{'accuracy': 0.95057142,
 'average_loss': 0.17318928,
 'loss': 2424.6499,
 'global_step': 2000}
Οι τιμές που επιλέχθηκαν για τη μείωση της υπερπροσαρμογής δεν βελτίωσαν την ακρίβεια του μοντέλου. Το πρώτο σας μοντέλο είχε ακρίβεια 96%, ενώ το μοντέλο με τον κανονικοποιητή L2 έχει ακρίβεια 95%. Μπορείτε να δοκιμάσετε διαφορετικές τιμές και να δείτε πώς επηρεάζουν την ακρίβεια.
