
Hadoop Pig Tutorial: Hvad er Apache Pig? Architecture, Eksempel
 Prafulla Ranadive
⚡ Smart opsummering
Apache Pig er en platform på højt niveau til analyse af store datasæt på Hadoop, der parrer dataflowsproget Pig Latin med en runtime, der kompilerer hvert script til MapReduce, Tez eller ... Spark job automatisk.
Denne vejledning starter med ideen bag Apache Pig og gennemgår derefter installationen og kørsel af et komplet latinsk Pig-script fra ende til anden.
Hvad er Apache Pig?
Gris er på højt niveau programmeringssprog nyttig til analyse af store datasæt. Pig var et resultat af udviklingsindsatsen hos Yahoo!
I et MapReduce-framework skal programmer oversættes til en række Map- og Reduce-faser. Dette er dog ikke en programmeringsmodel, som dataanalytikere er bekendt med. Så for at bygge bro over dette hul, er der behov for en abstraction kaldet Pig blev bygget oven på Hadoop.
Apache Pig gør det muligt for folk at fokusere mere på at analysere store mængder data og bruge mindre tid på at skrive MapReduce-programmer. Ligesom grise, der spiser hvad som helst, er programmeringssproget Apache Pig designet til at arbejde med alle former for data. Derfor navnet Pig! Projektets maskot nedenfor understreger det samme.

Projektet er stadig aktivt. Apache Pig 0.18.0 blev udgivet den 15. september 2025 og tilføjer understøttelse af Hadoop 3, Tez 0.10, Hive 3, Spark 3, HBase 2 og Python 3, ifølge Apache Pig-udgivelsessideGennemgangen nedenfor blev oprindeligt skrevet til den meget ældre 0.12.1-linje, så et par trin indeholder en bemærkning, hvor en nuværende udgivelse opfører sig anderledes.
Gris Architecture
Pigs arkitektur består af to komponenter:
- Grise latin, som er et sprog
- Et runtime miljø, til at køre Pig Latin-programmer.
Et Pig Latin-program består af en række operationer eller transformationer, der anvendes på inputdataene for at producere output. Disse operationer beskriver en datastrøm, der oversættes til en eksekverbar repræsentation af Hadoop Pig-eksekveringsmiljøet. Nedenfor er resultaterne af disse transformationer en række KortReducer job, som en programmør ikke er klar over. Så på en måde giver Pig i Hadoop programmøren mulighed for at fokusere på data snarere end på udførelsens natur.
Pig Latin er et forholdsvis stift sprog, der bruger velkendte nøgleord fra databehandling, f.eks. Join, Group og Filter. Diagrammet nedenfor tracsender et script fra Grunt-shellen gennem parseren, optimeringsprogrammet og compileren på sin vej til udførelsesmotoren.

Udførelsestilstande
Pig i Hadoop har to udførelsestilstande, og installationsgennemgangen længere nede bruger dem begge:
- Lokal tilstand: I denne tilstand kører Hadoop Pig-sproget i en enkelt FMV og bruger det lokale filsystem. Denne tilstand er kun egnet til analyse af små datasæt ved hjælp af Pig i Hadoop.
- MapReduce-tilstand: I denne tilstand oversættes forespørgsler skrevet på Pig Latin til MapReduce-job og køres på en Hadoop-klynge (klyngen kan være pseudodistribueret eller fuldt distribueret). MapReduce-tilstand med en fuldt distribueret klynge er nyttig til at køre Pig på store datasæt.
De to er det klassiske par. Nuværende udgivelser eksponerer faktisk seks udførelsestyper, eller exectyper, der hver især er valgt med det samme -x flag, som dokumenteret i Pig 0.18.0 Introduktionsvejledning.
| Exectype | Kommando | Hvor arbejdet foregår |
|---|---|---|
| Lokale | gris -x lokal | En enkelt JVM mod det lokale filsystem |
| Tez lokal | gris -x tez_local | En enkelt JVM, der bruger Tez-kørselstiden (eksperimentel) |
| Spark lokale | gris -x spark_local | En enkelt JVM, der bruger Spark kørselstid (eksperimentel) |
| KortReducer | gris eller gris -x mapreduce | En Hadoop-klynge med HDFS; dette er standardindstillingen |
| Tez | gris -x tez | En Hadoop-klynge, der kører Tez-motoren |
| Spark | gris -x gnist | A Spark, YARN eller Mesos-klynge med HDFS |
Latinske datatyper for grise og Operatorer
Før man skriver et script, er det en god idé at vide, hvad Pig kan indeholde, og hvad den kan gøre ved det. Datamodellen er fuldt indlejret, hvilket gør det muligt for Pig at læse logfiler og andet løst struktureret input, som en relationel tabel ville afvise.
Pig Latin tilbyder to familier af typer:
- Skalære typer:
int,long,float,double,chararray,bytearray,boolean,datetime,bigintegerogbigdecimal. Eksempelskriptet deklarerer senere hver kolonne somchararray. - Komplekse typer: a tupel er et ordnet sæt af felter og opfører sig som en række; taske er en uordnet samling af tupler og opfører sig som en tabel; a kort er et sæt af nøgle- og værdipar, hvis nøgle skal være en
chararray.
Operatørerne har et lille antal opgaver, og en håndfuld af dem fører næsten alle rørledninger:
| OperaTor | Hvad gør den |
|---|---|
| LÆS / OPBEVAR | Læs en relation fra filsystemet og skriv resultatet tilbage |
| FILTER | Behold kun de tupler, der matcher en betingelse |
| FOREACH … GENERÉR | Arbejd kolonne for kolonne, og opbyg nye felter |
| GRUPPE / SAMGRUPPE | Gruppér én relation, eller to eller flere relationer, efter en nøgle |
| JOIN | Kombinér relationer med en indre eller ydre join |
| UNION / SPLIT | Sammenføj relationer, eller opdel en i flere |
| SORTER EFTER / TYDELIG / GRÆNSE | Sortér, deduplikér og begræns antallet af tupler |
| DUMP / BESKRIV / FORKLAR / ILLUSTRER | Inspicer resultater, skemaer, udførelsesplaner og prøvekørsler |
De fire inspektionsoperatører har også Grunt-genveje, hvilket sparer penge.ping under fejlfinding: \d til DUMP, \de for BESKRIV, \e for FORKLARING og \i til ILLUSTRER.
Forudsætninger
Pig er et klientsideværktøj. Det analyserer et script, planlægger arbejdet og sender job, men det tilbyder ikke lagerplads eller en egen klynge, så der skal først findes en fungerende Hadoop-installation. Apache-kravlisten er kort.
| Component | Krav | Hvorfor er det nødvendigt |
|---|---|---|
| Hadoop | Hadoop 2.x eller 3.x, med HADOOP_HOME eksporteret | Leverer HDFS og udførelsesmotoren. Uden HADOOP_HOME falder Pig 0.18.0 tilbage til en indlejret Hadoop 2.7.3. |
| Java | Java 1.7 eller nyere, med JAVA_HOME sat til installationsroden | Pig og Hadoop-dæmonerne er Java programmer |
| Python (Valgfrit) | Python 2.7 | Kun nødvendigt til streaming Python brugerdefinerede funktioner |
| Myre (valgfrit) | Myr 1.8 | Kun nødvendigt ved opbygning eller rekompilering af Pig fra kildekode |
To praktiske punkter følger med den liste. For det første, kør alt som en Linux-bruger, der allerede har en hjemmemappe i HDFS og tilladelse til at skrive til den; denne vejledning bruger hduser, den konto, der blev oprettet under opsætningen af Hadoop. For det andet skal du starte klyngen, før du starter Pig i MapReduce-tilstand, da Pig fejler øjeblikkeligt, hvis NameNode og ResourceManager er nede. Hvis Hadoop ikke er installeret endnu, skal du arbejde dig igennem hvordan man installerer Hadoop først.
Sådan downloades og installeres Pig
Nu i denne Apache Pig-tutorial lærer vi, hvordan du downloader og installerer Pig:
Før vi starter med selve processen, skal du sørge for at have Hadoop installeret. Skift bruger til 'hduser' (id'et der blev brugt under konfigurationen af Hadoop; du kan skifte til det bruger-id der blev brugt under din egen Hadoop-konfiguration).

Trin 1) Download den seneste stabile udgave af Pig Hadoop fra et af de tilgængelige spejlwebsteder på
https://pig.apache.org/releases.html
Vælg tar.gz-filen (og ikke src.tar.gz) for at downloade, som vist nedenfor.

Trin 2) Når downloadingen er færdig, skal du navigere til den mappe, der indeholder den downloadede tar-fil, og flytte tar-filen til den placering, hvor du vil konfigurere Pig Hadoop. I dette tilfælde flytter vi til /usr/local.

Flyt til den mappe, der skal indeholde Pig Hadoop-filerne.
cd /usr/local
Extracindholdet af tar-filen som nedenfor.
sudo tar -xvf pig-0.12.1.tar.gz

Trin 3) Rediger ~/.bashrc for at tilføje Pig-relaterede miljøvariabler.
Åbn ~/.bashrc-filen i en hvilken som helst teksteditor efter eget valg, og foretag ændringerne nedenfor.
export PIG_HOME=<Installation directory of Pig>
export PATH=$PIG_HOME/bin:$HADOOP_HOME/bin:$PATH

Trin 4) Opret nu kilde til denne miljøkonfiguration ved hjælp af kommandoen nedenfor.
. ~/.bashrc

Trin 5) Vi skal rekompilere Pig for at understøtte Hadoop 2.2.0.
Her er trinene til at gøre dette.
Gå til Pigs hjemmemappe.
cd $PIG_HOME
Installer Ant.
sudo apt-get install ant

Bemærk: Downloaden starter og vil tage tid afhængigt af din internethastighed.
Genkompilér Pig.
sudo ant clean jar-all -Dhadoopversion=23

Bemærk venligst, at der downloades flere komponenter i denne rekompileringsproces, så systemet skal være forbundet til internettet.
Hvis denne proces også sidder fast et sted, og du ikke ser nogen bevægelse i kommandoprompten i mere end 20 minutter, skal du trykke på Ctrl + c og køre den samme kommando igen.
I vores tilfælde tager det 20 minutter.

Dette rekompileringstrin tilhører 0.12.1-æraen, hvor de leverede jar-filer blev bygget mod Hadoop 1 og -Dhadoopversion=23 flag skiftede Ant-bygget til Hadoop 0.23 og 2.x-linjen. Apache Pig 0.18.0 leverer binære filer, der allerede kører på Hadoop 2.7 og nyere samt Hadoop 3, så i en nuværende udgivelse kan du normalt udpakke tarballen og springe direkte til testen nedenfor.
Trin 6) Test Pig-installationen ved hjælp af kommandoen
pig -help

Eksempel Pig Script
Når Pig er installeret, kører resten af denne Apache Pig-vejledning et komplet script. Vi bruger Pig Scripts til at finde antallet af solgte produkter i hvert land.
Input: Vores inputdatasæt er en CSV-fil, SalgJan2009.csv.
Trin 1) Start Hadoop.
$HADOOP_HOME/sbin/start-dfs.sh
$HADOOP_HOME/sbin/start-yarn.sh
Trin 2) Pig i Big Data tager en fil fra HDFS i MapReduce-tilstand og gemmer resultaterne tilbage i HDFS.
Kopier filen SalesJan2009.csv (gemt på det lokale filsystem på adressen ~/input/SalesJan2009.csv) til HDFS-hjemmemappen (Hadoop Distributed File System).
Her i dette Apache Pig-eksempel er filen i mappen "input". Hvis filen er gemt et andet sted, skal du give den det navn i stedet.
$HADOOP_HOME/bin/hdfs dfs -copyFromLocal ~/input/SalesJan2009.csv /

Kontroller, om filen rent faktisk blev kopieret eller ej.
$HADOOP_HOME/bin/hdfs dfs -ls /

Trin 3) Grisekonfiguration.
Først skal du navigere til $PIG_HOME/conf og beholde en kopi af den originale egenskabsfil.
cd $PIG_HOME/conf
sudo cp pig.properties pig.properties.original

Åbn pig.properties ved hjælp af en teksteditor efter eget valg, og angiv logfilstien ved hjælp af pig.logfile.
sudo gedit pig.properties

Loggeren vil bruge denne fil til at logge fejl.
Trin 4) Kør kommandoen 'pig', som vil starte Pig-kommandoprompten, en interaktiv shell til Pig-forespørgsler.
pig

Trin 5) I Grunt-kommandoprompten for Pig skal du udføre Pig-kommandoerne nedenfor i rækkefølge.
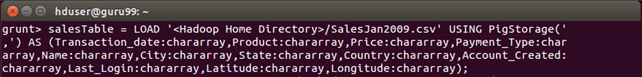
— A. Indlæs filen, der indeholder data.
salesTable = LOAD '/SalesJan2009.csv' USING PigStorage(',') AS (Transaction_date:chararray,Product:chararray,Price:chararray,Payment_Type:chararray,Name:chararray,City:chararray,State:chararray,Country:chararray,Account_Created:chararray,Last_Login:chararray,Latitude:chararray,Longitude:chararray);
Tryk på Enter efter denne kommando.
— B. Gruppér data efter feltet Land.
GroupByCountry = GROUP salesTable BY Country;

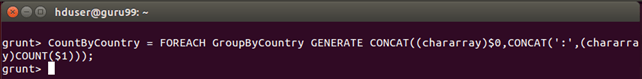
— C. For hver tuple i 'GroupByCountry' genereres den resulterende streng af formen Landets navn: Antal solgte produkter.
CountByCountry = FOREACH GroupByCountry GENERATE CONCAT((chararray)$0,CONCAT(':',(chararray)COUNT($1)));
Tryk på Enter efter denne kommando.
— D. Gem resultaterne af dataflowet i mappen 'pig_output_sales' på HDFS.
STORE CountByCountry INTO 'pig_output_sales' USING PigStorage('\t');

Denne kommando vil tage noget tid at udføre. Når den er færdig, bør du se følgende skærm.

Trin 6) Resultatet kan ses via kommandogrænsefladen som
$HADOOP_HOME/bin/hdfs dfs -cat pig_output_sales/part-r-00000

Resultaterne kan også ses via en webgrænseflade.
Åbn http://localhost:50070/ i en webbrowser.
Port 50070 er NameNode-webgrænsefladen på Hadoop 2. Hadoop 3 flyttede den samme side til port 9870, så brug den adresse i stedet, hvis din klynge kører Hadoop 3.

Vælg nu 'Gennemse filsystemet' og naviger op til /user/hduser/pig_output_sales.

Åbn part-r-00000 for at læse land- og produkt-antal-parrene, som scriptet producerede.

Apache Pig vs. Hive vs. MapReduce
Gris vurderes sjældent alene. Det sædvanlige spørgsmål er, om et job hører hjemme i Gris, i Hive eller i et håndskrevet MapReduce-program, da alle tre ender som job på den samme klynge.
| Aspect | KortReducer (Java) | Apache gris | Apache Hive |
|---|---|---|---|
| grænseflade | Java API | Pig Latin , et scriptsprog til dataflow | HiveQL, en SQL-dialekt |
| Niveau af mavemusklertraction | Lav | Medium | Høj |
| Typisk bruger | Java developer | Dataingeniør eller forsker | Analytiker fortrolig med SQL |
| Data der passer | Alt, håndteret manuelt | Struktureret og semistruktureret; skemaet er valgfrit ved indlæsning | Strukturerede tabeller registreret i en metastore |
| Code bind | De fleste linjer | Færre linjer | Færrest linjer for en forespørgsel |
| Kører som | Et MapReduce-job | Kompilerer til MapReduce, Tez eller Spark job | Kompilerer til MapReduce, Tez eller Spark job |
| Bedste ved | Fuld kontrol og brugerdefineret logik | Flertrins ETL-pipelines | Ad hoc-forespørgsler og rapportering |
I praksis er opdelingen ligetil. Brug Hive, når dataene allerede ligner en tabel, og spørgsmålet ligner SQL. Brug Pig, når inputtet er rodet, når pipelinen er en kæde af transformationer snarere end en enkelt forespørgsel, eller når det samme script skal forgrene sig og genforenes. Brug kun MapReduce, når ingen af abs...traction kan udtrykke logikken, fordi linjeantallet vokser hurtigt.
Gris sidder også komfortabelt ved siden af resten af økosystemet. Sqoop og Flume land de rå data, Pig eller Hive former dem, og en scheduler som f.eks. Apache Oozie kæder trinnene sammen til en gentagelig pipeline. For et bredere billede af, hvor disse værktøjer passer ind, se vejledningen til big data og opsamlingen af big data-værktøjerfor et kommercielt ETL-alternativ til håndskrevne manuskripter, se Talent.
