
Hadoop MapReduce-eksempel: Først Java Program med Code
 Prafulla Ranadive
⚡ Smart opsummering
Hadoop MapReduce-programmer er skrevet som tre Java klasser, en mapper, en reducer og en driver, der kompileres, pakkes i en jar og sendes til klyngen for at tælle salg pr. land.
I denne tutorial lærer du at bruge Hadoop med MapReduce-eksempler. De anvendte inputdata er SalgJan2009.csvDen indeholder salgsrelaterede oplysninger såsom produktnavn, pris, betalingsmetode, by og land for kunden. Målet er at finde ud af antallet af solgte produkter i hvert land.
Første Hadoop MapReduce-program
Nu i dette MapReduce tutorial, vil vi skabe vores første Java MapReduce-program:
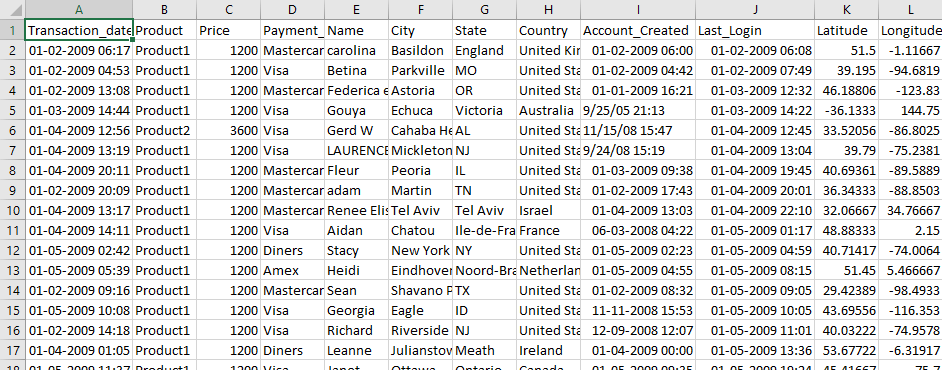
Skærmbilledet nedenfor viser de rå SalesJan2009-data, hvor hver linje er én transaktion, og landet er placeret i den ottende kommaseparerede kolonne.
Sørg for, at du har Hadoop installeret. Før du starter med selve processen, skal du ændre brugeren til 'hduser' (id'et, der blev brugt under konfigurationen af Hadoop — du kan skifte til det bruger-id, der blev brugt under din egen Hadoop-konfiguration).
su - hduser_
Prompten ændres til hduser-kontoen, som vist nedenfor.

Trin 1) Opret projektmappen og kildefilerne
Opret en ny mappe med navnet MapReduceTutorial som vist i MapReduce-eksemplet nedenfor.
sudo mkdir MapReduceTutorial

Giv tilladelser
sudo chmod -R 777 MapReduceTutorial

Skab de tre Java kildefilerne nedenfor i MapReduceTutorial. Bemærk, at alle tre bruger den ældre org.apache.hadoop.mapred API, som stadig leveres med Hadoop 3.x.
SalesMapper.java
package SalesCountry;

import java.io.IOException;

import org.apache.hadoop.io.IntWritable;
import org.apache.hadoop.io.LongWritable;
import org.apache.hadoop.io.Text;
import org.apache.hadoop.mapred.*;

public class SalesMapper extends MapReduceBase implements Mapper <LongWritable, Text, Text, IntWritable> {
	private final static IntWritable one = new IntWritable(1);

	public void map(LongWritable key, Text value, OutputCollector <Text, IntWritable> output, Reporter reporter) throws IOException {

		String valueString = value.toString();
		String[] SingleCountryData = valueString.split(",");
		output.collect(new Text(SingleCountryData[7]), one);
	}
}
SalesCountryReducer.java
package SalesCountry;

import java.io.IOException;
import java.util.*;

import org.apache.hadoop.io.IntWritable;
import org.apache.hadoop.io.Text;
import org.apache.hadoop.mapred.*;

public class SalesCountryReducer extends MapReduceBase implements Reducer<Text, IntWritable, Text, IntWritable> {

	public void reduce(Text t_key, Iterator<IntWritable> values, OutputCollector<Text,IntWritable> output, Reporter reporter) throws IOException {
		Text key = t_key;
		int frequencyForCountry = 0;
		while (values.hasNext()) {
			// replace type of value with the actual type of our value
			IntWritable value = (IntWritable) values.next();
			frequencyForCountry += value.get();

		}
		output.collect(key, new IntWritable(frequencyForCountry));
	}
}
SalesCountryDriver.java
package SalesCountry;

import org.apache.hadoop.fs.Path;
import org.apache.hadoop.io.*;
import org.apache.hadoop.mapred.*;

public class SalesCountryDriver {
    public static void main(String[] args) {
        JobClient my_client = new JobClient();
        // Create a configuration object for the job
        JobConf job_conf = new JobConf(SalesCountryDriver.class);

        // Set a name of the Job
        job_conf.setJobName("SalePerCountry");

        // Specify data type of output key and value
        job_conf.setOutputKeyClass(Text.class);
        job_conf.setOutputValueClass(IntWritable.class);

        // Specify names of Mapper and Reducer Class
        job_conf.setMapperClass(SalesCountry.SalesMapper.class);
        job_conf.setReducerClass(SalesCountry.SalesCountryReducer.class);

        // Specify formats of the data type of Input and output
        job_conf.setInputFormat(TextInputFormat.class);
        job_conf.setOutputFormat(TextOutputFormat.class);

        // Set input and output directories using command line arguments,
        //arg[0] = name of input directory on HDFS, and arg[1] =  name of output directory to be created to store the output file.

        FileInputFormat.setInputPaths(job_conf, new Path(args[0]));
        FileOutputFormat.setOutputPath(job_conf, new Path(args[1]));

        my_client.setConf(job_conf);
        try {
            // Run the job
            JobClient.runJob(job_conf);
        } catch (Exception e) {
            e.printStackTrace();
        }
    }
}
Arkivet udvides til de samme tre kildefiler, som vist her.
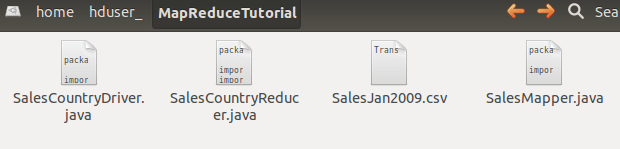
Kontroller filtilladelserne for alle disse filer

Hvis der mangler 'læse'-tilladelser, skal du give dem:

Trin 2) Eksporter Hadoop-klassestien
Eksporter klassestien som vist i Hadoop-eksemplet nedenfor.
export CLASSPATH="$HADOOP_HOME/share/hadoop/mapreduce/hadoop-mapreduce-client-core-2.2.0.jar:$HADOOP_HOME/share/hadoop/mapreduce/hadoop-mapreduce-client-common-2.2.0.jar:$HADOOP_HOME/share/hadoop/common/hadoop-common-2.2.0.jar:~/MapReduceTutorial/SalesCountry/*:$HADOOP_HOME/lib/*"
Den eksporterede klassesti afspilles igen ved prompten.

Trin 3) Kompilér Java filer
Kompilér Java filer (disse filer findes i mappen Final-MapReduceHandsOn). Deres klassefiler vil blive placeret i pakkemappen.
javac -d . SalesMapper.java SalesCountryReducer.java SalesCountryDriver.java
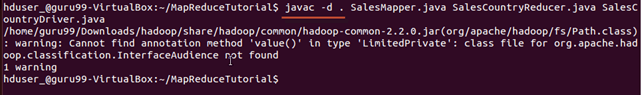
Denne advarsel kan trygt ignoreres – den rapporterer kun, at mapred API'en er udfaset.
Denne kompilering vil oprette en mappe i den aktuelle mappe med navnet på den pakkenavn, der er angivet i Java kildefilen (dvs. SalesCountry i vores tilfælde) og læg alle kompilerede klassefiler i den.

Trin 4) Opret manifestfilen
Opret en ny fil Manifest.txt
sudo gedit Manifest.txt
Tilføj følgende linje til den:
Main-Class: SalesCountry.SalesCountryDriver

SalesCountry.SalesCountryDriver er navnet på hovedklassen. Bemærk venligst, at du skal trykke på Enter-tasten i slutningen af denne linje.
Trin 5) Pak klasserne i en krukke
Opret en Jar-fil
jar cfm ProductSalePerCountry.jar Manifest.txt SalesCountry/*.class

Tjek, at jar-filen er oprettet

Trin 6) Start Hadoop
Start Hadoop
$HADOOP_HOME/sbin/start-dfs.sh
$HADOOP_HOME/sbin/start-yarn.sh
Trin 7) Kopier inputfilen til HDFS
Kopier filen SalesJan2009.csv til ~/inputMapReduce
Brug nu kommandoen nedenfor til at kopiere ~/inputMapReduce til HDFS.
$HADOOP_HOME/bin/hdfs dfs -copyFromLocal ~/inputMapReduce /
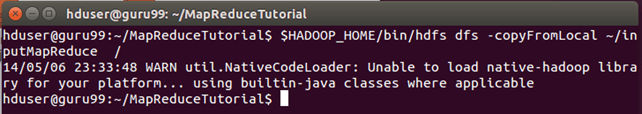
Vi kan roligt ignorere denne advarsel.
Kontroller, om en fil faktisk er kopieret eller ej.
$HADOOP_HOME/bin/hdfs dfs -ls /inputMapReduce

Trin 8) Kør MapReduce-jobbet
Kør MapReduce-job
$HADOOP_HOME/bin/hadoop jar ProductSalePerCountry.jar /inputMapReduce /mapreduce_output_sales

Dette vil oprette en output-mappe med navnet mapreduce_output_sales on HDFS. Indholdet af denne mappe vil være en fil, der indeholder produktsalg pr. land.
Trin 9) Læs resultaterne
Resultatet kan ses via kommandogrænsefladen som,
$HADOOP_HOME/bin/hdfs dfs -cat /mapreduce_output_sales/part-00000
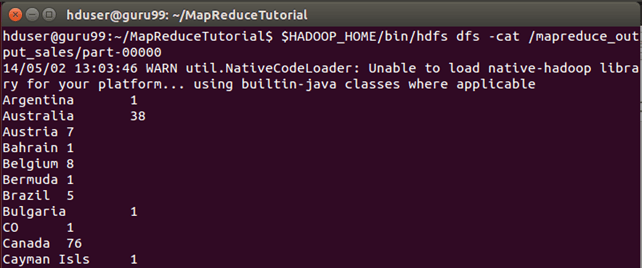
Resultater kan også ses via en webgrænseflade som-
Åbne http://localhost:50070/ i en webbrowser. På Hadoop 3.x blev NameNode-webgrænsefladen flyttet til port 9870, så brug http://localhost:9870/ der i stedet.

Vælg nu 'Gennemse filsystemet' og naviger til /mapreduce_output_sales

Åben del-r-00000

Forklaring af SalesMapper Class
Med arbejdet kørende fra ende til anden, gennemgår de næste tre afsnit, hvad hver klasse rent faktisk laver.
I dette afsnit vil vi forstå implementeringen af SalesMapper-klassen.
1. Vi starter med at angive et pakkenavn til vores klasse. SalesCountry er navnet på vores pakke. Bemærk venligst, at outputtet fra kompileringen, SalesMapper.class, vil blive placeret i en mappe med dette pakkenavn: SalesCountry.
Efterfulgt af dette importerer vi bibliotekspakker.
Nedenstående snapshot viser en implementering af SalesMapper-klassen-

Prøve Code Forklaring:
1. SalesMapper Klasse Definition-
public class SalesMapper extends MapReduceBase implements Mapper<LongWritable, Text, Text, IntWritable> {
Hver mapper-klasse skal udvides fra MapReduceBase-klassen, og den skal implementere Mapper-grænsefladen.
2. Definition af 'kort' funktion-
public void map(LongWritable key,
         Text value,
OutputCollector<Text, IntWritable> output,
Reporter reporter) throws IOException
Hoveddelen af Mapper-klassen er en 'map()'-metode, der accepterer fire argumenter.
Ved hvert kald til metoden 'map()' sendes et nøgle-værdi-par ('key' og 'value' i denne kode).
Metoden 'map()' starter med at opdele inputteksten, der modtages som et argument. Den opdeler hver linje i felter.
String valueString = value.toString();
String[] SingleCountryData = valueString.split(",");
Her bruges ',' som afgrænser.
Derefter dannes et par ved hjælp af en post ved det 7. indeks i arrayet 'SingleCountryData' og værdien '1'.
output.collect(new Text(SingleCountryData[7]), one);
Vi vælger posten ved 7. indeks, fordi vi har brug for landedata, og den er placeret ved 7. indeks i arrayet 'SingleCountryData'.
Bemærk venligst, at vores inputdata er i nedenstående format (hvor Land er på 7. indeks, med 0 som startindeks) -
Transaction_date,Product,Price,Payment_Type,Name,City,State,Country,Account_Created,Last_Login,Latitude,Longitude
Outputtet fra mapper er igen et nøgle-værdi-par, der udsendes ved hjælp af 'collect()'-metoden i 'OutputCollector'.
Forklaring af SalesCountryReducer Class
I dette afsnit vil vi forstå implementeringen af SalesCountryReducer-klassen.
1. Vi starter med at angive et navn på pakken til vores klasse. SalesCountry er navnet på vores pakke. Bemærk venligst, at outputtet fra kompileringen, SalesCountryReducer.class, vil blive placeret i en mappe med dette pakkenavn: SalesCountry.
Efterfulgt af dette importerer vi bibliotekspakker.
Nedenstående snapshot viser en implementering af SalesCountryReducer-klassen-
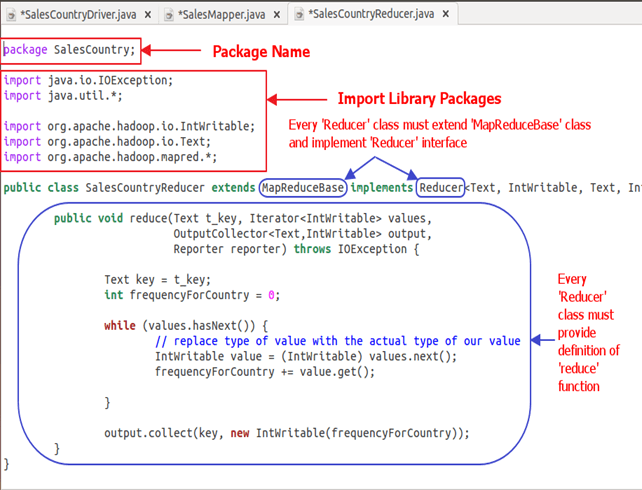
Code Forklaring:
1. SalesCountryReducer Klassedefinition-
public class SalesCountryReducer extends MapReduceBase implements Reducer<Text, IntWritable, Text, IntWritable> {
Her er de to første datatyper, 'Text' og 'IntWritable', datatypen for inputnøgleværdien til reduceringsfunktionen.
Outputtet fra mapperen er i form af , Dette output fra mapper bliver input til reduceren. Så for at justere med dens datatype bruges Text og IntWritable som datatyper her.
De sidste to datatyper, 'Tekst' og 'IntWritable', er datatypen for output genereret af reduceren i form af et nøgle-værdi-par.
Hver reducer-klasse skal udvides fra MapReduceBase-klassen, og den skal implementere Reducer-grænsefladen.
2. Definition af 'reducer' funktion-
public void reduce( Text t_key,
             Iterator<IntWritable> values,
             OutputCollector<Text,IntWritable> output,
             Reporter reporter) throws IOException {
Input til reduce()-metoden er en nøgle med en liste over flere værdier.
For eksempel vil det i vores tilfælde være-
, , , , , .
Dette gives til reducer som
Så for at acceptere argumenter af denne form bruges de første to datatyper, nemlig tekst og iterator. Tekst er en datatype for nøgle og iterator er en datatype for en liste over værdier for den pågældende nøgle.
Det næste argument er af typen OutputCollector som indsamler outputtet fra reducerfasen.
Metoden reduce() begynder med at kopiere nøgleværdien og initialisere frekvensantallet til 0.
Text key = t_key;int frequencyForCountry = 0;
Derefter bruger vi 'while'-løkken til at iterere gennem listen over værdier, der er knyttet til nøglen, og beregne den endelige frekvens ved at summere alle værdierne.
 while (values.hasNext()) {
            // replace type of value with the actual type of our value
            IntWritable value = (IntWritable) values.next();
            frequencyForCountry += value.get();

        }
Nu sender vi resultatet til output-samleren i form af nøgle og opnået frekvensantal.
Nedenstående kode gør dette-
output.collect(key, new IntWritable(frequencyForCountry));
Forklaring af SalesCountryDriver Class
I dette afsnit vil vi forstå implementeringen af SalesCountryDriver-klassen.
1. Vi starter med at angive et pakkenavn til vores klasse. SalesCountry er navnet på vores pakke. Bemærk venligst, at outputtet fra kompileringen, SalesCountryDriver.class, vil blive placeret i en mappe med dette pakkenavn: SalesCountry.
Her er en linje, der specificerer pakkenavn efterfulgt af kode for at importere bibliotekspakker.

2. Definer en driverklasse, som vil oprette et nyt klientjob, konfigurationsobjekt og annoncere Mapper- og Reducer-klasser.
Chaufførklassen er ansvarlig for at indstille vores MapReduce-job til at køre ind HadoopI denne klasse angiver vi jobnavn, datatype for input/output og navne på mapper- og reducer-klasser.

3. I nedenstående kodestykke indstiller vi input- og outputmapper, som bruges til henholdsvis at forbruge inputdatasæt og producere output.
arg[0] og arg[1] er kommandolinjeargumenterne, der sendes med en kommando givet i MapReduce hands-on, dvs.
$HADOOP_HOME/bin/hadoop jar ProductSalePerCountry.jar /inputMapReduce /mapreduce_output_sales
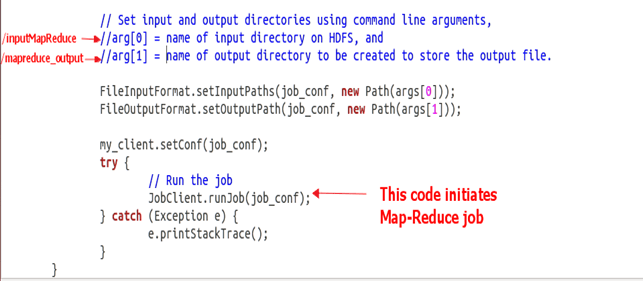
4. Udløs vores job
Koden nedenfor starter udførelsen af MapReduce-jobbet-
try {
    // Run the job
    JobClient.runJob(job_conf);
} catch (Exception e) {
    e.printStackTrace();
}
