
Kernel gaussiano nell'apprendimento automatico: Python Metodi del kernel
 Evelyn Clarke
⚡ Riepilogo intelligente
I metodi del kernel gaussiano rendono i dati non separabili linearmente separabili senza mai costruire la mappa delle caratteristiche ad alta dimensionalità. Questa procedura illustra la mappa polinomialeping Successivamente, addestra manualmente un classificatore kernel di Fourier casuale in TensorFlow.
Lo scopo di questo tutorial è rendere un set di dati linearmente separabile. Il tutorial è diviso in due parti:
- Trasformazione delle caratteristiche
- Addestra un classificatore Kernel con TensorFlow
Nella prima parte, comprenderai l'idea alla base di un metodo Kernel nell'apprendimento automatico, mentre nella seconda parte vedrai come addestrare un classificatore kernel con TensorFlowUtilizzerai il dataset degli adulti. L'obiettivo di questo dataset è classificare il reddito al di sotto e al di sopra di 50, conoscendo il comportamento di ogni nucleo familiare.
Perché hai bisogno dei metodi kernel?
L'obiettivo di ogni classificatore è prevedere correttamente le classi. Per questo, il dataset deve essere separabile. Osservate il grafico sottostante: è abbastanza semplice notare che tutti i punti al di sopra della linea nera appartengono alla prima classe e gli altri punti alla seconda. Tuttavia, è estremamente raro avere un dataset così semplice. Nella maggior parte dei casi, i dati non sono separabili, e i dati non separabili mettono in difficoltà i classificatori ingenui come la regressione logistica.
import numpy as np
  import matplotlib.pyplot as plt
  from mpl_toolkits.mplot3d import Axes3D
  x_lin = np.array([1,2,3,4,5,6,7,8,9,10])
  y_lin = np.array([2,2,3,2,2,9,6,8,8,9])
  label_lin = np.array([0,0,0,0,0,1,1,1,1,1])

  fig = plt.figure()
  ax=fig.add_subplot(111)
  plt.scatter(x_lin, y_lin, c=label_lin, s=60)
  plt.plot([-2.5, 10], [12.5, -2.5], 'k-', lw=2)
  ax.set_xlim([-5,15])
  ax.set_ylim([-5,15])plt.show()

Nella figura sottostante, rappresentiamo graficamente un insieme di dati non linearmente separabile. Se tracciassimo una linea retta, la maggior parte dei punti non verrebbe classificata nella classe corretta.
Un modo per affrontare questo problema è prendere il dataset e trasformare i dati in un'altra mappa di caratteristiche. Ciò significa utilizzare una funzione per spostare i dati su un altro piano, che dovrebbe essere linearmente separabile.
x = np.array([1,1,2,3,3,6,6,6,9,9,10,11,12,13,16,18])
y = np.array([18,13,9,6,15,11,6,3,5,2,10,5,6,1,3,1])
label = np.array([1,1,1,1,0,0,0,1,0,1,0,0,0,1,0,1])
fig = plt.figure()
plt.scatter(x, y, c=label, s=60)
plt.show()
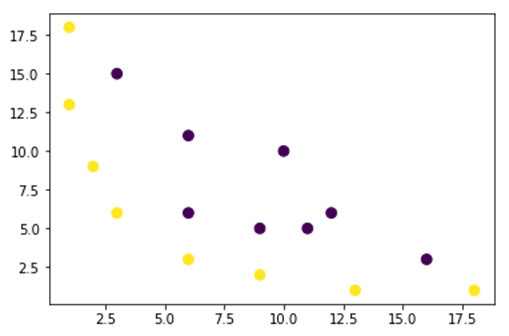
I dati della figura sopra si trovano su un piano bidimensionale e non sono separabili. Puoi provare a trasformare questi dati in tre dimensioni, ovvero creare una figura con 3 assi.
Nel nostro esempio di kernel gaussiano, applicheremo una mappa polinomialeping per portare i nostri dati in una terza dimensione. La formula per trasformare i dati è la seguente.

Si definisce una funzione nel kernel gaussiano Python per creare le nuove mappe delle caratteristiche.
Puoi usare NumPy per codificare la formula di cui sopra. Ogni riga sottostante associa un termine della mappaping con l'espressione array che la produce, e la piccola immagine indica la radice quadrata di due fattori.
| Formula | Codice NumPy equivalente |
|---|---|
| x | x[:,0] |
| y | x[:,1] |
| x² | x[:,0]**2 |
 |
np.sqrt(2)* |
| xy | x[:,0]*x[:,1] |
| y² | x[:,1]**2 |
### illustration purpose
def mapping(x, y):
	x = np.c_[(x, y)]
    if len(x) >	2:
    	x_1 = x[:,0]**2
        x_2 = np.sqrt(2)*x[:,0]*x[:,1]
        x_3 = x[:,1]**2
    else:
    	x_1 = x[0]**2
        x_2 = np.sqrt(2)*x[0]*x[1]
        x_3 = x[1]**2
   trans_x = np.array([x_1, x_2, x_3])
   return trans_x
La nuova mappaping ha 3 dimensioni e 16 punti.
x_1  = mapping(x, y)
x_1.shape
(3, 16)
Ora crea un nuovo grafico con 3 assi, x, y e z rispettivamente.
# plot
fig = plt.figure()
ax = fig.add_subplot(111, projection='3d')
ax.scatter(x_1[0], x_1[1], x_1[2], c=label, s=60)
ax.view_init(30, 185)ax.set_xlabel('X Label')
ax.set_ylabel('Y Label')
ax.set_zlabel('Z Label')
plt.show()

Notiamo un miglioramento, ma se cambiamo l'orientamento del grafico diventa chiaro che il set di dati ora è separabile.
# plot
fig = plt.figure()
ax = fig.add_subplot(111, projection='3d')
ax.scatter(x_1[0], x_1[1], x_1[1], c=label, s=60)
ax.view_init(0, -180)ax.set_ylim([150,-50])
ax.set_zlim([-10000,10000])
ax.set_xlabel('X Label')
ax.set_ylabel('Y Label')
ax.set_zlabel('Z Label')plt.show()

Se devi manipolare un set di dati di grandi dimensioni e creare più di due dimensioni, il metodo descritto sopra ti creerà un grosso problema. Infatti, dovresti trasformare tutti i punti dati, il che è chiaramente insostenibile. Richiederebbe un tempo infinito e il tuo computer potrebbe esaurire la memoria.
Il modo più comune per superare questo problema è utilizzare un kernel.
Cos'è un kernel nell'apprendimento automatico?
L'idea è quella di utilizzare uno spazio delle caratteristiche a dimensioni superiori per rendere i dati quasi linearmente separabili, come mostrato nella figura sopra.
Esistono molti spazi di dimensione superiore che rendono i punti dati separabili. Ad esempio, abbiamo dimostrato che la mappa polinomialeping è un ottimo inizio.
Abbiamo inoltre dimostrato che, con grandi quantità di dati, queste trasformazioni non sono efficienti. In alternativa, è possibile utilizzare una funzione Kernel nell'apprendimento automatico per modificare i dati senza passare a un nuovo piano di caratteristiche.
La magia del kernel sta nel trovare una funzione che eviti tutte le complicazioni implicate dal calcolo ad alta dimensionalità. Il risultato di un kernel è uno scalare, o, in altre parole, torniamo allo spazio unidimensionale.
Una volta individuata questa funzione, è possibile inserirla nel classificatore lineare standard.
Ecco un esempio che rende concreto il concetto di Kernel Machine Learning. Si hanno due vettori, x1 e x2. L'obiettivo è creare una dimensione superiore utilizzando una mappa polinomiale.pingL'output è uguale al prodotto scalare della nuova mappa delle caratteristiche. Dal metodo sopra descritto, è necessario:
- Trasforma x1 e x2 in una nuova dimensione
- Calcola il prodotto scalare: comune a tutti i kernel
Trasforma x1 e x2 in una nuova dimensione
È possibile utilizzare la funzione creata sopra per calcolare la dimensione superiore.
## Kernel
x1 = np.array([3,6])
x2 = np.array([10,10])

x_1 = mapping(x1, x2)
print(x_1)
Uscita
[[  9.         100.        ]
      [ 25.45584412 141.42135624]
      [ 36.         100.        ]]
Calcola il prodotto scalare
È possibile utilizzare il punto oggetto da NumPy per calcolare il prodotto scalare tra il primo e il secondo vettore memorizzati in x_1.
print(np.dot(x_1[:,0], x_1[:,1]))
8100.0
Il risultato è 8100. Il problema è evidente: per calcolare il prodotto scalare è necessario memorizzare una nuova mappa delle caratteristiche in memoria. Se si dispone di un dataset con milioni di record, l'operazione risulta computazionalmente inefficiente.
In alternativa, è possibile utilizzare il kernel polinomiale per calcolare il prodotto scalare senza trasformare il vettore. Questa funzione calcola il prodotto scalare di x1 e x2 come se questi due vettori fossero stati trasformati in una dimensione superiore. In altre parole, una funzione kernel calcola il risultato del prodotto scalare a partire da un altro spazio delle caratteristiche.
È possibile scrivere la funzione del kernel polinomiale Python come segue.
def polynomial_kernel(x, y, p=2):
	return (np.dot(x, y)) ** p
È la potenza del prodotto scalare di due vettori. Di seguito viene restituito il secondo grado del kernel polinomiale. L'output è uguale all'altro metodo. Questa è la magia del kernel.
polynomial_kernel(x1, x2, p=2)
8100
Tipi di metodi del kernel
Esistono diverse tecniche di kernel. La più semplice è il kernel lineare. Questa funzione funziona piuttosto bene per la classificazione del testo. Gli altri kernel sono:
- Nucleo polinomiale
- Kernel gaussiano
La tabella seguente riassume la funzione di ciascuno strumento e quando i professionisti lo utilizzano.
| nocciolo | Cosa calcola | Utilizzo tipico |
|---|---|---|
| Lineare | Il prodotto del punto semplice nello spazio delle caratteristiche originali | Dati già separabili e caratteristiche del testo ad alta dimensionalità |
| Polinomio | Il prodotto scalare elevato a un grado p, che cattura le interazioni delle caratteristiche | Confini curvi quando è noto che le interazioni sono rilevanti |
| Gaussiana (RBF) | Una similarità basata sulla distanza che tende a zero man mano che i punti si allontanano | La prima scelta di solito quando la forma del contorno è sconosciuta |
Nell'esempio con TensorFlow, useremo caratteristiche di Fourier casuali. TensorFlow ha uno stimatore integrato per calcolare il nuovo spazio delle caratteristiche. Il mapper di caratteristiche di Fourier casuali è un'approssimazione della funzione kernel gaussiana mostrata di seguito.

La funzione di filtro gaussiano calcola la somiglianza tra i punti dati in uno spazio dimensionale molto più elevato.
Una volta chiarita la teoria, il resto di questa guida illustra come applicare un kernel gaussiano a un set di dati reale.
Addestra il classificatore del kernel gaussiano con TensorFlow
L'obiettivo dell'algoritmo è classificare il reddito familiare superiore o inferiore a 50.
Innanzitutto, valuterai una regressione logistica per ottenere un modello di riferimento. Successivamente, addestrerai un classificatore Kernel per verificare se è possibile ottenere risultati migliori.
Si utilizzano le seguenti variabili dal set di dati degli adulti:
- classe operaia
- fnlwgt
- continua
- numero_istruzione
- coniugale
- occupazione
- rapporto
- gara
- sesso
- plusvalenza
- perdita_capitale
- ore_settimana
- Paese d'origine
- etichetta
Prima di addestrare e valutare il modello, procederai come segue:
- Importa le librerie
- Importa i dati
- Prepara i dati
- Costruisci il modello logistico: modello di base
- Valuta il modello
- Costruisci e valuta il classificatore Kernel.
Nota sulla versione: Ogni frammento di codice seguente è destinato a TensorFlow 1.x. Il namespace tf.contrib, che fornisce real_valued_column, RandomFourierFeatureMapper e KernelLinearClassifier, è stato rimosso in TensorFlow 2.0, e tf.estimator stesso è stato rimosso in TensorFlow 2.16. Su una versione corrente, crea la stessa pipeline con il layer tf.keras.layers.experimental.RandomFourierFeatures seguito da un layer di output Dense, oppure con la coppia RBFSampler e SGDClassifier di scikit-learn.
Passaggio 1) Importa le librerie
Per importare e addestrare i modelli kernel Intelligenza Artificiale, devi importare TensorFlow, panda e NumPy.
#import numpy as np
from sklearn.model_selection
import train_test_split
import tensorflow as tf
import pandas as pd
import numpy as np
Passaggio 2) Importa i dati
Si scaricano i dati dal Pagina del set di dati sugli adulti dell'UCI e importarlo come DataFrame di pandas.
## Define path data
COLUMNS = ['age','workclass', 'fnlwgt', 'education', 'education_num', 'marital', 'occupation', 'relationship', 'race', 'sex', 'capital_gain', 'capital_loss', 'hours_week', 'native_country', 'label']
PATH = "https://archive.ics.uci.edu/ml/machine-learning-databases/adult/adult.data"
PATH_test ="https://archive.ics.uci.edu/ml/machine-learning-databases/adult/adult.test
"## Import
df_train = pd.read_csv(PATH, skipinitialspace=True, names = COLUMNS, index_col=False)
df_test = pd.read_csv(PATH_test,skiprows = 1, skipinitialspace=True, names = COLUMNS, index_col=False)
Ora che i set di training e di test sono definiti, è possibile modificare l'etichetta della colonna da stringa a intero. TensorFlow non accetta valori stringa per l'etichetta.
label = {'<=50K': 0,'>50K': 1}
df_train.label = [label[item] for item in df_train.label]
label_t = {'<=50K.': 0,'>50K.': 1}
df_test.label = [label_t[item] for item in df_test.label]
df_train.shape
(32561, 15)
Passaggio 3) Preparare i dati
Il dataset contiene sia caratteristiche continue che categoriche. Una buona pratica è standardizzare i valori delle variabili continue. È possibile utilizzare la funzione StandardScaler da scikit-imparaÈ necessario creare anche una funzione definita dall'utente per semplificare la conversione del set di training e di test. Si noti che le variabili continue e categoriche vengono concatenate in un dataset comune e che l'array deve essere di tipo float32.
COLUMNS_INT = ['age','fnlwgt','education_num','capital_gain', 'capital_loss', 'hours_week']
CATE_FEATURES = ['workclass', 'education', 'marital', 'occupation', 'relationship', 'race', 'sex', 'native_country']
from sklearn.preprocessing import StandardScaler
from sklearn import preprocessing

def prep_data_str(df):
	scaler = StandardScaler()
    le = preprocessing.LabelEncoder()
    df_toscale = df[COLUMNS_INT]
    df_scaled = scaler.fit_transform(df_toscale.astype(np.float64))
    X_1 = df[CATE_FEATURES].apply(le.fit_transform)
    y = df['label'].astype(np.int32)
    X_conc = np.c_[df_scaled, X_1].astype(np.float32)
    return X_conc, y
La funzione transformer è pronta, quindi puoi convertire il dataset e creare la funzione input_fn.
X_train, y_train = prep_data_str(df_train)
X_test, y_test = prep_data_str(df_test)
print(X_train.shape)
(32561, 14)
Nel passaggio successivo, addestrerai una regressione logistica. Ti darà una precisione di base. L'obiettivo è superare la linea di base con un algoritmo diverso, ovvero un classificatore Kernel.
Passaggio 4) Costruire il modello logistico: modello di base
Costruisci la colonna delle funzionalità con l'oggetto real_valued_column. Si assicurerà che tutte le variabili siano dati numerici densi.
feat_column = tf.contrib.layers.real_valued_column('features', dimension=14)
Lo stimatore viene definito utilizzando l'API TensorFlow Estimator; è necessario specificare le colonne delle caratteristiche e la posizione in cui salvare il grafico.
estimator = tf.estimator.LinearClassifier(feature_columns=[feat_column],
                                          n_classes=2,
                                          model_dir = "kernel_log"
                                         )
INFO:tensorflow:Using default config.INFO:tensorflow:Using config: {'_model_dir': 'kernel_log', '_tf_random_seed': None, '_save_summary_steps': 100, '_save_checkpoints_steps': None, '_save_checkpoints_secs': 600, '_session_config': None, '_keep_checkpoint_max': 5, '_keep_checkpoint_every_n_hours': 10000, '_log_step_count_steps': 100, '_train_distribute': None, '_service': None, '_cluster_spec': <tensorflow.python.training.server_lib.ClusterSpec object at 0x1a2003f780>, '_task_type': 'worker', '_task_id': 0, '_global_id_in_cluster': 0, '_master': '', '_evaluation_master': '', '_is_chief': True, '_num_ps_replicas': 0, '_num_worker_replicas': 1}
Addestrerai la regressione logistica utilizzando mini-batch di dimensione 200.
# Train the model
train_input_fn = tf.estimator.inputs.numpy_input_fn(
	x={"features": X_train},
    y=y_train,
    batch_size=200,
    num_epochs=None,
    shuffle=True)
È possibile addestrare il modello con 1,000 iterazioni.
estimator.train(input_fn=train_input_fn, steps=1000)
INFO:tensorflow:Calling model_fn.
INFO:tensorflow:Done calling model_fn.
INFO:tensorflow:Create CheckpointSaverHook.
INFO:tensorflow:Graph was finalized.
INFO:tensorflow:Running local_init_op.
INFO:tensorflow:Done running local_init_op.
INFO:tensorflow:Saving checkpoints for 1 into kernel_log/model.ckpt.
INFO:tensorflow:loss = 138.62949, step = 1
INFO:tensorflow:global_step/sec: 324.16
INFO:tensorflow:loss = 87.16762, step = 101 (0.310 sec)
INFO:tensorflow:global_step/sec: 267.092
INFO:tensorflow:loss = 71.53657, step = 201 (0.376 sec)
INFO:tensorflow:global_step/sec: 292.679
INFO:tensorflow:loss = 69.56703, step = 301 (0.340 sec)
INFO:tensorflow:global_step/sec: 225.582
INFO:tensorflow:loss = 74.615875, step = 401 (0.445 sec)
INFO:tensorflow:global_step/sec: 209.975
INFO:tensorflow:loss = 76.49044, step = 501 (0.475 sec)
INFO:tensorflow:global_step/sec: 241.648
INFO:tensorflow:loss = 66.38373, step = 601 (0.419 sec)
INFO:tensorflow:global_step/sec: 305.193
INFO:tensorflow:loss = 87.93341, step = 701 (0.327 sec)
INFO:tensorflow:global_step/sec: 396.295
INFO:tensorflow:loss = 76.61518, step = 801 (0.249 sec)
INFO:tensorflow:global_step/sec: 359.857
INFO:tensorflow:loss = 78.54885, step = 901 (0.277 sec)
INFO:tensorflow:Saving checkpoints for 1000 into kernel_log/model.ckpt.
INFO:tensorflow:Loss for final step: 67.79706.


<tensorflow.python.estimator.canned.linear.LinearClassifier at 0x1a1fa3cbe0>
Passaggio 5) Valutare il modello
Si definisce la funzione di input NumPy per valutare il modello. Per la valutazione si utilizza l'intero set di test.
# Evaluation
test_input_fn = tf.estimator.inputs.numpy_input_fn(
    x={"features": X_test},
    y=y_test,
    batch_size=16281,
    num_epochs=1,
    shuffle=False)
estimator.evaluate(input_fn=test_input_fn, steps=1)
INFO:tensorflow:Calling model_fn.
WARNING:tensorflow:Trapezoidal rule is known to produce incorrect PR-AUCs; please switch to "careful_interpolation" instead.
WARNING:tensorflow:Trapezoidal rule is known to produce incorrect PR-AUCs; please switch to "careful_interpolation" instead.
INFO:tensorflow:Done calling model_fn.
INFO:tensorflow:Starting evaluation at 2018-07-12-15:58:22
INFO:tensorflow:Graph was finalized.
INFO:tensorflow:Restoring parameters from kernel_log/model.ckpt-1000
INFO:tensorflow:Running local_init_op.
INFO:tensorflow:Done running local_init_op.
INFO:tensorflow:Evaluation [1/1]
INFO:tensorflow:Finished evaluation at 2018-07-12-15:58:23
INFO:tensorflow:Saving dict for global step 1000: accuracy = 0.82353663, accuracy_baseline = 0.76377374, auc = 0.84898686, auc_precision_recall = 0.67214864, average_loss = 0.3877216, global_step = 1000, label/mean = 0.23622628, loss = 6312.495, precision = 0.7362797, prediction/mean = 0.21208474, recall = 0.39417577
{'accuracy': 0.82353663,
 'accuracy_baseline': 0.76377374,
 'auc': 0.84898686,
 'auc_precision_recall': 0.67214864,
 'average_loss': 0.3877216,
 'global_step': 1000,
 'label/mean': 0.23622628,
 'loss': 6312.495,
 'precision': 0.7362797,
 'prediction/mean': 0.21208474,
 'recall': 0.39417577}
Hai ottenuto un'accuratezza dell'82%. Nella prossima sezione, proverai a superare il classificatore logistico con un classificatore Kernel.
Passaggio 6) Costruisci il classificatore Kernel
Lo stimatore kernel non è poi così diverso dal tradizionale classificatore lineare, almeno in termini di costruzione. L'idea alla base è quella di combinare la potenza di una mappa kernel esplicitaping con il classificatore lineare.
Sono necessari due stimatori predefiniti disponibili in TensorFlow per addestrare il classificatore del kernel:
- RandomFourierFeatureMapper
- KernelLinearClassifier
Nella prima sezione hai appreso che è necessario trasformare la dimensione bassa in una dimensione alta utilizzando una funzione kernel. Più precisamente, utilizzerai caratteristiche di Fourier casuali, che approssimano la funzione gaussiana. TensorFlow 1.x fornisce questa mappaturaping come RandomFourierFeatureMapper, e il modello può essere addestrato utilizzando lo stimatore KernelLinearClassifier.
Per costruire il modello, seguirai questi passaggi:
- Imposta la funzione Kernel ad alta dimensione
- Imposta l'iperparametro L2
- Costruisci il modello
- Allena il modello
- Valuta il modello
Passaggio A) Impostare la funzione kernel ad alta dimensione
Il dataset corrente contiene 14 caratteristiche che trasformerete in un nuovo vettore a 5,000 dimensioni. Per effettuare la trasformazione, utilizzerete le caratteristiche casuali di Fourier. Ricordando la formula del kernel gaussiano, noterete che è necessario definire un parametro di deviazione standard. Questo parametro controlla la misura di similarità utilizzata durante la classificazione: un valore piccolo di stddev fa sì che il kernel consideri simili solo i punti molto vicini, mentre un valore grande uniforma il confine di decisione.
Puoi ottimizzare tutti i parametri in RandomFourierFeatureMapper con:
- ingresso_dim = 14
- dimensione_uscita = 5000
- deviazione standard = 4
### Prep Kernel
kernel_mapper = tf.contrib.kernel_methods.RandomFourierFeatureMapper(input_dim=14, output_dim=5000, stddev=4, name='rffm')
È necessario costruire il mappatore del kernel utilizzando le colonne delle funzionalità create prima: feat_column
### Map Kernel
kernel_mappers = {feat_column: [kernel_mapper]}
Passaggio B) Impostare l'iperparametro L2
Per evitare l'overfitting, si penalizza la funzione di perdita con il regolarizzatore L2. Si imposta l'iperparametro L2 a 0.1 e il tasso di apprendimento a 5.
optimizer = tf.train.FtrlOptimizer(learning_rate=5, l2_regularization_strength=0.1)
Fase C) Costruire il modello
Il passaggio successivo è simile alla classificazione lineare. Si utilizza l'estimatore integrato KernelLinearClassifier. Si noti che è necessario aggiungere il kernel mapper definito in precedenza e modificare la directory del modello.
### Prep estimator
estimator_kernel = tf.contrib.kernel_methods.KernelLinearClassifier(
    n_classes=2,
    optimizer=optimizer,
    kernel_mappers=kernel_mappers,
    model_dir="kernel_train")
Gli avvisi di deprecazione riportati di seguito sono previsti per TensorFlow 1.x, poiché il modulo kernel_methods è basato sugli stimatori tf.contrib.learn, una versione precedente.
WARNING:tensorflow:From /Users/Thomas/anaconda3/envs/hello-tf/lib/python3.6/site-packages/tensorflow/contrib/kernel_methods/python/kernel_estimators.py:305: multi_class_head (from tensorflow.contrib.learn.python.learn.estimators.head) is deprecated and will be removed in a future version. Instructions for updating: Please switch to tf.contrib.estimator.*_head. WARNING:tensorflow:From /Users/Thomas/anaconda3/envs/hello-tf/lib/python3.6/site-packages/tensorflow/contrib/learn/python/learn/estimators/estimator.py:1179: BaseEstimator.__init__ (from tensorflow.contrib.learn.python.learn.estimators.estimator) is deprecated and will be removed in a future version. Instructions for updating: Please replace uses of any Estimator from tf.contrib.learn with an Estimator from tf.estimator.* WARNING:tensorflow:From /Users/Thomas/anaconda3/envs/hello-tf/lib/python3.6/site-packages/tensorflow/contrib/learn/python/learn/estimators/estimator.py:427: RunConfig.__init__ (from tensorflow.contrib.learn.python.learn.estimators.run_config) is deprecated and will be removed in a future version. Instructions for updating: When switching to tf.estimator.Estimator, use tf.estimator.RunConfig instead. INFO:tensorflow:Using default config. INFO:tensorflow:Using config: {'_task_type': None, '_task_id': 0, '_cluster_spec': <tensorflow.python.training.server_lib.ClusterSpec object at 0x1a200ae550>, '_master': '', '_num_ps_replicas': 0, '_num_worker_replicas': 0, '_environment': 'local', '_is_chief': True, '_evaluation_master': '', '_train_distribute': None, '_tf_config': gpu_options { per_process_gpu_memory_fraction: 1.0 } , '_tf_random_seed': None, '_save_summary_steps': 100, '_save_checkpoints_secs': 600, '_log_step_count_steps': 100, '_session_config': None, '_save_checkpoints_steps': None, '_keep_checkpoint_max': 5, '_keep_checkpoint_every_n_hours': 10000, '_model_dir': 'kernel_train'}
Fase D) Addestrare il modello
Ora che il classificatore Kernel è stato creato, sei pronto per addestrarlo. Scegli di iterare il modello 2,000 volte.
### estimate
estimator_kernel.fit(input_fn=train_input_fn, steps=2000)
WARNING:tensorflow:Casting <dtype: 'int32'> labels to bool. WARNING:tensorflow:Casting <dtype: 'int32'> labels to bool. WARNING:tensorflow:Trapezoidal rule is known to produce incorrect PR-AUCs; please switch to "careful_interpolation" instead. WARNING:tensorflow:Trapezoidal rule is known to produce incorrect PR-AUCs; please switch to "careful_interpolation" instead. WARNING:tensorflow:From /Users/Thomas/anaconda3/envs/hello-tf/lib/python3.6/site-packages/tensorflow/contrib/learn/python/learn/estimators/head.py:678: ModelFnOps.__new__ (from tensorflow.contrib.learn.python.learn.estimators.model_fn) is deprecated and will be removed in a future version. Instructions for updating: When switching to tf.estimator.Estimator, use tf.estimator.EstimatorSpec. You can use the `estimator_spec` method to create an equivalent one. INFO:tensorflow:Create CheckpointSaverHook. INFO:tensorflow:Graph was finalized. INFO:tensorflow:Running local_init_op. INFO:tensorflow:Done running local_init_op. INFO:tensorflow:Saving checkpoints for 1 into kernel_train/model.ckpt. INFO:tensorflow:loss = 0.6931474, step = 1 INFO:tensorflow:global_step/sec: 86.6365 INFO:tensorflow:loss = 0.39374447, step = 101 (1.155 sec) INFO:tensorflow:global_step/sec: 80.1986 INFO:tensorflow:loss = 0.3797774, step = 201 (1.247 sec) INFO:tensorflow:global_step/sec: 79.6376 INFO:tensorflow:loss = 0.3908726, step = 301 (1.256 sec) INFO:tensorflow:global_step/sec: 95.8442 INFO:tensorflow:loss = 0.41890752, step = 401 (1.043 sec) INFO:tensorflow:global_step/sec: 93.7799 INFO:tensorflow:loss = 0.35700393, step = 501 (1.066 sec) INFO:tensorflow:global_step/sec: 94.7071 INFO:tensorflow:loss = 0.35535482, step = 601 (1.056 sec) INFO:tensorflow:global_step/sec: 90.7402 INFO:tensorflow:loss = 0.3692882, step = 701 (1.102 sec) INFO:tensorflow:global_step/sec: 94.4924 INFO:tensorflow:loss = 0.34746957, step = 801 (1.058 sec) INFO:tensorflow:global_step/sec: 95.3472 INFO:tensorflow:loss = 0.33655524, step = 901 (1.049 sec) INFO:tensorflow:global_step/sec: 97.2928 INFO:tensorflow:loss = 0.35966292, step = 1001 (1.028 sec) INFO:tensorflow:global_step/sec: 85.6761 INFO:tensorflow:loss = 0.31254214, step = 1101 (1.167 sec) INFO:tensorflow:global_step/sec: 91.4194 INFO:tensorflow:loss = 0.33247527, step = 1201 (1.094 sec) INFO:tensorflow:global_step/sec: 82.5954 INFO:tensorflow:loss = 0.29305756, step = 1301 (1.211 sec) INFO:tensorflow:global_step/sec: 89.8748 INFO:tensorflow:loss = 0.37943482, step = 1401 (1.113 sec) INFO:tensorflow:global_step/sec: 76.9761 INFO:tensorflow:loss = 0.34204718, step = 1501 (1.300 sec) INFO:tensorflow:global_step/sec: 73.7192 INFO:tensorflow:loss = 0.34614792, step = 1601 (1.356 sec) INFO:tensorflow:global_step/sec: 83.0573 INFO:tensorflow:loss = 0.38911164, step = 1701 (1.204 sec) INFO:tensorflow:global_step/sec: 71.7029 INFO:tensorflow:loss = 0.35255936, step = 1801 (1.394 sec) INFO:tensorflow:global_step/sec: 73.2663 INFO:tensorflow:loss = 0.31130585, step = 1901 (1.365 sec) INFO:tensorflow:Saving checkpoints for 2000 into kernel_train/model.ckpt. INFO:tensorflow:Loss for final step: 0.37795097. KernelLinearClassifier(params={'head': <tensorflow.contrib.learn.python.learn.estimators.head._BinaryLogisticHead object at 0x1a2054cd30>, 'feature_columns': {_RealValuedColumn(column_name='features_MAPPED', dimension=5000, default_value=None, dtype=tf.float32, normalizer=None)}, 'optimizer': <tensorflow.python.training.ftrl.FtrlOptimizer object at 0x1a200aec18>, 'kernel_mappers': {_RealValuedColumn(column_name='features', dimension=14, default_value=None, dtype=tf.float32, normalizer=None): [<tensorflow.contrib.kernel_methods.python.mappers.random_fourier_features.RandomFourierFeatureMapper object at 0x1a200ae400>]}})
Fase E) Valutare il modello
Ultimo ma non meno importante, valuti le prestazioni del tuo modello. Dovresti essere in grado di sconfiggere la regressione logistica.
# Evaluate and report metrics.
eval_metrics = estimator_kernel.evaluate(input_fn=test_input_fn, steps=1)
WARNING:tensorflow:Casting <dtype: 'int32'> labels to bool. WARNING:tensorflow:Casting <dtype: 'int32'> labels to bool. WARNING:tensorflow:Trapezoidal rule is known to produce incorrect PR-AUCs; please switch to "careful_interpolation" instead. WARNING:tensorflow:Trapezoidal rule is known to produce incorrect PR-AUCs; please switch to "careful_interpolation" instead. INFO:tensorflow:Starting evaluation at 2018-07-12-15:58:50 INFO:tensorflow:Graph was finalized. INFO:tensorflow:Restoring parameters from kernel_train/model.ckpt-2000 INFO:tensorflow:Running local_init_op. INFO:tensorflow:Done running local_init_op. INFO:tensorflow:Evaluation [1/1] INFO:tensorflow:Finished evaluation at 2018-07-12-15:58:51 INFO:tensorflow:Saving dict for global step 2000: accuracy = 0.83975184, accuracy/baseline_label_mean = 0.23622628, accuracy/threshold_0.500000_mean = 0.83975184, auc = 0.8904007, auc_precision_recall = 0.72722375, global_step = 2000, labels/actual_label_mean = 0.23622628, labels/prediction_mean = 0.23786618, loss = 0.34277728, precision/positive_threshold_0.500000_mean = 0.73001117, recall/positive_threshold_0.500000_mean = 0.5104004
L'accuratezza finale è dell'84%, circa 1.6 punti percentuali al di sopra del valore di riferimento della regressione logistica (0.83975184 contro 0.82353663). Esiste un compromesso tra il miglioramento dell'accuratezza e il costo computazionale. È necessario valutare se tale miglioramento giustifichi il tempo impiegato dal classificatore più complesso e se abbia un impatto significativo sulla propria attività.
