
Tutorial sulla regressione lineare con TensorFlow [Esempi]
 Team editoriale
⚡ Riepilogo intelligente
La regressione lineare in TensorFlow modella la relazione tra caratteristiche numeriche e un valore target continuo. Questa guida illustra come addestrare un predittore dei prezzi delle case a Boston in tre modi diversi, utilizzando Pandas, NumPy e le pipeline di input native di TensorFlow con lo stimatore LinearRegressor.
Che cos'è la regressione lineare?
Regressione lineare La regressione lineare è un approccio statistico per modellare le relazioni tra due variabili. Questa modellazione viene effettuata tra una variabile di risposta scalare e una o più variabili esplicative. La relazione con una sola variabile esplicativa è detta regressione lineare semplice, mentre con più di una variabile esplicativa è detta regressione lineare multipla.
TensorFlow fornisce strumenti per avere il pieno controllo dei calcoli. Questo viene fatto con l'API di basso livello. Oltre a ciò, TensorFlow è dotato di una vasta gamma di API per eseguirne molte machine learning algoritmi. Questa è l'API di alto livello e TensorFlow li chiama stimatori.
- API di basso livelloCostruisci l'architettura e ottimizza il modello da zero. È complicato per un principiante.
- API di alto livello: Definisci l'algoritmo. È di facile utilizzo. TensorFlow fornisce una toolbox chiamata estimatore costruire, addestrare, valutare e fare una previsione.
In questo tutorial utilizzerai il file solo estimatoriI calcoli sono più veloci e più facili da implementare. La prima parte spiega come utilizzare l'ottimizzatore di discesa del gradiente per addestrare una regressione lineare in TensorFlow. Nella seconda parte, utilizzerai il dataset di Boston per prevedere il prezzo di una casa utilizzando uno stimatore di TensorFlow.
Come addestrare un modello di regressione lineare
Prima di iniziare ad addestrare il modello, vediamo cos'è effettivamente la regressione lineare.
Immagina di avere due variabili, x e y, e il tuo compito è prevedere il valore di y conoscendo il valore di x. Se rappresenti graficamente i dati, puoi osservare una relazione positiva tra la variabile indipendente, x, e la variabile dipendente, y, come mostrato nel diagramma a dispersione sottostante.

Si può notare che se x=1, y sarà approssimativamente uguale a 6, e se x=2, y sarà intorno a 8.5.
Questo metodo non è molto preciso ed è soggetto a errori, soprattutto con un set di dati contenente centinaia di migliaia di punti.
Una regressione lineare viene valutata con un'equazione. La variabile y è spiegata da una o più covariate. Nel tuo esempio, c'è solo una variabile dipendente. Se devi scrivere questa equazione, sarà:

con:
 è la distorsione. Cioè, se x=0, y=
 è il peso associato a x
 è il residuo, o errore del modello. Include ciò che il modello non riesce ad apprendere dai dati
Immagina di adattare il modello e di trovare la seguente soluzione per:
- = 3.8
- = 2.78
Puoi sostituire quei numeri nell'equazione e diventa:
y= 3.8 + 2.78x
Ora hai un metodo migliore per trovare i valori di y. Ovvero, puoi sostituire x con qualsiasi valore desideri per prevedere y. Nell'immagine qui sotto, abbiamo sostituito x nell'equazione con tutti i valori presenti nel dataset e abbiamo tracciato il risultato.

La linea rossa rappresenta il valore stimato, ovvero i valori di y per ciascun valore di x. Non è necessario conoscere il valore di x per prevedere y; per ogni x esiste un valore che appartiene alla linea rossa. È possibile effettuare previsioni anche per valori di x superiori a 2.
Se si desidera estendere la regressione lineare a un maggior numero di covariabili, è possibile farlo aggiungendo ulteriori variabili al modello. La differenza tra l'analisi tradizionale e la regressione lineare sta nel fatto che quest'ultima considera come y reagirà per ciascuna variabile x presa indipendentemente.
Facciamo un esempio. Immaginiamo di voler prevedere le vendite di una gelateria. Il set di dati contiene diverse informazioni, come le condizioni meteorologiche (pioggia, sole, nuvoloso) e informazioni sui clienti (stipendio, sesso, stato civile).
L'analisi tradizionale cercherà di prevedere le vendite, ad esempio, calcolando la media per ciascuna variabile e tentando di stimare le vendite per diversi scenari. Questo approccio porterà a previsioni imprecise e limiterà l'analisi allo scenario prescelto.
Se usi la regressione lineare, puoi scrivere questa equazione:
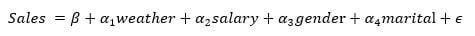
L'algoritmo troverà la soluzione migliore per i pesi; ciò significa che cercherà di minimizzare il costo, che è la differenza tra la retta di regressione e i punti dati.
Come funziona l'algoritmo
Il diagramma seguente riassume il ciclo ripetuto dall'algoritmo: selezionare i pesi, prevedere y, misurare l'errore e correggere i pesi.

L'algoritmo sceglierà un numero casuale per ciascuno  and
 e sostituire il valore di x per ottenere il valore previsto di y. Se il set di dati contiene 100 osservazioni, l'algoritmo calcola 100 valori previsti.
Possiamo calcolare l'errore, notato  , del modello, che è la differenza tra il valore previsto e il valore reale. Un errore positivo significa che il modello sottostima la previsione di y, e un errore negativo significa che il modello sovrastima la previsione di y.

Il tuo obiettivo è minimizzare il quadrato dell'errore. L'algoritmo calcola la media dell'errore quadratico. Questo passaggio è chiamato minimizzazione dell'errore. Per la regressione lineare, questo è il Errore quadratico medio, detto anche MSE. Matematicamente è:

Dove:
 sono i pesi, quindi
 si riferisce al valore previsto
- y sono i valori reali
- m è il numero di osservazioni
 si riferisce al valore previsto
Si noti che  significa che utilizza la trasposizione delle matrici. IL
 è la notazione matematica della media.
L'obiettivo è trovare il meglio  che minimizza l'MSE.
Se l’errore medio è elevato, significa che il modello funziona male e i pesi non sono scelti correttamente. Per correggere i pesi è necessario utilizzare un ottimizzatore. Si chiama l'ottimizzatore tradizionale Discesa a gradiente.
La discesa del gradiente prende la derivata e diminuisce o aumenta il peso. Se la derivata è positiva, il peso viene diminuito. Se la derivata è negativa, il peso aumenta. Il modello aggiornerà i pesi e ricalcolerà l'errore. Questo processo viene ripetuto finché l'errore non cambia più. Ogni passaggio è chiamato un iterazioneInoltre, i gradienti vengono moltiplicati per un tasso di apprendimento, che indica la velocità dell'apprendimento.
Se il tasso di apprendimento è troppo basso, l'algoritmo impiegherà molto tempo a convergere, poiché richiederà molte più iterazioni. Se il tasso di apprendimento è troppo alto, l'algoritmo potrebbe non convergere mai. La curva di perdita sottostante rappresenta l'errore in funzione del numero di iterazioni per questo dataset.

Come si può vedere dall'immagine qui sopra, il modello ripete il processo circa 20 volte prima di trovare un valore stabile per i pesi, raggiungendo quindi l'errore minimo.
Si noti che l'errore non è pari a zero, ma si stabilizza intorno a 5. Ciò significa che il modello presenta un errore tipico di 5. Per ridurre l'errore, è necessario aggiungere ulteriori informazioni al modello, come ad esempio più variabili, oppure utilizzare stimatori diversi.
Ricorderete la prima equazione:

I pesi finali sono 3.8 e 2.78. Il video qui sotto mostra come la discesa del gradiente ottimizza la funzione di perdita per trovare questi pesi.
Come addestrare una regressione lineare con TensorFlow
Ora che hai una migliore comprensione di ciò che accade dietro le quinte, sei pronto per utilizzare l'API di stima fornita da TensorFlow per addestrare la tua prima regressione lineare utilizzando TensorFlow.
Nota sulla versione: Il flusso di lavoro dell'estimatore mostrato di seguito è stato scritto per TensorFlow 1.x e le prime versioni 2.x. TensorFlow ha contrassegnato il tf.estimator and tf.feature_column API completamente deprecate nella versione 2.12 e Estimator rimossi nella versione 2.16. Su un'installazione corrente, esegui questo codice all'interno di un TensorFlow 1.15 o 2.x-con-tf.compat.v1 ambiente, oppure portarlo su Keras, dove tf.keras.layers.Dense(1) Inoltre, i livelli di preelaborazione sostituiscono il LinearRegressor e le colonne delle caratteristiche. I concetti — caratteristiche, etichette, batch, epoche, MSE e discesa del gradiente — rimangono invariati.
Utilizzerai il dataset di Boston, che include le seguenti variabili.
| Variabile | Descrizione |
| criminale | tasso di criminalità pro capite per città |
| zn | percentuale di terreno residenziale suddiviso in zone per lotti superiori a 25,000 piedi quadrati. |
| Indus | percentuale di ettari commerciali non al dettaglio per città. |
| nox | concentrazione di ossidi nitrici |
| rm | numero medio di stanze per abitazione |
| percentuale di unità abitative costruite prima del 1940 | |
| DIS | distanze ponderate da cinque centri per l'impiego di Boston |
| imposta | aliquota dell'imposta sulla proprietà a valore intero per dollari 10,000 |
| ptratio | rapporto alunni-insegnanti per comune |
| medv | Valore medio delle case occupate dai proprietari in migliaia di dollari |
Creerai tre diversi set di dati:
| dataset | obiettivo | shape |
| Formazione | Addestrare il modello e ottenere i pesi | 400, 10 |
| Valutazione | Valutare le prestazioni del modello su dati invisibili | 100, 10 |
| Prevedere | Utilizza il modello per prevedere il valore della casa sulla base di nuovi dati | 6, 10 |
L'obiettivo è utilizzare le caratteristiche del dataset per prevedere il valore della casa.
Nella seconda parte del tutorial, imparerai come utilizzare TensorFlow con tre diversi metodi per importare i dati:
- Con i panda
- Con NumPy
- Solo TensorFlow
Si noti che tutte e tre le opzioni forniscono gli stessi risultati.
Imparerai come utilizzare l'API di alto livello per costruire, addestrare e valutare un modello di regressione lineare TensorFlow. Se utilizzassi l'API di basso livello, dovresti definire manualmente:
- Funzione di perdita
- Ottimizzatore: discesa del gradiente
- Moltiplicazione della matrice
- Grafico e tensore
Questo è un processo noioso e più complicato per un principiante.
Soluzione Pandas
È necessario importare le librerie necessarie per addestrare il modello.
import pandas as pd
from sklearn import datasets
import tensorflow as tf
import itertools
Passo 1) Importa i dati con Pandas.
È possibile definire i nomi delle colonne e memorizzarli in COLUMNS. Per importare i dati è possibile utilizzare pd.read_csv().
COLUMNS = ["crim", "zn", "indus", "nox", "rm", "age",
           "dis", "tax", "ptratio", "medv"]
Indirizza ciascuna chiamata ai file CSV che hai scaricato in precedenza.
training_set = pd.read_csv("E:/boston_train.csv", skipinitialspace=True,skiprows=1, names=COLUMNS)
test_set = pd.read_csv("E:/boston_test.csv", skipinitialspace=True,skiprows=1, names=COLUMNS)
prediction_set = pd.read_csv("E:/boston_predict.csv", skipinitialspace=True,skiprows=1, names=COLUMNS)
È possibile stampare la forma dei dati.
print(training_set.shape, test_set.shape, prediction_set.shape)
Uscita
(400, 10) (100, 10) (6, 10)
Tieni presente che l'etichetta, ovvero la tua y, è inclusa nel dataset. Quindi devi definire altre due liste: una contenente solo le caratteristiche e una con solo il nome dell'etichetta. Queste due liste indicheranno al tuo stimatore quali sono le caratteristiche nel dataset e quale nome di colonna corrisponde all'etichetta.
Si fa con il codice qui sotto.
FEATURES = ["crim", "zn", "indus", "nox", "rm",
                 "age", "dis", "tax", "ptratio"]
LABEL = "medv"
Passo 2) Converti i dati
È necessario convertire le variabili numeriche nel formato corretto. TensorFlow fornisce un metodo per convertire una variabile continua: tf.feature_column.numeric_column().
Nel passaggio precedente, hai definito un elenco di caratteristiche che desideri includere nel modello. Ora puoi utilizzare questo elenco per convertirle in dati numerici. Se desideri escludere delle caratteristiche dal tuo modello, puoi tranquillamente eliminare una o più variabili dall'elenco FEATURES prima di costruire feature_cols.
Nota che utilizzerai un Python Utilizza una list comprehension con la lista FEATURES per creare una nuova lista chiamata feature_cols. Questo ti permette di evitare di scrivere tf.feature_column.numeric_column() nove volte. Una list comprehension è un modo più veloce e pulito per creare nuove liste.
feature_cols = [tf.feature_column.numeric_column(k) for k in FEATURES]
Passo 3) Definire lo stimatore
In questa fase, è necessario definire l'estimatore. TensorFlow fornisce sei estimatori predefiniti, tre per le attività di classificazione e tre per le attività di regressione di TensorFlow:
- Regressore
- DNNRegressore
- Regressore lineare
- DNNLinearCombinedRegressor
- classificare
- DNNClassificatore
- Classificatore lineare
- Classificatore combinato lineare DNN
In questo tutorial utilizzerai il regressore lineare. Per accedere a questa funzione, è necessario utilizzare tf.estimator.
La funzione necessita di due argomenti:
- feature_columns: contiene le variabili da includere nel modello
- model_dir: percorso in cui memorizzare il grafico, salvare i parametri del modello e così via.
TensorFlow creerà automaticamente una cartella chiamata train nella tua directory di lavoro. Devi usare questo percorso per accedere Scheda Tensor, come mostrato nell'esempio di regressione TensorFlow riportato di seguito.
estimator = tf.estimator.LinearRegressor(
        feature_columns=feature_cols,
        model_dir="train")
Uscita
INFO:tensorflow:Using default config.
INFO:tensorflow:Using config: {'_model_dir': 'train', '_tf_random_seed': None, '_save_summary_steps': 100, '_save_checkpoints_steps': None, '_save_checkpoints_secs': 600, '_session_config': None, '_keep_checkpoint_max': 5, '_keep_checkpoint_every_n_hours': 10000, '_log_step_count_steps': 100, '_train_distribute': None, '_service': None, '_cluster_spec': <tensorflow.python.training.server_lib.ClusterSpec object at 0x1a215dc550>, '_task_type': 'worker', '_task_id': 0, '_global_id_in_cluster': 0, '_master': '', '_evaluation_master': '', '_is_chief': True, '_num_ps_replicas': 0, '_num_worker_replicas': 1}
La difficoltà maggiore con TensorFlow risiede nel modo in cui alimenta il modello. TensorFlow è progettato per funzionare con il calcolo parallelo e set di dati molto grandi. A causa delle limitazioni delle risorse hardware, è impossibile alimentare il modello con tutti i dati in una sola volta. Per questo motivo, è necessario fornire i dati in batch. È importante notare che stiamo parlando di set di dati enormi, con milioni o più di record. Se non si procede per batch, si rischia un errore di memoria.
Ad esempio, se i tuoi dati contengono 100 osservazioni e definisci una dimensione batch pari a 10, significa che il modello vedrà 10 osservazioni per ogni iterazione (10*10).
Quando il modello ha analizzato tutti i dati, termina un'epoca. Un'epoca definisce quante volte si desidera che il modello analizzi i dati. È preferibile impostare questo passaggio su "nessuno" e lasciare che il modello esegua un numero predefinito di iterazioni.
Un secondo elemento da aggiungere riguarda la possibilità di mescolare i dati prima di ogni iterazione. Durante l'addestramento, è importante mescolare i dati in modo che il modello non apprenda uno schema specifico del dataset. Se il modello apprende i dettagli dello schema sottostante dei dati, avrà difficoltà a generalizzare la previsione a dati non visti. Questo fenomeno è chiamato overfitting. Il modello si comporta bene sui dati di addestramento, ma non è in grado di prevedere correttamente i dati non visti.
TensorFlow semplifica questi due passaggi. Quando i dati arrivano alla pipeline, sa di quante osservazioni ha bisogno (batch) e se deve mescolare i dati.
Per indicare a TensorFlow come alimentare il modello, è possibile utilizzare `pandas_input_fn`. Questo oggetto richiede cinque parametri:
- x: dati sulle caratteristiche
- y: dati dell'etichetta
- batch_size: lotto. Di default 128
- num_epoch: numero di epoche, di default 1
- mescola: mescola i dati o no. Per impostazione predefinita, Nessuno
È necessario fornire input al modello più volte, quindi si definisce una funzione per ripetere questo processo. Chiamare questa funzione get_input_fn.
def get_input_fn(data_set, num_epochs=None, n_batch = 128, shuffle=True):
         return tf.estimator.inputs.pandas_input_fn(
         x=pd.DataFrame({k: data_set[k].values for k in FEATURES}),
         y = pd.Series(data_set[LABEL].values),
         batch_size=n_batch,
         num_epochs=num_epochs,
         shuffle=shuffle)
Il metodo usuale per valutare le prestazioni di un modello è:
- Allena il modello
- Valuta il modello su un set di dati diverso
- Fare una previsione
L'estimatore di TensorFlow offre tre diverse funzioni per eseguire facilmente questi tre passaggi.
Passo 4) Allena il modello
È possibile utilizzare il metodo `train` dell'estimatore per addestrare il modello. L'estimatore di addestramento richiede una funzione di input (`input_fn`) e un numero di passaggi. È possibile utilizzare la funzione creata in precedenza per alimentare il modello. Quindi si indica al modello di iterare 1000 volte. Si noti che non si specifica il numero di epoche; si lascia che il modello iteri 1000 volte. Se si imposta il numero di epoche a 1, il modello itererà quattro volte, poiché ci sono 400 record nel set di addestramento e la dimensione del batch è 128:
- 128 piani
- 128 piani
- 128 piani
- 16 piani
Pertanto, è più semplice impostare il numero di epoche su zero e definire il numero di iterazioni, come mostrato nell'esempio di classificazione di TensorFlow riportato di seguito.
estimator.train(input_fn=get_input_fn(training_set,
                                           num_epochs=None,
                                           n_batch = 128,
                                           shuffle=False),
                                           steps=1000)
Uscita
INFO:tensorflow:Calling model_fn.
INFO:tensorflow:Done calling model_fn.
INFO:tensorflow:Create CheckpointSaverHook.
INFO:tensorflow:Graph was finalized.
INFO:tensorflow:Running local_init_op.
INFO:tensorflow:Done running local_init_op.
INFO:tensorflow:Saving checkpoints for 1 into train/model.ckpt.
INFO:tensorflow:loss = 83729.64, step = 1
INFO:tensorflow:global_step/sec: 238.616
INFO:tensorflow:loss = 13909.657, step = 101 (0.420 sec)
INFO:tensorflow:global_step/sec: 314.293
INFO:tensorflow:loss = 12881.449, step = 201 (0.320 sec)
INFO:tensorflow:global_step/sec: 303.863
INFO:tensorflow:loss = 12391.541, step = 301 (0.327 sec)
INFO:tensorflow:global_step/sec: 308.782
INFO:tensorflow:loss = 12050.5625, step = 401 (0.326 sec)
INFO:tensorflow:global_step/sec: 244.969
INFO:tensorflow:loss = 11766.134, step = 501 (0.407 sec)
INFO:tensorflow:global_step/sec: 155.966
INFO:tensorflow:loss = 11509.922, step = 601 (0.641 sec)
INFO:tensorflow:global_step/sec: 263.256
INFO:tensorflow:loss = 11272.889, step = 701 (0.379 sec)
INFO:tensorflow:global_step/sec: 254.112
INFO:tensorflow:loss = 11051.9795, step = 801 (0.396 sec)
INFO:tensorflow:global_step/sec: 292.405
INFO:tensorflow:loss = 10845.855, step = 901 (0.341 sec)
INFO:tensorflow:Saving checkpoints for 1000 into train/model.ckpt.
INFO:tensorflow:Loss for final step: 5925.9873.
È possibile verificare TensorBoard con il seguente comando:
activate hello-tf
# For MacOS
tensorboard --logdir=./train
# For Windows
tensorboard --logdir=train
Passo 5) Valuta il tuo modello
Puoi valutare l'adattamento del tuo modello sul set di prova con il codice seguente:
ev = estimator.evaluate(
          input_fn=get_input_fn(test_set,
          num_epochs=1,
          n_batch = 128,
          shuffle=False))
Uscita
INFO:tensorflow:Calling model_fn.
INFO:tensorflow:Done calling model_fn.
INFO:tensorflow:Starting evaluation at 2018-05-13-01:43:13
INFO:tensorflow:Graph was finalized.
INFO:tensorflow:Restoring parameters from train/model.ckpt-1000
INFO:tensorflow:Running local_init_op.
INFO:tensorflow:Done running local_init_op.
INFO:tensorflow:Finished evaluation at 2018-05-13-01:43:13
INFO:tensorflow:Saving dict for global step 1000: average_loss = 32.15896, global_step = 1000, loss = 3215.896
Puoi stampare lo smarrimento con il codice qui sotto:
loss_score = ev["loss"]
print("Loss: {0:f}".format(loss_score))
Uscita
Loss: 3215.895996
Il modello presenta una perdita di 3215. È possibile consultare le statistiche riassuntive per farsi un'idea dell'entità dell'errore.
training_set['medv'].describe()
Uscita
count    400.000000
mean      22.625500
std        9.572593
min        5.000000
25%       16.600000
50%       21.400000
75%       25.025000
max       50.000000
Name: medv, dtype: float64
Dal riepilogo statistico di cui sopra, si evince che il prezzo medio di una casa è di 22 mila, con un prezzo minimo di 5 mila e un massimo di 50 mila. Poiché la perdita riportata è l'errore quadratico medio, l'errore tipico nelle unità originali è approssimativamente la radice quadrata di 32.16, che corrisponde a circa 5.7 mila dollari.
Passo 6) Fai la previsione
Infine, è possibile utilizzare il metodo predict dell'estimatore TensorFlow per stimare il valore di sei case a Boston.
y = estimator.predict(
         input_fn=get_input_fn(prediction_set,
         num_epochs=1,
         n_batch = 128,
         shuffle=False))
Per stampare i valori stimati, puoi utilizzare questo codice:
predictions = list(p["predictions"] for p in itertools.islice(y, 6))
print("Predictions: {}".format(str(predictions)))
Uscita
INFO:tensorflow:Calling model_fn.
INFO:tensorflow:Done calling model_fn.
INFO:tensorflow:Graph was finalized.
INFO:tensorflow:Restoring parameters from train/model.ckpt-1000
INFO:tensorflow:Running local_init_op.
INFO:tensorflow:Done running local_init_op.
Predictions: [array([32.297546], dtype=float32), array([18.96125], dtype=float32), array([27.270979], dtype=float32), array([29.299236], dtype=float32), array([16.436684], dtype=float32), array([21.460876], dtype=float32)]
Il modello prevede i seguenti valori:
| Casa | Predizione |
| 1 | 32.29 |
| 2 | 18.96 |
| 3 | 27.27 |
| 4 | 29.29 |
| 5 | 16.43 |
| 6 | 21.46 |
Tieni presente che non conosciamo il vero valore di queste sei case. Nel tutorial sul deep learning, proverai a superare il modello lineare.
Soluzione NumPy
Questa sezione spiega come addestrare il modello utilizzando uno stimatore NumPy per alimentare i dati. Il metodo è lo stesso, con la differenza che si utilizzerà lo stimatore numpy_input_fn.
Leggi gli stessi tre file CSV, ma conserva solo gli array NumPy grezzi con .values.
training_set_n = pd.read_csv("E:/boston_train.csv").values
test_set_n = pd.read_csv("E:/boston_test.csv").values
prediction_set_n = pd.read_csv("E:/boston_predict.csv").values
Passo 1) Importa i dati
Innanzitutto, è necessario distinguere le variabili caratteristiche dalle etichette. Questo va fatto sia per i dati di addestramento che per i dati di valutazione. È più veloce definire una funzione per suddividere i dati.
def prepare_data(df):
        X_train = df[:, :-3]
        y_train = df[:,-3]
        return X_train, y_train
È possibile utilizzare questa funzione per separare l'etichetta dalle caratteristiche dei set di dati di addestramento e valutazione.
X_train, y_train = prepare_data(training_set_n)
X_test, y_test = prepare_data(test_set_n)
È necessario escludere l'ultima colonna del set di dati di previsione perché contiene solo valori NaN.
x_predict = prediction_set_n[:, :-2]
Conferma la forma dell'array. Nota che l'etichetta non deve avere una seconda dimensione, ovvero (400,).
print(X_train.shape, y_train.shape, x_predict.shape)
Uscita
(400, 9) (400,) (6, 9)
È possibile strutturare le colonne delle caratteristiche nel modo seguente:
feature_columns = [ tf.feature_column.numeric_column('x', shape=X_train.shape[1:])]
Lo strumento di stima viene definito come in precedenza: si specificano le colonne delle caratteristiche e la posizione in cui salvare il grafico.
estimator = tf.estimator.LinearRegressor(
         feature_columns=feature_columns,
         model_dir="train1")
Uscita
INFO:tensorflow:Using default config.
INFO:tensorflow:Using config: {'_model_dir': 'train1', '_tf_random_seed': None, '_save_summary_steps': 100, '_save_checkpoints_steps': None, '_save_checkpoints_secs': 600, '_session_config': None, '_keep_checkpoint_max': 5, '_keep_checkpoint_every_n_hours': 10000, '_log_step_count_steps': 100, '_train_distribute': None, '_service': None, '_cluster_spec': <tensorflow.python.training.server_lib.ClusterSpec object at 0x1a218d8f28>, '_task_type': 'worker', '_task_id': 0, '_global_id_in_cluster': 0, '_master': '', '_evaluation_master': '', '_is_chief': True, '_num_ps_replicas': 0, '_num_worker_replicas': 1}
È possibile utilizzare l'estimatore NumPy per fornire i dati al modello e quindi addestrarlo. Si noti che definiamo la funzione input_fn in anticipo per facilitarne la leggibilità.
# Train the estimator
train_input = tf.estimator.inputs.numpy_input_fn(
           x={"x": X_train},
           y=y_train,
           batch_size=128,
           shuffle=False,
           num_epochs=None)
estimator.train(input_fn = train_input,steps=5000)
Uscita
INFO:tensorflow:Calling model_fn.
INFO:tensorflow:Done calling model_fn.
INFO:tensorflow:Create CheckpointSaverHook.
INFO:tensorflow:Graph was finalized.
INFO:tensorflow:Running local_init_op.
INFO:tensorflow:Done running local_init_op.
INFO:tensorflow:Saving checkpoints for 1 into train1/model.ckpt.
INFO:tensorflow:loss = 83729.64, step = 1
INFO:tensorflow:global_step/sec: 490.057
INFO:tensorflow:loss = 13909.656, step = 101 (0.206 sec)
INFO:tensorflow:global_step/sec: 788.986
INFO:tensorflow:loss = 12881.45, step = 201 (0.126 sec)
INFO:tensorflow:global_step/sec: 736.339
INFO:tensorflow:loss = 12391.541, step = 301 (0.136 sec)
INFO:tensorflow:global_step/sec: 383.305
INFO:tensorflow:loss = 12050.561, step = 401 (0.260 sec)
INFO:tensorflow:global_step/sec: 859.832
INFO:tensorflow:loss = 11766.133, step = 501 (0.117 sec)
INFO:tensorflow:global_step/sec: 804.394
INFO:tensorflow:loss = 11509.918, step = 601 (0.125 sec)
INFO:tensorflow:global_step/sec: 753.059
INFO:tensorflow:loss = 11272.891, step = 701 (0.134 sec)
INFO:tensorflow:global_step/sec: 402.165
INFO:tensorflow:loss = 11051.979, step = 801 (0.248 sec)
INFO:tensorflow:global_step/sec: 344.022
INFO:tensorflow:loss = 10845.854, step = 901 (0.288 sec)
INFO:tensorflow:Saving checkpoints for 1000 into train1/model.ckpt.
INFO:tensorflow:Loss for final step: 5925.985.
Out[23]:
<tensorflow.python.estimator.canned.linear.LinearRegressor at 0x1a1b6ea860>
Si ripete lo stesso passaggio con una funzione di input diversa per valutare il modello.
eval_input = tf.estimator.inputs.numpy_input_fn(
       x={"x": X_test},
       y=y_test,
       shuffle=False,
       batch_size=128,
       num_epochs=1)
   estimator.evaluate(eval_input,steps=None)
Uscita
INFO:tensorflow:Calling model_fn.
INFO:tensorflow:Done calling model_fn.
INFO:tensorflow:Starting evaluation at 2018-05-13-01:44:00
INFO:tensorflow:Graph was finalized.
INFO:tensorflow:Restoring parameters from train1/model.ckpt-1000
INFO:tensorflow:Running local_init_op.
INFO:tensorflow:Done running local_init_op.
INFO:tensorflow:Finished evaluation at 2018-05-13-01:44:00
INFO:tensorflow:Saving dict for global step 1000: average_loss = 32.158947, global_step = 1000, loss = 3215.8945
Out[24]:
{'average_loss': 32.158947, 'global_step': 1000, 'loss': 3215.8945}
Infine, è possibile calcolare la previsione. Il risultato dovrebbe essere simile a quello ottenuto con Pandas.
test_input = tf.estimator.inputs.numpy_input_fn(
        x={"x": x_predict},
        batch_size=128,
        num_epochs=1,
        shuffle=False)
        y = estimator.predict(test_input)

predictions = list(p["predictions"] for p in itertools.islice(y, 6))
print("Predictions: {}".format(str(predictions)))
Uscita
INFO:tensorflow:Calling model_fn.
INFO:tensorflow:Done calling model_fn.
INFO:tensorflow:Graph was finalized.
INFO:tensorflow:Restoring parameters from train1/model.ckpt-1000
INFO:tensorflow:Running local_init_op.
INFO:tensorflow:Done running local_init_op.
Predictions: [array([32.297546], dtype=float32), array([18.961248], dtype=float32), array([27.270979], dtype=float32), array([29.299242], dtype=float32), array([16.43668], dtype=float32), array([21.460878], dtype=float32)]
Soluzione TensorFlow
L'ultima sezione è dedicata a un puro TensorFlow soluzione. Questo metodo è leggermente più complicato degli altri due.
Nota che se usi un Jupyter taccuinoÈ necessario riavviare e cancellare il kernel per eseguire questa sessione.
TensorFlow ha creato un ottimo strumento per passare i dati alla pipeline. In questa sezione, creerai tu stesso la funzione input_fn.
Passo 1) Definire il percorso e il formato dei dati
Innanzitutto, si dichiarano due variabili con il percorso dei file CSV. Si noti che sono presenti due file, uno per il set di addestramento e uno per il set di test.
import tensorflow as tf
df_train = "E:/boston_train.csv"
df_eval = "E:/boston_test.csv"
Successivamente, è necessario definire le colonne che si desidera utilizzare dal file CSV. Noi le useremo tutte. Dopodiché, è necessario dichiarare il tipo di ciascuna variabile.
Le variabili float sono definite da [0].
COLUMNS = ["crim", "zn", "indus", "nox", "rm", "age",
                "dis", "tax", "ptratio", "medv"]
RECORDS_ALL = [[0.0], [0.0], [0.0], [0.0],[0.0],[0.0],[0.0],[0.0],[0.0],[0.0]]
Passo 2) Definire la funzione input_fn
La funzione può essere suddivisa in tre parti:
- Importa i dati
- Crea l'iteratore
- Consumare i dati
Di seguito è riportato il codice completo che definisce la funzione. Il codice verrà spiegato in seguito.
def input_fn(data_file, batch_size, num_epoch = None):
       # Step 1
          def parse_csv(value):
          columns = tf.decode_csv(value, record_defaults= RECORDS_ALL)
          features = dict(zip(COLUMNS, columns))
          #labels = features.pop('median_house_value')
          labels =  features.pop('medv')
          return features, labels

          # Extract lines from input files using the Dataset API.
          dataset = (tf.data.TextLineDataset(data_file) # Read text file
          .skip(1) # Skip header row
          .map(parse_csv))

          dataset = dataset.repeat(num_epoch)
          dataset = dataset.batch(batch_size)
          # Step 3
          iterator = dataset.make_one_shot_iterator()
          features, labels = iterator.get_next()
          return features, labels
Importa i dati
Per un file CSV, il metodo dataset legge una riga alla volta. Per creare il dataset, è necessario utilizzare l'oggetto TextLineSet di dati. Il tuo set di dati ha un'intestazione, quindi devi usare skip(1) per saltare la prima riga. A questo punto, leggi solo i dati ed escludi l'intestazione nella pipeline. Per alimentare il modello, devi separare le caratteristiche dall'etichetta. Il metodo utilizzato per applicare qualsiasi trasformazione ai dati è map.
Questo metodo chiama una funzione che creerai per istruire come trasformare i dati. In poche parole, devi passare i dati alla TextLineOggetto Dataset, escludere l'intestazione e applicare una trasformazione definita da una funzione.
Code spiegazione
- tf.data.TextLineDataset(data_file): questa riga legge il file CSV
- .skip(1): salta l'intestazione
- .map(parse_csv)): analizza i record e li converte in tensori
È necessario definire una funzione per dare istruzioni all'oggetto mappa. È possibile chiamare questa funzione parse_csv.
Questa funzione analizza il file CSV con il metodo tf.decode_csv e dichiara le caratteristiche e l'etichetta. Le caratteristiche possono essere dichiarate come un dizionario o una tupla. Si utilizza il metodo del dizionario perché è più pratico.
Code spiegazione
- tf.decode_csv(value, record_defaults= RECORDS_ALL): il metodo decode_csv utilizza l'output del TextLineSet di dati per leggere il file CSV. record_defaults indica a TensorFlow i tipi di colonna. In TensorFlow 2.x questo simbolo si trova in tf.io.decode_csv.
- dict(zip(COLUMNS, columns)): popola il dizionario con tutte le colonne espressetracted durante questa elaborazione dei dati
- features.pop('medv'): esclude la variabile target dalle variabili feature e crea una variabile label
Il dataset necessita di ulteriori elementi per alimentare iterativamente i tensori. In particolare, è necessario aggiungere il metodo `repeat` per consentire al dataset di continuare indefinitamente ad alimentare il modello. Se non si aggiunge questo metodo, il modello eseguirà l'iterazione una sola volta e poi genererà un errore perché non verranno più inseriti dati nella pipeline.
Dopodiché, è possibile controllare la dimensione del batch con il metodo batch. Ciò significa che si indica al dataset quanti dati si desidera passare alla pipeline per ogni iterazione. Se si imposta una dimensione del batch elevata, il modello risulterà lento.
Passo 3) Crea l'iteratore
Ora sei pronto per il secondo passaggio: crea un iteratore per restituire gli elementi nel set di dati.
Il modo più semplice per creare un operatore è con il metodo make_one_shot_iterator.
Successivamente, puoi creare funzionalità ed etichette dall'iteratore.
Passo 4) Consumare i dati
Puoi verificare cosa succede con la funzione input_fn. Devi chiamare la funzione in una sessione per consumare i dati. Prova con una dimensione del batch pari a 1.
Si noti che stampa le caratteristiche in un dizionario e l'etichetta come un array.
Verrà visualizzata la prima riga del file CSV. È possibile provare a eseguire questo codice più volte con diverse dimensioni del batch.
next_batch = input_fn(df_train, batch_size = 1, num_epoch = None)
with tf.Session() as sess:
     first_batch  = sess.run(next_batch)
     print(first_batch)
Uscita
({'crim': array([2.3004], dtype=float32), 'zn': array([0.], dtype=float32), 'indus': array([19.58], dtype=float32), 'nox': array([0.605], dtype=float32), 'rm': array([6.319], dtype=float32), 'age': array([96.1], dtype=float32), 'dis': array([2.1], dtype=float32), 'tax': array([403.], dtype=float32), 'ptratio': array([14.7], dtype=float32)}, array([23.8], dtype=float32))
Passo 5) Definire la colonna della funzionalità
È necessario definire le colonne numeriche come segue:
X1= tf.feature_column.numeric_column('crim')
X2= tf.feature_column.numeric_column('zn')
X3= tf.feature_column.numeric_column('indus')
X4= tf.feature_column.numeric_column('nox')
X5= tf.feature_column.numeric_column('rm')
X6= tf.feature_column.numeric_column('age')
X7= tf.feature_column.numeric_column('dis')
X8= tf.feature_column.numeric_column('tax')
X9= tf.feature_column.numeric_column('ptratio')
Tieni presente che devi raggruppare tutte le variabili in un unico contenitore.
base_columns = [X1, X2, X3,X4, X5, X6,X7, X8, X9]
Passo 6) Costruisci il modello
È possibile addestrare il modello con lo stimatore LinearRegressor.
model = tf.estimator.LinearRegressor(feature_columns=base_columns, model_dir='train3')
Uscita
INFO:tensorflow:Using default config. INFO:tensorflow:Using config: {'_model_dir': 'train3', '_tf_random_seed': None, '_save_summary_steps': 100, '_save_checkpoints_steps': None, '_save_checkpoints_secs': 600, '_session_config': None, '_keep_checkpoint_max': 5, '_keep_checkpoint_every_n_hours': 10000, '_log_step_count_steps': 100, '_train_distribute': None, '_service': None, '_cluster_spec': <tensorflow.python.training.server_lib.ClusterSpec object at 0x1820a010f0>, '_task_type': 'worker', '_task_id': 0, '_global_id_in_cluster': 0, '_master': '', '_evaluation_master': '', '_is_chief': True, '_num_ps_replicas': 0, '_num_worker_replicas': 1}
Devi usare un file funzione lambda per consentirti di scrivere gli argomenti per la funzione input_fn. Se non utilizzi una funzione lambda, non puoi addestrare il modello.
# Train the estimator
model.train(steps =1000,
          input_fn= lambda : input_fn(df_train,batch_size=128, num_epoch = None))
Uscita
INFO:tensorflow:Calling model_fn.
INFO:tensorflow:Done calling model_fn.
INFO:tensorflow:Create CheckpointSaverHook.
INFO:tensorflow:Graph was finalized.
INFO:tensorflow:Running local_init_op.
INFO:tensorflow:Done running local_init_op.
INFO:tensorflow:Saving checkpoints for 1 into train3/model.ckpt.
INFO:tensorflow:loss = 83729.64, step = 1
INFO:tensorflow:global_step/sec: 72.5646
INFO:tensorflow:loss = 13909.657, step = 101 (1.380 sec)
INFO:tensorflow:global_step/sec: 101.355
INFO:tensorflow:loss = 12881.449, step = 201 (0.986 sec)
INFO:tensorflow:global_step/sec: 109.293
INFO:tensorflow:loss = 12391.541, step = 301 (0.915 sec)
INFO:tensorflow:global_step/sec: 102.235
INFO:tensorflow:loss = 12050.5625, step = 401 (0.978 sec)
INFO:tensorflow:global_step/sec: 104.656
INFO:tensorflow:loss = 11766.134, step = 501 (0.956 sec)
INFO:tensorflow:global_step/sec: 106.697
INFO:tensorflow:loss = 11509.922, step = 601 (0.938 sec)
INFO:tensorflow:global_step/sec: 118.454
INFO:tensorflow:loss = 11272.889, step = 701 (0.844 sec)
INFO:tensorflow:global_step/sec: 114.947
INFO:tensorflow:loss = 11051.9795, step = 801 (0.870 sec)
INFO:tensorflow:global_step/sec: 111.484
INFO:tensorflow:loss = 10845.855, step = 901 (0.897 sec)
INFO:tensorflow:Saving checkpoints for 1000 into train3/model.ckpt.
INFO:tensorflow:Loss for final step: 5925.9873.
Out[8]:
<tensorflow.python.estimator.canned.linear.LinearRegressor at 0x18225eb8d0>
Puoi valutare l'adattamento del tuo modello sul set di prova con il codice seguente:
results = model.evaluate(steps =None,input_fn=lambda: input_fn(df_eval, batch_size =128, num_epoch = 1))
for key in results:
print("   {}, was: {}".format(key, results[key]))
Uscita
INFO:tensorflow:Calling model_fn.
INFO:tensorflow:Done calling model_fn.
INFO:tensorflow:Starting evaluation at 2018-05-13-02:06:02
INFO:tensorflow:Graph was finalized.
INFO:tensorflow:Restoring parameters from train3/model.ckpt-1000
INFO:tensorflow:Running local_init_op.
INFO:tensorflow:Done running local_init_op.
INFO:tensorflow:Finished evaluation at 2018-05-13-02:06:02
INFO:tensorflow:Saving dict for global step 1000: average_loss = 32.15896, global_step = 1000, loss = 3215.896
   average_loss, was: 32.158958435058594
   loss, was: 3215.89599609375
   global_step, was: 1000
L'ultimo passaggio consiste nel prevedere il valore dell'obiettivo in base al valore della matrice delle caratteristiche. È possibile creare un dizionario con i valori che si desidera prevedere. Il modello ha nove caratteristiche, quindi è necessario fornire un valore per ciascuna. Il modello fornirà una previsione per ognuna di esse.
Nel codice seguente, si inseriscono i valori di ciascuna caratteristica contenuta nel file CSV df_predict.
È necessario scrivere una nuova funzione input_fn perché nel dataset non è presente alcuna etichetta. È possibile utilizzare l'API from_tensors dell'oggetto Dataset.
prediction_input = {
          'crim': [0.03359,5.09017,0.12650,0.05515,8.15174,0.24522],
          'zn': [75.0,0.0,25.0,33.0,0.0,0.0],
          'indus': [2.95,18.10,5.13,2.18,18.10,9.90],
          'nox': [0.428,0.713,0.453,0.472,0.700,0.544],
          'rm': [7.024,6.297,6.762,7.236,5.390,5.782],
          'age': [15.8,91.8,43.4,41.1,98.9,71.7],
          'dis': [5.4011,2.3682,7.9809,4.0220,1.7281,4.0317],
          'tax': [252,666,284,222,666,304],
          'ptratio': [18.3,20.2,19.7,18.4,20.2,18.4]
     }
     def test_input_fn():
     dataset = tf.data.Dataset.from_tensors(prediction_input)
     return dataset

     # Predict all our prediction_input
     pred_results = model.predict(input_fn=test_input_fn)
Infine, si stampano le previsioni.
for pred in enumerate(pred_results):
print(pred)
Uscita
INFO:tensorflow:Calling model_fn.
INFO:tensorflow:Done calling model_fn.
INFO:tensorflow:Graph was finalized.
INFO:tensorflow:Restoring parameters from train3/model.ckpt-1000
INFO:tensorflow:Running local_init_op.
INFO:tensorflow:Done running local_init_op.
(0, {'predictions': array([32.297546], dtype=float32)})
(1, {'predictions': array([18.96125], dtype=float32)})
(2, {'predictions': array([27.270979], dtype=float32)})
(3, {'predictions': array([29.299236], dtype=float32)})
(4, {'predictions': array([16.436684], dtype=float32)})
(5, {'predictions': array([21.460876], dtype=float32)})

INFO:tensorflow:Calling model_fn. INFO:tensorflow:Done calling model_fn. INFO:tensorflow:Graph was finalized. INFO:tensorflow:Restoring parameters from train3/model.ckpt-5000 INFO:tensorflow:Running local_init_op. INFO:tensorflow:Done running local_init_op. (0, {'predictions': array([35.60663], dtype=float32)}) (1, {'predictions': array([22.298521], dtype=float32)}) (2, {'predictions': array([25.74533], dtype=float32)}) (3, {'predictions': array([35.126694], dtype=float32)}) (4, {'predictions': array([17.94416], dtype=float32)}) (5, {'predictions': array([22.606628], dtype=float32)})
Tutte e tre le pipeline restituiscono le stesse sei previsioni, il che conferma che la scelta tra Pandas, NumPy e un dataset nativo di TensorFlow è una questione di praticità, non di accuratezza.
