
Tutorial sulle reti neurali artificiali (ANN) con TensorFlow
 Team editoriale
⚡ Riepilogo intelligente
Le reti neurali artificiali apprendono elaborando gli input attraverso strati interconnessi, valutando il risultato con una funzione di perdita e correggendo i pesi con un ottimizzatore. Questa guida illustra come crearne una in TensorFlow e classificare le cifre del dataset MNIST.
Cos'è la rete neurale artificiale?
An Rete neurale artificiale (ANN) È un sistema informatico ispirato alle reti neurali biologiche per la creazione di cervelli artificiali basati su un insieme di unità interconnesse chiamate neuroni artificiali. È progettato per analizzare ed elaborare le informazioni nello stesso modo in cui lo fanno gli esseri umani. Una rete neurale artificiale possiede capacità di autoapprendimento per produrre risultati migliori man mano che sono disponibili più dati.
Il diagramma sottostante tracsi tratta di un passaggio completo attraverso tale rete, dall'input grezzo all'ottimizzatore che corregge i pesi.

Una Rete Neurale Artificiale (ANN) è composta da quattro oggetti principali:
- Strati: Tutto l'apprendimento avviene a strati. Ci sono 3 strati: 1) Input, 2) Nascosto e 3) Output.
- Caratteristica ed etichetta: Dati di input per la rete (caratteristiche) e dati di output dalla rete (etichette)
- Funzione di perdita: Metrica utilizzata per stimare le prestazioni della fase di apprendimento
- Ottimizzatore: Migliorare l'apprendimento aggiornando le conoscenze nella rete
Una rete neurale riceve i dati in ingresso e li distribuisce in un insieme di strati. La rete valuta quindi le proprie prestazioni tramite una funzione di perdita. La funzione di perdita fornisce alla rete un'indicazione del percorso da seguire per acquisire la conoscenza necessaria. La rete migliora tale conoscenza con l'aiuto di un ottimizzatore.
Se dai un'occhiata alla figura sopra, capirai il meccanismo sottostante.
Il programma prende alcuni valori di input e li inserisce in due strati completamente connessi. Immagina di avere un problema di matematica. La prima cosa che fai è leggere il capitolo corrispondente per risolverlo. Poi applichi le tue nuove conoscenze al problema. C'è un'alta probabilità che il risultato non sia molto buono. Lo stesso vale per una rete neurale: la prima volta che vede i dati e fa una previsione, il risultato non corrisponderà perfettamente ai dati reali.
Per migliorare le proprie conoscenze, la rete utilizza un ottimizzatore. In questa analogia, un ottimizzatore può essere paragonato alla rilettura di un capitolo. Rileggendo si acquisiscono nuove conoscenze. Allo stesso modo, la rete utilizza l'ottimizzatore, aggiorna le proprie conoscenze e le verifica per accertarsi di quanto ancora ha da imparare. Il programma ripete questo processo finché non produce l'errore minimo possibile.
Nell'analogia con i problemi di matematica, significa che si legge un capitolo del libro di testo molte volte finché non se ne comprende a fondo il contenuto. Anche dopo averlo letto più volte, se si continua a commettere errori, significa che si è raggiunto il limite di conoscenza dell'argomento. È necessario utilizzare un libro di testo diverso o sperimentare un metodo diverso per migliorare il proprio punteggio. Per una rete neurale, il processo è lo stesso. Se il numero di errori smette di diminuire e la curva di perdita si appiattisce, l'architettura attuale non è in grado di apprendere altro. La rete deve essere ottimizzata per migliorare la conoscenza.
Questi quattro oggetti corrispondono direttamente ai componenti che si configurano durante la progettazione di una rete.
Rete neurale Architectura
L'architettura della rete neurale artificiale è composta dai seguenti componenti:
- Livelli
- Funzione di attivazione
- Funzione di perdita
- Optimizer
Livelli
Un livello è la parte della rete neurale in cui avviene tutto l'apprendimento. All'interno di un livello si trova un numero arbitrario di neuroni, ognuno dei quali possiede i propri pesi. Una tipica rete neurale è spesso elaborata da livelli densamente connessi (chiamati anche livelli completamente connessi). Ciò significa che tutti gli input sono collegati all'output.
Una tipica rete neurale riceve in input un vettore e uno scalare che contiene le etichette. La configurazione più semplice è una classificazione binaria con solo due classi: 0 e 1.
La rete riceve un input, lo invia a tutti i nodi connessi e calcola il segnale utilizzando una funzione di attivazione. Il diagramma numerato sottostante espande un singolo nodo, permettendo di visualizzare separatamente la somma ponderata e la fase di attivazione.

La figura qui sopra illustra questo concetto. Il primo strato contiene i valori di input. Il secondo strato, chiamato strato nascosto, riceve l'input ponderato dallo strato precedente.
- Il primo nodo rappresenta i valori di input.
- Il neurone è scomposto nella parte di input e nella funzione di attivazione. La parte sinistra riceve tutto l'input dallo strato precedente. La parte destra è la somma dell'input passato alla funzione di attivazione.
- Il valore di output viene calcolato a partire dagli strati nascosti e utilizzato per effettuare una previsione. Per la classificazione, corrisponde al numero di classi. Per la regressione, viene previsto un solo valore.
Funzione di attivazione
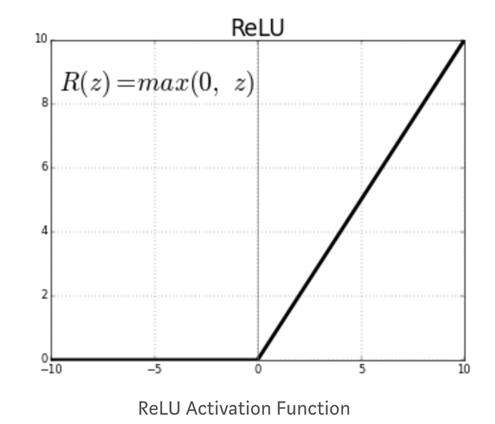
La funzione di attivazione di un nodo definisce l'output dato un insieme di input. È necessaria una funzione di attivazione per consentire alla rete di apprendere schemi non lineari. Una funzione di attivazione comune è ReLU, o Rectified Linear Unit. Questa funzione assegna zero a tutti i valori negativi.
Le altre funzioni di attivazione sono:
- Lineare a tratti
- sigmoid
- Tan
- ReLU che perde
Il grafico sottostante mostra perché la ReLU viene descritta in questo modo: la curva è piatta in corrispondenza dello zero per ogni valore di input negativo e successivamente aumenta linearmente.
La decisione fondamentale da prendere quando si costruisce una rete neurale è:
- Quanti strati nella rete neurale
- Quante unità nascoste per ogni livello
Le reti neurali con molti strati e unità nascoste possono apprendere una rappresentazione complessa dei dati, ma rendono il calcolo della rete molto oneroso.
Funzione di perdita
Dopo aver definito gli strati nascosti e la funzione di attivazione, è necessario specificare la funzione di perdita e l'ottimizzatore.
Per la classificazione binaria, è prassi comune utilizzare una funzione di perdita di entropia incrociata binaria. regressione lineare, si utilizza l'errore quadratico medio.
La funzione di perdita è una metrica importante per stimare le prestazioni dell'ottimizzatore. Durante la formazione, questa metrica verrà ridotta al minimo. È necessario selezionare attentamente questa quantità a seconda del tipo di problema che si sta affrontando.
Optimizer
La funzione di perdita è una misura delle prestazioni del modello. L'ottimizzatore aiuta a migliorare i pesi della rete per ridurre la perdita. Esistono diversi ottimizzatori, ma il più comune è la discesa del gradiente stocastico.
Gli ottimizzatori convenzionali sono:
- Momentum ottimizzazione
- Gradiente accelerato di Nesterov
- AdaGrad
- Ottimizzazione di Adamo
ArchiLa sola struttura non garantisce un modello utilizzabile.
Limitazioni della rete neurale
Di seguito sono elencati i limiti di una rete neurale:
sovradattamento
Un problema comune delle reti neurali complesse è la difficoltà di generalizzare a dati mai visti prima. Una rete neurale con molti pesi può identificare molto bene dettagli specifici nel set di addestramento, ma questo spesso porta all'overfitting. Se i dati sono sbilanciati all'interno dei gruppi (ovvero, non ci sono dati sufficienti in alcuni gruppi), la rete imparerà molto bene durante l'addestramento, ma non sarà in grado di generalizzare tali modelli a dati mai visti prima.
C'è un compromesso in machine learning tra ottimizzazione e generalizzazione.
- L'ottimizzazione di un modello richiede la ricerca dei parametri migliori che minimizzino la perdita del set di addestramento.
- La generalizzazione, tuttavia, indica come si comporta il modello per i dati invisibili.
Per evitare che il modello catturi dettagli specifici o pattern indesiderati dai dati di addestramento, è possibile utilizzare diverse tecniche. Il metodo migliore consiste nell'avere un dataset bilanciato con una quantità sufficiente di dati. L'arte di ridurre l'overfitting è chiamata regolarizzazione. Le tre tecniche seguenti rappresentano i punti di partenza convenzionali.
| Tecnica | Ciò che limita | Impostazione tipica in questo tutorial |
|---|---|---|
| Dimensioni della rete | Il numero di strati e unità nascoste | Due strati nascosti, da 300 e 100 unità |
| Regolarizzazione del peso L1/L2 | L'entità dei coefficienti di ponderazione | l1_regularization_strength e l2_regularization_strength pari a 0.01 |
| dropout | Percentuale di unità disattivate per ogni fase di addestramento | dropout dello 0.3 |
Dimensioni della rete
Una rete neurale con troppi strati e unità nascoste è notoriamente molto complessa. Un modo semplice per ridurre la complessità del modello è quello di ridurne le dimensioni. Non esiste una singola regola generale per definire il numero di strati. È necessario iniziare con un numero ridotto di strati e aumentarlo gradualmente fino a quando il modello non presenta overfitting.
Regolarizzazione del peso
Una tecnica standard per prevenire l'overfitting consiste nell'aggiungere vincoli ai pesi della rete. Il vincolo impone che i pesi della rete assumano solo valori piccoli. Il vincolo viene aggiunto alla funzione di perdita dell'errore. Esistono due tipi di regolarizzazione:
- L1 (Lazo): Il costo è proporzionale al valore assoluto dei coefficienti di ponderazione.
- L2 (Cresta): Il costo è proporzionale al quadrato del valore dei coefficienti di ponderazione.
dropout
Il dropout è una tecnica insolita ma utile. Una rete neurale con dropout prevede che alcune unità vengano disattivate casualmente durante una fase di addestramento, in modo che il loro segnale in uscita diventi zero. Immaginate di avere un array di pesi [0.1, 1.7, 0.7, -0.9]. Se la rete neurale ha il dropout, diventerà [0.1, 0, 0, -0.9] con 0 distribuiti casualmente. Il parametro che controlla il dropout è il tasso di dropout. Il tasso definisce quante unità vengono disattivate. Un tasso compreso tra 0.2 e 0.5 è comune.
Un piccolo esempio interattivo rende il ciclo di allenamento facile da seguire.
Esempio di rete neurale in TensorFlow
Ecco un esempio pratico di rete neurale artificiale, che mostra come una rete neurale funziona su un tipico problema di classificazione. Ci sono due input, x1 e x2, ciascuno con un valore casuale. L'output è una classe binaria. L'obiettivo è classificare l'etichetta in base alle due caratteristiche. Per svolgere questo compito, l'architettura della rete neurale è definita come segue:
- Due strati nascosti
- Il primo strato ha quattro neuroni completamente connessi
- Il secondo strato ha due neuroni completamente connessi
- La funzione di attivazione è una ReLU.
- Aggiungi una regolarizzazione L2 con un tasso di apprendimento di 0.003
La rete ottimizzerà i pesi durante 180 epoche con una dimensione del batch di 10. Nell'animazione di esempio della rete neurale artificiale qui sotto, è possibile osservare come i pesi si evolvono nel tempo e come la rete migliora la mappa di classificazione.ping.

Innanzitutto la rete assegna valori casuali a tutti i pesi.
- Con pesi casuali, ovvero senza ottimizzazione, la perdita in uscita è pari a 0.453. L'immagine sottostante rappresenta la rete con colori diversi.
- In generale, il colore arancione rappresenta i valori negativi mentre i colori blu mostrano i valori positivi.
- I punti dati hanno la stessa rappresentazione: quelli blu sono le etichette positive e quelli arancioni le etichette negative.

All'interno del secondo strato nascosto, le linee sono colorate in base al segno dei pesi. Le linee arancioni hanno pesi negativi e quelle blu pesi positivi.
Come puoi vedere, nella mappa di outputpingLa rete sta commettendo parecchi errori. Ora osserviamo come si comporta la rete dopo l'ottimizzazione.
L'immagine dell'esempio di rete neurale artificiale (ANN) qui sotto mostra i risultati della rete ottimizzata. Innanzitutto, si nota che la rete ha imparato con successo a classificare i punti dati. Confrontandola con l'immagine precedente, il peso iniziale era -0.43, mentre dopo l'ottimizzazione risulta essere -0.95.

L'idea può essere generalizzata per reti con più strati nascosti e neuroni. Puoi sperimentare tu stesso con le impostazioni nel Parco giochi TensorFlow.
La procedura descritta di seguito illustra la stessa idea implementandola tramite codice e utilizzando un set di dati reale.
Come addestrare una rete neurale con TensorFlow
Ecco il processo passo passo su come addestrare una rete neurale con TensorFlow Rete neurale artificiale (ANN) che utilizza lo stimatore DNNClassifier dell'API.
Utilizzeremo il set di dati MNIST per addestrare la tua prima rete neurale. Addestrare una rete neurale con TensorFlow Non è molto complicato. La fase di pre-elaborazione è esattamente la stessa dei tutorial precedenti. Procederai come segue:
- Importa i dati
- Trasforma i dati
- Costruisci il tensore
- Costruisci il modello
- Formare e valutare il modello
- Migliora il modello
Nota sulla versione: Il codice in questa procedura guidata è destinato all'API Estimator di TensorFlow 1.x. La versione finale del pacchetto tf-estimator è stata rilasciata con TensorFlow 2.15 e tf.estimator è stato rimosso in TensorFlow 2.16. Per eseguire questi passaggi su una versione più recente, è necessario bloccare TensorFlow alla versione 2.15 oppure ricostruire la stessa rete a due strati con tf.keras.layers.Dense e model.fit().
Passaggio 1) Importa i dati
Innanzitutto, è necessario importare la libreria necessaria. È possibile importare il dataset MNIST utilizzando scikit-impara come mostrato nell'esempio di rete neurale TensorFlow riportato di seguito.
Il dataset MNIST è il dataset più comunemente utilizzato per testare nuove tecniche o algoritmi. Si tratta di una raccolta di immagini di 28×28 pixel, ciascuna delle quali mostra una cifra scritta a mano da 0 a 9. Un gruppo di reti neurali convoluzionali profonde addestrate con distorsioni elastiche ha ridotto l'errore di test allo 0.27%.
import numpy as np
import tensorflow as tf
np.random.seed(1337)
La procedura originale prevedeva il download manuale dei file MNIST e l'indicazione della cartella a fetch_mldata.
from sklearn.datasets import fetch_mldata
mnist = fetch_mldata(' /Users/Thomas/Dropbox/Learning/Upwork/tuto_TF/data/mldata/MNIST original')
print(mnist.data.shape)
print(mnist.target.shape)
Nota sull'API: Il sito mldata.org non è più online e la funzione fetch_mldata è stata rimossa nella versione 0.22 di scikit-learn. Su un'installazione corrente, sostituire la chiamata precedente con fetch_openml('mnist_784', version=1), che scarica le stesse 70,000 cifre ed espone gli stessi dati e attributi di destinazione.
Dopodiché, si dividono i dati e si ottiene la forma di entrambi i set di dati.
from sklearn.model_selection import train_test_split

X_train, X_test, y_train, y_test = train_test_split(mnist.data, mnist.target, test_size=0.2, random_state=42)
y_train  = y_train.astype(int)
y_test  = y_test.astype(int)
batch_size =len(X_train)

print(X_train.shape, y_train.shape,y_test.shape )
Passaggio 2) Trasformare i dati
Nel tutorial precedente, hai imparato che è necessario trasformare i dati per limitare l'effetto dei valori anomali. In questo tutorial sulle reti neurali, trasformerai i dati utilizzando lo scaler min-max. La formula è:
(X-min_x)/(max_x - min_x)
scikit-learn ha già una funzione per questo: MinMaxScaler()
## resclae
from sklearn.preprocessing import MinMaxScaler
scaler = MinMaxScaler()
# Train
X_train_scaled = scaler.fit_transform(X_train.astype(np.float64))
# test
X_test_scaled = scaler.fit_transform(X_test.astype(np.float64))
Passaggio 3) Costruire il tensore
Ora hai familiarità con il modo di creare tensori In TensorFlow è possibile convertire il set di dati di addestramento in una colonna numerica.
feature_columns = [tf.feature_column.numeric_column('x', shape=X_train_scaled.shape[1:])]
Passaggio 4) Costruisci il modello
L'architettura della rete neurale contiene 2 strati nascosti, con 300 unità per il primo strato e 100 unità per il secondo. Questi valori derivano dall'esperienza, non da una formula. È possibile ottimizzarli e osservare come influenzano la precisione della rete.
Per costruire il modello, si utilizza l'estimatore DNNClassifier. È necessario impostare il numero di classi a 10, poiché il set di addestramento contiene dieci classi. La sintassi dell'oggetto estimatore è già nota. Gli argomenti feature_columns, n_classes e model_dir sono esattamente gli stessi del tutorial precedente. L'argomento hidden_units è la novità: controlla sia il numero di layer che il numero di nodi a cui ogni layer è connesso nella rete neurale. Nel codice seguente, sono presenti due layer nascosti: il primo con 300 nodi connessi e il secondo con 100 nodi.
Per costruire lo stimatore, utilizzare tf.estimator.DNNClassifier con i seguenti parametri:
- colonne_caratteristiche: Definire le colonne da utilizzare nella rete
- unità nascoste: Definire il numero di neuroni nascosti
- n_classi: Definisci il numero di classi da prevedere
- directory_modello: Definire il percorso di Scheda Tensor
estimator = tf.estimator.DNNClassifier(
    feature_columns=feature_columns,
    hidden_units=[300, 100],
    n_classes=10,
    model_dir = '/train/DNN')
Passaggio 5) Addestrare e valutare il modello
È possibile utilizzare la funzione di input di NumPy per addestrare il modello e valutarlo.
# Train the estimator
train_input = tf.estimator.inputs.numpy_input_fn(
    x={"x": X_train_scaled},
    y=y_train,
    batch_size=50,
    shuffle=False,
    num_epochs=None)
estimator.train(input_fn = train_input,steps=1000)
eval_input = tf.estimator.inputs.numpy_input_fn(
    x={"x": X_test_scaled},
    y=y_test,
    shuffle=False,
    batch_size=X_test_scaled.shape[0],
    num_epochs=1)
estimator.evaluate(eval_input,steps=None)
Produzione:
{'accuracy': 0.9637143,
 'average_loss': 0.12014342,
 'loss': 1682.0079,
 'global_step': 1000}
L'architettura attuale consente di raggiungere un'accuratezza sul set di valutazione pari a circa il 96%.
Passaggio 6) Migliorare il modello
Puoi provare a migliorare il modello aggiungendo parametri di regolarizzazione.
In questo caso, l'estimatore utilizza un ottimizzatore Proximal AdaGrad con un tasso di dropout di 0.3 e valori di intensità sia per L1 che per L2 pari a 0.01. In una rete neurale TensorFlow, si accede all'ottimizzatore tramite l'oggetto train seguito dal nome dell'ottimizzatore. TensorFlow include un'API integrata per l'ottimizzatore Proximal AdaGrad.
Per aggiungere la regolarizzazione alla rete neurale profonda, è possibile utilizzare tf.train.ProximalAdagradOptimizer con i seguenti parametri:
- Tasso di apprendimento: tasso_di_apprendimento
- Regolarizzazione L1: forza di regolarizzazione l1
- Regolarizzazione L2: forza di regolarizzazione l2
estimator_imp = tf.estimator.DNNClassifier(
    feature_columns=feature_columns,
    hidden_units=[300, 100],
    dropout=0.3,
    n_classes = 10,
    optimizer=tf.train.ProximalAdagradOptimizer(
      learning_rate=0.01,
      l1_regularization_strength=0.01,
      l2_regularization_strength=0.01
    ),
    model_dir = '/train/DNN1')
estimator_imp.train(input_fn = train_input,steps=1000)
estimator_imp.evaluate(eval_input,steps=None)
Produzione:
{'accuracy': 0.95057142,
 'average_loss': 0.17318928,
 'loss': 2424.6499,
 'global_step': 2000}
I valori scelti per ridurre l'overfitting non hanno migliorato l'accuratezza del modello. Il tuo primo modello aveva un'accuratezza del 96%, mentre il modello con il regolarizzatore L2 ha un'accuratezza del 95%. Puoi provare valori diversi e vedere come influiscono sull'accuratezza.
