
डेटा वेयरहाउस मॉडलिंग में स्टार स्कीमा क्या है?
 डेविड कार्टर
⚡ स्मार्ट सारांश
डेटा वेयरहाउस मॉडलिंग में स्टार स्कीमा एक केंद्रीय तथ्य तालिका को आसपास की आयाम तालिकाओं के मूल में रखता है, जिससे एक गैर-सामान्यीकृत, तारा-आकार का डिज़ाइन बनता है जो विश्लेषणात्मक प्रश्नों को सरल बनाता है, रिपोर्टिंग को गति देता है और व्यावसायिक बुद्धिमत्ता प्लेटफार्मों में OLAP क्यूब्स को शक्ति प्रदान करता है।
स्टार स्कीमा क्या है?
A स्टार स्कीमा डेटा वेयरहाउस में मॉडलिंग संरचना वह होती है जिसमें एक केंद्रीय तथ्य तालिका कई संबंधित आयाम तालिकाओं से जुड़ी होती है। इसे स्टार स्कीमा कहा जाता है क्योंकि इसका लेआउट एक तारे जैसा होता है, जिसमें तथ्य तालिका केंद्र में होती है और आयाम तालिकाएँ बिंदुओं की तरह बाहर की ओर फैली होती हैं।
स्टार स्कीमा डेटा वेयरहाउस स्कीमा का सबसे सरल प्रकार है, और इसे स्टार जॉइन स्कीमा के नाम से भी जाना जाता है। क्योंकि इसकी आयाम तालिकाएँ डीनॉर्मलाइज़्ड होती हैं, इसलिए यह मॉडल बहुत बड़े डेटा सेटों को क्वेरी करने के लिए अनुकूलित है, जो इसे एक सामान्य विकल्प बनाता है। आयामी मॉडलिंग और रिपोर्टिंग.
बहुआयामी स्कीमा क्या है?
A बहुआयामी योजना इसे विशेष रूप से डेटा वेयरहाउस सिस्टम को मॉडल करने के लिए डिज़ाइन किया गया है। ये स्कीमा उन बहुत बड़े डेटाबेस की अनूठी ज़रूरतों को पूरा करते हैं जो विश्लेषणात्मक उद्देश्यों के लिए बनाए गए हैं। OLAP नियमित लेनदेन प्रसंस्करण के बजाय।
डेटा वेयरहाउस स्कीमा के प्रकार: बहुआयामी योजनाओं के तीन मुख्य प्रकार हैं, और प्रत्येक की अपनी-अपनी खूबियां हैं।
- स्टार स्कीमा – एक केंद्रीय तथ्य तालिका जो सीधे डीनोर्मलाइज़्ड आयाम तालिकाओं से जुड़ी होती है।
- स्नोफ्लेक स्कीमा – स्टार स्कीमा का एक विस्तार जिसमें आयामों को अतिरिक्त उप-आयाम तालिकाओं में सामान्यीकृत किया जाता है।
- आकाशगंगा योजना इसे फैक्ट कॉन्स्टेलेशन भी कहा जाता है, इसमें कई फैक्ट टेबल का उपयोग किया जाता है जो कॉमन डायमेंशन टेबल साझा करते हैं।
क्योंकि स्नोफ्लेक स्कीमा सीधे स्टार स्कीमा पर आधारित है, इसलिए विस्तृत स्टार स्कीमा उदाहरण पर काम करने से पहले दोनों मॉडलों की तुलना करना सहायक होता है।
स्टार स्कीमा बनाम स्नोफ्लेक स्कीमा
तारा योजना और स्नोफ्लेक स्कीमा दोनों ही डेटा को फैक्ट और डाइमेंशन टेबल के आधार पर व्यवस्थित करते हैं, लेकिन डाइमेंशन को स्टोर करने के तरीके में अंतर होता है। स्टार स्कीमा प्रत्येक डाइमेंशन को एक ही डीनॉर्मलाइज़्ड टेबल में रखता है, जबकि स्नोफ्लेक स्कीमा उन डाइमेंशन को कई संबंधित टेबल में नॉर्मलाइज़ करता है।
- संरचना: तारा संरचना सपाट और सरल होती है; जबकि हिमखंड संरचना आयामों को उप-आयामों में विभाजित करती है।
- क्वेरी गति: स्टार स्कीमा में कम जॉइन की आवश्यकता होती है, इसलिए क्वेरी आमतौर पर तेजी से चलती हैं और SQL सरल रहता है।
- भंडारण: स्नोफ्लेक स्कीमा अनावश्यकता को दूर करते हैं, इसलिए वे कम जगह का उपयोग करते हैं लेकिन डिजाइन की जटिलता को बढ़ाते हैं।
- आंकड़ा शुचिता: सामान्यीकृत स्नोफ्लेक आयाम अखंडता को बेहतर ढंग से लागू करते हैं, जबकि गैर-सामान्यीकृत स्टार आयाम प्रदर्शन को प्राथमिकता देते हैं।
- उपयोग में आसानी: विश्लेषकों के लिए स्टार स्कीमा को समझना आसान होता है और इसे बनाए रखना भी तेज़ होता है, जबकि स्नोफ्लेक स्कीमा के लिए अधिक सावधानीपूर्वक डिजाइन की आवश्यकता होती है।
व्यवहार में, टीमें अक्सर डेटा मार्ट और डैशबोर्ड के लिए स्टार स्कीमा का चयन करती हैं, जिन्हें तेज़ और सरल रिपोर्टिंग की आवश्यकता होती है, और स्नोफ्लेक स्कीमा का चयन तब करती हैं जब स्टोरेज की बचत और सख्त स्थिरता अधिक मायने रखती है।
स्टार स्कीमा का उदाहरण
निम्नलिखित स्टार स्कीमा उदाहरण में, फैक्ट टेबल केंद्र में स्थित है और इसमें प्रत्येक आयाम तालिका की कुंजी होती है, जैसे कि Dealer_ID, Model_ID, Date_ID, Product_ID और Branch_ID, साथ ही इकाइयों की बिक्री और राजस्व जैसे मापने योग्य विशेषताएँ भी होती हैं।
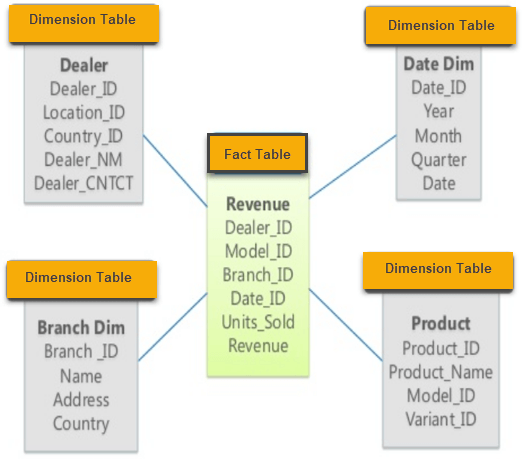
प्रत्येक संबंधित आयाम तालिका उन मापों में वर्णनात्मक संदर्भ जोड़ती है, इसलिए एक ही क्वेरी किसी अन्य तालिका को जोड़े बिना डीलर, मॉडल, तिथि, उत्पाद या शाखा के आधार पर बिक्री तथ्यों को समूहित या फ़िल्टर कर सकती है।
तथ्य तालिकाएँ
स्टार स्कीमा में एक फैक्ट टेबल में फैक्ट्स होते हैं और यह डाइमेंशन से जुड़ी होती है। एक फैक्ट टेबल में दो प्रकार के कॉलम होते हैं:
- एक कॉलम जिसमें तथ्य या माप संग्रहीत होते हैं।
- प्रत्येक आयाम तालिका से जुड़ने वाली विदेशी कुंजियाँ।
सामान्यतः, किसी फैक्ट टेबल की प्राइमरी की एक कंपोजिट की होती है जो टेबल को बनाने वाली सभी फॉरेन कीज़ से मिलकर बनी होती है।
तथ्य तालिकाओं में विस्तृत तथ्य या एकत्रित तथ्य शामिल हो सकते हैं। एकत्रित तथ्यों वाली तथ्य तालिकाओं को अक्सर सारांश तालिकाएँ कहा जाता है, और इनमें आमतौर पर ऐसे तथ्य होते हैं जिन्हें पहले ही किसी स्तर तक एकत्रित किया जा चुका होता है।
आयाम सारणी
डाइमेंशन एक ऐसी संरचना है जो डेटा को एक पदानुक्रम में वर्गीकृत करती है। पदानुक्रम और स्तरों के बिना डाइमेंशन को फ्लैट डाइमेंशन या सूची कहा जाता है। प्रत्येक डाइमेंशन टेबल की प्राथमिक कुंजी, फैक्ट टेबल की समग्र प्राथमिक कुंजी का हिस्सा होती है।
डाइमेंशन एट्रिब्यूट एक वर्णनात्मक, पाठ्य एट्रिब्यूट है जो किसी डाइमेंशनल वैल्यू, जैसे कि उत्पाद का नाम या शहर, का वर्णन करने में सहायक होता है। चूंकि डाइमेंशन टेबल ट्रांजैक्शनल इवेंट्स के बजाय इस वर्णनात्मक संदर्भ को स्टोर करती हैं, इसलिए फैक्ट टेबल आमतौर पर डाइमेंशन टेबल से कहीं बड़ी होती हैं।
स्टार स्कीमा कैसे डिज़ाइन करें
स्टार स्कीमा का डिज़ाइन राल्फ किम्बल द्वारा लोकप्रिय किए गए आयामी मॉडलिंग दृष्टिकोण का अनुसरण करता है। इसका लक्ष्य स्पष्ट, पुन: प्रयोज्य आयामों के आधार पर व्यावसायिक मापों को व्यवस्थित करना है ताकि तैयार मॉडल को क्वेरी करना आसान हो और उस पर त्वरित रिपोर्ट तैयार की जा सके। नीचे दिए गए पाँच चरण उस प्रक्रिया की रूपरेखा प्रस्तुत करते हैं जिसका पालन अधिकांश आयामी मॉडलिंग परियोजनाएँ करती हैं, जो उच्चतम स्तर के व्यावसायिक प्रश्न से शुरू होकर भौतिक तथ्य और आयाम तालिकाओं तक जाती हैं।
- व्यावसायिक प्रक्रिया की पहचान करें: आप जिस गतिविधि का विश्लेषण करना चाहते हैं, उसे चुनें, जैसे बिक्री, शिपमेंट आदि।pingया इन्वेंट्री। यह निर्णय परिभाषित करता है कि तथ्य तालिका क्या मापेगी।
- अनाज की घोषणा करें: प्रत्येक तथ्य पंक्ति में दी गई जानकारी का स्तर निर्धारित करें, उदाहरण के लिए प्रति पंक्ति, प्रति लेन-देन या प्रति दिन। स्पष्ट संरचना मॉडल को सुसंगत बनाए रखती है।
- आयामों की पहचान करें: तथ्यों को अलग-अलग भागों में बांटने के लिए आवश्यक वर्णनात्मक संदर्भ सूचीबद्ध करें, जैसे कि उत्पाद, ग्राहक, डीलर, शाखा और तिथि। इनमें से प्रत्येक एक विशेषता का आयाम सारणी बन जाता है।
- तथ्यों की पहचान करें: व्यवसाय द्वारा वांछित संख्यात्मक मापों का निर्धारण करें। track, जैसे बेची गई इकाइयाँ, राजस्व या लागत, को केंद्रीय तथ्य तालिका में रखें।
- तारा बनाएं: फ़ॉरेन कीज़ के माध्यम से फ़ैक्ट टेबल को प्रत्येक आयाम से कनेक्ट करें।ping आयामों को इस प्रकार से विसामान्यीकृत किया जाता है कि आरेख अपने आयामों से घिरी एक एकल केंद्रीय तथ्य तालिका का रूप ले लेता है।
स्टार स्कीमा बन जाने के बाद, प्रत्येक आयाम में एक सरोगेट कुंजी जोड़ें, सुनिश्चित करें कि प्रत्येक तथ्य तालिका में एक संबंधित दिनांक आयाम हो, और पुष्टि करें कि सभी तथ्य एक ही स्तर पर हों। यह भी एक अच्छी प्रक्रिया है कि सबसे पहले एटॉमिक, निम्नतम स्तर का डेटा लोड किया जाए, क्योंकि सारांश तालिकाएँ बाद में प्राप्त की जा सकती हैं। इन नियमों का पालन करने से स्कीमा उच्च प्रदर्शन और सरलता के लिए अनुकूलित रहता है। डाटा गोदाम रिपोर्टिंग।
स्टार स्कीमा की विशेषताएँ
- स्टार स्कीमा में प्रत्येक आयाम को केवल एक आयाम तालिका द्वारा दर्शाया जाता है।
- प्रत्येक आयाम तालिका में विशेषताओं का अपना एक समूह होता है।
- डिमिशन टेबल को फैक्ट टेबल से फॉरेन की का उपयोग करके जोड़ा जाता है।
- आयाम सारणी एक दूसरे से जुड़ी हुई नहीं हैं।
- तथ्य तालिका में कुंजी और माप शामिल हैं।
- स्टार स्कीमा को समझना आसान है और यह डिस्क का इष्टतम उपयोग प्रदान करता है।
- डाइमेंशन टेबल नॉर्मलाइज़्ड नहीं हैं। उदाहरण के लिए, ऊपर दिए गए उदाहरण में, Country_ID में एक अलग कंट्री लुकअप टेबल नहीं है, जैसा कि एक अन्य टेबल में होता है। OLTP डिजाइन ऐसा होगा।
- यह योजना बीआई टूल्स द्वारा व्यापक रूप से समर्थित है।
स्टार स्कीमा के लाभ
स्टार स्कीमा कई लाभ प्रदान करता है जो इसे डेटा वेयरहाउस डिजाइन के लिए एक लोकप्रिय प्रारंभिक बिंदु बनाता है:
- स्टार स्कीमा, अत्यधिक मानकीकृत लेनदेन स्रोतों से डेटा प्राप्त करते समय अन्य स्कीमाओं की तुलना में सरल जॉइन लॉजिक का उपयोग करते हैं।
- स्टार स्कीमा सामान्य व्यावसायिक रिपोर्टिंग तर्क को सरल बनाता है, जैसे कि अवधि-दर-अवधि और दिनांक-वार रिपोर्टिंग।
- स्टार स्कीमा का उपयोग OLAP सिस्टम द्वारा क्यूब्स को कुशलतापूर्वक बनाने के लिए व्यापक रूप से किया जाता है, और अधिकांश प्रमुख OLAP सिस्टम में क्यूब संरचना को डिजाइन किए बिना स्टार स्कीमा एक स्रोत के रूप में कार्य कर सकता है।
- क्वेरी पर लागू की जा सकने वाली विशिष्ट प्रदर्शन ट्यूनिंग को सक्षम करके, क्वेरी प्रोसेसर बेहतर निष्पादन योजनाएँ प्रदान कर सकता है।
स्टार स्कीमा के नुकसान
- क्योंकि स्कीमा अत्यधिक डीनॉर्मलाइज़्ड है, इसलिए डेटा अखंडता को सख्ती से लागू नहीं किया जाता है।
- यह उन्नत विश्लेषणात्मक आवश्यकताओं के मामले में लचीला नहीं है।
- स्टार स्कीमा व्यावसायिक संस्थाओं के बीच अनेक-से-अनेक संबंधों को सुदृढ़ नहीं करते हैं।
स्टार स्कीमा का उपयोग कब करें
जब स्टोरेज स्पेस बचाने की तुलना में तेज़ और अनुमानित क्वेरी प्रदर्शन अधिक महत्वपूर्ण हो, तो स्टार स्कीमा सही विकल्प है। चूंकि यह मॉडल अपने डाइमेंशन टेबल को डीनॉर्मलाइज़्ड रखता है और जॉइन की संख्या कम रखता है, इसलिए यह उन विश्लेषणात्मक वर्कलोड के लिए उपयुक्त है जहां व्यावसायिक उपयोगकर्ता ऐतिहासिक डेटा की बड़ी मात्रा पर बार-बार समान रिपोर्ट, डैशबोर्ड और एग्रीगेशन चलाते हैं।
स्टार स्कीमा के उपयुक्त होने की विशिष्ट स्थितियों में निम्नलिखित शामिल हैं:
- डेटा मार्ट्स: विभागीय डेटा मार्ट्स सरल और सुस्पष्ट संबंधों वाले उदाहरण पठनीय संरचना से लाभान्वित होते हैं।
- बीआई डैशबोर्ड: व्यापारिक सूचना टूल्स को स्टार स्कीमा पर आसानी से मैप किया जा सकता है, इसलिए रिपोर्ट और विजुअल्स को जल्दी से बनाया जा सकता है।
- ओएलएपी क्यूब्स: स्टार स्कीमा OLAP क्यूब्स, एग्रीगेशन और स्लाइस-एंड-डाइस विश्लेषण के लिए एक स्वाभाविक स्रोत हैं।
यदि प्राथमिकता न्यूनतम स्टोरेज, सख्त डेटा अखंडता, या गहन, परिवर्तनशील पदानुक्रमों की ओर स्थानांतरित होती है, तो स्नोफ्लेक स्कीमा या अधिक मानकीकृत डिज़ाइन बेहतर साबित हो सकता है। कई टीमें तो इन दोनों को मिलाकर भी काम करती हैं, स्टार स्कीमा से शुरुआत करती हैं और केवल उन्हीं आयामों को मानकीकृत करती हैं जिनकी वास्तव में आवश्यकता होती है।
