
NoSQL-opetusohjelma: NoSQL-tietokantojen tyypit ja esimerkit
 Stephen Twain
⚡ Älykäs yhteenveto
NoSQL on ei-relaatiotietokannan hallintajärjestelmä, joka ei vaadi kiinteää kaavaa, välttää liitoksia ja skaalautuu helposti. Tämä resurssi selittää, mikä NoSQL on, miksi se on olemassa, sen historian, ominaisuudet, neljä tietokantatyyppiä, CAP-teoreeman, lopullisen johdonmukaisuuden sekä sen edut ja haitat.
Mikä on NoSQL?
NoSQL-tietokanta on ei-relaatioon perustuva tiedonhallintajärjestelmä, joka ei vaadi kiinteää kaavaa. Se välttää liitoksia ja on helppo skaalata. NoSQL-tietokannan pääasiallinen tarkoitus on hajautetut tietovarastot, joissa on valtavat tiedontallennustarpeet. NoSQL:ää käytetään big datan ja reaaliaikaisten verkkosovellusten kanssa. Esimerkiksi yritykset, kuten Twitter, Facebook ja Google kerää teratavuja käyttäjädataa joka päivä.
NoSQL-tietokanta tulee sanoista ”Not Only SQL” tai ”Not SQL”. Vaikka parempi termi olisi ”NoREL”, NoSQL levisi suosioon. Carl Strozzi esitteli NoSQL-konseptin vuonna 1998.
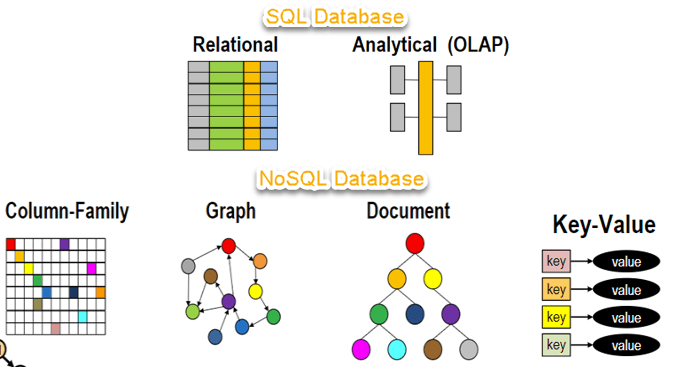
Perinteinen RDBMS käyttää SQL-syntaksia datan tallentamiseen ja hakemiseen lisätietojen saamiseksi. Sen sijaan NoSQL-tietokantajärjestelmä kattaa laajan valikoiman tietokantatekniikoita, jotka voivat tallentaa strukturoitua, puolistrukturoitua, strukturoimatonta ja polymorfista dataa. Tutustutaan NoSQL:ään tämän NoSQL-tietokantaoppaan kaavion avulla:
Miksi NoSQL?
NoSQL-tietokantojen konseptista tuli suosittu internet-jättien, kuten Google, Facebook, Amazonjne. jotka käsittelevät valtavia tietomääriä. Järjestelmän vasteaika hidastuu, kun käytät RDBMS:ää valtaviin tietomääriin.
Tämän ongelman ratkaisemiseksi voisimme "skaalata" järjestelmiämme päivittämällä olemassa olevaa laitteistoamme. Tämä prosessi on kallis.
Vaihtoehto tälle ongelmalle on jakaa tietokannan kuormitus useille isännille aina, kun kuormitus kasvaa. Tätä menetelmää kutsutaan skaalaukseksi.

NoSQL-tietokanta ei ole relaatiotietokanta, joten se skaalautuu paremmin kuin relaatiotietokannat, koska ne on suunniteltu web-sovelluksia ajatellen.

NoSQL-tietokantojen lyhyt historia
- 1998 – Carlo Strozzi käyttää termiä NoSQL kevyestä, avoimen lähdekoodin relaatiotietokannastaan.
- 2000 – Graafitietokanta Neo4j lanseerataan.
- 2004 - Google BigTable on julkaistu.
- 2005 - CouchDB käynnistetään.
- 2007 – Tutkimusartikkeli aiheesta Amazon Dynamo vapautetaan.
- 2008 – Facebook avaa lähdekoodin Cassandra projekti.
- 2009 – Termi NoSQL otettiin uudelleen käyttöön.
NoSQL:n ominaisuudet
Ei-relatiivista
- NoSQL-tietokannat eivät koskaan noudata relaatiomalli.
- Älä koskaan anna taulukoita, joissa on kiinteästi sarakkeissa olevia tietueita.
- Työskentele itsenäisten aggregaattien tai BLOBien kanssa.
- Ei vaadi objektirelaatiokarttaaping ja datan normalisointi.
- Ei monimutkaisia ominaisuuksia, kuten kyselykieliä, kyselysuunnittelijoita, viite-eheysliitoksia tai ACID:tä.
Kaaviovapaa
- NoSQL-tietokannat ovat joko skeemattomia tai niissä on revenneet skeemat.
- Älä vaadi minkäänlaista datan kaavan määritelmää.
- Tarjoa heterogeenisiä datarakenteita samalla toimialueella.

Yksinkertainen API
- Tarjoaa helppokäyttöisiä käyttöliittymiä tiedon tallennukseen ja kyselyyn.
- API-rajapinnat mahdollistavat matalan tason datan käsittely- ja valintamenetelmät.
- Tekstipohjaisia protokollia käytetään enimmäkseen HTTP RESTin ja JSONin kanssa.
- Enimmäkseen käytetty ei-standardipohjaista NoSQL-kyselykieltä.
- Verkkopohjaiset tietokannat, jotka toimivat internetiin yhdistettyinä palveluina.
hajautettu
- Useita NoSQL-tietokantoja voidaan suorittaa hajautetusti.
- Tarjoaa automaattisen skaalauksen ja vikasietoisuuden.
- Usein ACID-konsepti voidaan uhrata skaalautuvuuden ja läpimenon vuoksi.
- Hajautettujen solmujen välillä ei enimmäkseen synkronista replikointia; asynkroninen usean isännän replikointi, vertaisverkkoreplikointi, HDFS-replikointi.
- Tarjoaa vain lopullista johdonmukaisuutta.
- Jaettu-ei mitään -arkkitehtuuri. Tämä mahdollistaa vähemmän koordinointia ja suuremman hajautuksen.

NoSQL-tietokantojen tyypit
NoSQL-tietokannat luokitellaan pääasiassa neljään tyyppiin: avain-arvo-pari, sarakepohjainen, graafipohjainen ja dokumenttipohjainen. Jokaisella luokalla on omat ainutlaatuiset ominaisuutensa ja rajoituksensa. Mikään yllä mainituista tietokannoista ei ratkaise kaikkia ongelmia paremmin. Käyttäjien tulisi valita tietokanta tuotetarpeidensa perusteella.
NoSQL-tietokantojen tyypit:
- Avainarvopariperusteinen
- Sarakesuuntainen kaavio
- Kaavioihin perustuva
- Asiakirjasuuntautunut

Avainarvopari perustuu
Data tallennetaan avain/arvo-pareihin. Se on suunniteltu käsittelemään suuria tietomääriä ja raskasta kuormitusta. Avain-arvo-parien tallennustietokannat tallentavat datan hajautustaulukkona, jossa jokainen avain on ainutlaatuinen ja arvo voi olla JSON, BLOB (Binary Large Objects), merkkijono jne.
Esimerkiksi avain-arvo-pari voi sisältää avaimen, kuten ”Verkkosivusto”, johon liittyy arvo, kuten ”Guru99. "

Se on yksi perustavanlaatuisimmista NoSQL-tietokantaesimerkeistä. Tämän tyyppistä NoSQL-tietokantaa käytetään kokoelmana, sanakirjoina, assosiatiivisina taulukoina jne. Avain-arvo-säilöissä kehittäjä voi tallentaa tietoa ilman kaavamaisia tietoja. Ne toimivat parhaiten esimerkiksi verkkokaupoissa.ping ostoskorin sisältö.
Redis, Dynamo ja Riak ovat esimerkkejä NoSQL-avain-arvo-tietokannoista. Ne kaikki perustuvat AmazonDynamo-paperi.
Sarakepohjainen
Sarakepohjaiset tietokannat toimivat sarakkeiden perusteella ja perustuvat BigTable-artikkeliin, jonka on kirjoittanut GoogleJokaista saraketta käsitellään erikseen. Yksisarakkeisten tietokantojen arvot tallennetaan vierekkäin.

Ne tarjoavat korkean suorituskyvyn koostekyselyissä, kuten SUM, COUNT, AVG, MIN jne., koska tiedot ovat helposti saatavilla sarakkeessa. Sarakepohjaisia NoSQL-tietokantoja käytetään laajalti tietovarastojen hallintaan, bisnesvaisto, CRM ja kirjastokorttiluettelot.
HBase, Cassandra, ja Hypertable ovat NoSQL-kyselyesimerkkejä sarakepohjaisista tietokannoista.
Dokumenttisuuntautunut
Dokumenttikeskeinen NoSQL-tietokanta tallentaa ja hakee tiedot avain-arvo-parina, mutta arvo-osa tallennetaan dokumenttina. Dokumentti tallennetaan JSON- tai XML-muodossa. Tietokanta ymmärtää arvon ja sitä voidaan kysellä.

Vasemmalla olevassa kaaviossa näet rivit ja sarakkeet, ja oikealla puolella on dokumenttitietokanta, jonka rakenne on samanlainen kuin JSON:lla. Relaatiotietokannan osalta sinun on tiedettävä, mitä sarakkeita siinä on, ja niin edelleen. Dokumenttitietokannassa on kuitenkin tietovarasto, kuten JSON-objekti. Sinun ei tarvitse määritellä sitä, mikä tekee siitä joustavan.
Tätä dokumenttityyppiä käytetään enimmäkseen sisällönhallintajärjestelmissä, blogialustoilla, reaaliaikaisessa analytiikassa ja verkkokauppasovelluksissa. Sitä ei tule käyttää monimutkaisiin tapahtumiin, jotka vaativat useita toimintoja tai kyselyitä vaihtelevia koosterakenteita vastaan.
Amazon SimpleDB, CouchDB, MongoDB, Riak ja Lotus Notes ovat suosittuja dokumenttikeskeisiä DBMS-järjestelmät.
Kaaviopohjainen
Graafityyppinen tietokanta tallentaa entiteetit sekä niiden väliset suhteet. Entiteetti tallennetaan solmuna ja suhde reunoina. Reuna määrittää solmujen välisen suhteen. Jokaisella solmulla ja reunalla on yksilöllinen tunniste.

Verrattuna relaatiotietokantaan, jossa taulukot ovat löyhästi yhteydessä toisiinsa, graafitietokanta on luonteeltaan monirelaatiotietokanta. Suhteiden läpikäyminen on nopeaa, koska ne ovat jo tallennettuna tietokantaan, eikä niitä tarvitse laskea. Graafitietokantoja käytetään enimmäkseen sosiaalisten verkostojen, logistiikan ja paikkatiedon hallintaan.
Neo4J, Infinite Graph, OrientDBja FlockDB ovat joitakin suosittuja graafipohjaisia tietokantoja.
Kyselymekanismin työkalut NoSQL:lle
Yleisin tiedonhakutapa on REST-pohjainen arvon haku sen avaimen/tunnuksen perusteella GET-resurssin avulla.
Tiedostovarastotietokannat tarjoavat vaikeampia kyselyitä, koska ne ymmärtävät avain-arvo-parin arvon. Esimerkiksi CouchDB mahdollistaa näkymien määrittelyn MapReducen avulla.
Mikä on CAP-lause?
CAP-lausetta kutsutaan myös Brewerin lauseeksi. Se toteaa, että hajautetun tietovaraston on mahdotonta tarjota enempää kuin kaksi kolmesta takuusta:
- Johdonmukaisuus
- Saatavuus:
- Osiotoleranssi
Johdonmukaisuus: Tietojen tulee pysyä johdonmukaisina myös toimenpiteen suorittamisen jälkeen. Tämä tarkoittaa, että kun tiedot on kirjoitettu, kaikkien tulevien lukupyyntöjen tulee sisältää kyseiset tiedot. Esimerkiksi tilauksen tilan päivityksen jälkeen kaikkien asiakkaiden pitäisi voida nähdä samat tiedot.
Saatavuus: Tietokannan tulee olla aina saatavilla ja reagoiva. Siinä ei pitäisi olla seisokkeja.
Osiotoleranssi: Osiotoleranssi tarkoittaa, että järjestelmän tulee jatkaa toimintaansa, vaikka palvelinten välinen tiedonsiirto ei olisi vakaa. Palvelimet voidaan esimerkiksi jakaa useisiin ryhmiin, jotka eivät välttämättä kommunikoi keskenään. Tässä, jos osa tietokannasta ei ole käytettävissä, muut osat eivät aina vaikuta.
Lopullinen johdonmukaisuus
Termi "lopullinen yhdenmukaisuus" tarkoittaa datan kopioiden pitämistä useilla koneilla korkean käytettävyyden ja skaalautuvuuden saavuttamiseksi. Näin ollen mihin tahansa dataelementtiin yhdellä koneella tehdyt muutokset on siirrettävä muihin kopioihin.
Tiedon replikointi ei välttämättä tapahdu välittömästi, koska jotkut kopiot päivittyvät välittömästi, kun taas toiset ajan myötä. Nämä kopiot voivat olla keskenään epäjohdonmukaisia, mutta ajan myötä niistä tulee yhdenmukaisia. Tästä johtuu nimitys lopullinen yhdenmukaisuus.
BASE: Basikaalisesti Asaatavilla, Susein tila, Evenuaalinen johdonmukaisuus
- Pohjimmiltaan saatavilla tarkoittaa, että tietokanta on käytettävissä koko ajan CAP-lauseen mukaisesti.
- Pehmeä tila tarkoittaa, että järjestelmän tila voi muuttua, vaikka järjestelmää ei syötettäisikään.
- Lopullinen johdonmukaisuus tarkoittaa, että järjestelmästä tulee ajan myötä johdonmukainen.

NoSQL:n edut
- Voidaan käyttää ensisijaisena tai analyyttisena tietolähteenä.
- Big datan käyttömahdollisuus.
- Ei yhtä ainoaa vikaantumiskohtaa.
- Helppo replikointi.
- Erillistä välimuistikerrosta ei tarvita.
- Se tarjoaa nopean suorituskyvyn ja vaakasuuntaisen skaalautuvuuden.
- Pystyy käsittelemään strukturoitua, puolistrukturoitua ja strukturoimatonta dataa yhtä tehokkaasti.
- Olio-ohjelmointi, joka on helppokäyttöistä ja joustavaa.
- NoSQL-tietokannat eivät tarvitse erillistä tehokasta palvelinta.
- Tukee keskeisiä kehittäjäkieliä ja -alustoja.
- Helpompi toteuttaa kuin RDBMS:n käyttö.
- Se voi toimia verkkosovellusten ensisijaisena tietolähteenä.
- Käsittelee big dataa, joka hallitsee datan nopeutta, monimuotoisuutta, määrää ja monimutkaisuutta.
- Erinomainen hajautettujen tietokantojen ja useiden datakeskusten toiminnoissa.
- Poistaa tarpeen erilliselle välimuistikerrokselle tietojen tallentamiseen.
- Tarjoaa joustavan kytkentäkaavion, jota voidaan helposti muuttaa ilman käyttökatkoksia tai palvelukatkoksia.
NoSQL:n haitat
- Ei standardointisääntöjä.
- Rajoitetut kyselyominaisuudet.
- RDBMS tietokannat ja työkalut ovat suhteellisen kypsiä.
- Se ei tarjoa perinteisiä tietokantaominaisuuksia, kuten johdonmukaisuutta, kun useita tapahtumia suoritetaan samanaikaisesti.
- Kun datamäärä kasvaa, yksilöllisten arvojen ylläpitäminen on vaikeaa, koska avaimista tulee vaikeita.
- Ei toimi yhtä hyvin relaatiodatan kanssa.
- Oppimiskäyrä on jäykkä uusille kehittäjille.
- Avoimen lähdekoodin vaihtoehdot eivät ole kovin suosittuja yrityksille.
