
Πολλαπλή Γραμμική Παλινδρόμηση σε R: Απλή & Σταδιακή με Παραδείγματα
 Έβελιν Κλαρκ
⚡ Έξυπνη Σύνοψη
Η Απλή και Πολλαπλή Γραμμική Παλινδρόμηση στην R μοντελοποιεί ένα συνεχές αποτέλεσμα ως ένα σταθμισμένο άθροισμα προγνωστικών που προσαρμόζονται με συνήθεις ελαχίστες τετραγώνους. Αυτή η αναλυτική περιγραφή καλύπτει την lm(), την ανάγνωση συντελεστών, τους προγνωστικούς παράγοντες, τη διαγνωστική υπολειμμάτων, την πρόβλεψη και την αυτόματη επιλογή μεταβλητών.
Πού εντάσσεται η γραμμική παλινδρόμηση στη μηχανική μάθηση
Η γραμμική παλινδρόμηση είναι μία από τις παλαιότερες εποπτευόμενες μάθηση μηχανής αλγόριθμοι, και εξακολουθεί να είναι το πρώτο μοντέλο που αναζητούν οι περισσότεροι αναλυτές. Μία από τις πρώτες εφαρμογές μηχανικής μάθησης ήταν η Φίλτρο ανεπιθύμητων.
Άλλες συνηθισμένες εφαρμογές της μηχανικής μάθησης περιλαμβάνουν:
- Αναγνώριση ανεπιθύμητων ανεπιθύμητων μηνυμάτων σε email
- Τμηματοποίηση συμπεριφοράς πελατών για στοχευμένη διαφήμιση
- Μείωση των δόλιων συναλλαγών με πιστωτικές κάρτες
- Βελτιστοποίηση της χρήσης ενέργειας σε κατοικίες και κτίρια γραφείων
- Αναγνώριση προσώπου
Εποπτευόμενη μάθηση
In Εποπτευόμενη μάθηση, τα δεδομένα εκπαίδευσης που τροφοδοτείτε στον αλγόριθμο περιλαμβάνουν μια ετικέτα.
Ταξινόμηση είναι πιθανώς η πιο χρησιμοποιούμενη τεχνική εποπτευόμενης μάθησης. Μία από τις πρώτες εργασίες ταξινόμησης που αντιμετώπισαν οι ερευνητές ήταν το φίλτρο ανεπιθύμητης αλληλογραφίας (spam). Στόχος της μάθησης είναι να προβλέψει εάν ένα email ταξινομείται ως ανεπιθύμητο ή ως καλό email. Το μηχάνημα, μετά το βήμα εκπαίδευσης, μπορεί να ανιχνεύσει την κατηγορία του email.
Υποχωρήσεις χρησιμοποιούνται συνήθως στον τομέα της μηχανικής μάθησης για την πρόβλεψη συνεχούς τιμής. Μια εργασία παλινδρόμησης μπορεί να προβλέψει την τιμή ενός εξαρτημένη μεταβλητή με βάση ένα σύνολο από ανεξάρτητες μεταβλητές (ονομάζονται επίσης προγνωστικοί παράγοντες ή οπισθοδρομικοί). Για παράδειγμα, οι γραμμικές παλινδρομήσεις μπορούν να προβλέψουν μια τιμή μετοχής, πρόβλεψη καιρού, πωλήσεις και ούτω καθεξής.
Μερικοί βασικοί αλγόριθμοι εποπτευόμενης μάθησης είναι:
- Γραμμικής παλινδρόμησης
- Λογιστική παλινδρόμηση
- Κοντινότεροι γείτονες
- Μηχανή φορέα υποστήριξης (SVM)
- Δέντρα απόφασης και Τυχαίο Δάσος
- Νευρωνικά δίκτυα
Μη εποπτευόμενη μάθηση
In Μη εποπτευόμενη μάθηση, τα δεδομένα εκπαίδευσης δεν έχουν ετικέτα. Το σύστημα προσπαθεί να μάθει χωρίς αναφορά. Παρακάτω είναι μια λίστα αλγορίθμων μάθησης χωρίς επίβλεψη.
- Κ-μέσος
- Ιεραρχικός Cluster Ανάλυση
- Μεγιστοποίηση προσδοκιών
- Οπτικοποίηση και μείωση διαστάσεων
- Ανάλυση κύριων συστατικών
- PCA πυρήνα
- Τοπική-Γραμμική Ενσωμάτωση
Με αυτό το πλαίσιο στη θέση του, το υπόλοιπο αυτού του σεμιναρίου δημιουργεί μοντέλα παλινδρόμησης σε R βήμα προς βήμα.
Απλή γραμμική παλινδρόμηση στο R
Η γραμμική παλινδρόμηση απαντά σε ένα απλό ερώτημα: μπορείτε να μετρήσετε μια ακριβή σχέση μεταξύ μιας μεταβλητής-στόχου και ενός συνόλου προγνωστικών παραγόντων;
Το απλούστερο πιθανοτικό μοντέλο είναι το ευθύγραμμο μοντέλο:

όπου
- y = Εξαρτημένη μεταβλητή
- x = Ανεξάρτητη μεταβλητή
-
 = συστατικό τυχαίου σφάλματος
-
 = αναχαιτίζω
-
 = Συντελεστής x
Εξετάστε την ακόλουθη πλοκή:
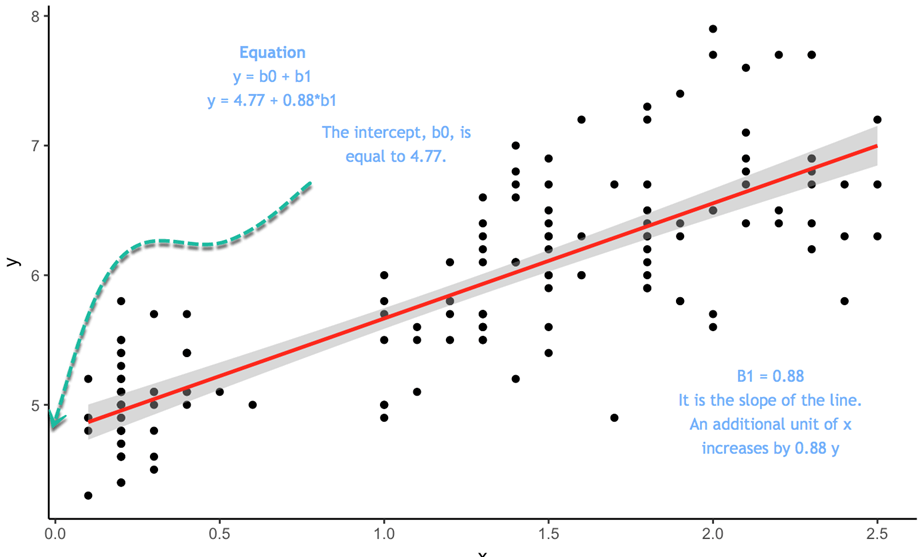
Η εξίσωση είναι 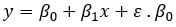 Σε αυτήν την εξίσωση, η τομή είναι 4.77, επομένως όταν το x ισούται με 0, η προσαρμοσμένη τιμή του y είναι 4.77. Η κλίση σας δείχνει σε ποια αναλογία μεταβάλλεται το y όταν το x μεταβάλλεται.
Για να υπολογίσετε τις βέλτιστες τιμές του  και
 , χρησιμοποιείτε μια μέθοδο που ονομάζεται Συνήθη ελάχιστα τετράγωνα (OLS). Αυτή η μέθοδος προσπαθεί να βρει τις παραμέτρους που ελαχιστοποιούν το άθροισμα των τετραγωνικών σφαλμάτων, δηλαδή την κατακόρυφη απόσταση μεταξύ των προβλεπόμενων τιμών y και των πραγματικών τιμών y. Η διαφορά είναι γνωστή ως το όρος σφάλματος.
Πριν υπολογίσετε το μοντέλο, μπορείτε να προσδιορίσετε εάν μια γραμμική σχέση μεταξύ y και x είναι εύλογη σχεδιάζοντας ένα διάγραμμα διασποράς.
Διάγραμμα διασποράς
Θα χρησιμοποιήσουμε ένα πολύ απλό σύνολο δεδομένων για να εξηγήσουμε την έννοια της απλής γραμμικής παλινδρόμησης. Θα εισαγάγουμε τα μέσα ύψη και βάρη για Αμερικανίδες. Το σύνολο δεδομένων περιέχει 15 παρατηρήσεις. Θέλετε να μετρήσετε εάν τα ύψη συσχετίζονται θετικά με τα βάρη.
library(ggplot2)
path <- 'https://raw.githubusercontent.com/guru99-edu/R-Programming/master/women.csv'
df <-read.csv(path)
ggplot(df,aes(x=height, y =  weight))+
geom_point()
Παραγωγή:

Το διάγραμμα διασποράς υποδηλώνει μια γενική τάση αύξησης του βάρους καθώς αυξάνεται το ύψος. Στο επόμενο βήμα, θα μετρήσετε με βάση το πόσο αυξάνεται το βάρος για κάθε επιπλέον μονάδα ύψους.
Εκτιμήσεις ελάχιστων τετραγώνων
Σε μια απλή παλινδρόμηση OLS, ο υπολογισμός του  και είναι απλή. Αυτό το σεμινάριο δεν εξάγει τους τύπους, απλώς τους αναφέρει.
Θέλετε να υπολογίσετε: 
Ο στόχος της παλινδρόμησης OLS είναι να ελαχιστοποιήσει την ακόλουθη εξίσωση:

όπου
 είναι η πραγματική τιμή και
 είναι η προβλεπόμενη τιμή.
Η λύση για is 
Σημειώστε ότι  σημαίνει τη μέση τιμή του x
Η λύση για  is

Στην R, μπορείτε να χρησιμοποιήσετε τις συναρτήσεις cov() και var() για να εκτιμήσετε και μπορείτε να χρησιμοποιήσετε τη συνάρτηση mean() για να εκτιμήσετε 
beta <- cov(df$height, df$weight) / var (df$height)
beta
Παραγωγή:
##[1] 3.45
alpha <- mean(df$weight) - beta * mean(df$height)
alpha
Παραγωγή:
## [1] -87.51667
Ο συντελεστής βήτα υποδηλώνει ότι για κάθε επιπλέον ίντσα ύψους, το μέσο βάρος αυξάνεται κατά 3.45 λίβρες.
Η εκτίμηση μιας γραμμικής εξίσωσης με το χέρι είναι διδακτική αλλά μη πρακτική. R παρέχει τη συνάρτηση lm() για να το κάνει για εσάς και θα τη χρησιμοποιήσετε από την επόμενη ενότητα και μετά. Σε πραγματικά έργα σχεδόν ποτέ δεν θα προσαρμόσετε ένα μοντέλο με έναν μόνο προγνωστικό παράγοντα. Οι εργασίες παλινδρόμησης συνήθως περιλαμβάνουν πολλούς εκτιμητές ταυτόχρονα.
Πολλαπλή Γραμμική Παλινδρόμηση στο R
Οι πρακτικές εφαρμογές της ανάλυσης παλινδρόμησης χρησιμοποιούν μοντέλα πιο σύνθετα από το απλό ευθύγραμμο μοντέλο. Το πιθανοτικό μοντέλο που περιλαμβάνει περισσότερες από μία ανεξάρτητες μεταβλητές ονομάζεται πολλαπλά μοντέλα παλινδρόμησης. Η γενική μορφή αυτού του μοντέλου είναι:

Στη σημειογραφία μήτρας, μπορείτε να ξαναγράψετε το μοντέλο:

Η εξαρτημένη μεταβλητή y είναι πλέον συνάρτηση k ανεξάρτητων μεταβλητών. Η τιμή του συντελεστή  καθορίζει τη συνεισφορά της ανεξάρτητης μεταβλητής
 και .
Εισάγουμε εν συντομία την υπόθεση που κάναμε για το τυχαίο σφάλμα  του OLS:
- Μέση τιμή ίση με 0
- Διακύμανση ίση με

- Κανονική κατανομή
- Τα τυχαία σφάλματα είναι ανεξάρτητα (με πιθανολογική έννοια)

Πρέπει να λύσετε , το διάνυσμα των συντελεστών παλινδρόμησης που ελαχιστοποιούν το άθροισμα των τετραγωνικών σφαλμάτων μεταξύ της προβλεπόμενης και της πραγματικής τιμής y.
Η λύση κλειστής μορφής είναι:

με:
- δείχνει το μεταθέτω του πίνακα X
 δείχνει το αντιστρέψιμη μήτρα
 δείχνει το αντιστρέψιμη μήτρα
Τα παρακάτω παραδείγματα χρησιμοποιούν το ενσωματωμένο σύνολο δεδομένων mtcars. Στόχος είναι η πρόβλεψη μιλίων ανά γαλόνι (mpg) από ένα σύνολο χαρακτηριστικών.
Συνεχείς μεταβλητές στο R
Προς το παρόν, θα χρησιμοποιήσετε μόνο τις συνεχείς μεταβλητές και θα αφήσετε στην άκρη τα κατηγορηματικά χαρακτηριστικά. Η μεταβλητή am είναι μια δυαδική μεταβλητή που παίρνει την τιμή 1 εάν το κιβώτιο ταχυτήτων είναι χειροκίνητο και 0 για αυτόματα αυτοκίνητα. Το vs είναι επίσης μια δυαδική μεταβλητή.
library(dplyr)
df <- mtcars %>%
select(-c(am, vs, cyl, gear, carb))
glimpse(df)
Παραγωγή:
## Observations: 32
## Variables: 6
## $ mpg  <dbl> 21.0, 21.0, 22.8, 21.4, 18.7, 18.1, 14.3, 24.4, 22.8, 19....
## $ disp <dbl> 160.0, 160.0, 108.0, 258.0, 360.0, 225.0, 360.0, 146.7, 1...
## $ hp   <dbl> 110, 110, 93, 110, 175, 105, 245, 62, 95, 123, 123, 180, ...
## $ drat <dbl> 3.90, 3.90, 3.85, 3.08, 3.15, 2.76, 3.21, 3.69, 3.92, 3.9...
## $ wt   <dbl> 2.620, 2.875, 2.320, 3.215, 3.440, 3.460, 3.570, 3.190, 3...
## $ qsec <dbl> 16.46, 17.02, 18.61, 19.44, 17.02, 20.22, 15.84, 20.00, 2...
Μπορείτε να χρησιμοποιήσετε τη συνάρτηση lm() για να υπολογίσετε τις παραμέτρους. Η βασική σύνταξη αυτής της συνάρτησης είναι:
lm(formula, data, subset)
Arguments:
	-formula: The equation you want to estimate
	-data: The dataset used
	-subset: Estimate the model on a subset of the dataset
Θυμηθείτε ότι μια εξίσωση έχει την ακόλουθη μορφή

στο Ρ
- Το σύμβολο = αντικαθίσταται από ~
- Κάθε x αντικαθίσταται από το όνομα της μεταβλητής
- Εάν θέλετε να αφαιρέσετε τη σταθερά, προσθέστε -1 στο τέλος του τύπου
Παράδειγμα:
Θέλετε να υπολογίσετε το βάρος των ατόμων με βάση το ύψος και τα έσοδά τους. Η εξίσωση είναι

Η εξίσωση στο R γράφεται ως εξής:
y ~ X1+ X2+…+Xn # Με διακοπή
Έτσι για το παράδειγμά μας:
- Ζυγίζω ~ ύψος + έσοδα
Ο στόχος σας είναι να υπολογίσετε το μίλι ανά γαλόνι με βάση ένα σύνολο μεταβλητών. Η εξίσωση προς εκτίμηση είναι:

Θα εκτιμήσετε την πρώτη σας γραμμική παλινδρόμηση και θα αποθηκεύσετε το αποτέλεσμα στο κατάλληλο αντικείμενο.
model <- mpg ~ disp + hp + drat + wt + qsec
fit <- lm(model, df)
fit
Code εξήγηση
- μοντέλο <- mpg ~ disp + hp + drat + wt + qsec: Αποθηκεύστε το μοντέλο για εκτίμηση
- lm(μοντέλο, df): Υπολογίστε το μοντέλο με το πλαίσιο δεδομένων df
##
## Call:
## lm(formula = model, data = df)
##
## Coefficients:
## (Intercept)         disp           hp         drat           wt
##    16.53357      0.00872     -0.02060      2.01577     -4.38546
##        qsec
##     0.64015
Η έξοδος δεν παρέχει αρκετές πληροφορίες σχετικά με την ποιότητα της προσαρμογής. Μπορείτε να αποκτήσετε πρόσβαση σε περισσότερες λεπτομέρειες, όπως η σημασία των συντελεστών, ο βαθμός ελευθερίας και το σχήμα των υπολειμμάτων με τη συνάρτηση summary().
summary(fit)
Παραγωγή:
## return the p-value and coefficient
##
## Call:
## lm(formula = model, data = df)
##
## Residuals:
##     Min      1Q  Median      3Q     Max
## -3.5404 -1.6701 -0.4264  1.1320  5.4996
##
## Coefficients:
##             Estimate Std. Error t value Pr(>|t|)
## (Intercept) 16.53357   10.96423   1.508  0.14362
## disp         0.00872    0.01119   0.779  0.44281
## hp          -0.02060    0.01528  -1.348  0.18936
## drat         2.01578    1.30946   1.539  0.13579
## wt          -4.38546    1.24343  -3.527  0.00158 **
## qsec         0.64015    0.45934   1.394  0.17523
## ---
## Signif. codes:  0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1
##
## Residual standard error: 2.558 on 26 degrees of freedom
## Multiple R-squared:  0.8489, Adjusted R-squared:  0.8199
## F-statistic: 29.22 on 5 and 26 DF, p-value: 6.892e-10
Συμπεράσματα από την έξοδο του παραπάνω πίνακα
- Ο πίνακας δείχνει μια ισχυρή αρνητική σχέση μεταξύ wt και mpg, και έναν θετικό συντελεστή για το drat.
- Μόνο η μεταβλητή wt έχει στατιστικό αντίκτυπο στο mpg. Θυμηθείτε, για να ελέγξουμε μια υπόθεση στη στατιστική, χρησιμοποιούμε:
- H0: Καμία στατιστική επίδραση
- H1: Ο προγνωστικός παράγοντας έχει σημαντική επίδραση στο y
- Εάν η τιμή p είναι μικρότερη από 0.05, σημαίνει ότι η μεταβλητή είναι στατιστικά σημαντική
- Προσαρμοσμένο R-τετράγωνο: το μερίδιο της διακύμανσης του y που εξηγείται από το μοντέλο, διορθωμένο για τον αριθμό των προγνωστικών παραγόντων. Εδώ είναι 0.8199, επομένως το μοντέλο εξηγεί περίπου το 82% της διακύμανσης του mpg. Το R-τετράγωνο βρίσκεται πάντα μεταξύ 0 και 1, και όσο υψηλότερο είναι τόσο καλύτερο.
Μπορείτε να εκτελέσετε το ANOVA δοκιμή για την εκτίμηση της επίδρασης κάθε χαρακτηριστικού στις διακυμάνσεις με τη συνάρτηση anova().
anova(fit)
Παραγωγή:
## Analysis of Variance Table
##
## Response: mpg
##           Df Sum Sq Mean Sq  F value   Pr(>F)
## disp       1 808.89  808.89 123.6185 2.23e-11 ***
## hp         1  33.67   33.67   5.1449 0.031854 *
## drat       1  30.15   30.15   4.6073 0.041340 *
## wt         1  70.51   70.51  10.7754 0.002933 **
## qsec       1  12.71   12.71   1.9422 0.175233
## Residuals 26 170.13    6.54
## ---
## Signif. codes:  0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1
Ένας πιο συμβατικός τρόπος εκτίμησης της απόδοσης του μοντέλου είναι η εμφάνιση του υπολειπόμενου σε διαφορετικές μετρήσεις.
Μπορείτε να χρησιμοποιήσετε τη συνάρτηση plot() για να εμφανίσετε τέσσερα γραφήματα:
– Υπολείμματα έναντι προσαρμοσμένων τιμών
– Κανονική γραφική παράσταση QQ: Θεωρητικό τεταρτημόριο έναντι τυποποιημένων υπολειμμάτων
– Κλίμακα-Τοποθεσία: Προσαρμοσμένες τιμές έναντι τετραγωνικών ριζών των τυποποιημένων υπολειμμάτων
– Υπολείμματα έναντι μόχλευσης: Μόχλευση έναντι τυποποιημένων υπολειμμάτων
Προσθέτετε τον κώδικα par(mfrow = c(2, 2)) πριν από την plot(fit). Εάν δεν προσθέσετε αυτήν τη γραμμή κώδικα, η R σας ζητά να πατήσετε την εντολή enter για να εμφανιστεί το επόμενο γράφημα.
par(mfrow = c(2, 2))
Code εξήγηση
- (mfrow=c(2,2)): επιστρέψτε ένα παράθυρο με τα τέσσερα γραφήματα δίπλα-δίπλα.
- Οι πρώτες 2 προσθέτουν τον αριθμό των σειρών
- Το δεύτερο 2 προσθέτει τον αριθμό των στηλών.
- Εάν γράψετε (mfrow=c(3,2)): θα δημιουργήσετε ένα παράθυρο 3 σειρών 2 στηλών
plot(fit)
Παραγωγή:

Ο τύπος lm() επιστρέφει μια λίστα που περιέχει πολλές χρήσιμες πληροφορίες. Μπορείτε να αποκτήσετε πρόσβαση σε αυτές με το αντικείμενο fit που έχετε δημιουργήσει, ακολουθούμενο από το σύμβολο $ και τις πληροφορίες που θέλετε να εξαγάγετε.tract.
– συντελεστές: «fit$coefficients».
– υπολείμματα: «fit$residuals».
– προσαρμοσμένη τιμή: «fit$fitted.values».
Παλινδρόμηση παραγόντων στο R
Στην τελευταία εκτίμηση μοντέλου, υποχωρείτε mpg μόνο σε συνεχείς μεταβλητές. Είναι εύκολο να προσθέσετε μεταβλητές παραγόντων στο μοντέλο. Προσθέτετε τη μεταβλητή am στο μοντέλο σας. Είναι σημαντικό να βεβαιωθείτε ότι η μεταβλητή είναι επίπεδο παράγοντα και όχι συνεχής.
df <- mtcars %>%
    mutate(cyl = factor(cyl),
        vs = factor(vs),
        am = factor(am),
        gear = factor(gear),
        carb = factor(carb))
model <- mpg ~ .
summary(lm(model, df))
Παραγωγή:
##
## Call:
## lm(formula = model, data = df)
##
## Residuals:
##     Min      1Q  Median      3Q     Max
## -3.5087 -1.3584 -0.0948  0.7745  4.6251
##
## Coefficients:
##             Estimate Std. Error t value Pr(>|t|)
## (Intercept) 23.87913   20.06582   1.190   0.2525
## cyl6        -2.64870    3.04089  -0.871   0.3975
## cyl8        -0.33616    7.15954  -0.047   0.9632
## disp         0.03555    0.03190   1.114   0.2827
## hp          -0.07051    0.03943  -1.788   0.0939 .
## drat         1.18283    2.48348   0.476   0.6407
## wt          -4.52978    2.53875  -1.784   0.0946 .
## qsec         0.36784    0.93540   0.393   0.6997
## vs1          1.93085    2.87126   0.672   0.5115
## am1          1.21212    3.21355   0.377   0.7113
## gear4        1.11435    3.79952   0.293   0.7733
## gear5        2.52840    3.73636   0.677   0.5089
## carb2       -0.97935    2.31797  -0.423   0.6787
## carb3        2.99964    4.29355   0.699   0.4955
## carb4        1.09142    4.44962   0.245   0.8096
## carb6        4.47757    6.38406   0.701   0.4938
## carb8        7.25041    8.36057   0.867   0.3995
## ---
## Signif. codes:  0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1
##
## Residual standard error: 2.833 on 15 degrees of freedom
## Multiple R-squared:  0.8931, Adjusted R-squared:  0.779
## F-statistic:  7.83 on 16 and 15 DF,  p-value: 0.000124
Το R χρησιμοποιεί το πρώτο επίπεδο παράγοντα ως βασική ομάδα. Πρέπει να συγκρίνετε τους συντελεστές της άλλης ομάδας με τη βασική ομάδα.
Υποθέσεις Γραμμικής Παλινδρόμησης στην R
Η συνηθισμένη μέθοδος των ελαχίστων τετραγώνων παράγει αξιόπιστους συντελεστές και τιμές p μόνο όταν ισχύουν πέντε συνθήκες. Τα τέσσερα διαγνωστικά γραφήματα που παράγονται από την plot(fit) υπάρχουν ακριβώς για να τα ελέγξουν.
- Γραμμικότητα: η σχέση μεταξύ κάθε προγνωστικού παράγοντα και του y είναι γραμμική. Ελέγξτε το Υπολείμματα έναντι Τοποθετημένων διάγραμμα· μια ορατή καμπύλη σημαίνει ότι χρειάζεστε έναν μετασχηματισμό ή έναν πολυωνυμικό όρο.
- Ανεξαρτησία: Οι όροι σφάλματος δεν είναι συσχετισμένοι. Τα δεδομένα με χρονική σειρά συχνά παραβιάζουν αυτό το πρότυπο, το οποίο μπορείτε να ελέγξετε με την durbinWatsonTest() από το πακέτο car.
- Ομοσκεδαστικότητα: η διακύμανση σφάλματος είναι σταθερή σε όλες τις προσαρμοσμένες τιμές. Ένα σχήμα χοάνης στο Κλίμακα-Τοποθεσία Το γράφημα υποδηλώνει παραβίαση.
- Κανονικότητα υπολειμμάτων: τα σφάλματα ακολουθούν μια κανονική κατανομή. Τα σημεία θα πρέπει να βρίσκονται στη διαγώνιο του Κανονικό QQ οικόπεδο.
- Χωρίς πολυσυγγραμμικότητα: Οι προγνωστικοί παράγοντες δεν είναι σχεδόν διπλότυποι ο ένας του άλλου. Ένας συντελεστής πληθωρισμού διακύμανσης άνω του 5 είναι η συνήθης γραμμή προειδοποίησης.
library(car)
vif(fit)           # variance inflation factors
shapiro.test(residuals(fit))   # normality of residuals
Οι παραβιάσεις δεν ακυρώνουν πάντα ένα μοντέλο, αλλά αλλάζουν την αξιοπιστία των τιμών p, επομένως ελέγξτε τις πριν αναφέρετε οποιονδήποτε συντελεστή.
Πώς να κάνετε προβλέψεις με ένα γραμμικό μοντέλο παλινδρόμησης στην R
Η προσαρμογή ενός μοντέλου είναι μόνο η μισή δουλειά. Η συνάρτηση predict() εφαρμόζει τους προσαρμοσμένους συντελεστές σε νέες παρατηρήσεις.
predict(object, newdata, interval = "none", level = 0.95)
arguments:
-object: The model returned by lm()
-newdata: A data frame whose columns match the predictors used in the formula
-interval: "none", "confidence" for the mean response, or "prediction" for a single new case
-level: The confidence level, 0.95 by default
Ακολουθήστε αυτά τα τρία βήματα.
- Δημιουργήστε ένα πλαίσιο δεδομένων νέων περιπτώσεων. Τα ονόματα των στηλών πρέπει να ταιριάζουν ακριβώς με τα ονόματα των προγνωστικών στον τύπο και τα επίπεδα των παραγόντων πρέπει να ταιριάζουν με τα δεδομένα εκπαίδευσης.
- Καλέστε την predict(). Περάστε το προσαρμοσμένο αντικείμενο και το νέο πλαίσιο δεδομένων.
- Προσθέστε ένα διάστημα. Επιλέξτε «εμπιστοσύνη» όταν θέλετε την αβεβαιότητα γύρω από τη μέση απόκριση και «πρόβλεψη» όταν θέλετε την αυτονομία για ένα μεμονωμένο αυτοκίνητο.
new_cars <- data.frame(wt = c(2.5, 3.2), hp = c(110, 175))
fit_final <- lm(mpg ~ wt + hp, data = mtcars)

predict(fit_final, newdata = new_cars)
predict(fit_final, newdata = new_cars, interval = "prediction")
Διαβάζοντας το αποτέλεσμα. Ένα αυτοκίνητο βάρους 2.5 χιλιάδων λιβρών με 110 ίππους προβλέπεται να καταναλώσει περίπου 24.1 mpg. Το διάστημα πρόβλεψης είναι πάντα μεγαλύτερο από το διάστημα εμπιστοσύνης, επειδή φέρει την αβεβαιότητα μιας μεμονωμένης παρατήρησης επιπλέον της αβεβαιότητας της προσαρμοσμένης γραμμής.
Δύο κανόνες διατηρούν τις προβλέψεις ειλικρινείς. Ποτέ μην κάνετε παρέκταση πέρα από το εύρος των προγνωστικών εκπαίδευσης, επειδή η ευθεία γραμμή δεν έχει καμία απόδειξη. Και πάντα να αξιολογείτε με βάση δεδομένα που δεν έχει δει το μοντέλο, διαφορετικά το αναφερόμενο σφάλμα είναι αισιόδοξο.
Γραμμική Παλινδρόμηση έναντι Λογιστικής Παλινδρόμησης σε R
Οι αναλυτές συχνά καταφεύγουν στην lm() όταν το αποτέλεσμα δεν είναι συνεχές. Ο παρακάτω πίνακας δείχνει πού βρίσκεται το όριο.
| Κριτήρια | γραμμική Παλινδρόμηση | Λογιστική παλινδρόμηση |
|---|---|---|
| Μεταβλητή απόκρισης | Συνεχής | Δυαδικό ή κατηγορικό |
| Προβλεπόμενη απόδοση | Οποιοσδήποτε πραγματικός αριθμός | Μια πιθανότητα μεταξύ 0 και 1 |
| Εκτίμηση | Συνηθισμένα ελάχιστα τετράγωνα | Μέγιστη πιθανότητα |
| Μέτρο προσαρμογής | R-τετράγωνο, RMSE | AIC, απόκλιση, ακρίβεια |
| Συνάρτηση R | lm(τύπος, δεδομένα) | glm(τύπος, δεδομένα, οικογένεια = “διωνυμικό”) |
Εάν το αποτέλεσμα είναι μια απόφαση ναι ή όχι, προχωρήστε στο γενικευμένο γραμμικό μοντέλο αντί να επιβάλλει μια ευθεία γραμμή μέσα από μηδενικά και μονάδες.
Βηματική Γραμμική Παλινδρόμηση στο R
Το τελευταίο μέρος αυτού του σεμιναρίου ασχολείται με το σταδιακή παλινδρόμηση αλγόριθμος. Ο σκοπός αυτού του αλγορίθμου είναι να προσθέσει και να αφαιρέσει πιθανούς υποψηφίους στα μοντέλα και να διατηρήσει αυτούς που έχουν σημαντικό αντίκτυπο στην εξαρτημένη μεταβλητή. Αυτός ο αλγόριθμος έχει νόημα όταν το σύνολο δεδομένων περιέχει μια μεγάλη λίστα προγνωστικών. Δεν χρειάζεται να προσθέσετε και να αφαιρέσετε μη αυτόματα τις ανεξάρτητες μεταβλητές. Η σταδιακή παλινδρόμηση έχει δημιουργηθεί για να επιλέγει τους καλύτερους υποψηφίους που ταιριάζουν στο μοντέλο.
Ας δούμε στην πράξη πώς λειτουργεί. Χρησιμοποιείτε το σύνολο δεδομένων mtcars με τις συνεχείς μεταβλητές μόνο για παιδαγωγικό παράδειγμα. Πριν ξεκινήσετε την ανάλυση, είναι καλή πρακτική να ελέγξετε τις σχέσεις στα δεδομένα με έναν πίνακα συσχέτισης. Η βιβλιοθήκη GGally είναι μια επέκταση του ggplot2.
Η βιβλιοθήκη περιλαμβάνει διαφορετικές συναρτήσεις για την εμφάνιση συνοπτικών στατιστικών, όπως συσχέτιση και κατανομή όλων των μεταβλητών σε έναν πίνακα. Θα χρησιμοποιήσουμε τη συνάρτηση ggscatmat, αλλά μπορείτε να ανατρέξετε στο βινιέτα για περισσότερες πληροφορίες σχετικά με τη βιβλιοθήκη GGally.
Η βασική σύνταξη για το ggscatmat() είναι:
ggscatmat(df, columns = 1:ncol(df), corMethod = "pearson")
arguments:
-df:  A matrix of continuous variables
-columns: Pick up the columns to use in the function. By default, all columns are used
-corMethod: Define the function to compute the correlation between variable. By default, the algorithm uses the Pearson formula
Εμφανίζετε τη συσχέτιση για όλες τις μεταβλητές σας και αποφασίζετε ποιες είναι οι καλύτερες υποψήφιες για το πρώτο βήμα της σταδιακής παλινδρόμησης. Υπάρχουν ορισμένες ισχυρές συσχετίσεις μεταξύ των μεταβλητών σας και της εξαρτημένης μεταβλητής, mpg.
library(GGally)
df <- mtcars %>%
	select(-c(am, vs, cyl, gear, carb))
ggscatmat(df, columns = 1: ncol(df))
Παραγωγή:

Βήμα προς βήμα Παλινδρόμηση Παράδειγμα
Η επιλογή μεταβλητών είναι ένα σημαντικό μέρος της προσαρμογής ενός μοντέλου και η σταδιακή παλινδρόμηση εκτελεί αυτήν την αναζήτηση αυτόματα. Για να εκτιμήσετε πόσες πιθανές επιλογές υπάρχουν στο σύνολο δεδομένων, υπολογίζετε  με k είναι ο αριθμός των προβλέψεων. Ο αριθμός των δυνατοτήτων μεγαλώνει με τον αριθμό των ανεξάρτητων μεταβλητών. Γι' αυτό πρέπει να έχετε μια αυτόματη αναζήτηση.
Πρέπει να εγκαταστήσετε το πακέτο olsrr από το CRAN. Το πακέτο δεν είναι ακόμα διαθέσιμο στο Anaconda. Ως εκ τούτου, το εγκαθιστάτε απευθείας από τη γραμμή εντολών:
install.packages("olsrr")
Μπορείτε να σχεδιάσετε όλα τα υποσύνολα δυνατοτήτων με τα κριτήρια προσαρμογής (π.χ. R-square, Adjusted R-square, Bayesian κριτήρια). Το μοντέλο με τα χαμηλότερα κριτήρια AIC θα είναι το τελικό μοντέλο.
library(olsrr)
model <- mpg~.
fit <- lm(model, df)
test <- ols_all_subset(fit)
plot(test)
Code εξήγηση
- mpg ~.: Κατασκευάστε το μοντέλο για εκτίμηση
- lm(μοντέλο, df): Εκτέλεση του μοντέλου OLS
- ols_all_subset(προσαρμογή): Κατασκευάστε τα γραφήματα με τις σχετικές στατιστικές πληροφορίες
- πλοκή (δοκιμή): Σχεδιάστε τα γραφήματα
Παραγωγή:

Τα μοντέλα γραμμικής παλινδρόμησης χρησιμοποιούν το δοκιμή t για την εκτίμηση της στατιστικής επίδρασης μιας ανεξάρτητης μεταβλητής στην εξαρτημένη μεταβλητή. Οι ερευνητές συνήθως ορίζουν το μέγιστο όριο στο 10% και οι χαμηλότερες τιμές p υποδεικνύουν ισχυρότερη στατιστική σύνδεση. Η σταδιακή παλινδρόμηση βασίζεται σε αυτό το τεστ για την προσθήκη και αφαίρεση υποψήφιων προγνωστικών παραγόντων. Ο αλγόριθμος λειτουργεί ως εξής:

- Βήμα 1: Αναδρομή κάθε προγνωστικού στο y ξεχωριστά. Δηλαδή, παλινδρομήστε το x_1 στο y, το x_2 στο y στο x_n. Αποθηκεύστε το p-value και διατηρήστε τον παλινδρομητή με τιμή p χαμηλότερη από ένα καθορισμένο όριο (0.1 από προεπιλογή). Οι προγνωστικοί παράγοντες με σημαντικότητα χαμηλότερη από το όριο θα προστεθούν στο τελικό μοντέλο. Εάν καμία μεταβλητή δεν έχει τιμή p χαμηλότερη από το όριο εισαγωγής, τότε ο αλγόριθμος σταματά και έχετε το τελικό σας μοντέλο μόνο με σταθερά.
- Βήμα 2: Χρησιμοποιήστε τον προγνωστικό δείκτη με τη χαμηλότερη τιμή p και προσθέτετε ξεχωριστά μία μεταβλητή. Παθαίνεις μια σταθερά, ο καλύτερος προγνωστικός δείκτης του βήματος ένα και μιας τρίτης μεταβλητής. Προσθέτετε στο σταδιακό μοντέλο, τους νέους προγνωστικούς παράγοντες με τιμή χαμηλότερη από το όριο εισαγωγής. Εάν καμία μεταβλητή δεν έχει τιμή p μικρότερη από 0.1, τότε ο αλγόριθμος σταματά και έχετε το τελικό σας μοντέλο με έναν μόνο προγνωστικό παράγοντα. Παθάνετε το σταδιακό μοντέλο για να ελέγξετε τη σημασία των καλύτερων προγνωστικών του βήματος 1. Εάν είναι υψηλότερο από το όριο αφαίρεσης, το κρατάτε στο σταδιακό μοντέλο. Διαφορετικά το αποκλείεις.
- Βήμα 3: Αντιγράφετε το βήμα 2 στο νέο καλύτερο σταδιακό μοντέλο. Ο αλγόριθμος προσθέτει προγνωστικούς παράγοντες στο σταδιακό μοντέλο με βάση τις τιμές εισαγωγής και αποκλείει τον προγνωστικό από το σταδιακό μοντέλο εάν δεν ικανοποιεί το όριο εξαίρεσης.
- Ο αλγόριθμος συνεχίζει μέχρι να μην μπορεί να προστεθεί ή να εξαιρεθεί καμία μεταβλητή.
Μπορείτε να εκτελέσετε τον αλγόριθμο με τη συνάρτηση ols_stepwise() από το πακέτο olsrr.
ols_stepwise(fit, pent = 0.1, prem = 0.3, details = FALSE)

arguments:
-fit:  Model to fit. Need to use `lm()`before to run `ols_stepwise()
-pent: Threshold of the p-value used to enter a variable into the stepwise model. By default, 0.1
-prem: Threshold of the p-value used to exclude a variable into the stepwise model. By default, 0.3
-details: Print the details of each step
⚠️ Σημείωση για το πακέτο: Οι πρόσφατες εκδόσεις του olsrr μετονόμασαν αυτές τις συναρτήσεις. Χρησιμοποιήστε ols_step_all_possible() στη θέση της ols_all_subset() και ols_step_both_p() στη θέση της ols_stepwise(). Τα ορίσματα και η έξοδος παραμένουν αμετάβλητα.
Πριν από αυτό, σας δείχνουμε τα βήματα του αλγορίθμου. Ακολουθεί ένας πίνακας με τις εξαρτημένες και ανεξάρτητες μεταβλητές:
| Εξαρτημένη μεταβλητή | Ανεξάρτητες μεταβλητές |
|---|---|
| mpg | διανομή |
| hp | |
| αρουραίος | |
| wt | |
| qsec |
Αρχική
Αρχικά, ο αλγόριθμος ξεκινά εκτελώντας το μοντέλο σε κάθε ανεξάρτητη μεταβλητή ξεχωριστά. Ο πίνακας δείχνει την τιμή p για κάθε μοντέλο.
## [[1]]
##  (Intercept)         disp
## 3.576586e-21 9.380327e-10
##
## [[2]]
##  (Intercept)           hp
## 6.642736e-18 1.787835e-07
##
## [[3]]
##  (Intercept)         drat
## 0.1796390847 0.0000177624
##
## [[4]]
##  (Intercept)           wt
## 8.241799e-19 1.293959e-10
##
## [[5]
## (Intercept)        qsec
##  0.61385436  0.01708199
Για να εισαγάγετε το μοντέλο, ο αλγόριθμος διατηρεί τη μεταβλητή με τη χαμηλότερη τιμή p. Από την παραπάνω έξοδο, είναι wt
Βήμα 1
Στο πρώτο βήμα, ο αλγόριθμος τρέχει mpg σε wt και τις άλλες μεταβλητές ανεξάρτητα.
## [[1]]
##  (Intercept)           wt         disp
## 4.910746e-16 7.430725e-03 6.361981e-02
##
## [[2]]
##  (Intercept)           wt           hp
## 2.565459e-20 1.119647e-06 1.451229e-03
##
## [[3]]
##  (Intercept)           wt         drat
## 2.737824e-04 1.589075e-06 3.308544e-01
##
## [[4]]
##  (Intercept)           wt         qsec
## 7.650466e-04 2.518948e-11 1.499883e-03
Κάθε μεταβλητή είναι μια πιθανή υποψήφια για να εισέλθει στο τελικό μοντέλο. Ωστόσο, ο αλγόριθμος διατηρεί μόνο τη μεταβλητή με τη χαμηλότερη τιμή p. Αποδεικνύεται ότι η hp έχει ελαφρώς χαμηλότερη τιμή p από την qsec, επομένως η hp εισέρχεται στο τελικό μοντέλο.
Βήμα 2
Ο αλγόριθμος επαναλαμβάνει το πρώτο βήμα αλλά αυτή τη φορά με δύο ανεξάρτητες μεταβλητές στο τελικό μοντέλο.
## [[1]]
##  (Intercept)           wt           hp         disp
## 1.161936e-16 1.330991e-03 1.097103e-02 9.285070e-01
##
## [[2]]
##  (Intercept)           wt           hp         drat
## 5.133678e-05 3.642961e-04 1.178415e-03 1.987554e-01
##
## [[3]]
##  (Intercept)           wt           hp         qsec
## 2.784556e-03 3.217222e-06 2.441762e-01 2.546284e-01
Κανένας από τους υπόλοιπους υποψηφίους δεν έχει τιμή p κάτω από το όριο εισόδου. Ο αλγόριθμος σταματά εδώ και αυτό είναι το τελικό μοντέλο:
##
## Call:
## lm(formula = mpg ~ wt + hp, data = df)
##
## Residuals:
##    Min     1Q Median     3Q    Max
## -3.941 -1.600 -0.182  1.050  5.854
##
## Coefficients:
##             Estimate Std. Error t value Pr(>|t|)
## (Intercept) 37.22727    1.59879  23.285  < 2e-16 ***
## wt          -3.87783    0.63273  -6.129 1.12e-06 ***
## hp          -0.03177    0.00903  -3.519  0.00145 **
## ---
## Signif. codes:  0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1
##
## Residual standard error: 2.593 on 29 degrees of freedom
## Multiple R-squared:  0.8268, Adjusted R-squared:  0.8148
## F-statistic: 69.21 on 2 and 29 DF,  p-value: 9.109e-12
Μπορείτε να χρησιμοποιήσετε τη συνάρτηση ols_stepwise() για να συγκρίνετε τα αποτελέσματα.
stp_s <-ols_stepwise(fit, details=TRUE)
Παραγωγή:
Ο αλγόριθμος βρίσκει μια λύση μετά από δύο βήματα και επιστρέφει το ίδιο αποτέλεσμα με την παραπάνω χειροκίνητη αναλυτική παρουσίαση.
Το τελικό μοντέλο εξηγείται επομένως από δύο προγνωστικούς παράγοντες και μια τομή: τα μίλια ανά γαλόνι σχετίζονται αρνητικά τόσο με την ολική ιπποδύναμη όσο και με το βάρος.
## You are selecting variables based on p value...
## 1 variable(s) added....
## Variable Selection Procedure
##  Dependent Variable: mpg
##
##  Stepwise Selection: Step 1
##
##  Variable wt Entered
##
##                         Model Summary
## --------------------------------------------------------------
## R                       0.868       RMSE                3.046
## R-Squared               0.753       Coef. Var          15.161
## Adj. R-Squared          0.745       MSE                 9.277
## Pred R-Squared          0.709       MAE                 2.341
## --------------------------------------------------------------
##  RMSE: Root Mean Square Error
##  MSE: Mean Square Error
##  MAE: Mean Absolute Error
##		ANOVA
## --------------------------------------------------------------------
##                 Sum of
##                Squares        DF    Mean Square      F         Sig.
## --------------------------------------------------------------------
## Regression     847.725         1        847.725    91.375    0.0000
## Residual       278.322        30          9.277
## Total         1126.047        31
## --------------------------------------------------------------------
##
##                                   Parameter Estimates
## ----------------------------------------------------------------------------------------
##       model      Beta    Std. Error    Std. Beta      t        Sig      lower     upper
## ----------------------------------------------------------------------------------------
## (Intercept)    37.285         1.878                 19.858    0.000    33.450    41.120
##          wt    -5.344         0.559       -0.868    -9.559    0.000    -6.486    -4.203
## ----------------------------------------------------------------------------------------
## 1 variable(s) added...
## Stepwise Selection: Step 2
##
##  Variable hp Entered
##
##                         Model Summary
## --------------------------------------------------------------
## R                       0.909       RMSE                2.593
## R-Squared               0.827       Coef. Var          12.909
## Adj. R-Squared          0.815       MSE                 6.726
## Pred R-Squared          0.781       MAE                 1.901
## --------------------------------------------------------------
##  RMSE: Root Mean Square Error
##  MSE: Mean Square Error
##  MAE: Mean Absolute Error
##			ANOVA
## --------------------------------------------------------------------
##                 Sum of
##                Squares        DF    Mean Square      F         Sig.
## --------------------------------------------------------------------
## Regression     930.999         2        465.500    69.211    0.0000
## Residual       195.048        29          6.726
## Total         1126.047        31
## --------------------------------------------------------------------
##
##                                   Parameter Estimates
## ----------------------------------------------------------------------------------------
##       model      Beta    Std. Error    Std. Beta      t        Sig      lower     upper
## ----------------------------------------------------------------------------------------
## (Intercept)    37.227         1.599                 23.285    0.000    33.957    40.497
##          wt    -3.878         0.633       -0.630    -6.129    0.000    -5.172    -2.584
##          hp    -0.032         0.009       -0.361    -3.519    0.001    -0.050    -0.013
## ----------------------------------------------------------------------------------------
## No more variables to be added or removed.
Γραμμική Παλινδρόμηση στην R: Βασικά Συμπεράσματα και Αναφορά Συναρτήσεων
- Η γραμμική παλινδρόμηση απαντά σε ένα απλό ερώτημα: μπορείτε να μετρήσετε μια ακριβή σχέση μεταξύ μιας μεταβλητής-στόχου και ενός συνόλου προγνωστικών παραγόντων;
- Η μέθοδος των Συνηθισμένων Ελάχιστων Τετραγώνων βρίσκει τις παραμέτρους που ελαχιστοποιούν το άθροισμα των τετραγώνων των σφαλμάτων, δηλαδή την κατακόρυφη απόσταση μεταξύ των προβλεπόμενων τιμών y και των πραγματικών τιμών y.
- Το πιθανοτικό μοντέλο που περιλαμβάνει περισσότερες από μία ανεξάρτητες μεταβλητές ονομάζεται μοντέλα πολλαπλής παλινδρόμησης.
- Ο σκοπός του αλγόριθμου Βηματικής Γραμμικής Παλινδρόμησης είναι να προσθέσει και να αφαιρέσει πιθανούς υποψηφίους στα μοντέλα και να διατηρήσει αυτούς που έχουν σημαντικό αντίκτυπο στην εξαρτημένη μεταβλητή.
- Η επιλογή μεταβλητών είναι ένα σημαντικό μέρος της προσαρμογής ενός μοντέλου και η σταδιακή παλινδρόμηση εκτελεί αυτήν την αναζήτηση αυτόματα.
Κάθε συνάρτηση που χρησιμοποιείται σε αυτό το σεμινάριο παρατίθεται παρακάτω:
| Βιβλιοθήκη | Σκοπός | Λειτουργία | Επιχειρήματα |
|---|---|---|---|
| βάση | Υπολογίστε μια γραμμική παλινδρόμηση | lm() | τύπος, δεδομένα |
| βάση | Συνοψίστε το μοντέλο | περίληψη() | ταιριάζουν |
| βάση | Extracσυντελεστές t | lm()$συντελεστής | |
| βάση | Extract υπολείμματα | lm()$υπολείμματα | |
| βάση | Extracπροσαρμοσμένη τιμή t | lm()$fitted.values | |
| olsrr | Εκτέλεση σταδιακής παλινδρόμησης | ols_stepwise() | fit, pent = 0.1, prem = 0.3, λεπτομέρειες = FALSE |
ΣημείωσηΘυμηθείτε να μετατρέψετε τις κατηγορικές μεταβλητές σε παράγοντες πριν προσαρμόσετε το μοντέλο.
