
Gaussisk kerne i maskinlæring: Python Kernel metoder
 Evelyn Clarke
⚡ Smart opsummering
Gaussiske kernemetoder gør ikke-separerbare data lineært separerbare uden nogensinde at skulle bygge det højdimensionelle featurekort. Denne gennemgang viser polynomialkortet.ping manuelt, træner derefter en tilfældig Fourier-kerneklassifikator i TensorFlow.
Formålet med denne tutorial er at gøre et datasæt lineært adskilleligt. Tutorialen er opdelt i to dele:
- Funktionstransformation
- Træn en kerneklassifikator med TensorFlow
I første del vil du forstå ideen bag en kernemetode i maskinlæring, mens du i anden del vil se, hvordan man træner en kerneklassifikator med TensorFlowDu skal bruge datasættet for voksne. Formålet med dette datasæt er at klassificere omsætningen under og over 50 kr., ud fra hver husstands adfærd.
Hvorfor har du brug for Kernel Methods?
Målet med enhver klassifikator er at forudsige klasserne korrekt. For at gøre det skal datasættet være separerbart. Se på plottet nedenfor; det er forholdsvis enkelt at se, at alle punkter over den sorte linje tilhører den første klasse, og de andre punkter tilhører den anden klasse. Det er dog ekstremt sjældent at have et så simpelt datasæt. I de fleste tilfælde er dataene ikke separerbare, og data, der ikke er separerbare, giver naive klassifikatorer som logistisk regression problemer.
import numpy as np
  import matplotlib.pyplot as plt
  from mpl_toolkits.mplot3d import Axes3D
  x_lin = np.array([1,2,3,4,5,6,7,8,9,10])
  y_lin = np.array([2,2,3,2,2,9,6,8,8,9])
  label_lin = np.array([0,0,0,0,0,1,1,1,1,1])

  fig = plt.figure()
  ax=fig.add_subplot(111)
  plt.scatter(x_lin, y_lin, c=label_lin, s=60)
  plt.plot([-2.5, 10], [12.5, -2.5], 'k-', lw=2)
  ax.set_xlim([-5,15])
  ax.set_ylim([-5,15])plt.show()

I figuren nedenfor plotter vi et datasæt, der ikke er lineært separerbart. Hvis vi tegner en ret linje, vil de fleste punkter ikke blive klassificeret i den korrekte klasse.
En måde at løse dette problem på er at tage datasættet og transformere dataene til et andet featurekort. Det betyder, at du skal bruge en funktion til at flytte dataene til et andet plan, et der skal være lineært separerbart.
x = np.array([1,1,2,3,3,6,6,6,9,9,10,11,12,13,16,18])
y = np.array([18,13,9,6,15,11,6,3,5,2,10,5,6,1,3,1])
label = np.array([1,1,1,1,0,0,0,1,0,1,0,0,0,1,0,1])
fig = plt.figure()
plt.scatter(x, y, c=label, s=60)
plt.show()
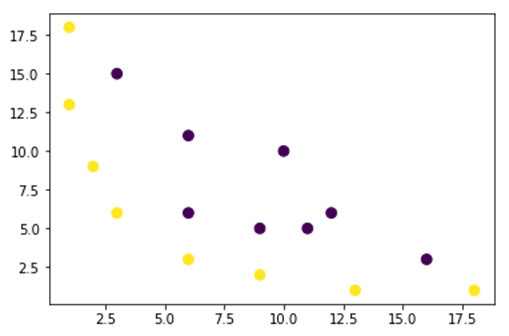
Dataene fra figuren ovenfor ligger i et 2D-plan og kan ikke separeres. Du kan forsøge at transformere disse data til tre dimensioner, hvilket betyder, at du opretter en figur med 3 akser.
I vores Gaussiske kerneeksempel anvender vi en polynomial afbildningping at bringe vores data til en tredje dimension. Formlen til at transformere dataene er som følger.

Du definerer en funktion i Gaussian Kernel Python for at oprette de nye funktionskort.
Du kan bruge nusset at kode ovenstående formel. Hver række nedenfor parrer et led af afbildningenping med det array-udtryk, der producerer det, og det lille billede markerer kvadratroden af to faktorer.
| Formula | Ækvivalent NumPy-kode |
|---|---|
| x | x[:,0] |
| y | x[:,1] |
| x² | x[:,0]**2 |
 |
np.sqrt(2)* |
| xy | x[:,0]*x[:,1] |
| y² | x[:,1]**2 |
### illustration purpose
def mapping(x, y):
	x = np.c_[(x, y)]
    if len(x) >	2:
    	x_1 = x[:,0]**2
        x_2 = np.sqrt(2)*x[:,0]*x[:,1]
        x_3 = x[:,1]**2
    else:
    	x_1 = x[0]**2
        x_2 = np.sqrt(2)*x[0]*x[1]
        x_3 = x[1]**2
   trans_x = np.array([x_1, x_2, x_3])
   return trans_x
Det nye kortping har 3 dimensioner og 16 punkter.
x_1  = mapping(x, y)
x_1.shape
(3, 16)
Lav nu et nyt plot med 3 akser, henholdsvis x, y og z.
# plot
fig = plt.figure()
ax = fig.add_subplot(111, projection='3d')
ax.scatter(x_1[0], x_1[1], x_1[2], c=label, s=60)
ax.view_init(30, 185)ax.set_xlabel('X Label')
ax.set_ylabel('Y Label')
ax.set_zlabel('Z Label')
plt.show()

Vi ser en forbedring, men hvis vi ændrer plottets orientering, bliver det tydeligt, at datasættet nu kan separeres.
# plot
fig = plt.figure()
ax = fig.add_subplot(111, projection='3d')
ax.scatter(x_1[0], x_1[1], x_1[1], c=label, s=60)
ax.view_init(0, -180)ax.set_ylim([150,-50])
ax.set_zlim([-10000,10000])
ax.set_xlabel('X Label')
ax.set_ylabel('Y Label')
ax.set_zlabel('Z Label')plt.show()

Hvis du skal manipulere et stort datasæt og oprette mere end 2 dimensioner, vil du støde på et stort problem med ovenstående metode. Faktisk skal du transformere alle datapunkter, hvilket tydeligvis ikke er bæredygtigt. Det vil tage dig evigheder, og din computer kan løbe tør for hukommelse.
Den mest almindelige måde at løse dette problem på er at bruge en kerne.
Hvad er en kerne i maskinlæring?
Ideen er at bruge et funktionsrum med højere dimensioner for at gøre dataene næsten lineært separerbare, som vist i figuren ovenfor.
Der er masser af højere dimensionelle rum, der gør datapunkterne separerbare. For eksempel har vi vist, at polynomialafbildningenping er en god start.
Vi har også vist, at disse transformationer ikke er effektive med store mængder data. I stedet kan man bruge en kernefunktion i maskinlæring til at ændre dataene uden at flytte til et nyt funktionsplan.
Magien ved kernen er at finde en funktion, der undgår alle de problemer, der følger med højdimensionel beregning. Resultatet af en kerne er en skalar, eller sagt på en anden måde, vi er tilbage til et endimensionelt rum.
Når du har fundet denne funktion, kan du tilslutte den til den standard lineære klassifikator.
Her er et eksempel, der konkretiserer konceptet med Kernel Machine Learning. Du har to vektorer, x1 og x2. Målet er at skabe en højere dimension ved hjælp af en polynomial afbildning.pingOutputtet er lig med punktproduktet af det nye objektkort. Fra ovenstående metode skal du:
- Transform x1 og x2 til en ny dimension
- Beregn prikproduktet: fælles for alle kerner
Transform x1 og x2 til en ny dimension
Du kan bruge funktionen oprettet ovenfor til at beregne den højere dimension.
## Kernel
x1 = np.array([3,6])
x2 = np.array([10,10])

x_1 = mapping(x1, x2)
print(x_1)
Produktion
[[  9.         100.        ]
      [ 25.45584412 141.42135624]
      [ 36.         100.        ]]
Beregn prikproduktet
Du kan bruge objektprikken fra nusset at beregne prikproduktet mellem den første og anden vektor gemt i x_1.
print(np.dot(x_1[:,0], x_1[:,1]))
8100.0
Outputtet er 8100. Du ser problemet: du skal gemme et nyt objektkort i hukommelsen for at beregne prikproduktet. Hvis du har et datasæt med millioner af poster, er det beregningsmæssigt ineffektivt.
I stedet kan du bruge polynomiets kerne til at beregne prikproduktet uden at transformere vektoren. Denne funktion beregner prikproduktet af x1 og x2, som om disse to vektorer var blevet transformeret til den højere dimension. Med andre ord beregner en kernefunktion resultatet af prikproduktet fra et andet featurerum.
Du kan skrive polynomiets kernefunktion i Python som følger.
def polynomial_kernel(x, y, p=2):
	return (np.dot(x, y)) ** p
Det er styrken af prikproduktet af to vektorer. Nedenfor returnerer du anden grad af polynomiumkernen. Outputtet er lig med den anden metode. Dette er kernens magi.
polynomial_kernel(x1, x2, p=2)
8100
Typer af kernemetoder
Der findes mange forskellige kerneteknikker. Den enkleste er den lineære kerne. Denne funktion fungerer ret godt til tekstklassificering. De andre kerner er:
- Polynomisk kerne
- Gaussisk kerne
Tabellen nedenfor opsummerer, hvad hver enkelt gør, og hvornår praktikere griber efter det.
| kernel | Hvad den beregner | Typisk brug |
|---|---|---|
| Lineær | Det almindelige prikprodukt i det oprindelige funktionsrum | Allerede adskillelige data og højdimensionelle tekstfunktioner |
| polynomial | Prikproduktet opløftet til en grad p, der indfanger funktionsinteraktioner | Buede grænser, når interaktionerne vides at have betydning |
| Gaussisk (RBF) | En afstandsbaseret lighed, der falder mod nul, når punkter bevæger sig fra hinanden | Det sædvanlige førstevalg, når grænseformen er ukendt |
I eksemplet med TensorFlow bruger vi tilfældige Fourier-funktioner. TensorFlow har en indbygget estimator til at beregne det nye funktionsrum. Den tilfældige Fourier-funktionsmapper er en tilnærmelse af den gaussiske kernefunktion vist nedenfor.

Den Gaussiske filtreringsfunktion beregner ligheden mellem datapunkterne i et meget højere dimensionelt rum.
Når teorien er afklaret, sætter resten af denne gennemgang en Gaussisk kerne i gang med et rigtigt datasæt.
Træn Gaussian Kernel-klassifikator med TensorFlow
Formålet med algoritmen er at klassificere husstanden, der tjener mere eller mindre end 50k.
Du skal først evaluere en logistisk regression for at få en benchmarkmodel. Derefter skal du træne en kerneklassifikator for at se, om du kan få bedre resultater.
Du bruger følgende variabler fra voksendatasættet:
- alder
- arbejdsklasse
- fnlwgt
- uddannelse
- uddannelsesnummer
- ægteskabelig
- besættelse
- forhold
- løb
- køn
- kapitalgevinst
- kapitaltab
- timer_uge
- oprindelses land
- label
Du skal gå frem på følgende måde, før du træner og evaluerer modellen:
- Importer bibliotekerne
- Importer dataene
- Forbered dataene
- Konstruér den logistiske model: basismodel
- Vurder modellen
- Konstruer og evaluer kerneklassifikatoren
Versionsnotat: Hvert kodestykke nedenfor er rettet mod TensorFlow 1.x. Navnerummet tf.contrib, som leverer real_valued_column, RandomFourierFeatureMapper og KernelLinearClassifier, blev fjernet i TensorFlow 2.0, og selve tf.estimator blev fjernet i TensorFlow 2.16. I en nuværende udgivelse skal du bygge den samme pipeline med laget tf.keras.layers.experimental.RandomFourierFeatures efterfulgt af et Dense output-lag, eller med RBFSampler- og SGDClassifier-parret fra scikit-learn.
Trin 1) Importer bibliotekerne
At importere og træne Kernel-modeller i Kunstig intelligens, du skal importere TensorFlow, pandaer og NumPy.
#import numpy as np
from sklearn.model_selection
import train_test_split
import tensorflow as tf
import pandas as pd
import numpy as np
Trin 2) Importer dataene
Du downloader dataene fra UCI-side med datasæt for voksne og importer den som en pandas DataFrame.
## Define path data
COLUMNS = ['age','workclass', 'fnlwgt', 'education', 'education_num', 'marital', 'occupation', 'relationship', 'race', 'sex', 'capital_gain', 'capital_loss', 'hours_week', 'native_country', 'label']
PATH = "https://archive.ics.uci.edu/ml/machine-learning-databases/adult/adult.data"
PATH_test ="https://archive.ics.uci.edu/ml/machine-learning-databases/adult/adult.test
"## Import
df_train = pd.read_csv(PATH, skipinitialspace=True, names = COLUMNS, index_col=False)
df_test = pd.read_csv(PATH_test,skiprows = 1, skipinitialspace=True, names = COLUMNS, index_col=False)
Nu hvor toget og testsættet er defineret, kan du ændre kolonnenavnet fra streng til heltal. TensorFlow accepterer ikke strengværdier for navnet.
label = {'<=50K': 0,'>50K': 1}
df_train.label = [label[item] for item in df_train.label]
label_t = {'<=50K.': 0,'>50K.': 1}
df_test.label = [label_t[item] for item in df_test.label]
df_train.shape
(32561, 15)
Trin 3) Forbered dataene
Datasættet indeholder både kontinuerlige og kategoriske funktioner. Det er god praksis at standardisere værdierne af de kontinuerlige variabler. Du kan bruge funktionen StandardScaler fra scikit-læreDu opretter også en brugerdefineret funktion for at gøre det nemmere at konvertere tog- og testsættet. Bemærk, at du sammenkæder de kontinuerlige og kategoriske variabler til et fælles datasæt, og at arrayet skal være af typen float32.
COLUMNS_INT = ['age','fnlwgt','education_num','capital_gain', 'capital_loss', 'hours_week']
CATE_FEATURES = ['workclass', 'education', 'marital', 'occupation', 'relationship', 'race', 'sex', 'native_country']
from sklearn.preprocessing import StandardScaler
from sklearn import preprocessing

def prep_data_str(df):
	scaler = StandardScaler()
    le = preprocessing.LabelEncoder()
    df_toscale = df[COLUMNS_INT]
    df_scaled = scaler.fit_transform(df_toscale.astype(np.float64))
    X_1 = df[CATE_FEATURES].apply(le.fit_transform)
    y = df['label'].astype(np.int32)
    X_conc = np.c_[df_scaled, X_1].astype(np.float32)
    return X_conc, y
Transformer-funktionen er klar, så du kan konvertere datasættet og oprette input_fn-funktionen.
X_train, y_train = prep_data_str(df_train)
X_test, y_test = prep_data_str(df_test)
print(X_train.shape)
(32561, 14)
I næste trin træner du en logistisk regression. Det vil give dig en baseline nøjagtighed. Målet er at slå basislinjen med en anden algoritme, nemlig en Kernel-klassifikator.
Trin 4) Konstruer den logistiske model: Basismodel
Du konstruerer funktionskolonnen med objektet real_valued_column. Det vil sikre, at alle variabler er tætte numeriske data.
feat_column = tf.contrib.layers.real_valued_column('features', dimension=14)
Estimatoren defineres ved hjælp af TensorFlow Estimator API'en; du angiver funktionskolonnerne og hvor grafen skal gemmes.
estimator = tf.estimator.LinearClassifier(feature_columns=[feat_column],
                                          n_classes=2,
                                          model_dir = "kernel_log"
                                         )
INFO:tensorflow:Using default config.INFO:tensorflow:Using config: {'_model_dir': 'kernel_log', '_tf_random_seed': None, '_save_summary_steps': 100, '_save_checkpoints_steps': None, '_save_checkpoints_secs': 600, '_session_config': None, '_keep_checkpoint_max': 5, '_keep_checkpoint_every_n_hours': 10000, '_log_step_count_steps': 100, '_train_distribute': None, '_service': None, '_cluster_spec': <tensorflow.python.training.server_lib.ClusterSpec object at 0x1a2003f780>, '_task_type': 'worker', '_task_id': 0, '_global_id_in_cluster': 0, '_master': '', '_evaluation_master': '', '_is_chief': True, '_num_ps_replicas': 0, '_num_worker_replicas': 1}
Du vil træne den logistiske regression ved hjælp af mini-batches af størrelse 200.
# Train the model
train_input_fn = tf.estimator.inputs.numpy_input_fn(
	x={"features": X_train},
    y=y_train,
    batch_size=200,
    num_epochs=None,
    shuffle=True)
Du kan træne modellen med 1,000 iterationer.
estimator.train(input_fn=train_input_fn, steps=1000)
INFO:tensorflow:Calling model_fn.
INFO:tensorflow:Done calling model_fn.
INFO:tensorflow:Create CheckpointSaverHook.
INFO:tensorflow:Graph was finalized.
INFO:tensorflow:Running local_init_op.
INFO:tensorflow:Done running local_init_op.
INFO:tensorflow:Saving checkpoints for 1 into kernel_log/model.ckpt.
INFO:tensorflow:loss = 138.62949, step = 1
INFO:tensorflow:global_step/sec: 324.16
INFO:tensorflow:loss = 87.16762, step = 101 (0.310 sec)
INFO:tensorflow:global_step/sec: 267.092
INFO:tensorflow:loss = 71.53657, step = 201 (0.376 sec)
INFO:tensorflow:global_step/sec: 292.679
INFO:tensorflow:loss = 69.56703, step = 301 (0.340 sec)
INFO:tensorflow:global_step/sec: 225.582
INFO:tensorflow:loss = 74.615875, step = 401 (0.445 sec)
INFO:tensorflow:global_step/sec: 209.975
INFO:tensorflow:loss = 76.49044, step = 501 (0.475 sec)
INFO:tensorflow:global_step/sec: 241.648
INFO:tensorflow:loss = 66.38373, step = 601 (0.419 sec)
INFO:tensorflow:global_step/sec: 305.193
INFO:tensorflow:loss = 87.93341, step = 701 (0.327 sec)
INFO:tensorflow:global_step/sec: 396.295
INFO:tensorflow:loss = 76.61518, step = 801 (0.249 sec)
INFO:tensorflow:global_step/sec: 359.857
INFO:tensorflow:loss = 78.54885, step = 901 (0.277 sec)
INFO:tensorflow:Saving checkpoints for 1000 into kernel_log/model.ckpt.
INFO:tensorflow:Loss for final step: 67.79706.


<tensorflow.python.estimator.canned.linear.LinearClassifier at 0x1a1fa3cbe0>
Trin 5) Evaluer modellen
Du definerer NumPy-inputfunktionen til at evaluere modellen. Du bruger hele testsættet til evaluering.
# Evaluation
test_input_fn = tf.estimator.inputs.numpy_input_fn(
    x={"features": X_test},
    y=y_test,
    batch_size=16281,
    num_epochs=1,
    shuffle=False)
estimator.evaluate(input_fn=test_input_fn, steps=1)
INFO:tensorflow:Calling model_fn.
WARNING:tensorflow:Trapezoidal rule is known to produce incorrect PR-AUCs; please switch to "careful_interpolation" instead.
WARNING:tensorflow:Trapezoidal rule is known to produce incorrect PR-AUCs; please switch to "careful_interpolation" instead.
INFO:tensorflow:Done calling model_fn.
INFO:tensorflow:Starting evaluation at 2018-07-12-15:58:22
INFO:tensorflow:Graph was finalized.
INFO:tensorflow:Restoring parameters from kernel_log/model.ckpt-1000
INFO:tensorflow:Running local_init_op.
INFO:tensorflow:Done running local_init_op.
INFO:tensorflow:Evaluation [1/1]
INFO:tensorflow:Finished evaluation at 2018-07-12-15:58:23
INFO:tensorflow:Saving dict for global step 1000: accuracy = 0.82353663, accuracy_baseline = 0.76377374, auc = 0.84898686, auc_precision_recall = 0.67214864, average_loss = 0.3877216, global_step = 1000, label/mean = 0.23622628, loss = 6312.495, precision = 0.7362797, prediction/mean = 0.21208474, recall = 0.39417577
{'accuracy': 0.82353663,
 'accuracy_baseline': 0.76377374,
 'auc': 0.84898686,
 'auc_precision_recall': 0.67214864,
 'average_loss': 0.3877216,
 'global_step': 1000,
 'label/mean': 0.23622628,
 'loss': 6312.495,
 'precision': 0.7362797,
 'prediction/mean': 0.21208474,
 'recall': 0.39417577}
Du har en nøjagtighed på 82 procent. I næste afsnit skal du forsøge at slå den logistiske klassifikator med en kerneklassifikator.
Trin 6) Konstruer Kernel-klassifikatoren
Kerneestimatoren er ikke så forskellig fra den traditionelle lineære klassifikator, i hvert fald ikke med hensyn til konstruktion. Ideen bag den er at kombinere styrken ved en eksplicit kernekortlægning.ping med den lineære klassifikator.
Du skal bruge to foruddefinerede estimatorer tilgængelige i TensorFlow for at træne Kernel Classifier:
- RandomFourierFeatureMapper
- KernelLinearClassifier
I første afsnit lærte du, at du skal transformere den lave dimension til en høj dimension ved hjælp af en kernefunktion. Mere præcist vil du bruge tilfældige Fourier-funktioner, som approksimerer den gaussiske funktion. TensorFlow 1.x leverer denne afbildning.ping som RandomFourierFeatureMapper, og modellen kan trænes ved hjælp af estimatoren KernelLinearClassifier.
For at bygge modellen skal du følge disse trin:
- Indstil kernefunktionen med høj dimension
- Indstil L2-hyperparameteren
- Byg modellen
- Træn modellen
- Vurder modellen
Trin A) Indstil den højdimensionelle kernefunktion
Det nuværende datasæt indeholder 14 funktioner, som du vil transformere til en ny 5,000-dimensionel vektor. Du bruger de tilfældige Fourier-funktioner til at opnå transformationen. Hvis du husker den gaussiske kerneformel, bemærker du, at der er en standardafvigelsesparameter, der skal defineres. Denne parameter styrer det lighedsmål, der bruges under klassificeringen: en lille stddev får kernen til at behandle kun meget tætte punkter som ens, mens en stor udjævner beslutningsgrænsen.
Du kan indstille alle parametrene i RandomFourierFeatureMapper med:
- input_dim = 14
- output_dim = 5000
- stddev = 4
### Prep Kernel
kernel_mapper = tf.contrib.kernel_methods.RandomFourierFeatureMapper(input_dim=14, output_dim=5000, stddev=4, name='rffm')
Du skal konstruere kernemapperen ved at bruge funktionskolonnerne oprettet før: feat_column
### Map Kernel
kernel_mappers = {feat_column: [kernel_mapper]}
Trin B) Indstil L2-hyperparameteren
For at forhindre overfitting, straffer du tabsfunktionen med L2-regularisatoren. Du sætter L2-hyperparameteren til 0.1 og læringsraten til 5.
optimizer = tf.train.FtrlOptimizer(learning_rate=5, l2_regularization_strength=0.1)
Trin C) Byg modellen
Det næste trin ligner den lineære klassifikation. Du bruger den indbyggede estimator KernelLinearClassifier. Bemærk, at du tilføjer den tidligere definerede kernelmapper og ændrer modelmappen.
### Prep estimator
estimator_kernel = tf.contrib.kernel_methods.KernelLinearClassifier(
    n_classes=2,
    optimizer=optimizer,
    kernel_mappers=kernel_mappers,
    model_dir="kernel_train")
Nedenstående advarsler om udfasning forventes på TensorFlow 1.x, fordi kernel_methods-modulet er bygget på de ældre tf.contrib.learn-estimatorer.
WARNING:tensorflow:From /Users/Thomas/anaconda3/envs/hello-tf/lib/python3.6/site-packages/tensorflow/contrib/kernel_methods/python/kernel_estimators.py:305: multi_class_head (from tensorflow.contrib.learn.python.learn.estimators.head) is deprecated and will be removed in a future version. Instructions for updating: Please switch to tf.contrib.estimator.*_head. WARNING:tensorflow:From /Users/Thomas/anaconda3/envs/hello-tf/lib/python3.6/site-packages/tensorflow/contrib/learn/python/learn/estimators/estimator.py:1179: BaseEstimator.__init__ (from tensorflow.contrib.learn.python.learn.estimators.estimator) is deprecated and will be removed in a future version. Instructions for updating: Please replace uses of any Estimator from tf.contrib.learn with an Estimator from tf.estimator.* WARNING:tensorflow:From /Users/Thomas/anaconda3/envs/hello-tf/lib/python3.6/site-packages/tensorflow/contrib/learn/python/learn/estimators/estimator.py:427: RunConfig.__init__ (from tensorflow.contrib.learn.python.learn.estimators.run_config) is deprecated and will be removed in a future version. Instructions for updating: When switching to tf.estimator.Estimator, use tf.estimator.RunConfig instead. INFO:tensorflow:Using default config. INFO:tensorflow:Using config: {'_task_type': None, '_task_id': 0, '_cluster_spec': <tensorflow.python.training.server_lib.ClusterSpec object at 0x1a200ae550>, '_master': '', '_num_ps_replicas': 0, '_num_worker_replicas': 0, '_environment': 'local', '_is_chief': True, '_evaluation_master': '', '_train_distribute': None, '_tf_config': gpu_options { per_process_gpu_memory_fraction: 1.0 } , '_tf_random_seed': None, '_save_summary_steps': 100, '_save_checkpoints_secs': 600, '_log_step_count_steps': 100, '_session_config': None, '_save_checkpoints_steps': None, '_keep_checkpoint_max': 5, '_keep_checkpoint_every_n_hours': 10000, '_model_dir': 'kernel_train'}
Trin D) Træn modellen
Nu hvor kerneklassificeringen er bygget, er du klar til at træne den. Du vælger at iterere modellen 2,000 gange.
### estimate
estimator_kernel.fit(input_fn=train_input_fn, steps=2000)
WARNING:tensorflow:Casting <dtype: 'int32'> labels to bool. WARNING:tensorflow:Casting <dtype: 'int32'> labels to bool. WARNING:tensorflow:Trapezoidal rule is known to produce incorrect PR-AUCs; please switch to "careful_interpolation" instead. WARNING:tensorflow:Trapezoidal rule is known to produce incorrect PR-AUCs; please switch to "careful_interpolation" instead. WARNING:tensorflow:From /Users/Thomas/anaconda3/envs/hello-tf/lib/python3.6/site-packages/tensorflow/contrib/learn/python/learn/estimators/head.py:678: ModelFnOps.__new__ (from tensorflow.contrib.learn.python.learn.estimators.model_fn) is deprecated and will be removed in a future version. Instructions for updating: When switching to tf.estimator.Estimator, use tf.estimator.EstimatorSpec. You can use the `estimator_spec` method to create an equivalent one. INFO:tensorflow:Create CheckpointSaverHook. INFO:tensorflow:Graph was finalized. INFO:tensorflow:Running local_init_op. INFO:tensorflow:Done running local_init_op. INFO:tensorflow:Saving checkpoints for 1 into kernel_train/model.ckpt. INFO:tensorflow:loss = 0.6931474, step = 1 INFO:tensorflow:global_step/sec: 86.6365 INFO:tensorflow:loss = 0.39374447, step = 101 (1.155 sec) INFO:tensorflow:global_step/sec: 80.1986 INFO:tensorflow:loss = 0.3797774, step = 201 (1.247 sec) INFO:tensorflow:global_step/sec: 79.6376 INFO:tensorflow:loss = 0.3908726, step = 301 (1.256 sec) INFO:tensorflow:global_step/sec: 95.8442 INFO:tensorflow:loss = 0.41890752, step = 401 (1.043 sec) INFO:tensorflow:global_step/sec: 93.7799 INFO:tensorflow:loss = 0.35700393, step = 501 (1.066 sec) INFO:tensorflow:global_step/sec: 94.7071 INFO:tensorflow:loss = 0.35535482, step = 601 (1.056 sec) INFO:tensorflow:global_step/sec: 90.7402 INFO:tensorflow:loss = 0.3692882, step = 701 (1.102 sec) INFO:tensorflow:global_step/sec: 94.4924 INFO:tensorflow:loss = 0.34746957, step = 801 (1.058 sec) INFO:tensorflow:global_step/sec: 95.3472 INFO:tensorflow:loss = 0.33655524, step = 901 (1.049 sec) INFO:tensorflow:global_step/sec: 97.2928 INFO:tensorflow:loss = 0.35966292, step = 1001 (1.028 sec) INFO:tensorflow:global_step/sec: 85.6761 INFO:tensorflow:loss = 0.31254214, step = 1101 (1.167 sec) INFO:tensorflow:global_step/sec: 91.4194 INFO:tensorflow:loss = 0.33247527, step = 1201 (1.094 sec) INFO:tensorflow:global_step/sec: 82.5954 INFO:tensorflow:loss = 0.29305756, step = 1301 (1.211 sec) INFO:tensorflow:global_step/sec: 89.8748 INFO:tensorflow:loss = 0.37943482, step = 1401 (1.113 sec) INFO:tensorflow:global_step/sec: 76.9761 INFO:tensorflow:loss = 0.34204718, step = 1501 (1.300 sec) INFO:tensorflow:global_step/sec: 73.7192 INFO:tensorflow:loss = 0.34614792, step = 1601 (1.356 sec) INFO:tensorflow:global_step/sec: 83.0573 INFO:tensorflow:loss = 0.38911164, step = 1701 (1.204 sec) INFO:tensorflow:global_step/sec: 71.7029 INFO:tensorflow:loss = 0.35255936, step = 1801 (1.394 sec) INFO:tensorflow:global_step/sec: 73.2663 INFO:tensorflow:loss = 0.31130585, step = 1901 (1.365 sec) INFO:tensorflow:Saving checkpoints for 2000 into kernel_train/model.ckpt. INFO:tensorflow:Loss for final step: 0.37795097. KernelLinearClassifier(params={'head': <tensorflow.contrib.learn.python.learn.estimators.head._BinaryLogisticHead object at 0x1a2054cd30>, 'feature_columns': {_RealValuedColumn(column_name='features_MAPPED', dimension=5000, default_value=None, dtype=tf.float32, normalizer=None)}, 'optimizer': <tensorflow.python.training.ftrl.FtrlOptimizer object at 0x1a200aec18>, 'kernel_mappers': {_RealValuedColumn(column_name='features', dimension=14, default_value=None, dtype=tf.float32, normalizer=None): [<tensorflow.contrib.kernel_methods.python.mappers.random_fourier_features.RandomFourierFeatureMapper object at 0x1a200ae400>]}})
Trin E) Evaluer modellen
Sidst, men ikke mindst, evaluerer du din models ydeevne. Du burde være i stand til at slå den logistiske regression.
# Evaluate and report metrics.
eval_metrics = estimator_kernel.evaluate(input_fn=test_input_fn, steps=1)
WARNING:tensorflow:Casting <dtype: 'int32'> labels to bool. WARNING:tensorflow:Casting <dtype: 'int32'> labels to bool. WARNING:tensorflow:Trapezoidal rule is known to produce incorrect PR-AUCs; please switch to "careful_interpolation" instead. WARNING:tensorflow:Trapezoidal rule is known to produce incorrect PR-AUCs; please switch to "careful_interpolation" instead. INFO:tensorflow:Starting evaluation at 2018-07-12-15:58:50 INFO:tensorflow:Graph was finalized. INFO:tensorflow:Restoring parameters from kernel_train/model.ckpt-2000 INFO:tensorflow:Running local_init_op. INFO:tensorflow:Done running local_init_op. INFO:tensorflow:Evaluation [1/1] INFO:tensorflow:Finished evaluation at 2018-07-12-15:58:51 INFO:tensorflow:Saving dict for global step 2000: accuracy = 0.83975184, accuracy/baseline_label_mean = 0.23622628, accuracy/threshold_0.500000_mean = 0.83975184, auc = 0.8904007, auc_precision_recall = 0.72722375, global_step = 2000, labels/actual_label_mean = 0.23622628, labels/prediction_mean = 0.23786618, loss = 0.34277728, precision/positive_threshold_0.500000_mean = 0.73001117, recall/positive_threshold_0.500000_mean = 0.5104004
Den endelige nøjagtighed er 84 %, cirka 1.6 procentpoint over den logistiske regressionsbasislinje (0.83975184 mod 0.82353663). Der er en afvejning mellem forbedring af nøjagtighed og beregningsomkostninger. Du skal overveje, om denne forbedring er værd at bruge tid på den tungere klassifikator, og om den har en overbevisende effekt på din virksomhed.
