
Selvstudie i lineær regression med TensorFlow [Eksempler]
 Redaktionelle team
⚡ Smart opsummering
Lineær regression i TensorFlow modellerer forholdet mellem numeriske funktioner og en kontinuerlig målværdi. Denne gennemgang træner en boligprisprædiktor i Boston på tre separate måder ved hjælp af Pandas, NumPy og native TensorFlow-inputpipelines med LinearRegressor-estimatoren.
Hvad er lineær regression?
Lineær regression er en tilgang inden for statistik til modellering af sammenhænge mellem to variabler. Denne modellering udføres mellem et skalært respons og en eller flere forklarende variabler. Sammenhængen med én forklarende variabel kaldes simpel lineær regression, og med mere end én forklarende variabel kaldes den multipel lineær regression.
TensorFlow giver værktøjer til at have fuld kontrol over beregningerne. Dette gøres med lav-niveau API. Derudover er TensorFlow udstyret med en bred vifte af API'er til at udføre mange machine learning algoritmer. Dette er API'en på højt niveau, og TensorFlow kalder dem estimatorer.
- API på lavt niveauByg arkitekturen og optimeringen af modellen fra bunden. Det er kompliceret for en nybegynder.
- API på højt niveauDefiner algoritmen. Den er brugervenlig. TensorFlow leverer en værktøjskasse kaldet estimator at konstruere, træne, evaluere og lave en forudsigelse.
I denne tutorial skal du bruge kun estimatorerBeregningerne er hurtigere og nemmere at implementere. Den første del forklarer, hvordan man bruger gradient descent optimizer til at træne en lineær regression i TensorFlow. I en anden del vil du bruge Boston-datasættet til at forudsige prisen på et hus ved hjælp af en TensorFlow estimator.
Sådan træner du en lineær regressionsmodel
Før vi begynder at træne modellen, lad os se på, hvad en lineær regression egentlig er.
Forestil dig, at du har to variabler, x og y, og din opgave er at forudsige værdien af y, når du kender værdien af x. Hvis du plotter dataene, kan du se en positiv sammenhæng mellem din uafhængige variabel, x, og din afhængige variabel, y, som punktplottet nedenfor viser.

Du kan observere, at hvis x=1, vil y omtrent være lig med 6, og hvis x=2, vil y være omkring 8.5.
Dette er ikke en særlig præcis metode og er tilbøjelig til fejl, især med et datasæt, der indeholder hundredtusindvis af punkter.
En lineær regression evalueres med en ligning. Variablen y forklares af en eller flere kovariater. I dit eksempel er der kun én afhængig variabel. Hvis du skal skrive denne ligning, vil den være:

Med:
 er biasen. Det vil sige, hvis x=0, y=
 er vægten forbundet med x
 er residualet eller modellens fejl. Det inkluderer, hvad modellen ikke kan lære af dataene
Forestil dig, at du passer til modellen, og du finder følgende løsning til:
- = 3.8
- = 2.78
Du kan erstatte disse tal i ligningen, og det bliver:
y= 3.8 + 2.78x
Du har nu en bedre måde at finde værdierne for y på. Det vil sige, at du kan erstatte x med en hvilken som helst værdi, du ønsker, for at forudsige y. I billedet nedenfor har vi erstattet x i ligningen med alle værdierne i datasættet og plottet resultatet.

Den røde linje repræsenterer den tilpassede værdi, det vil sige værdierne af y for hver værdi af x. Du behøver ikke at se værdien af x for at forudsige y; for hvert x er der en værdi, der hører til den røde linje. Du kan også forudsige værdier af x, der er højere end 2.
Hvis du vil udvide den lineære regression til flere kovariater, kan du gøre det ved at tilføje flere variabler til modellen. Forskellen mellem traditionel analyse og lineær regression er, at lineær regression ser på, hvordan y vil reagere for hver variabel x taget uafhængigt.
Lad os se på et eksempel. Forestil dig, at du vil forudsige salget i en isbutik. Datasættet indeholder forskellige oplysninger såsom vejret (regn, solskin, overskyet) og kundeoplysninger (løn, køn, civilstand).
Traditionel analyse vil forsøge at forudsige salget ved f.eks. at beregne gennemsnittet for hver variabel og forsøge at estimere salget for forskellige scenarier. Det vil føre til dårlige forudsigelser og begrænse analysen til det valgte scenarie.
Hvis du bruger lineær regression, kan du skrive denne ligning:
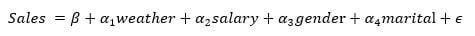
Algoritmen vil finde den bedste løsning for vægtene; det betyder, at den vil forsøge at minimere omkostningerne, hvilket er forskellen mellem den tilpassede linje og datapunkterne.
Hvordan algoritmen fungerer
Diagrammet nedenfor opsummerer den løkke, som algoritmen gentager: vælg vægte, forudsig y-værdien, mål fejlen og korriger vægtene.

Algoritmen vælger et tilfældigt tal for hver  og
 og erstatte værdien af x for at få den forudsagte værdi af y. Hvis datasættet har 100 observationer, beregner algoritmen 100 forudsagte værdier.
Vi kan beregne fejlen, bemærkede  , af modellen, hvilket er forskellen mellem den forudsagte værdi og den reelle værdi. En positiv fejl betyder, at modellen undervurderer forudsigelsen af y, og en negativ fejl betyder, at modellen overvurderer forudsigelsen af y.

Dit mål er at minimere kvadratet af fejlen. Algoritmen beregner middelværdien af kvadratfejlen. Dette trin kaldes minimering af fejlen. For lineær regression er dette Mean Square Fejl, også kaldet MSE. Matematisk er det:

Hvor:
 er vægtene, så
 refererer til den forudsagte værdi
- y er de reelle værdier
- m er antallet af observationer
 refererer til den forudsagte værdi
Bemærk, at  betyder, at den bruger transponeringen af matricerne. Det
 er den matematiske notation af middelværdien.
Målet er at finde de bedste  der minimerer MSE.
Hvis den gennemsnitlige fejl er stor, betyder det, at modellen klarer sig dårligt, og at vægtene ikke er valgt korrekt. For at rette vægtene skal du bruge en optimizer. Den traditionelle optimizer kaldes Gradient nedstigning.
Gradientnedgangen tager den afledte og mindsker eller øger vægten. Hvis den afledte er positiv, mindskes vægten. Hvis den afledte er negativ, øges vægten. Modellen opdaterer vægtene og genberegner fejlen. Denne proces gentages, indtil fejlen ikke længere ændrer sig. Hver gennemgang kaldes en iterationDerudover ganges gradienterne med en læringshastighed, som angiver læringshastigheden.
Hvis læringshastigheden er for lille, vil det tage meget lang tid for algoritmen at konvergere, fordi det kræver mange flere iterationer. Hvis læringshastigheden er for høj, vil algoritmen muligvis aldrig konvergere. Tabskurven nedenfor afbilder fejlen i forhold til iterationsantallet for dette datasæt.

Du kan se på billedet ovenfor, at modellen gentager processen omkring 20 gange, før den finder en stabil værdi for vægtene og dermed når den laveste fejl.
Bemærk, at fejlen ikke er lig med nul, men stabiliserer sig omkring 5. Det betyder, at modellen typisk laver en fejl på 5. Hvis du vil reducere fejlen, skal du tilføje mere information til modellen, f.eks. flere variabler, eller bruge forskellige estimatorer.
Du husker den første ligning:

De endelige vægte er 3.8 og 2.78. Videoen nedenfor viser dig, hvordan gradientdescens optimerer tabsfunktionen for at finde disse vægte.
Sådan træner du en lineær regression med TensorFlow
Nu hvor du har en bedre forståelse af, hvad der sker bag emhætten, er du klar til at bruge estimator-API'en fra TensorFlow til at træne din første lineære regression ved hjælp af TensorFlow.
Versionsnotat: Estimatorarbejdsgangen vist nedenfor blev skrevet mod TensorFlow 1.x og de tidlige 2.x-udgivelser. TensorFlow markerede tf.estimator og tf.feature_column API'er er fuldt ud forældede i version 2.12 og Estimatorer er fjernet i version 2.16. Kør denne kode i en TensorFlow 1.15 eller 2.x-with- på en nuværende installation.tf.compat.v1 miljø, eller transporter det til Keras, hvor tf.keras.layers.Dense(1) plus forbehandlingslag erstatter LinearRegressor og featurekolonnerne. Koncepterne - features, labels, batches, epochs, MSE og gradient descent - fortsætter uændret.
Du skal bruge Boston-datasættet, som indeholder følgende variabler.
| Variabel | Beskrivelse |
| kriminel | kriminalitet pr. indbygger efter by |
| zn | andel af boligarealer udlagt til grunde over 25,000 sq.ft. |
| indu | andel af ikke-detailvirksomheder pr. by. |
| nox | koncentration af nitrogenoxider |
| rm | gennemsnitligt antal værelser pr. bolig |
| alder | andel af ejerlejligheder bygget før 1940 |
| dis | vægtede afstande til fem Boston beskæftigelsescentre |
| skat | ejendomsskattesats for fuld værdi pr. dollars 10,000 |
| ptratio | elev-lærer forhold efter by |
| medv | Medianværdien af ejerboliger i tusinde dollars |
Du vil oprette tre forskellige datasæt:
| datasæt | objektiv | forme |
| Kurser | Træn modellen og få vægtene | 400, 10 |
| Evaluering | Evaluer modellens ydeevne på usete data | 100, 10 |
| Forudsige | Brug modellen til at forudsige husværdi på nye data | 6, 10 |
Formålet er at bruge datasættets funktioner til at forudsige husets værdi.
I anden del af vejledningen lærer du, hvordan du bruger TensorFlow med tre forskellige måder at importere data på:
- Med pandaer
- Med nusset
- Kun TensorFlow
Bemærk at alle tre muligheder giver de samme resultater.
Du lærer, hvordan du bruger high-level API'en til at bygge, træne og evaluere en TensorFlow lineær regressionsmodel. Hvis du brugte low-level API'en, skulle du manuelt definere:
- Tabsfunktion
- Optimer: gradientnedgang
- Matrix multiplikation
- Graf og tensor
Dette er kedeligt og mere kompliceret for en nybegynder.
Pandas-løsning
Du skal importere de nødvendige biblioteker for at træne modellen.
import pandas as pd
from sklearn import datasets
import tensorflow as tf
import itertools
Trin 1) Importer data med pandas.
Du definerer kolonnenavnene og gemmer dem i KOLONNER. Du kan bruge pd.read_csv() til at importere dataene.
COLUMNS = ["crim", "zn", "indus", "nox", "rm", "age",
           "dis", "tax", "ptratio", "medv"]
Ret hvert opkald mod de CSV-filer, du downloadede tidligere.
training_set = pd.read_csv("E:/boston_train.csv", skipinitialspace=True,skiprows=1, names=COLUMNS)
test_set = pd.read_csv("E:/boston_test.csv", skipinitialspace=True,skiprows=1, names=COLUMNS)
prediction_set = pd.read_csv("E:/boston_predict.csv", skipinitialspace=True,skiprows=1, names=COLUMNS)
Du kan udskrive formen på dataene.
print(training_set.shape, test_set.shape, prediction_set.shape)
Produktion
(400, 10) (100, 10) (6, 10)
Bemærk, at etiketten, det vil sige dit y, er inkluderet i datasættet. Så du skal definere to andre lister: en, der kun indeholder funktionerne, og en, der kun indeholder navnet på etiketten. Disse to lister vil fortælle din estimator, hvilke funktioner i datasættet er, og hvilket kolonnenavn der er etiketten.
Det gøres med nedenstående kode.
FEATURES = ["crim", "zn", "indus", "nox", "rm",
                 "age", "dis", "tax", "ptratio"]
LABEL = "medv"
Trin 2) Konverter dataene
Du skal konvertere de numeriske variabler til det korrekte format. TensorFlow tilbyder en metode til at konvertere en kontinuerlig variabel: tf.feature_column.numeric_column().
I det forrige trin definerede du en liste over funktioner, du vil inkludere i modellen. Nu kan du bruge denne liste til at konvertere dem til numeriske data. Hvis du vil udelukke funktioner fra din model, er du velkommen til at fjerne en eller flere variabler fra listen FEATURES, før du konstruerer feature_cols.
Bemærk at du vil bruge en Python Listeforståelse med listen FEATURES for at oprette en ny liste med navnet feature_cols. Det hjælper dig med at undgå at skrive tf.feature_column.numeric_column() ni gange. Listeforståelse er en hurtigere og mere overskuelig måde at oprette nye lister på.
feature_cols = [tf.feature_column.numeric_column(k) for k in FEATURES]
Trin 3) Definer estimatoren
I dette trin skal du definere estimatoren. TensorFlow leverer seks præbyggede standardestimatorer, tre til klassifikationsopgaver og tre til TensorFlow-regressionsopgaver:
- Regressor
- DNNRegressor
- LineærRegressor
- DNNLineær Kombineret Regressor
- Classifier
- DNNklassificering
- LinearClassifier
- DNNLineær Kombineret Klassifikator
I denne øvelse skal du bruge den lineære regressor. For at få adgang til denne funktion skal du bruge tf.estimator.
Funktionen har brug for to argumenter:
- feature_columns: indeholder de variabler, der skal inkluderes i modellen
- model_dir: sti til at gemme grafen, gemme modelparametrene osv.
TensorFlow opretter automatisk en mappe med navnet train i din arbejdsmappe. Du skal bruge denne sti for at få adgang. TensorBoard, som vist i TensorFlow-regressionseksemplet nedenfor.
estimator = tf.estimator.LinearRegressor(
        feature_columns=feature_cols,
        model_dir="train")
Produktion
INFO:tensorflow:Using default config.
INFO:tensorflow:Using config: {'_model_dir': 'train', '_tf_random_seed': None, '_save_summary_steps': 100, '_save_checkpoints_steps': None, '_save_checkpoints_secs': 600, '_session_config': None, '_keep_checkpoint_max': 5, '_keep_checkpoint_every_n_hours': 10000, '_log_step_count_steps': 100, '_train_distribute': None, '_service': None, '_cluster_spec': <tensorflow.python.training.server_lib.ClusterSpec object at 0x1a215dc550>, '_task_type': 'worker', '_task_id': 0, '_global_id_in_cluster': 0, '_master': '', '_evaluation_master': '', '_is_chief': True, '_num_ps_replicas': 0, '_num_worker_replicas': 1}
Den vanskelige del med TensorFlow er måden at fodre modellen på. TensorFlow er designet til at fungere med parallel beregning og meget store datasæt. På grund af begrænsninger i maskinressourcerne er det umuligt at fodre modellen med alle dataene på én gang. Til det formål skal du fodre en batch data hver gang. Bemærk, at vi taler om enorme datasæt med millioner eller flere poster. Hvis du ikke tilføjer en batch, ender du med en hukommelsesfejl.
For eksempel, hvis dine data indeholder 100 observationer, og du definerer en batchstørrelse på 10, betyder det, at modellen vil se 10 observationer for hver iteration (10*10).
Når modellen har set alle dataene, afslutter den én epoch. En epoch definerer, hvor mange gange du ønsker, at modellen skal se dataene. Det er bedre at indstille dette trin til ingen og lade modellen udføre et bestemt antal iterationer.
En anden information, der skal tilføjes, er, om du vil blande dataene før hver iteration. Under træningen er det vigtigt at blande dataene, så modellen ikke lærer et specifikt mønster i datasættet. Hvis modellen lærer detaljerne i det underliggende mønster i dataene, vil den have svært ved at generalisere forudsigelsen for usete data. Dette kaldes overfitting. Modellen klarer sig godt på træningsdataene, men kan ikke forudsige korrekt for usete data.
TensorFlow gør disse to trin nemme at udføre. Når dataene går til pipelinen, ved den, hvor mange observationer den har brug for (batch), og om den skal blande dataene.
For at instruere TensorFlow i, hvordan modellen skal fodres, kan du bruge pandas_input_fn. Dette objekt skal bruge fem parametre:
- x: funktionsdata
- y: etiketdata
- batch_size: batch. Som standard 128
- num_epoch: antal epoker, som standard 1
- bland: bland dataene eller ej. Som standard er ingen
Du skal give modellen flere referencer, så du definerer en funktion til at gentage denne proces. Kald denne funktion get_input_fn.
def get_input_fn(data_set, num_epochs=None, n_batch = 128, shuffle=True):
         return tf.estimator.inputs.pandas_input_fn(
         x=pd.DataFrame({k: data_set[k].values for k in FEATURES}),
         y = pd.Series(data_set[LABEL].values),
         batch_size=n_batch,
         num_epochs=num_epochs,
         shuffle=shuffle)
Den sædvanlige metode til at evaluere en models ydeevne er at:
- Træn modellen
- Evaluer modellen på et andet datasæt
- Lav en forudsigelse
TensorFlow-estimatoren tilbyder tre forskellige funktioner til nemt at udføre disse tre trin.
Trin 4) Træn modellen
Du kan bruge estimator-train-metoden til at tilpasse modellen. Trainestimateren skal bruge en input_fn og et antal trin. Du kan bruge den funktion, du oprettede ovenfor, til at fodre modellen. Derefter instruerer du modellen til at iterere 1000 gange. Bemærk, at du ikke angiver antallet af epoker; du lader modellen iterere 1000 gange. Hvis du sætter antallet af epoker til 1, vil modellen iterere fire gange, fordi der er 400 poster i træningssættet, og batchstørrelsen er 128:
- 128 rækker
- 128 rækker
- 128 rækker
- 16 rækker
Derfor er det nemmere at indstille antallet af epoker til ingen og definere antallet af iterationer, som vist i TensorFlow-klassifikationseksemplet nedenfor.
estimator.train(input_fn=get_input_fn(training_set,
                                           num_epochs=None,
                                           n_batch = 128,
                                           shuffle=False),
                                           steps=1000)
Produktion
INFO:tensorflow:Calling model_fn.
INFO:tensorflow:Done calling model_fn.
INFO:tensorflow:Create CheckpointSaverHook.
INFO:tensorflow:Graph was finalized.
INFO:tensorflow:Running local_init_op.
INFO:tensorflow:Done running local_init_op.
INFO:tensorflow:Saving checkpoints for 1 into train/model.ckpt.
INFO:tensorflow:loss = 83729.64, step = 1
INFO:tensorflow:global_step/sec: 238.616
INFO:tensorflow:loss = 13909.657, step = 101 (0.420 sec)
INFO:tensorflow:global_step/sec: 314.293
INFO:tensorflow:loss = 12881.449, step = 201 (0.320 sec)
INFO:tensorflow:global_step/sec: 303.863
INFO:tensorflow:loss = 12391.541, step = 301 (0.327 sec)
INFO:tensorflow:global_step/sec: 308.782
INFO:tensorflow:loss = 12050.5625, step = 401 (0.326 sec)
INFO:tensorflow:global_step/sec: 244.969
INFO:tensorflow:loss = 11766.134, step = 501 (0.407 sec)
INFO:tensorflow:global_step/sec: 155.966
INFO:tensorflow:loss = 11509.922, step = 601 (0.641 sec)
INFO:tensorflow:global_step/sec: 263.256
INFO:tensorflow:loss = 11272.889, step = 701 (0.379 sec)
INFO:tensorflow:global_step/sec: 254.112
INFO:tensorflow:loss = 11051.9795, step = 801 (0.396 sec)
INFO:tensorflow:global_step/sec: 292.405
INFO:tensorflow:loss = 10845.855, step = 901 (0.341 sec)
INFO:tensorflow:Saving checkpoints for 1000 into train/model.ckpt.
INFO:tensorflow:Loss for final step: 5925.9873.
Du kan tjekke TensorBoard med følgende kommando:
activate hello-tf
# For MacOS
tensorboard --logdir=./train
# For Windows
tensorboard --logdir=train
Trin 5) Vurder din model
Du kan evaluere pasformen af din model på testsættet med koden nedenfor:
ev = estimator.evaluate(
          input_fn=get_input_fn(test_set,
          num_epochs=1,
          n_batch = 128,
          shuffle=False))
Produktion
INFO:tensorflow:Calling model_fn.
INFO:tensorflow:Done calling model_fn.
INFO:tensorflow:Starting evaluation at 2018-05-13-01:43:13
INFO:tensorflow:Graph was finalized.
INFO:tensorflow:Restoring parameters from train/model.ckpt-1000
INFO:tensorflow:Running local_init_op.
INFO:tensorflow:Done running local_init_op.
INFO:tensorflow:Finished evaluation at 2018-05-13-01:43:13
INFO:tensorflow:Saving dict for global step 1000: average_loss = 32.15896, global_step = 1000, loss = 3215.896
Du kan udskrive tabet med koden nedenfor:
loss_score = ev["loss"]
print("Loss: {0:f}".format(loss_score))
Produktion
Loss: 3215.895996
Modellen har et tab på 3215. Du kan tjekke den overordnede statistik for at få en idé om, hvor stor fejlen er.
training_set['medv'].describe()
Produktion
count    400.000000
mean      22.625500
std        9.572593
min        5.000000
25%       16.600000
50%       21.400000
75%       25.025000
max       50.000000
Name: medv, dtype: float64
Ud fra ovenstående opsummerende statistik ved du, at den gennemsnitlige pris for et hus er 22 tusind, med en minimumspris på 5 tusind og et maksimum på 50 tusind. Da det rapporterede tab er den gennemsnitlige kvadratiske fejl, er den typiske fejl i de oprindelige enheder omtrent kvadratroden af 32.16, hvilket er omkring 5.7 tusind dollars.
Trin 6) Lav forudsigelsen
Endelig kan du bruge estimatoren TensorFlows forudsigelsesmetoden til at estimere værdien af seks huse i Boston.
y = estimator.predict(
         input_fn=get_input_fn(prediction_set,
         num_epochs=1,
         n_batch = 128,
         shuffle=False))
For at udskrive de estimerede værdier kan du bruge denne kode:
predictions = list(p["predictions"] for p in itertools.islice(y, 6))
print("Predictions: {}".format(str(predictions)))
Produktion
INFO:tensorflow:Calling model_fn.
INFO:tensorflow:Done calling model_fn.
INFO:tensorflow:Graph was finalized.
INFO:tensorflow:Restoring parameters from train/model.ckpt-1000
INFO:tensorflow:Running local_init_op.
INFO:tensorflow:Done running local_init_op.
Predictions: [array([32.297546], dtype=float32), array([18.96125], dtype=float32), array([27.270979], dtype=float32), array([29.299236], dtype=float32), array([16.436684], dtype=float32), array([21.460876], dtype=float32)]
Modellen forudsiger følgende værdier:
| hus | Forudsigelse |
| 1 | 32.29 |
| 2 | 18.96 |
| 3 | 27.27 |
| 4 | 29.29 |
| 5 | 16.43 |
| 6 | 21.46 |
Bemærk, at vi ikke kender den sande værdi af disse seks huse. I den dybe læringsvejledning vil du forsøge at overvinde den lineære model.
NumPy-løsning
Dette afsnit forklarer, hvordan man træner modellen ved hjælp af en NumPy-estimator til at indlæse dataene. Metoden er den samme, bortset fra at du bruger numpy_input_fn-estimatoren.
Læs de samme tre CSV-filer, men behold kun de rå NumPy-arrays med .values.
training_set_n = pd.read_csv("E:/boston_train.csv").values
test_set_n = pd.read_csv("E:/boston_test.csv").values
prediction_set_n = pd.read_csv("E:/boston_predict.csv").values
Trin 1) Importer dataene
Først og fremmest skal du skelne mellem funktionsvariablerne og etiketten. Du skal gøre dette for træningsdataene og evalueringsdataene. Det er hurtigere at definere en funktion til at opdele dataene.
def prepare_data(df):
        X_train = df[:, :-3]
        y_train = df[:,-3]
        return X_train, y_train
Du kan bruge funktionen til at opdele etiketten fra togets funktioner og evaluere datasæt.
X_train, y_train = prepare_data(training_set_n)
X_test, y_test = prepare_data(test_set_n)
Du skal udelade den sidste kolonne i forudsigelsesdatasættet, fordi den kun indeholder NaN.
x_predict = prediction_set_n[:, :-2]
Bekræft formen på arrayet. Bemærk at etiketten ikke skal have en anden dimension, hvilket betyder (400,).
print(X_train.shape, y_train.shape, x_predict.shape)
Produktion
(400, 9) (400,) (6, 9)
Du kan konstruere funktionskolonnerne som følger:
feature_columns = [ tf.feature_column.numeric_column('x', shape=X_train.shape[1:])]
Estimatoren er defineret som før: du angiver funktionskolonnerne og hvor grafen skal gemmes.
estimator = tf.estimator.LinearRegressor(
         feature_columns=feature_columns,
         model_dir="train1")
Produktion
INFO:tensorflow:Using default config.
INFO:tensorflow:Using config: {'_model_dir': 'train1', '_tf_random_seed': None, '_save_summary_steps': 100, '_save_checkpoints_steps': None, '_save_checkpoints_secs': 600, '_session_config': None, '_keep_checkpoint_max': 5, '_keep_checkpoint_every_n_hours': 10000, '_log_step_count_steps': 100, '_train_distribute': None, '_service': None, '_cluster_spec': <tensorflow.python.training.server_lib.ClusterSpec object at 0x1a218d8f28>, '_task_type': 'worker', '_task_id': 0, '_global_id_in_cluster': 0, '_master': '', '_evaluation_master': '', '_is_chief': True, '_num_ps_replicas': 0, '_num_worker_replicas': 1}
Du kan bruge NumPy-estimatoren til at føre dataene til modellen og derefter træne modellen. Bemærk, at vi definerer input_fn-funktionen på forhånd for at lette læsbarheden.
# Train the estimator
train_input = tf.estimator.inputs.numpy_input_fn(
           x={"x": X_train},
           y=y_train,
           batch_size=128,
           shuffle=False,
           num_epochs=None)
estimator.train(input_fn = train_input,steps=5000)
Produktion
INFO:tensorflow:Calling model_fn.
INFO:tensorflow:Done calling model_fn.
INFO:tensorflow:Create CheckpointSaverHook.
INFO:tensorflow:Graph was finalized.
INFO:tensorflow:Running local_init_op.
INFO:tensorflow:Done running local_init_op.
INFO:tensorflow:Saving checkpoints for 1 into train1/model.ckpt.
INFO:tensorflow:loss = 83729.64, step = 1
INFO:tensorflow:global_step/sec: 490.057
INFO:tensorflow:loss = 13909.656, step = 101 (0.206 sec)
INFO:tensorflow:global_step/sec: 788.986
INFO:tensorflow:loss = 12881.45, step = 201 (0.126 sec)
INFO:tensorflow:global_step/sec: 736.339
INFO:tensorflow:loss = 12391.541, step = 301 (0.136 sec)
INFO:tensorflow:global_step/sec: 383.305
INFO:tensorflow:loss = 12050.561, step = 401 (0.260 sec)
INFO:tensorflow:global_step/sec: 859.832
INFO:tensorflow:loss = 11766.133, step = 501 (0.117 sec)
INFO:tensorflow:global_step/sec: 804.394
INFO:tensorflow:loss = 11509.918, step = 601 (0.125 sec)
INFO:tensorflow:global_step/sec: 753.059
INFO:tensorflow:loss = 11272.891, step = 701 (0.134 sec)
INFO:tensorflow:global_step/sec: 402.165
INFO:tensorflow:loss = 11051.979, step = 801 (0.248 sec)
INFO:tensorflow:global_step/sec: 344.022
INFO:tensorflow:loss = 10845.854, step = 901 (0.288 sec)
INFO:tensorflow:Saving checkpoints for 1000 into train1/model.ckpt.
INFO:tensorflow:Loss for final step: 5925.985.
Out[23]:
<tensorflow.python.estimator.canned.linear.LinearRegressor at 0x1a1b6ea860>
Du replikerer det samme trin med en anden inputfunktion for at evaluere din model.
eval_input = tf.estimator.inputs.numpy_input_fn(
       x={"x": X_test},
       y=y_test,
       shuffle=False,
       batch_size=128,
       num_epochs=1)
   estimator.evaluate(eval_input,steps=None)
Produktion
INFO:tensorflow:Calling model_fn.
INFO:tensorflow:Done calling model_fn.
INFO:tensorflow:Starting evaluation at 2018-05-13-01:44:00
INFO:tensorflow:Graph was finalized.
INFO:tensorflow:Restoring parameters from train1/model.ckpt-1000
INFO:tensorflow:Running local_init_op.
INFO:tensorflow:Done running local_init_op.
INFO:tensorflow:Finished evaluation at 2018-05-13-01:44:00
INFO:tensorflow:Saving dict for global step 1000: average_loss = 32.158947, global_step = 1000, loss = 3215.8945
Out[24]:
{'average_loss': 32.158947, 'global_step': 1000, 'loss': 3215.8945}
Endelig kan du beregne forudsigelsen. Den burde ligne Pandas' resultat.
test_input = tf.estimator.inputs.numpy_input_fn(
        x={"x": x_predict},
        batch_size=128,
        num_epochs=1,
        shuffle=False)
        y = estimator.predict(test_input)

predictions = list(p["predictions"] for p in itertools.islice(y, 6))
print("Predictions: {}".format(str(predictions)))
Produktion
INFO:tensorflow:Calling model_fn.
INFO:tensorflow:Done calling model_fn.
INFO:tensorflow:Graph was finalized.
INFO:tensorflow:Restoring parameters from train1/model.ckpt-1000
INFO:tensorflow:Running local_init_op.
INFO:tensorflow:Done running local_init_op.
Predictions: [array([32.297546], dtype=float32), array([18.961248], dtype=float32), array([27.270979], dtype=float32), array([29.299242], dtype=float32), array([16.43668], dtype=float32), array([21.460878], dtype=float32)]
TensorFlow-løsning
Det sidste afsnit er dedikeret til en ren TensorFlow løsning. Denne metode er lidt mere kompliceret end de to andre.
Bemærk at hvis du bruger en Jupyter notesbog, skal du genstarte og rydde kernen for at køre denne session.
TensorFlow har bygget et fremragende værktøj til at sende data ind i pipelinen. I dette afsnit skal du selv bygge input_fn-funktionen.
Trin 1) Definer stien og formatet for dataene
Først og fremmest deklarerer du to variabler med stien til CSV-filerne. Bemærk, at du har to filer, en til træningssættet og en til testsættet.
import tensorflow as tf
df_train = "E:/boston_train.csv"
df_eval = "E:/boston_test.csv"
Derefter skal du definere de kolonner, du vil bruge, fra CSV-filen. Vi bruger dem alle. Derefter skal du deklarere typen for hver variabel.
Flydende variabler er defineret af [0.]
COLUMNS = ["crim", "zn", "indus", "nox", "rm", "age",
                "dis", "tax", "ptratio", "medv"]
RECORDS_ALL = [[0.0], [0.0], [0.0], [0.0],[0.0],[0.0],[0.0],[0.0],[0.0],[0.0]]
Trin 2) Definer funktionen input_fn
Funktionen kan opdeles i tre dele:
- Importer dataene
- Opret iteratoren
- Forbrug dataene
Nedenfor er den overordnede kode til at definere funktionen. Koden vil blive forklaret senere.
def input_fn(data_file, batch_size, num_epoch = None):
       # Step 1
          def parse_csv(value):
          columns = tf.decode_csv(value, record_defaults= RECORDS_ALL)
          features = dict(zip(COLUMNS, columns))
          #labels = features.pop('median_house_value')
          labels =  features.pop('medv')
          return features, labels

          # Extract lines from input files using the Dataset API.
          dataset = (tf.data.TextLineDataset(data_file) # Read text file
          .skip(1) # Skip header row
          .map(parse_csv))

          dataset = dataset.repeat(num_epoch)
          dataset = dataset.batch(batch_size)
          # Step 3
          iterator = dataset.make_one_shot_iterator()
          features, labels = iterator.get_next()
          return features, labels
Importer dataene
For en CSV-fil læser datasætmetoden én linje ad gangen. For at opbygge datasættet skal du bruge objektet TextLineDatasæt. Dit datasæt har en header, så du skal bruge skip(1) til at springe den første linje over. På dette tidspunkt læser du kun dataene og udelader headeren i pipelinen. For at indlæse modellen skal du adskille funktionerne fra etiketten. Metoden, der bruges til at anvende enhver transformation på dataene, er map.
Denne metode kalder en funktion, som du skal oprette for at instruere i, hvordan dataene skal transformeres. Kort sagt skal du sende dataene til TextLineDatasæt-objekt, udelad headeren, og anvend en transformation, der er instrueret af en funktion.
Code forklaring
- tf.data.TextLineDataset(data_file): denne linje læser CSV-filen
- .skip(1): springer overskriften over
- .map(parse_csv)): analyserer posterne i tensorerne
Du skal definere en funktion til at instruere kortobjektet. Du kan kalde denne funktion parse_csv.
Denne funktion parser CSV-filen med metoden tf.decode_csv og deklarerer funktionerne og etiketten. Funktionerne kan deklareres som en ordbog eller en tuple. Du bruger ordbogsmetoden, fordi den er mere praktisk.
Code forklaring
- tf.decode_csv(værdi, record_defaults= RECORDS_ALL): metoden decode_csv bruger output fra TextLineDatasæt til at læse CSV-filen. record_defaults instruerer TensorFlow om kolonnetyperne. I TensorFlow 2.x findes dette symbol på tf.io.decode_csv.
- dict(zip(COLUMNS, columns)): udfylder ordbogen med alle kolonnerne f.eks.tracunder denne databehandling
- features.pop('medv'): udelukker målvariablen fra funktionsvariablerne og opretter en labelvariabel
Datasættet har brug for yderligere elementer for iterativt at kunne fodre tensorerne. Du skal tilføje metoden "repeat" for at tillade datasættet at fortsætte på ubestemt tid med at fodre modellen. Hvis du ikke tilføjer metoden, vil modellen kun iterere én gang og derefter give en fejl, fordi der ikke føres flere data ind i pipelinen.
Derefter kan du styre batchstørrelsen med batchmetoden. Det betyder, at du fortæller datasættet, hvor meget data du vil sende ind i pipelinen for hver iteration. Hvis du angiver en stor batchstørrelse, vil modellen være langsom.
Trin 3) Opret iteratoren
Nu er du klar til det andet trin: Opret en iterator for at returnere elementerne i datasættet.
Den enkleste måde at oprette en operator på er med metoden make_one_shot_iterator.
Derefter kan du oprette funktionerne og etiketterne fra iteratoren.
Trin 4) Forbrug dataene
Du kan tjekke, hvad der sker med funktionen input_fn. Du skal kalde funktionen i en session for at forbruge dataene. Du prøver med en batchstørrelse lig med 1.
Bemærk at den udskriver funktionerne i en ordbog og labelen som et array.
Den viser den første linje i CSV-filen. Du kan prøve at køre denne kode mange gange med forskellige batchstørrelser.
next_batch = input_fn(df_train, batch_size = 1, num_epoch = None)
with tf.Session() as sess:
     first_batch  = sess.run(next_batch)
     print(first_batch)
Produktion
({'crim': array([2.3004], dtype=float32), 'zn': array([0.], dtype=float32), 'indus': array([19.58], dtype=float32), 'nox': array([0.605], dtype=float32), 'rm': array([6.319], dtype=float32), 'age': array([96.1], dtype=float32), 'dis': array([2.1], dtype=float32), 'tax': array([403.], dtype=float32), 'ptratio': array([14.7], dtype=float32)}, array([23.8], dtype=float32))
Trin 5) Definer funktionskolonnen
Du skal definere de numeriske kolonner som følger:
X1= tf.feature_column.numeric_column('crim')
X2= tf.feature_column.numeric_column('zn')
X3= tf.feature_column.numeric_column('indus')
X4= tf.feature_column.numeric_column('nox')
X5= tf.feature_column.numeric_column('rm')
X6= tf.feature_column.numeric_column('age')
X7= tf.feature_column.numeric_column('dis')
X8= tf.feature_column.numeric_column('tax')
X9= tf.feature_column.numeric_column('ptratio')
Bemærk at du skal kombinere alle variablerne i en bucket.
base_columns = [X1, X2, X3,X4, X5, X6,X7, X8, X9]
Trin 6) Byg modellen
Du kan træne modellen med estimatoren LinearRegressor.
model = tf.estimator.LinearRegressor(feature_columns=base_columns, model_dir='train3')
Produktion
INFO:tensorflow:Using default config. INFO:tensorflow:Using config: {'_model_dir': 'train3', '_tf_random_seed': None, '_save_summary_steps': 100, '_save_checkpoints_steps': None, '_save_checkpoints_secs': 600, '_session_config': None, '_keep_checkpoint_max': 5, '_keep_checkpoint_every_n_hours': 10000, '_log_step_count_steps': 100, '_train_distribute': None, '_service': None, '_cluster_spec': <tensorflow.python.training.server_lib.ClusterSpec object at 0x1820a010f0>, '_task_type': 'worker', '_task_id': 0, '_global_id_in_cluster': 0, '_master': '', '_evaluation_master': '', '_is_chief': True, '_num_ps_replicas': 0, '_num_worker_replicas': 1}
Du skal bruge en lambda funktion for at give dig mulighed for at skrive argumenterne for funktionen input_fn. Hvis du ikke bruger en lambda-funktion, kan du ikke træne modellen.
# Train the estimator
model.train(steps =1000,
          input_fn= lambda : input_fn(df_train,batch_size=128, num_epoch = None))
Produktion
INFO:tensorflow:Calling model_fn.
INFO:tensorflow:Done calling model_fn.
INFO:tensorflow:Create CheckpointSaverHook.
INFO:tensorflow:Graph was finalized.
INFO:tensorflow:Running local_init_op.
INFO:tensorflow:Done running local_init_op.
INFO:tensorflow:Saving checkpoints for 1 into train3/model.ckpt.
INFO:tensorflow:loss = 83729.64, step = 1
INFO:tensorflow:global_step/sec: 72.5646
INFO:tensorflow:loss = 13909.657, step = 101 (1.380 sec)
INFO:tensorflow:global_step/sec: 101.355
INFO:tensorflow:loss = 12881.449, step = 201 (0.986 sec)
INFO:tensorflow:global_step/sec: 109.293
INFO:tensorflow:loss = 12391.541, step = 301 (0.915 sec)
INFO:tensorflow:global_step/sec: 102.235
INFO:tensorflow:loss = 12050.5625, step = 401 (0.978 sec)
INFO:tensorflow:global_step/sec: 104.656
INFO:tensorflow:loss = 11766.134, step = 501 (0.956 sec)
INFO:tensorflow:global_step/sec: 106.697
INFO:tensorflow:loss = 11509.922, step = 601 (0.938 sec)
INFO:tensorflow:global_step/sec: 118.454
INFO:tensorflow:loss = 11272.889, step = 701 (0.844 sec)
INFO:tensorflow:global_step/sec: 114.947
INFO:tensorflow:loss = 11051.9795, step = 801 (0.870 sec)
INFO:tensorflow:global_step/sec: 111.484
INFO:tensorflow:loss = 10845.855, step = 901 (0.897 sec)
INFO:tensorflow:Saving checkpoints for 1000 into train3/model.ckpt.
INFO:tensorflow:Loss for final step: 5925.9873.
Out[8]:
<tensorflow.python.estimator.canned.linear.LinearRegressor at 0x18225eb8d0>
Du kan evaluere pasformen af din model på testsættet med koden nedenfor:
results = model.evaluate(steps =None,input_fn=lambda: input_fn(df_eval, batch_size =128, num_epoch = 1))
for key in results:
print("   {}, was: {}".format(key, results[key]))
Produktion
INFO:tensorflow:Calling model_fn.
INFO:tensorflow:Done calling model_fn.
INFO:tensorflow:Starting evaluation at 2018-05-13-02:06:02
INFO:tensorflow:Graph was finalized.
INFO:tensorflow:Restoring parameters from train3/model.ckpt-1000
INFO:tensorflow:Running local_init_op.
INFO:tensorflow:Done running local_init_op.
INFO:tensorflow:Finished evaluation at 2018-05-13-02:06:02
INFO:tensorflow:Saving dict for global step 1000: average_loss = 32.15896, global_step = 1000, loss = 3215.896
   average_loss, was: 32.158958435058594
   loss, was: 3215.89599609375
   global_step, was: 1000
Det sidste trin er at forudsige værdien af målet baseret på værdien af funktionsmatricen. Du kan skrive en ordbog med de værdier, du vil forudsige. Din model har ni funktioner, så du skal angive en værdi for hver af dem. Modellen vil give en forudsigelse for hver af dem.
I koden nedenfor skriver du værdierne for hver funktion, der er indeholdt i df_predict CSV-filen.
Du skal skrive en ny input_fn-funktion, fordi der ikke er nogen label i datasættet. Du kan bruge from_tensors API'en fra Dataset-objektet.
prediction_input = {
          'crim': [0.03359,5.09017,0.12650,0.05515,8.15174,0.24522],
          'zn': [75.0,0.0,25.0,33.0,0.0,0.0],
          'indus': [2.95,18.10,5.13,2.18,18.10,9.90],
          'nox': [0.428,0.713,0.453,0.472,0.700,0.544],
          'rm': [7.024,6.297,6.762,7.236,5.390,5.782],
          'age': [15.8,91.8,43.4,41.1,98.9,71.7],
          'dis': [5.4011,2.3682,7.9809,4.0220,1.7281,4.0317],
          'tax': [252,666,284,222,666,304],
          'ptratio': [18.3,20.2,19.7,18.4,20.2,18.4]
     }
     def test_input_fn():
     dataset = tf.data.Dataset.from_tensors(prediction_input)
     return dataset

     # Predict all our prediction_input
     pred_results = model.predict(input_fn=test_input_fn)
Til sidst udskriver du forudsigelserne.
for pred in enumerate(pred_results):
print(pred)
Produktion
INFO:tensorflow:Calling model_fn.
INFO:tensorflow:Done calling model_fn.
INFO:tensorflow:Graph was finalized.
INFO:tensorflow:Restoring parameters from train3/model.ckpt-1000
INFO:tensorflow:Running local_init_op.
INFO:tensorflow:Done running local_init_op.
(0, {'predictions': array([32.297546], dtype=float32)})
(1, {'predictions': array([18.96125], dtype=float32)})
(2, {'predictions': array([27.270979], dtype=float32)})
(3, {'predictions': array([29.299236], dtype=float32)})
(4, {'predictions': array([16.436684], dtype=float32)})
(5, {'predictions': array([21.460876], dtype=float32)})

INFO:tensorflow:Calling model_fn. INFO:tensorflow:Done calling model_fn. INFO:tensorflow:Graph was finalized. INFO:tensorflow:Restoring parameters from train3/model.ckpt-5000 INFO:tensorflow:Running local_init_op. INFO:tensorflow:Done running local_init_op. (0, {'predictions': array([35.60663], dtype=float32)}) (1, {'predictions': array([22.298521], dtype=float32)}) (2, {'predictions': array([25.74533], dtype=float32)}) (3, {'predictions': array([35.126694], dtype=float32)}) (4, {'predictions': array([17.94416], dtype=float32)}) (5, {'predictions': array([22.606628], dtype=float32)})
Alle tre pipelines returnerer de samme seks forudsigelser, hvilket bekræfter, at valget mellem Pandas, NumPy og et native TensorFlow-datasæt er et spørgsmål om bekvemmelighed, ikke om nøjagtighed.
