
Sådan uploader du en flad fil til SAP HANA: CSV, XLS og XLSX
 Redaktionelle team
⚡ Smart opsummering
Upload af flad fil til SAP HANA indlæser CSV-, XLS- og XLSX-data direkte fra en klientmaskine uden et ETL-værktøj. HANA Studio foreslår kolonnenavne og datatyper og knytter derefter kildekolonner til en ny eller eksisterende tabel.
SAP HANA understøtter upload af data fra en fil uden ETL-værktøjer (SLT, BODS og DXC). Det er en ny funktion i HANA Studio Revsion 28 (SPS04).
SAP HANA Support følgende filtype, som vil være tilgængelige på klientsystemet som nedenfor –
- .CSV (kommaseparerede værdifiler)
- . XLS
- .XLSX
Forud for denne mulighed skal brugeren oprette kontrolfil (.CTL-fil). For at uploade data ind SAP HANA, bord skal eksistere i SAP HANA. Hvis der findes en tabel, tilføjes poster i slutningen af tabellen. Hvis der ikke findes en tabel, skal der oprettes en tabel.
Denne applikation foreslår kolonnenavn og datatype for de nye tabeller.
Før du uploader: Tjekliste til filforberedelse
De fleste mislykkede uploads skyldes filen snarere end HANA, og alle disse problemer er billigere at løse før start end efter en delvis indlæsning.
- Én overskriftsrække, ingen flettede celler. Guiden foreslår kolonnenavne fra overskriften. Sammenflettede celler, en titelrække over overskriften eller en tom første række giver alle meningsløse kolonnenavne.
- Kolonnenavne uden mellemrum eller specialtegn. Foreslåede tabelkolonner arver headerteksten. Navne som Salgsorganisation bliver akavede identifikatorer, der senere kræver dobbelte anførselstegn i hver forespørgsel.
- Konsistente datatyper ned ad hver kolonne. En kolonne med tal og én tekstindtastning foreslås som tegn, og hver efterfølgende beregning kræver derefter en konvertering.
- Datoer i et entydigt format. ÅÅÅÅ-MM-DD fjerner tvetydigheden omkring dag og måned, der lydløst ødelægger en indlæsning.
- Ingen tusindseparatorer i numeriske kolonner. En værdi på 1,000 læses som tekst, ikke som et tal.
- Korrekt kodning på CSV. UTF-8 bevarer ikke-ASCII-tegn; andre kodninger omdanner dem til erstatningstegn, der er svære at rette bagefter.
- Kun ét regneark med data. For XLSX forvirrer ekstra ark og skjulte rækker ofte rækkeantallet.
At bruge et par minutter på filen gør også typeforslagene bedre, da HANA udleder hver kolonne fra de værdier, den kan se. Typeadfærd er dækket i SAP HANA-datatyper.
Sådan uploades data fra flad fil til SAP HANA
Trin til upload af data fra flad fil til SAP HANA er som nedenfor-
- Opret tabellen i SAP HANA
- Opret fil med data i vores lokale system
- Vælg filen
- Administrer kortetpings
- Indlæs dataene
Opret tabellen i SAP HANA
Hvis bordet ikke er til stede i SAP HANA, så kan vi lave et bord ved SQL Script eller ved denne proces ved at vælge "NY" valgmulighed.
Vi vil bruge "NY" mulighed for at oprette en ny tabel.
Opret fil med data i vores lokale system
Vi vil uploade salgsorganisationens stamdata. Så opret en .csv-fil og .xls-fil til den på det lokale system.
Vi vil uploade filen SalesOrg.xlsx til SAP HANA, så vi har oprettet en fil SalesOrg.xlsx i det lokale system.
| SalgsOrg | Navn | Valuta | CoCode | Adresse | Land | Ref_Sorg |
|---|---|---|---|---|---|---|
| 1000 | ABC Pvt. Ltd. | USD | 1000 | NEW YORK | Danmark | 1000 |
| 2000 | ABC Enterprises | INR | 2000 | INDIEN | INDIEN | 2000 |
Vælg filen
Trin 1) Åbn modeleringsperspektivet -> 'Hovedmenu' -> 'Hjælp' -> 'Hurtig visning' som vist nedenfor.

En Quick View-skærm vises som nedenfor-
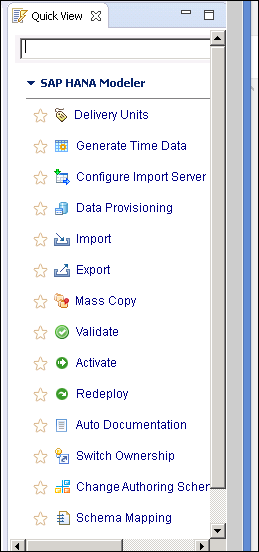
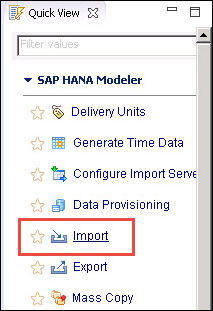
Vælg 'Importer' fra Quick View. En pop-up til importindstilling vil blive vist.
En pop-up til import-skærm vises. Gå til SAP HANA-indhold -> 'Data fra lokal fil'.

Klik på Næste. Der vises en pop op-boks til valg af fil. Følg nedenstående trin for at vælge den fil.
- Vælg filen SalesOrg.xls.
- Klik på knappen "Åbn".
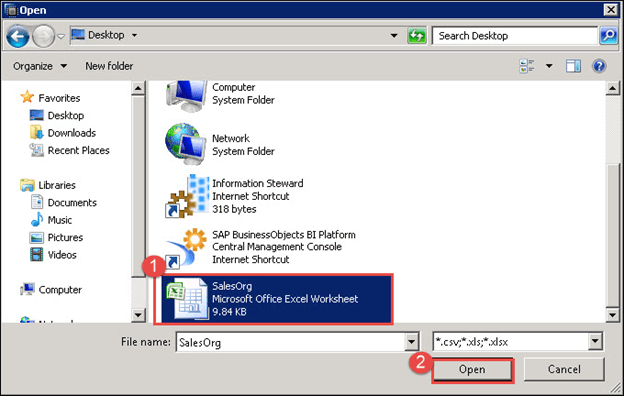
Der vises en skærm til filvalg til import, hvor vi kan vælge en fil til indlæsning af data fra det lokale system. SAP HANA database.
Tilgængelige muligheder kan kategoriseres i tre hovedområder, de er
- Kildefilsektion
- Fildetaljers sektion
- Target Bordlampe
Trin 2) I dette trin skal vi indtaste følgende detaljer -
- Vælg fil – Den valgte filsti vil blive vist her.
- Overskriftsrække findes – Hvis filen SalesOrg.xls har en overskrift (kolonnenavn). Så vi har sat kryds ved det.
- Importer alle data – Marker denne mulighed, hvis du vil importere alle data fra en fil, ellers nævner Startlinje og Slutlinje for specifik dataindlæsning fra fil.
- Ignorer førende og efterfølgende hvidt mellemrum – Markér denne indstilling for at ignorere foranstillede og efterstillede mellemrum i filen.
- Target Bord – NyHvis tabellen ikke findes i SAP HANA, vælg derefter denne indstilling, og angiv et eksisterende skemanavn og det tabelnavn, der skal oprettes.
- Target Tabel – EksisterendeHvis tabellen findes i SAP HANA, og vælg derefter denne mulighed. Vælg Skemanavn og Tabel. Data vil blive tilføjet til slutningen af tabellen.
- Klik på knappen "Næste".

Administrer kortetpings
Et kortping Skærmen vil blive brugt til at udføre kortetping mellem kilde- og målkolonner.
Der er to forskellige typer kortping tilgængelig. Når vi klikker på  vi får to muligheder som nedenfor -
- En til en: Ved at bruge denne mulighed kan vi kortlægge kolonne til kolonne baseret på sekvensen. Denne mulighed kan bruges, hvis vi ved, at alle kolonnerne er i rækkefølge.
- Kort efter navn: Ved at bruge denne mulighed kan vi kortlægge kilde- og målkolonnerne baseret på navnet. Dette kan bruges, hvis vi ved, at kolonnenavnene er de samme.
Kortping af kilde til Target - Vi vil kortlægge her Kildefil-kolonnen til Target Tabel, og vi kan også ændre definitionen af måltabellen.
- Foreslået tabelstruktur fra kildefil- Tabelkolonne Navn formodes fra Excel-fil Kolonnenavn (overskrift).
- Target Tabelstruktur: Target Tabellagertype er valgt som kolonnelager som standard.
- Klik på Filnavn og træk til målfeltet. Filen vil blive kortlagt. Feltet kan kortlægges automatisk én-til-én eller med muligheden Kortlægning efter navn. Vi kan manuelt lave kortlægningen.ping ved hjælp af træk-og-slip-funktionen, hvis vores kolonnenavn ikke kunne kortlægges med ovenstående muligheder.

- I afsnittet Fildata på samme skærm kan vi også se, hvordan dataene ser ud i kildefilen for alle kolonnerne. Afsnittet Fildata viser data fra SalesOrg-filen.
- Klik på knappen "Næste".


Et vindue til import af data fra den lokale fil vises.
Indlæs dataene
Dette er den sidste skærm, før vi starter indlæsningsprocessen. På denne skærm vises data, der allerede findes i tabellen, samt oplysninger om skemaet og tabellen, som vi skal indlæse dataene til.
- DetaljeafsnitI dette afsnit Navn på valgt kildefil, Target Tabel navn, og Target Skemanavn detaljer vil blive vist.
- Data fra fil: Den vil vise data f.eks.trachentet fra filen.
- Hvis de viste data i afsnittet Data fra fil er blevet bekræftet, skal du klikke på 'Udfør' for at begynde at indlæse dataene i tabellen.

Når importfunktionen er fuldført, bør vi se posten i joblogvisningen med statussen 'Fuldført'.

Når dataimportopgaven er vellykket,
- Vi kan se dataene i tabellen ved at vælge tabellen for det respektive skema og højreklikke på Tabel -> 'Datavisning' som vist nedenfor.
- Tabellens data vil blive vist på dataeksempelskærmen som nedenfor-

Almindelige fejl ved upload af flade filer
Troldmanden er tilgivende, hvilket er en blandet velsignelse: nogle problemer giver en klar fejl, og andre indlæses stille og roligt med det forkerte resultat. Begge typer er anført her.
| Symptom | Årsag | Fix |
|---|---|---|
| Kolonnenavne vises som COL1, COL2 | Overskriftsrække findes var ikke markeret | Gå tilbage til skærmbilledet med filoplysninger, og marker det |
| Indlæsning mislykkes med en længdefejl | Foreslået kolonnelængde er kortere end en værdi længere nede i filen | Udvid kolonnen på kortetping skærm før indlæsning |
| Numbers ankommer som tekst | Tusindseparatorer eller en tilfældig tekstværdi i kolonnen | Rengør kildekolonnen og genindlæs |
| Datoerne er forkerte eller afviste | Tvetydigt eller lokalspecifikt datoformat | Omformatér filen til ÅÅÅÅ-MM-DD |
| Rækkerne er duplikerede | Eksisterende blev valgt, og indlæsningen blev gentaget; data tilføjes, de erstatter ikke | Afkort tabellen før genindlæsning |
| Tegn med accent er beskadiget | CSV gemt i en ikke-UTF-8-kodning | Gem igen som UTF-8 og genindlæs |
| Færre rækker indlæst end forventet | Start- og slutlinjen blev angivet i stedet for Importér alle data | Markér Importer alle data |
Det er tilfældet med duplikering, man skal holde øje med. Valg af en eksisterende tabel tilføjer altid data, så genkørsel af en mislykket indlæsning uden at rydde tabellen fordobler dataene lydløst.
Flad filupload vs. andre provisioneringsmetoder
Upload af flad fil er den enkleste og mest begrænsede mulighed. At vide, hvor den stopper, forhindrer, at den bruges, hvor en planlagt metode hører hjemme.
| Parameter | Upload af flad fil | SLT | Datatjenester |
|---|---|---|---|
| Automation | Kun manuel | Planlagt eller i realtid | Planlagt |
| gentagelig | Nej, hver kørsel er i hånden | Ja | Ja |
| Transformation | Kolonnekortping kun | Enkle regler | Rige transformationer |
| Bind | Små filer | Store borde | Stor og heterogen |
| Opsætningsindsats | Ingen | En SLT-server | Et landskab for datatjenester |
| Bedste for | Prototyping, små referencedata | Live operationelle data | Konsolidering af mange kilder |
Reglen er enkel: hvis den samme fil skal indlæses igen næste måned, hører indlæsningen hjemme Datatjenester or SLT snarere end i en guide, som nogen skal huske at køre. Det fulde sæt af muligheder sammenlignes i datalevering vejledningen, og den tilsvarende indstilling i menuen Filer er beskrevet i SAP HANA import og eksport.
