
SAP HANA-modellering: Visninger, tabeller og datamodeller
 Murer Garcia
⚡ Smart opsummering
SAP HANA Modeling opretter informationsvisninger, der omformer rå databasetabeller til forretningsklare modeller. Attribut-, analytiske og beregningsvisninger, pakkestruktur, nødvendige rettigheder og ydeevneregler dækkes med praktiske navngivningsstandarder.

Hvad er SAP HANA modellering?
SAP HANA-modellering er en aktivitet, hvormed vi opretter en informationsvisning. En informationsvisning svarer til en dimension, en kube eller en InfoProvider i BW. Denne informationsvisning bruges til at oprette den flerdimensionelle datamodel.
De fysiske borde indenfor SAP HANA holder data i den form, som kildesystemet leverede dem i. Modellering tilføjer et lag oven på disse tabeller, der omdøber kolonner, forbinder relaterede poster, anvender filtre og definerer beregninger. Rapporteringsværktøjer læser derefter dette lag i stedet for tabellerne, så forretningsbrugere aldrig behøver at kende den underliggende tabelstruktur.
SAP HANA-modelleringsoversigt
Modellering er en aktivitet, hvor brugeren forfiner eller opdeler data i databasetabellen ved at oprette en informationsvisning baseret på forretningsscenariet. Disse informationsvisninger kan bruges til rapportering og beslutningstagning.
En informationsvisning laves ud fra forskellige kombinationer af indholdsdata for at skabe en model for et forretningsscenarie.
Indholdsdata i en informationsvisning er af to typer:
- Egenskab: Descriptive og ikke-målbare data. For eksempel leverandør-ID, leverandørnavn, by osv.
- Måle: Data, der kan kvantificeres og beregnes. For eksempel, RevEnue, Solgt antal og Tællere. En måling er afledt af en analytisk visning og en beregningsvisning. En måling kan ikke oprettes i en attributvisning.
Begge byggesten defineres, når de er inde i visningen, og genbruges af hver rapport, der bruger den. Afsnittene nedenfor viser de nøjagtige varianter. SAP HANA understøtter hver enkelt.
Typer af attribut
SAP HANA understøtter tre typer attributter:
| Typer af attributter | Aktiviteter |
|---|---|
| Enkel attribut | Det er afledt af datagrundlaget. |
| Beregnet egenskab | Det er afledt af en eller flere eksisterende attributter og konstanter. For eksempel en aritmetisk beregning eller udledning af det fulde navn fra for- og efternavn. |
| Lokal egenskab | Den bruges i modelleringsvisninger (analytisk visning eller beregningsvisning) til at tilpasse en attributs funktionsmåde, så den er lokal for modellering visning og kan ikke tilgås uden for denne visning. |
Måletyper
SAP HANA understøtter fire typer af målinger:
| Typer af foranstaltninger | Aktiviteter |
|---|---|
| Simpel foranstaltning | Det er afledt af datagrundlaget. |
| Beregnet mål | Den er afledt af en eller flere eksisterende målinger, konstanter og funktioner. For eksempel en aritmetisk beregning. |
| Begrænset Foranstaltning | Den bruges til at filtrere værdier baseret på brugerdefinerede regler for attributværdier. |
| Counter | Det er en særlig type kolonne, der viser et unikt nummer for attributkolonner (analytisk visning eller beregningsvisning). Den bruges til at tælle en eller flere attributkolonner. |
Når attributter og målinger er besluttet, samles de i en af tre informationsvisninger:
- Attributvisning – Dette bruges til masterdatakontekst.
- Analytisk visning – Dette bruges til at oprette faktatabeller og ligner en kube i BW.
- Beregningsvisning – Dette bruges til at oprette en kompleks visning og ligner en MultiProvider i BW.
Før nogen af disse visninger kan bygges, skal modelbyggerkontoen have et specifikt sæt autorisationer.
Nødvendige privilegier til modellering
Privilegier giver sikkerhed til SAP HANA-database, hvorigennem kun en autoriseret bruger kan få adgang til autoriseret indhold.
Objektprivilegier
Objektprivilegier er SQL privilegier, der bruges til at give læse-/skriveadgang til databaseobjekter. Objektprivilegierne nedenfor er påkrævet til modellering.
- SELECT-privilegium på _SYS_BI-skemaet.
- SELECT-privilegium på _SYS_BIC-skemaet.
- UDFØR privilegium på REPOSITORY_REST (SYS).
- SELECT-privilegium på tabelskemaet.
Pakkeprivilegier
Pakkerettigheder er påkrævet for at godkende handlinger på individuelle pakker. Pakkerettighederne nedenfor er påkrævet til datamodellering.
- REPO.MAINTAIN_NATIVE_PACKAGES-privilegiet på rodpakken.
- REPO.READ, REPO.EDIT_NATIVE_OBJECTS & REPO.ACTIVATE_NATIVE_OBJECTS på den pakke, der bruges til indholdsobjekter.
Analytiske privilegier
For at få adgang til en SAP HANA-informationsvisning, analytiske privilegier er krævet.
- For fuld dataadgang til alle informationsvisninger i en SAP HANA-systemet kræver analytisk privilegium "_SYS_BI_CP_ALL". For begrænset dataadgang skal analytiske privilegier oprettes og tildeles brugeren.
Andre privilegier
- Giv adgang til dit eget skema til _SYS_REPO-brugeren som 'GRANT SELECT ON SCHEMA “Schema name” TO _SYS_REPO WITH GRANT OPTION';
- REPO.MAINTAIN_DELIVERY_UNITS til oprettelse af leveringsenheder.
- REPO.IMPORT, REPO.EXPORT til import og eksport af leveringsenheder.
- REPO.WORK_IN_FOREIGN_WORKSPACES til at arbejde i fremmede arbejdsområder.
Forskellen mellem attributvisning, analytisk visning og beregningsvisning
De tre informationsvisninger er ikke udskiftelige. Hver enkelt besvarer et forskelligt spørgsmål, og at vælge den forkerte er den mest almindelige modelleringsfejl, som begyndere begår.
| Kriterier | Attributvisning | Analytisk visning | Beregningsvisning |
|---|---|---|---|
| Formål | Stamdata og beskrivende kontekst | Stjerneskema på en enkelt faktatabel | Kompleks logik på tværs af flere kilder |
| Tilladte foranstaltninger | Ingen | Ja | Ja |
| Antal faktatabeller | Ikke relevant | Én | Mange |
| Unionen støttede | Ingen | Ingen | Ja |
| Kan forbruge andre visninger | Ingen | Kun attributvisninger | Alle tre typer |
| BW-ækvivalent | Karakteristik / dimension | Infokube | Multiudbyder |
En praktisk regel fungerer godt: byg en attributvisning når outputtet er en beskrivende liste, analytisk visning når én faktatabel måles i forhold til disse beskrivelser, og en beregningsvisning når svaret kræver en forening, en anden faktatabel eller logik, som et stjerneskema ikke kan udtrykke.
SAP HANA Bedste-praksis til at skabe informationsmodeller
An SAP HANA Best Practice er en standard, der følges, når et objekt oprettes i SAP HANA-database. De bedste fremgangsmåder nedenfor gælder for hver objekttype.
PAKKE:
- Opret en pakke på topniveau, f.eks. "Udvikling", til udviklingsarbejde.
- Opret en underpakke under topniveaupakken for hver udvikler.
- Flere underpakker kan også oprettes, hvis det er nødvendigt.
SKEMA:
- Design dit skemalayout, før projektet starter. For eksempel DS_SCHEMA, SLT_SCHEMA, FI_SCHEMA, SD_SCHEMA osv.
- Brugerdefinerede tabeller skal placeres i et separat skema.
TABELLER:
- En tabel, der skal bruges i rapportering eller OLAP skal være af typen kolonnelager.
- En tabel, der skal bruges i transaktioner eller OLTP skal være af typen rækkelager.
- Giv en kommentar eller beskrivelse af tabellen og kolonnenavnene korrekt for at sikre klarheden.
NAVNEKONVENTION:
| FORMÅL | dannet | Beskrivelse |
|---|---|---|
| ATRIBUTER VISNINGER | AT_PRODUKT | AT_ betyder attributvisning |
| ANALYTISKE VISNINGER | AN_SALG | AN_ betyder analytisk visning |
| BEREGNINGSVISNINGER | CA_SALG | CA_ betyder beregningsvisning |
| ANALYTISKE PRIVILEGIER | AP_REST_AT (Attributvisning) AP_REST_AN (Analytisk visning) AP_REST_CA (Beregningsvisning) |
AP_ betyder analytiske privilegier |
| HIERARKI | HI_BNAME_PC (Forælder/barn) HI_BNAME_LV (Niveau) |
HI_ betyder hierarki |
| PROCEDURE | SP_PROCEDURENAME | SP_ betyder gemt procedure |
| INDGANGSPARAMETRE | IP_PARA_NAME | IP_ betyder parameter |
| VARIABLER | VA_VNAME | VA_ betyder variabelnavn |
Navngivningskonventionen giver kun mening, hvis hver model findes i en planlagt pakkestruktur, som oprettes som vist nedenfor.
Oprettelse af en pakke i SAP HANA Studio
Pakke: Det er en beholder, der indeholder alle oplysninger om modellen (attributvisning, analytisk visning, beregningsvisning osv.) i en gruppe.
Typer af pakke: Pakkerne findes i to typer, som vist nedenfor.
| Type | Beskrivelse | ikon |
|---|---|---|
| Strukturel | I en strukturpakke kan der kun oprettes en underpakke. Der kan ikke oprettes nogen informationsvisning (attributvisning, analytisk visning osv.) i en strukturpakke. Eksempler på en strukturel pakke er SAP, system-lokal, system-lokal.genereret og system-lokal.privat. |
|
| Ikke-strukturel | En ikke-strukturel pakke kan indeholde informationsobjekter og underpakker. Dette er standardpakken. |
|


Anvendelser af en pakke: En pakke grupperer alle informationsmodeller og gør modeltransport nemmere. Begge pakketyper kan bruges i transporten.
Trin til at oprette en strukturel pakke i SAP HANA Studio:
Trin 1) I dette trin,
- Vælg HANA-systemet, her er det HDB.
- Gå til mappen Indhold.

Trin 2) I dette trin,
- Vælg Ny.
- Vælg Pakkeindstillingen.

Trin 3) I dette trin,
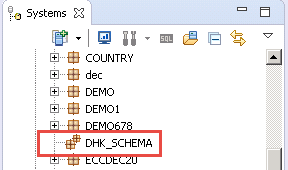
- Indtast pakkenavnet. For eksempel "DHK_SCHEMA".
- Indtast en beskrivelse af pakken.
- Originalsprog og ansvarlig person er valgt som standard.

En ikke-strukturel pakke med navnet “DHK_SCHEMA” vil blive oprettet i Content-noden, som vist nedenfor.

Trin 4) Konverter nu den ikke-strukturelle pakke til en strukturel pakke.
- Vælg pakken “DHK_SCHEMA” og højreklik på den.
- Gå til redigeringsindstillingen for pakken.

Trin 5) I dette trin,
- Vælg "Ja" i feltet Strukturelle indstillinger.
- Klik på OK-knappen.

Når "DHK_SCHEMA" ændres fra en ikke-strukturel til en strukturel pakke, ændres ikonstilen fra  til
 Dette er en indikation af, at den ikke-strukturelle pakke nu er konverteret til en strukturel pakke.
Trin til oprettelse af en ikke-strukturel pakke under en strukturel pakke som en underpakke:
En pakke oprettes som standard som ikke-strukturel. I en ikke-strukturel pakke kan andre pakker og informationsobjekter oprettes. Det er bedre først at oprette en strukturel pakke og derefter oprette en underpakke indeni.
Trin 1) I dette trin,
- Vælg strukturpakken “DHK_SCHEMA” og højreklik på den.
- Vælg Ny -> Pakke.

Trin 2) I dette trin,
- Indtast navnet på underpakken i feltet Navn.
- Indtast en beskrivelse af det.
- Klik på knappen “OK”.

En ny ikke-strukturel pakke vil blive oprettet som en underpakke under DHK_SCHEMA-pakken.

Sådan aktiverer og validerer du en informationsvisning
Når en visning gemmes, gemmes den kun i designtidsarkivet. Indtil den aktiveres, findes der intet runtime-objekt, og ingen rapporter kan læse den. Aktivering genererer en kolonnevisning under _SYS_BIC-skemaet, og det genererede objekt er det, SQL og rapporteringsværktøjer rent faktisk forespørger.
Trin 1) Gem visningen. Tryk Ctrl+S i SAP HANA Studio. Visningen findes nu som et inaktivt designtidsobjekt, markeret med et diamantformet overlay i Content-noden.
Trin 2) Aktivér visningen. Højreklik på visningen, og vælg Aktiver, eller tryk på Ctrl+F3. Vælg "Aktiver" for kun at implementere denne visning, eller "Genimplementer" for at genopbygge runtime-objektet, når designtidsdefinitionen ikke er ændret, men det genererede objekt mangler.
Trin 3) Læs jobloggen. Joblogvisningen rapporterer succes eller fiasko for hvert objekt i aktiveringsbatchen. En fejlpost navngiver objektet og årsagen, så udvid altid posten i stedet for at stole på opsummeringslinjen.
Trin 4) Forhåndsvis dataene. Højreklik på den aktiverede visning, og vælg Datavisning. Fanen Analyse giver mulighed for at trække attributter til etiketaksen og mål til værdiaksen, hvilket bekræfter, at joinforbindelser returnerer det forventede antal rækker.
Trin 5) Løs almindelige aktiveringsfejl. Tre fejl forklarer de fleste tilfælde:
- Utilstrækkelige rettigheder på skemaet: _SYS_REPO mangler SELECT WITH GRANT OPTION på skemaet, der indeholder basistabellerne. Tillad den, og aktiver den igen.
- Ugyldigt kolonnenavn: En basistabelkolonne blev omdøbt eller slettet, efter at visningen blev modelleret. Opdater datagrundlaget, og omdøb feltet.
- Cyklisk afhængighed: To visninger refererer til hinanden. Bryd løkken ved i stedet at pege en af dem mod den underliggende tabel.
Efter en vellykket aktivering kan visningen forespørges direkte med SELECT * FROM “_SYS_BIC”.”package/VIEW_NAME”, hvilket er den hurtigste måde at bekræfte objektets eksistens, før et rapporteringsværktøj er forbundet til det.
SAP HANA Performance Optimization Teknik
En aktiveret visning, der returnerer korrekte resultater, kan stadig være langsom. Reglerne nedenfor former, hvordan beregningsmotoren udfører modellen.
- Alle informationsvisninger og tabelvisninger bør bruges med en projektionsnode. En projektionsnode forbedrer ydeevnen ved at indsnævre kolonnesættet.
- Anvend filtre på projektionsnoder.
- Undgå at sammenføje noder i en beregningsvisning, og brug i stedet en union, hvor det er muligt.
- Brug inputparametre eller variabler til at begrænse datasættet inden for en analytisk visning eller beregningsvisning.
- Beregninger bør udføres før aggregering.
- Hierarkier skal omdefineres i en beregningsvisning, fordi hierarkier i en attributvisning ikke er synlige i en beregningsvisning.
- Hierarkier i en attributvisning er synlige i en analytisk visning.
- Etiketter for attributter og beskrivelser af målinger defineret i en attributvisning, analysevisning eller beregningsvisning vises ikke i en forbrugende beregningsvisning. De skal omtilknyttes.
- Bland ikke CE-funktioner og SQLScript i den samme informationsmodel.
Join-design påvirker også runtime-omkostningerne. En referentiel join kan beskæres helt, når der ikke anmodes om et felt fra den højre tabel, hvilket er grunden til valg af tilslutningstype fortjener lige så meget opmærksomhed som placering af noder.
Hvorfor beregningsvisninger erstattede attribut- og analytiske visninger
SAP udfasede attributvisninger og analytiske visninger sammen med XS Classic-modellen og SAP HANA Repository. Udfasningen blev annonceret for SAP HANA 1.0 SPS 12 og gentaget for SAP HANA 2.0 SPS 02. Udfaset betyder stadig understøttet på SAP HANA 2.0, men ikke videreført til SAP HANA Cloud.
Årsagen er konsolidering snarere end udskiftning af funktioner. Successive supportpakker stabler udvidede beregningsvisninger, indtil de har absorberet funktionerne i de to andre typer:
- En beregningsvisning af datakategori Dimension, med en projektionsnode på det semantiske lag, udfører arbejdet i en attributvisning.
- En beregningsvisning af datakategori Cube med en stjernesammenkobling, med en aggregeringsnode på det semantiske lag, udfører arbejdet i en analytisk visning.
Én visningstype betyder også én optimeringssti, ét sæt modelleringsmønstre at lære og ét migreringsmål. SAP Leverer et migreringsværktøj, der konverterer eksisterende attributvisninger, analytiske visninger og scriptbaserede beregningsvisninger til grafiske beregningsvisninger og tabelfunktioner. Eksisterende visninger kører fortsat, så migrering kan planlægges i stedet for at blive forhastet, men ny udvikling bør starte med beregningsvisninger.
