
Підручник Hadoop Pig: що таке Apache Pig? Archiтектура, приклад
 Прафулла Ранадіве
⚡ Розумний підсумок
Apache Pig — це високорівнева платформа для аналізу великих наборів даних на Hadoop, що поєднує мову обробки потоків даних Pig Latin із середовищем виконання, яке компілює кожен скрипт у MapReduce, Tez або... Spark завдання автоматично.
Цей посібник починається з ідеї Apache Pig, потім розповідає про його встановлення та запуск повного латинського алфавіту Pig від початку до кінця.
Що таке Apache Pig?
Свиня — це високорівень мова програмування корисний для аналізу великих наборів даних. Pig був результатом зусиль розробників Yahoo!
У фреймворку MapReduce програми потрібно перевести в серію етапів Map та Reduce. Однак це не та модель програмування, з якою знайомі аналітики даних. Тому, щоб подолати цю прогалину, потрібно використовувати ABS.tracпід назвою Pig було збудовано на вершині Hadoop.
Apache Pig дозволяє людям більше зосередитися на аналізі великих наборів даних і витрачати менше часу на написання програм MapReduce. Подібно до свиней, які їдять усе, мова програмування Apache Pig розроблена для роботи з будь-яким типом даних. Саме тому назва Pig!, талісман проекту нижче, підкреслює ту саму думку.

Проєкт все ще активний. Apache Pig 0.18.0 було випущено 15 вересня 2025 року та додано підтримку Hadoop 3, Tez 0.10, Hive 3, Spark 3, HBase 2 та Python 3, згідно з Сторінка випусків Apache PigНаведене нижче покрокове керівництво було спочатку написано для набагато старішої версії 0.12.1, тому деякі кроки містять примітку, де поточний реліз поводиться інакше.
Свиня Archiтектура
Архітектура Pig складається з двох компонентів:
- Свиня латинська, яка є мовою
- Середовище виконання, для проведення програм Pig Latin.
Програма на Pig Latin складається з серії операцій або перетворень, які застосовуються до вхідних даних для отримання виводу. Ці операції описують потік даних, який перетворюється на виконуваний файл середовищем виконання Hadoop Pig. Нижче результати цих перетворень є серією... MapReduce завдання, про які програміст не знає. Тож, певним чином, Pig у Hadoop дозволяє програмісту зосередитися на даних, а не на характері виконання.
Pig Latin — це порівняно жорстка мова, яка використовує знайомі ключові слова з обробки даних, наприклад, Join, Group та Filter. Діаграма нижче tracпроходить скрипт з оболонки Grunt через парсер, оптимізатор та компілятор на шляху до механізму виконання.

Режими виконання
Pig у Hadoop має два режими виконання, і в наступному покроковому посібнику з встановлення використовуються обидва з них:
- Локальний режим: У цьому режимі мова Hadoop Pig працює в одному JVM та використовує локальну файлову систему. Цей режим підходить лише для аналізу невеликих наборів даних за допомогою Pig у Hadoop.
- Режим MapReduce: У цьому режимі запити, написані мовою Pig Latin, перетворюються на завдання MapReduce та виконуються на кластері Hadoop (кластер може бути псевдорозподіленим або повністю розподіленим). Режим MapReduce з повністю розподіленим кластером корисний для запуску Pig на великих наборах даних.
Ці дві — класична пара. Поточні релізи фактично пропонують шість типів виконання, або exectypes, кожен з яких вибрано з однаковим -x прапор, як задокументовано в Посібник з початку роботи з Pig 0.18.0.
| Тип виконання | Command | Де виконується робота |
|---|---|---|
| Місцевий | свиня -x локальний | Одна JVM на локальній файловій системі |
| Tez local | pig -x tez_local | Одна JVM, що використовує середовище виконання Tez (експериментальна версія) |
| Spark місцевий | pig -x spark_local | Одна JVM, що використовує Spark середовище виконання (експериментальна версія) |
| MapReduce | свиня або свиня -x mapredue | Кластер Hadoop з HDFS; це налаштування за замовчуванням |
| тезу | свиня -x tez | Кластер Hadoop, що працює під керуванням рушія Tez |
| Spark | свиня -x іскра | A Spark, YARN або кластер Mesos з HDFS |
Типи даних Pig Latin та Operaторс
Перш ніж писати скрипт, корисно знати, що може містити Pig і що він може з цим робити. Модель даних повністю вкладена, що дозволяє Pig читати файли журналів та інші вільно структуровані дані, які реляційна таблиця відхилила б.
Pig Latin пропонує два сімейства типів:
- Скалярні типи:
int,long,float,double,chararray,bytearray,boolean,datetime,bigintegerтаbigdecimalУ наступному прикладі скрипта кожен стовпець оголошується якchararray. - Складні типи: a кортеж є впорядкованим набором полів і поводиться як рядок; сумка є невпорядкованою колекцією кортежів і поводиться як таблиця; карта – це набір пар ключ-значення, ключ яких має бути
chararray.
Оператори виконують невелику кількість робіт, і лише декілька з них обслуговують майже кожен конвеєр:
| Operaтор | Що вона робить |
|---|---|
| ЗАВАНТАЖИТИ / ЗБЕРІГАННЯ | Зчитати відношення з файлової системи та записати результат назад |
| ФІЛЬТР | Зберігати лише ті кортежі, які відповідають умові |
| ДЛЯ ВСЬОГО … ЗГЕНЕРУВАТИ | Працюйте стовпець за стовпцем, створюючи нові поля |
| ГРУПА / КОГРУПА | Групування одного або двох чи більше відношень за ключем |
| РЕЄСТРАЦІЯ | Об'єднання зв'язків за допомогою внутрішнього або зовнішнього з'єднання |
| СОЮЗ / РОЗДІЛ | Об'єднати зв'язки або розділити одне на кілька |
| Упорядкувати за / відмінністю / обмеженням | Сортування, видалення дублікатів та обмеження кількості кортежів |
| ВИКИДАТИ / ОПИСАТИ / ПОЯСНИТИ / ПРОІЛЮСТРУВАТИ | Перевірка результатів, схем, планів виконання та пробних запусків |
Чотири оператори інспекції також мають скорочення Grunt, що економить тиping під час налагодження: \d для ДАМПУ, \de для ОПИСУ, \e для ПОЯСНЕННЯ та \i для ІЛЮСТРАЦІЇ.
Передумови
Pig — це клієнтський інструмент. Він аналізує скрипт, планує роботу та надсилає завдання, але не надає власного сховища чи кластера, тому спочатку має існувати робоча інсталяція Hadoop. Список вимог до Apache короткий.
| Компонент | Вимога | Чому це потрібно |
|---|---|---|
| Hadoop | Hadoop 2.x або 3.x з експортованим HADOOP_HOME | Забезпечує HDFS та механізм виконання. Без HADOOP_HOME, Pig 0.18.0 повертається до вбудованого Hadoop 2.7.3. |
| Java | Java 1.7 або пізнішої версії, з JAVA_HOME, встановленим на кореневий каталог інсталяції | Pig та демони Hadoop є Java програми |
| Python (За бажанням) | Python 2.7 | Потрібно лише для потокового передавання Python функції, визначені користувачем |
| Мураха (необов'язково) | Мураха 1.8 | Потрібно лише під час збирання або перекомпіляції Pig з вихідного коду |
Поряд із цим списком є два практичні моменти. По-перше, запускайте все від імені користувача Linux, який уже має домашній каталог у HDFS і дозвіл на запис у нього; у цьому посібнику використовується hduser, обліковий запис, створений під час налаштування Hadoop. По-друге, запустіть кластер перед запуском Pig у режимі MapReduce, оскільки Pig негайно завершує роботу, якщо NameNode та ResourceManager не встановлені. Якщо Hadoop ще не встановлено, виконайте дії як встановити Hadoop перший.
Як завантажити та встановити Pig
У цьому посібнику з Apache Pig ми дізнаємося, як завантажити та встановити Pig:
Перш ніж ми почнемо безпосередньо з процесу, переконайтеся, що у вас встановлено Hadoop. Змініть ім'я користувача на «hduser» (ідентифікатор, який використовувався під час налаштування Hadoop; ви можете переключитися на ідентифікатор користувача, який використовувався під час власного налаштування Hadoop).

Крок 1) Завантажте останню стабільну версію Pig Hadoop з будь-якого з доступних сайтів-дзеркал за адресою
https://pig.apache.org/releases.html
Виберіть файл tar.gz (а не src.tar.gz) для завантаження, як показано нижче.

Крок 2) Після завершення завантаження перейдіть до каталогу, що містить завантажений tar-файл, і перемістіть його туди, де ви хочете налаштувати Pig Hadoop. У цьому випадку ми перемістимося до /usr/local.

Перейдіть до каталогу, який міститиме файли Pig Hadoop.
cd /usr/local
Extracвміст tar-файлу, як показано нижче.
sudo tar -xvf pig-0.12.1.tar.gz

Крок 3) Змініть ~/.bashrc, щоб додати змінні середовища, пов'язані з Pig.
Відкрийте файл ~/.bashrc у будь-якому текстовому редакторі на ваш вибір та внесіть наведені нижче зміни.
export PIG_HOME=<Installation directory of Pig>
export PATH=$PIG_HOME/bin:$HADOOP_HOME/bin:$PATH

Крок 4) Тепер отримайте цю конфігурацію середовища за допомогою команди нижче.
. ~/.bashrc

Крок 5) Нам потрібно перекомпілювати Pig для підтримки Hadoop 2.2.0.
Ось кроки, як це зробити.
Перейдіть до домашнього каталогу Pig.
cd $PIG_HOME
Встановіть Ant.
sudo apt-get install ant

Примітка: Завантаження розпочнеться та триватиме певний час залежно від швидкості вашого інтернет-з’єднання.
Перекомпілюйте Pig.
sudo ant clean jar-all -Dhadoopversion=23

Зверніть увагу, що в цьому процесі перекомпіляції завантажується кілька компонентів, тому система повинна бути підключена до Інтернету.
Також, якщо цей процес десь зависає, і ви не бачите жодного руху в командному рядку більше 20 хвилин, натисніть Ctrl + c і повторіть ту саму команду.
У нашому випадку це займає 20 хвилин.

Цей крок перекомпіляції належить до ери версії 0.12.1, коли надіслані JAR-файли були зібрані на Hadoop 1 та -Dhadoopversion=23 flag переключив збірку Ant на лінійку Hadoop 0.23 та 2.x. Apache Pig 0.18.0 постачає бінарні файли, які вже працюють на Hadoop 2.7 та вище, а також на Hadoop 3, тому в поточному випуску ви зазвичай можете розпакувати tar-архів і одразу перейти до тесту нижче.
Крок 6) Перевірте встановлення Pig за допомогою команди
pig -help

Приклад сценарію Pig
Після встановлення Pig, решта цього посібника з Apache Pig запускатиме повний скрипт. Ми використовуватимемо скрипти Pig, щоб знайти кількість проданих товарів у кожній країні.
Вхідні дані: Наш набір вхідних даних – це файл CSV, SalesJan2009.csv.
Крок 1) Запустіть Hadoop.
$HADOOP_HOME/sbin/start-dfs.sh
$HADOOP_HOME/sbin/start-yarn.sh
Крок 2) Pig у Big Data бере файл з HDFS у режимі MapReduce та зберігає результати назад у HDFS.
Скопіюйте файл SalesJan2009.csv (зберігається в локальній файловій системі за адресою ~/input/SalesJan2009.csv) до домашнього каталогу HDFS (розподілена файлова система Hadoop).
У цьому прикладі Apache Pig файл знаходиться у вхідній папці. Якщо файл зберігається в іншому місці, вкажіть цю назву.
$HADOOP_HOME/bin/hdfs dfs -copyFromLocal ~/input/SalesJan2009.csv /

Перевірте, чи файл дійсно був скопійований.
$HADOOP_HOME/bin/hdfs dfs -ls /

Крок 3) Конфігурація свині.
Спочатку перейдіть до $PIG_HOME/conf та збережіть копію оригінального файлу властивостей.
cd $PIG_HOME/conf
sudo cp pig.properties pig.properties.original

Відкрийте pig.properties за допомогою будь-якого текстового редактора та вкажіть шлях до файлу журналу за допомогою pig.logfile.
sudo gedit pig.properties

Логер використовуватиме цей файл для реєстрації помилок.
Крок 4) Виконайте команду «pig», яка запустить командний рядок Pig, інтерактивну оболонку для запитів Pig.
pig

Крок 5) У командному рядку Grunt для Pig виконайте команди Pig, наведені нижче по порядку.
— A. Завантажте файл із даними.
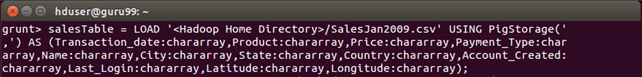
salesTable = LOAD '/SalesJan2009.csv' USING PigStorage(',') AS (Transaction_date:chararray,Product:chararray,Price:chararray,Payment_Type:chararray,Name:chararray,City:chararray,State:chararray,Country:chararray,Account_Created:chararray,Last_Login:chararray,Latitude:chararray,Longitude:chararray);
Натисніть Enter після цієї команди.
— B. Згрупуйте дані за полем «Країна».
GroupByCountry = GROUP salesTable BY Country;

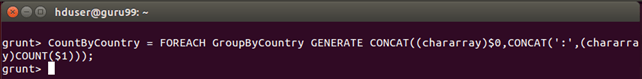
— C. Для кожного кортежу в «GroupByCountry» згенеруйте результуючий рядок виду Назва країни: Кількість проданих товарів.
CountByCountry = FOREACH GroupByCountry GENERATE CONCAT((chararray)$0,CONCAT(':',(chararray)COUNT($1)));
Натисніть Enter після цієї команди.
— D. Зберегти результати потоку даних у каталозі 'pig_output_sales' на HDFS.
STORE CountByCountry INTO 'pig_output_sales' USING PigStorage('\t');

Виконання цієї команди займе деякий час. Після завершення ви повинні побачити наступний екран.

Крок 6) Результат можна побачити через інтерфейс команд як
$HADOOP_HOME/bin/hdfs dfs -cat pig_output_sales/part-r-00000

Результати також можна переглянути через веб-інтерфейс.
Відкрийте http://localhost:50070/ у веббраузері.
Порт 50070 – це веб-інтерфейс NameNode на Hadoop 2. Hadoop 3 перемістив ту саму сторінку на порт 9870, тому використовуйте цю адресу, якщо ваш кластер працює на Hadoop 3.

Тепер виберіть «Переглянути файлову систему» та перейдіть до /user/hduser/pig_output_sales.

Відкрийте part-r-00000, щоб прочитати пари country та product-count, які створив скрипт.

Apache Pig проти Hive проти MapReduce
Свиня рідко оцінюється окремо. Звичайне питання полягає в тому, чи належить робота Свині, Вулик або в рукописній програмі MapReduce, оскільки всі три зрештою опиняються як завдання в одному кластері.
| Аспект | Зменшення карти (Java) | Свиня Апач | Вулик апачів |
|---|---|---|---|
| інтерфейс | Java API | Pig Latin, мова сценаріїв для обробки потоків даних | HiveQL, діалект SQL |
| Рівень пресуtracції | низький | Medium | Високий |
| Типовий користувач | Java розробник | Інженер даних або дослідник | Аналітик впевнено працює з SQL |
| Дані, які підходять | Будь-що, обробляється вручну | Структуровані та напівструктуровані; схема необов'язкова під час завантаження | Структуровані таблиці, зареєстровані в метасховищі |
| Code обсяг | Більшість ліній | Менше ліній | Найменша кількість рядків для запиту |
| Працює як | Завдання MapReduce | Компілюється в MapReduce, Tez або Spark роботи | Компілюється в MapReduce, Tez або Spark роботи |
| Найкраще в | Повний контроль та налаштована логіка | Багатокрокові ETL-конвеєри | Спеціальні запити та звіти |
На практиці поділ простий. Hive слід використовувати, коли дані вже виглядають як таблиця, а запитання — як SQL. Pig слід використовувати, коли вхідні дані неохайні, коли конвеєр є ланцюжком перетворень, а не одним запитом, або коли той самий скрипт має розгалужуватися та повторно об'єднуватися. MapReduce слід використовувати лише тоді, коли ні абсtracція може виразити логіку, оскільки кількість рядків швидко зростає.
Свиня також зручно розташовується поруч з рештою екосистеми. Sqoop та Flume отримує необроблені дані, Pig або Hive формують їх, а планувальник, такий як Apache Oozie об’єднують кроки в повторюваний конвеєр. Щоб отримати ширше уявлення про те, де ці інструменти підходять, див. посібник з великих даних та обговорення інструменти для роботи з великими даними; для комерційної ETL-альтернативи рукописним сценаріям див. Таленд.
