
Підручник Apache Flume: Що таке, ArchiПриклад tecture & Hadoop
 Прафулла Ранадіве
⚡ Розумний підсумок
Apache Flume — це розподілений сервіс для збору, агрегації та переміщення великих обсягів даних журналів у HDFS, побудований навколо агентів, які об'єднують джерело, канал та приймач.
Що таке Apache Flume у Hadoop?
Apache Flume — це надійна та розподілена система для збору, агрегації та переміщення величезних обсягів даних журналів. Вона має просту, але гнучку архітектуру, засновану на потоковій передачі даних. Apache Flume використовується для збору даних журналів, що містяться у файлах журналів з веб-серверів, та їх агрегації в HDFS для аналізу.
Flume в Hadoop підтримує кілька джерел, зокрема:
- «tail» (який передає дані з локального файлу та записує їх у HDFS через Flume, подібно до команди Unix «tail»)
- Системні журнали
- Apache log4j (що дозволяє Java програми для запису подій у файли в HDFS через Flume).
Поточний реліз – Флюм 1.11.0, опубліковано 25 жовтня 2022 року та доступно з Сторінка завантаження Apache FlumeЦей посібник було написано для версії 1.4.0, тому кілька кроків нижче містять примітку, де поточна версія поводиться інакше.
Потік Archiтектура
Агент Flume – це JVM процес із трьома компонентами – джерелом потоку (флуму), каналом потоку (флуму) та стоком потоку (флуму), через які поширюються події після їх ініціювання зовнішнім джерелом. На діаграмі нижче показано, як вони пов'язані.
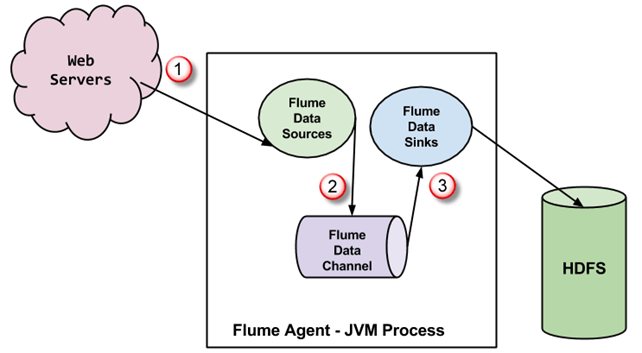
- Події, згенеровані зовнішнім джерелом (веб-сервером), споживаються джерелом Flume. Зовнішнє джерело надсилає події до джерела Flume у форматі, який розпізнає цільове джерело.
- Джерело Flume отримує подію та зберігає її в одному або кількох каналах. Канал діє як сховище, яке зберігає подію, доки вона не буде використана приймачем Flume. Цей канал може використовувати локальну файлову систему для зберігання цих подій.
- Приймач Flume видаляє подію з каналу та зберігає її у зовнішньому репозиторії, такому як HDFS. Може бути кілька агентів Flume, і в цьому випадку приймач Flume пересилає подію до джерела Flume наступного агента в потоці.
Деякі важливі характеристики Flume
- Flume має гнучку конструкцію, засновану на потоковій передачі даних. Він стійкий до відмов та надійний, з кількома механізмами перемикання на резервний рахунок та відновлення. Flume пропонує різні рівні надійності, включаючи "найкраща доставка" та "наскрізна доставка". Доставка найкращим способом не допускає жодних відмов вузла Flume, тоді як наскрізна доставка гарантує доставку навіть у разі відмови кількох вузлів.
- Flume передає дані між джерелами та приймачами. Цей збір даних може бути запланованим або керованим подіями. Flume має власний механізм обробки запитів, що дозволяє легко перетворювати кожну нову партію даних перед її переміщенням до цільового приймача.
- це можливо Лобові раковини включають HDFS та HBaseFlume також може передавати дані про події, такі як дані мережевого трафіку, дані, згенеровані веб-сайтами соціальних мереж та повідомленнями електронної пошти.
Налаштування каналу, бібліотеки та вихідного коду
Перш ніж ми почнемо безпосередньо процес, переконайтеся, що у вас встановлено Hadoop; якщо ні, продовжуйте роботу. як встановити Hadoop Спочатку змініть ім'я користувача на «hduser» (ідентифікатор, який використовувався під час налаштування Hadoop; ви можете переключитися на ідентифікатор користувача, який використовувався під час власного налаштування Hadoop).

Крок 1) Створіть новий каталог з назвою «FlumeTutorial».
sudo mkdir FlumeTutorial
- Надайте дозволи на читання, запис та виконання.
sudo chmod -R 777 FlumeTutorial
- Скопіюйте файли MyTwitterSource.java та MyTwitterSourceForFlume.java у цей каталог.
Завантажте вхідні файли звідси
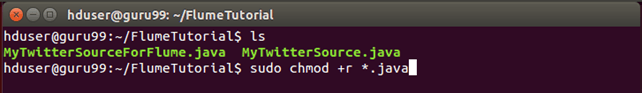
Перевірте дозволи на доступ до всіх цих файлів, як зазначено нижче, та надайте дозвіл на «читання», якщо він відсутній.
Крок 2) Завантажте «Apache Flume» з https://flume.apache.org/download.html.
Apache Flume 1.4.0 використовувався в цьому підручнику Flume.

Далі, клацніть, щоб знайти дзеркало.

Крок 3) Скопіюйте завантажений tar-архів у вибраний вами каталог та extracвміст за допомогою наступної команди.
sudo tar -xvf apache-flume-1.4.0-bin.tar.gz

Це створює новий каталог з назвою apache-flume-1.4.0-bin та extracts файли в нього. Цей каталог називається в решті статті.
Крок 4) Налаштування бібліотеки Flume. Скопіюйте twitter4j-core-4.0.1.jar, flume-ng-configuration-1.4.0.jar, flume-ng-core-1.4.0.jar та flume-ng-sdk-1.4.0.jar до
/lib/
Один або всі скопійовані JAR-файли можуть мати встановлений дозвіл на виконання, що може спричинити проблеми з компіляцією коду, тому скасуйте його. У моєму випадку twitter4j-core-4.0.1.jar мав дозвіл на виконання. Я скасував його, як показано нижче.
sudo chmod -x twitter4j-core-4.0.1.jar

Після цього, команда нижче надає дозвіл на «читання» для twitter4j-core-4.0.1.jar усім.
sudo chmod +rrr /usr/local/apache-flume-1.4.0-bin/lib/twitter4j-core-4.0.1.jar
Зверніть увагу, що я завантажив twitter4j-core-4.0.1.jar з Репозиторій Maven, та всі JAR-файли Flume, тобто flume-ng-*-1.4.0.jar, з артефакти org.apache.flume.
Завантажуйте дані з Twitter за допомогою Flume
Крок 1) Перейдіть до каталогу, що містить файли вихідного коду.
Крок 2) Встановити CLASSPATH як вміст /lib/* та ~/FlumeTutorial/flume/mytwittersource/*.
export CLASSPATH="/usr/local/apache-flume-1.4.0-bin/lib/*:~/FlumeTutorial/flume/mytwittersource/*"

Крок 3) Скомпілюйте вихідний код за допомогою команди нижче.
javac -d . MyTwitterSourceForFlume.java MyTwitterSource.java

Крок 4) Створіть JAR-файл. Спочатку створіть файл Manifest.txt за допомогою обраного вами текстового редактора та додайте до нього наведений нижче рядок.
Main-Class: flume.mytwittersource.MyTwitterSourceForFlume
Тут flume.mytwittersource.MyTwitterSourceForFlume — це назва основного класу. Зверніть увагу, що вам потрібно натиснути клавішу Enter в кінці цього рядка, як показано нижче.

Тепер створіть JAR-файл 'MyTwitterSourceForFlume.jar' наступним чином.
jar cfm MyTwitterSourceForFlume.jar Manifest.txt flume/mytwittersource/*.class

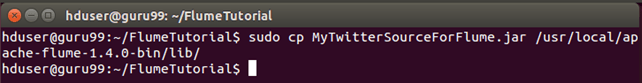
Крок 5) Скопіюйте цей JAR-файл до /бібліотека/.
sudo cp MyTwitterSourceForFlume.jar <Flume Installation Directory>/lib/
Крок 6) Перейдіть до каталогу конфігурації Flume, /конф.
Якщо файл flume.conf не існує, скопіюйте файл flume-conf.properties.template та перейменуйте його на flume.conf.
sudo cp flume-conf.properties.template flume.conf

Якщо файл flume-env.sh не існує, скопіюйте файл flume-env.sh.template та перейменуйте його на flume-env.sh.
sudo cp flume-env.sh.template flume-env.sh

Створення програми Twitter
Спочатку прочитайте це. Потокова передача версії 1.1 statuses/filter Кінцева точка, яка потрібна twitter4j 4.0.1, була виведена з експлуатації 9 березня 2023 року, а фільтрований потік API v2, який її замінив, тепер знаходиться за адресою developer.x.com, знаходиться за платним рівнем. Розглядайте екрани нижче як шаблон користувацького вихідного коду, а потім спрямуйте того ж агента на файл, виконуваний файл або вихідний код Kafka.
Крок 1) Створіть додаток Twitter, увійшовши на портал розробника.


Крок 2) Перейдіть до розділу «Мої програми» (ця опція випадає, коли натискається кнопка «Яйце» у верхньому правому куті).

Крок 3) Створіть нову програму, натиснувши кнопку «Створити нову програму».
Крок 4) Заповніть дані програми, вказавши назву програми, опис та веб-сайт. Ви можете звернутися до приміток, наведених під кожним полем введення.
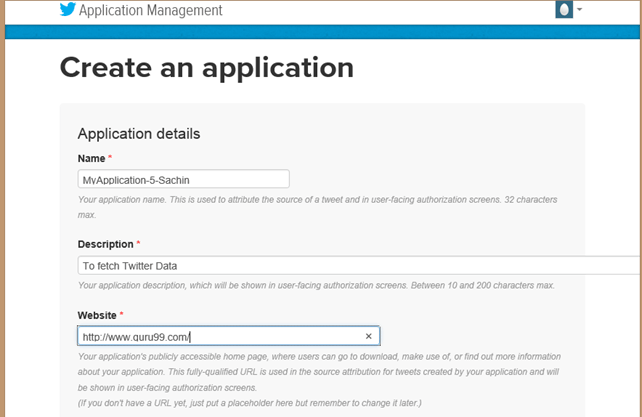
Крок 5) Прокрутіть сторінку вниз, прийміть умови, поставивши позначку «Так, я згоден», і натисніть кнопку «Створити свій додаток Twitter».

Крок 6) У вікні щойно створеної програми перейдіть на вкладку «Ключі API», прокрутіть сторінку вниз і натисніть кнопку «Створити мій токен доступу».


Крок 7) Оновіть сторінку.
Крок 8) Натисніть кнопку «Перевірити OAuth». Відобразяться налаштування «OAuth» програми.

Крок 9) Змініть 'flume.conf', використовуючи ці налаштування OAuth. Кроки для зміни 'flume.conf' наведено нижче.

Нам потрібно скопіювати ключ споживача, секрет споживача, токен доступу та секрет токена доступу, щоб оновити 'flume.conf'.
Примітка: Ці значення належать користувачеві, тому є конфіденційними, тому їх не слід розголошувати.
Змініть файл 'flume.conf'
Крок 1) Відкрийте 'flume.conf' у режимі запису та встановіть значення для параметрів нижче.
sudo gedit flume.conf
Скопіюйте вміст нижче.
MyTwitAgent.sources = Twitter
MyTwitAgent.channels = MemChannel
MyTwitAgent.sinks = HDFS
MyTwitAgent.sources.Twitter.type = flume.mytwittersource.MyTwitterSourceForFlume
MyTwitAgent.sources.Twitter.channels = MemChannel
MyTwitAgent.sources.Twitter.consumerKey = <Copy consumer key value from Twitter App>
MyTwitAgent.sources.Twitter.consumerSecret = <Copy consumer secret value from Twitter App>
MyTwitAgent.sources.Twitter.accessToken = <Copy access token value from Twitter App>
MyTwitAgent.sources.Twitter.accessTokenSecret = <Copy access token secret value from Twitter App>
MyTwitAgent.sources.Twitter.keywords = guru99
MyTwitAgent.sinks.HDFS.channel = MemChannel
MyTwitAgent.sinks.HDFS.type = hdfs
MyTwitAgent.sinks.HDFS.hdfs.path = hdfs://localhost:54310/user/hduser/flume/tweets/
MyTwitAgent.sinks.HDFS.hdfs.fileType = DataStream
MyTwitAgent.sinks.HDFS.hdfs.writeFormat = Text
MyTwitAgent.sinks.HDFS.hdfs.batchSize = 1000
MyTwitAgent.sinks.HDFS.hdfs.rollSize = 0
MyTwitAgent.sinks.HDFS.hdfs.rollCount = 10000
MyTwitAgent.channels.MemChannel.type = memory
MyTwitAgent.channels.MemChannel.capacity = 10000
MyTwitAgent.channels.MemChannel.transactionCapacity = 1000

Крок 2) Також встановіть TwitterAgent.sinks.HDFS.hdfs.path, як зазначено нижче.
TwitterAgent.sinks.HDFS.hdfs.path = hdfs:// : / /flume/твіти/

Знайти , і див. значення параметра 'fs.defaultFS', встановленого в $HADOOP_HOME/etc/hadoop/core-site.xml, наведене нижче.

Крок 3) Щоб скидати дані до HDFS одразу після їх надходження, видаліть запис нижче, якщо він існує.
TwitterAgent.sinks.HDFS.hdfs.rollInterval = 600
Приклад: потокова передача даних Twitter за допомогою Flume
Крок 1) Відкрийте 'flume-env.sh' у режимі запису та встановіть значення для параметрів нижче.
JAVA_HOME=<Installation directory of Java>
FLUME_CLASSPATH="<Flume Installation Directory>/lib/MyTwitterSourceForFlume.jar"

Крок 2) Запустіть Hadoop.
$HADOOP_HOME/sbin/start-dfs.sh
$HADOOP_HOME/sbin/start-yarn.sh
Крок 3) Два JAR-файли з tar-архіву Flume несумісні з Hadoop 2.2.0, тому в цьому прикладі Apache Flume ми виконуємо наведені нижче кроки, щоб зробити Flume сумісним з Hadoop 2.2.0. Ця заміна JAR-файлів є виправленням епохи 1.4.0; Flume 1.11.0 вже постачає поточні збірки protobuf та Guava, тому сучасному tar-архіву зазвичай нічого з цього не потрібно.
a. Перемістіть protobuf-java-2.4.1.jar з ' /lib'. Спочатку перейдіть до цього каталогу.
компакт-диск /lib
sudo mv protobuf-java-2.4.1.jar ~/

b. Знайдіть JAR-файл «guava», як показано нижче.
find . -name "guava*"

Перемістіть guava-10.0.1.jar з папки ' /ліб'.
sudo mv guava-10.0.1.jar ~/

c. Завантажте guava-17.0.jar з Репозиторій Maven, показано нижче.

Тепер скопіюйте цей завантажений JAR-файл до ' /ліб'.
Крок 4) Перейти до ' /bin' та запустіть Flume наступним чином.
./flume-ng agent -n MyTwitAgent -c conf -f <Flume Installation Directory>/conf/flume.conf

Вікно командного рядка, де Flume отримує твіти, виглядає ось так.

З повідомлення командного вікна ми бачимо, що вивід записується в каталог /user/hduser/flume/tweets/. Тепер відкрийте цей каталог за допомогою веббраузера.
Крок 5) Щоб побачити результат завантаження даних, відкрийте http://localhost:50070/ у браузері, перегляньте файлову систему, а потім перейдіть до каталогу, куди було завантажено дані, тобто
/flume/твіти/
Порт 50070 – це веб-інтерфейс NameNode на Hadoop 2; Hadoop 3 перемістив ту саму сторінку на порт 9870.

Флюм — це половина ковтання: Скуп імпортує таблиці пакетами, Flume транслює події, а потім Свиня or Вулик сформувати файли та Озі планує ланцюг. Див. також інструменти для аналізу великих даних, З'єднання та лічильники MapReduce та Таленд.
