
Підручник з Apache Oozie: Діаграма робочого процесу, Планувальник
 Прафулла Ранадіве
⚡ Розумний підсумок
Apache Oozie — це планувальник робочих процесів для Hadoop, який запускає залежні завдання як спрямовані ациклічні графи, поєднуючи механізм робочих процесів для дій MapReduce, Pig та Hive з механізмом координатора, керованим часом та доступністю даних.
Що таке Апачі Оозі?
Apache Oozie — це планувальник робочих процесів для HadoopЦе система, яка запускає робочий процес залежних завдань. Тут користувачам дозволено створювати спрямовані ациклічні графи робочих процесів, які можна запускати паралельно та послідовно в Hadoop.
Він складається з двох частин:
- Механізм робочого процесу: Обов'язком механізму робочих процесів є зберігання та виконання робочих процесів, що складаються із завдань Hadoop, наприклад, MapReduce, Свиня, Вулик.
- Координатор двигуна: Він запускає завдання робочого процесу на основі попередньо визначених розкладів та наявності даних.
Oozie масштабований і може керувати своєчасним виконанням тисяч робочих процесів (кожен з яких складається з десятків завдань) у кластері Hadoop. На діаграмі нижче показано, де планувальник знаходиться відносно кластера та завдань, які він керує.

Oozie також дуже гнучкий. Ви можете легко запускати, зупиняти, призупиняти та повторно запускати завдання. Oozie значно спрощує повторний запуск невдалих робочих процесів. Легко зрозуміти, як важко надолужити пропущені або невдалі завдання через простої чи збої. Можна навіть пропустити певний вузол, що вийшов з ладу.
Статус проекту: Apache Software вивела з експлуатації Apache Oozie. Foundation у лютому 2025 року та переїзд до Апачі Аттік завершено у квітні 2025 року. Фінальний реліз залишається 5.2.1 від лютого 2021 року, а репозиторій вихідного коду тепер доступний лише для читання. Існуючі кластери все ще використовують його, тому варто знати наведені нижче механізми, але нові конвеєри зазвичай будуються на Apache Airflow.
Як працює Оозі?
Oozie працює як сервіс у кластері, а клієнти надсилають визначення робочого процесу для негайної або пізнішої обробки.
Робочий процес Oozie складається з вузлів дій та вузлів керування потоком.
Вузол дії представляє завдання робочого процесу, наприклад, переміщення файлів у HDFS, запуск завдання MapReduce, Pig або Hive, імпорт даних за допомогою Скупабо запуск скрипта оболонки чи програми, написаної на Java.
Вузол керування потоком контролює виконання робочого процесу між діями, дозволяючи використовувати конструкції, такі як умовна логіка, де різні гілки можуть бути виконані залежно від результату попереднього вузла дії.
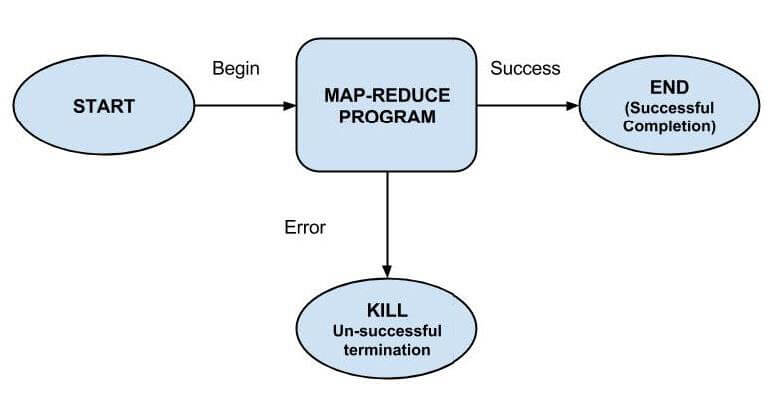
Початковий вузол, кінцевий вузол та вузол помилки належать до цієї категорії вузлів.
- Почати вузол позначає початок завдання робочого процесу.
- Кінцевий вузол сигналізує про закінчення роботи.
- Вузол помилок позначає виникнення помилки та відповідне повідомлення про помилку, яке має бути надруковано.
Після завершення виконання робочого процесу Oozie використовує зворотний виклик HTTP для оновлення статусу робочого процесу клієнту. Вхід до вузла дії або вихід з нього також може ініціювати зворотний виклик.
Вузли керування Oozie та типи дій
Окрім початку, кінця та помилки, XML робочого процесу підтримує невеликий словник керуючих вузлів, які формують граф.
- рішення: Обчислює вираз і надсилає робочий процес вниз по одній з кількох гілок, еквівалент оператора switch.
- вилка: Розділяє шлях таким чином, щоб дві або більше дій виконувалися паралельно.
- приєднатися: Очікує завершення кожної гілки відповідної розгалуження, перш ніж продовжити.
- вбити: Негайно завершує робочий процес і записує повідомлення про помилку.
Вузли дій охоплюють саму роботу, і кожен має свій власний XML-елемент:
- map-reduce, pig, hive та sqoop дії запускають відповідне завдання Hadoop.
- Ява запускає основний клас на кластері; оболонка та SSH запускати скрипти.
- fs виконує прибирання HDFSping такі як переміщення, видалення, mkdir та chmod.
- e-mail повідомляє одержувачів, і підробочий процес викликає іншу програму робочого процесу.
Приклад схеми робочого процесу
Діаграма нижче tracвиконує невеликий робочий процес від початкового вузла через дію MapReduce до кінцевого вузла або шляху помилки, коли дія не вдається.
Типи вакансій в Оозі
Оозі описує роботу на трьох рівнях. Кожен шар огортає нижчий, тому пакет зрештою контролює багато окремих робочих процесів.
| Тип роботи | Що це визначає | Спрацьовує |
|---|---|---|
| Workflow | Орієнтований ациклічний граф вузлів дій та керування, записаний у workflow.xml | Ручне подання або подання координатором |
| Координатор | Повторюваний графік для одного робочого процесу з часом початку, часом завершення та частотою | Доступність часу та вхідних даних |
| Пакет | Колекція програм-координаторів, що керуються разом як один конвеєр даних | Час початку, що застосовується до всіх його координаторів |
Ця відмінність має значення на практиці: робочий процес відповідає на запитання «що виконується», координатор відповідає на запитання «коли виконується», а пакет відповідає на запитання «що починається і зупиняється разом».
Пакування та розгортання робочого застосунку Oozie
Програма робочого процесу складається з визначення робочого процесу та всіх пов'язаних з ним ресурсів, таких як файли MapReduce JAR, скрипти Pig тощо. Програми повинні дотримуватися простої структури каталогів та розгортатися на HDFS, щоб Oozie мав до них доступ.
Приклад структури каталогів показано нижче:
<name of workflow>/
├── lib/
│   └── hadoop-examples.jar
└── workflow.xml
Необхідно зберігати workflow.xml (файл визначення робочого процесу) у каталозі верхнього рівня (батьківському каталозі, що містить назву робочого процесу). Каталог lib містить файли Jar, що містять класи MapReduce. Програму робочого процесу, що відповідає цьому макету, можна зібрати за допомогою будь-якого інструменту збірки, наприклад, Ant або Maven.
Таку збірку потрібно скопіювати на HDFS за допомогою команди, наприклад:
% hadoop fs -put hadoop-examples/target/<name of workflow dir> name of workflow
Кроки для запуску робочого процесу Oozie
У цьому розділі ми побачимо, як запустити завдання робочого циклу. Щоб запустити це, ми скористаємося інструментом командного рядка Oozie (клієнтська програма, яка спілкується з сервером Oozie).
1. Експорт OOZIE_URL змінна середовища, яка повідомляє команді oozie, який сервер Oozie використовувати (тут ми використовуємо той, що працює локально):
% export OOZIE_URL="http://localhost:11000/oozie"
2. Запустіть завдання робочого процесу, використовуючи:
% oozie job -config ch05/src/main/resources/max-temp-workflow.properties -run
Параметр -config відноситься до локального Java файл властивостей, що містить визначення параметрів у XML-файлі робочого процесу, а також oozie.wf.application.path, який повідомляє Oozie розташування програми робочого циклу в HDFS.
Приклад вмісту файлу властивостей:
nameNode=hdfs://localhost:8020
jobTracker=localhost:8021
oozie.wf.application.path=${nameNode}/user/${user.name}/<name of workflow>
3. Отримати стан завдання робочого процесу.
Стан завдання робочого процесу можна побачити за допомогою підкоманди 'job' з параметром '-info', вказавши ідентифікатор завдання після '-info'.
e.g., % oozie job -info <job id>
Вивід показує один із станів: RUNNING, KILLED або SUCCEEDED.
4. Результати успішного виконання робочого процесу можна побачити за допомогою команди Hadoop, наприклад:
% hadoop fs -cat <location of result>
Навіщо використовувати Oozie?
Основна мета використання Oozie — керування різними типами завдань, що обробляються в системі Hadoop.
Залежності між завданнями визначаються користувачем у вигляді спрямованих ациклічних графів. Oozie використовує цю інформацію та піклується про їх виконання у правильному порядку, як зазначено в робочому процесі. Таким чином, користувачеві економиться час на управління повним робочим процесом. Крім того, Oozie має можливість вказувати частоту виконання певного завдання.
Особливості Oozie
- Oozie має клієнтський API та інтерфейс командного рядка, які можна використовувати для запуску, керування та моніторингу завдань з Java Додаток.
- Використовуючи API веб-сервісів, можна керувати завданнями з будь-якого місця.
- Oozie має можливість виконувати завдання, заплановані на періодичне виконання.
- Oozie має можливість надсилати сповіщення електронною поштою після завершення завдань.
Повітряний потік Oozie проти Apache
Оскільки Oozie вже не підтримується, більшість команд, які оцінюють планувальники сьогодні, порівнюють те, що вони вже використовують, з Apache Airflow. Ці два інструменти вирішують одну й ту саму проблему з протилежних боків.
| Аспект | Apache Oozie | Потік повітря Apache |
|---|---|---|
| Мова визначення | Робочі процеси, написані у форматі XML | DAG, записані як Python код |
| Сфера | Побудовано на основі дій Hadoop, таких як MapReduce, Pig, Hive та Sqoop | Загального призначення, з операторами для хмарних сервісів, баз даних та контейнерів |
| Планування | Робота координатора, зумовлена наявністю часу та даних | Інтервали планування плюс датчики, які очікують на зовнішні умови |
| Статус проекту | Перенесено на горище Apache у 2025 році; остаточний реліз 5.2.1 | Активно розроблений проект верхнього рівня для Apache |
Oozie залишається простішим варіантом на кластері, який вже його використовує, оскільки дії взаємопов'язані з компонентами Hadoop. Airflow — це практичний вибір для будь-чого нового, особливо там, де конвеєр виходить за межі Hadoop.
