
Denetimsiz Makine Öğrenimi: AlgorithmsTürler ve Örnekler
 Editoryal Takım
⚡ Akıllı Özet
Denetimsiz Öğrenme, etiketlenmemiş veriler üzerinde çalışan bir makine öğrenme tekniğidir; modelin önceden verilen yanıtlardan ziyade kümeleme, ilişkilendirme kuralları ve boyut indirgeme yoluyla kendi başına yapıyı keşfetmesine olanak tanır.
Denetimsiz Öğrenme Nedir?
Denetimsiz Öğrenme, kullanıcının modeli denetlemesine gerek olmadığı bir makine öğrenme tekniğidir. Bunun yerine, modelin daha önce tespit edilmemiş kalıpları ve bilgileri keşfetmek için kendi başına çalışmasına olanak tanır. Esas olarak etiketlenmemiş verilerle ilgilenir.
Denetimsiz Öğrenme Algorithms
Denetimsiz Öğrenme Algorithms kullanıcılara daha karmaşık işlem görevlerini gerçekleştirme olanağı sağlar. denetimli öğrenmeAncak, denetimsiz öğrenme, bilinen cevaplara göre eğitilmiş yöntemlere kıyasla daha tahmin edilemez olabilir. Denetimsiz öğrenme algoritmaları arasında kümeleme, anomali tespiti, boyut indirgeme ve kendi kendini organize eden sinir ağları yer alır.
Denetimsiz Makine Öğrenimi Örneği
Bebek ve aile köpeği için gözetimsiz öğrenmeye bir örnek verelim. İlk resimde bebeğin zaten tanıdığı evcil hayvan görülüyor.
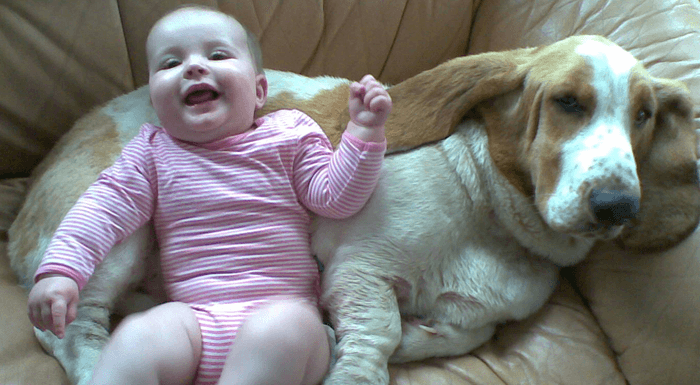
Bu köpeği tanıyor ve teşhis ediyor. Birkaç hafta sonra bir aile dostu bir köpek getiriyor ve bebekle oynamaya çalışıyor. Aşağıda bu ikinci, yabancı köpek gösteriliyor.
Bebek bu köpeği daha önce görmemişti. Ancak birçok özelliğinin (2 kulak, gözler, 4 ayak üzerinde yürüme) kendi evcil köpeğine benzediğini fark etti. Yeni hayvanı köpek olarak tanımladı. Bu, denetimsiz öğrenmedir; yani size bir şey öğretilmez, verilerden (bu durumda bir köpek hakkındaki verilerden) öğrenirsiniz. Eğer bu denetimli öğrenme olsaydı, yukarıdaki Denetimsiz Öğrenme örneğinde gösterildiği gibi, aile dostu bebeğe bunun bir köpek olduğunu söylerdi.
Neden Denetimsiz Öğrenme?
İşte denetimsiz öğrenmenin kullanılmasının başlıca nedenleri. Makine öğrenmesi:
- Denetimsiz makine öğrenimi, verilerdeki her türlü bilinmeyen örüntüyü bulur.
- Denetimsiz yöntemler, kategorizasyon için yararlı olabilecek özellikleri bulmanıza yardımcı olur.
- Veriler gelir gelmez işleme alabilir, bu nedenle gelen kayıtlar insan müdahalesi olmadan analiz edilip gruplandırılabilir.
- Etiketsiz verileri bilgisayardan almak, manuel müdahale gerektiren etiketli verilere göre daha kolaydır.
ClusterDenetimsiz Öğrenme Türleri Algorithms
Denetimsiz öğrenme problemleri, kümeleme, ilişkilendirme ve boyut indirgeme problemleri olarak alt gruplara ayrılır. ClusterGruplandırma, benzer kayıtları bir araya getirir; ilişkilendirme, birlikte görünen öğeleri bulur; boyut indirgeme ise birçok özelliği birkaç özelliğe sıkıştırır.
Clustering
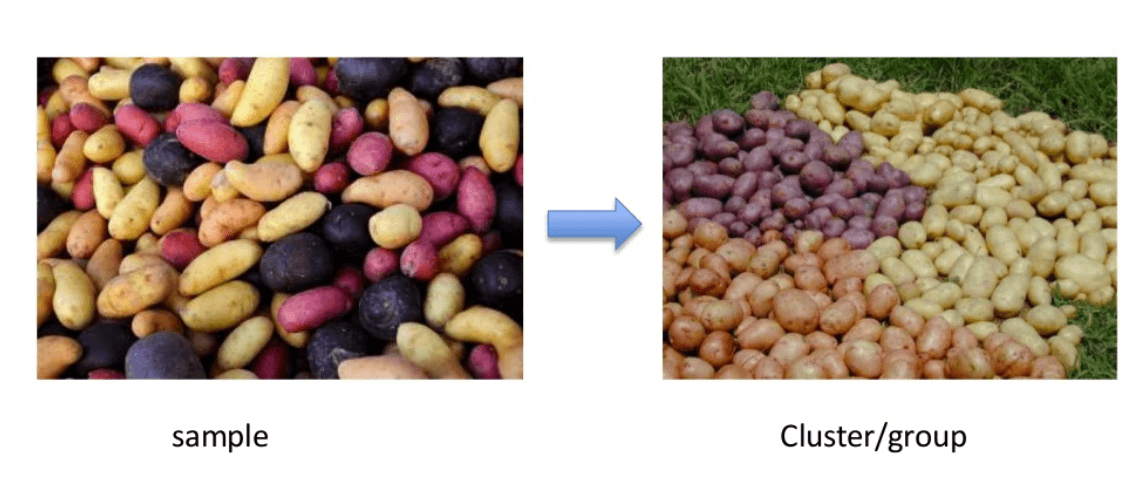
ClusterDenetimsiz öğrenme söz konusu olduğunda öğrenme önemli bir kavramdır. Temel olarak kategorize edilmemiş verilerden oluşan bir koleksiyonda bir yapı veya model bulmakla ilgilenir. Denetimsiz Öğrenme ClusterAlgoritmalar verilerinizi işleyecek ve verilerde varsa doğal kümeleri (grupları) bulacaktır. Algoritmalarınızın kaç küme belirlemesi gerektiğini de değiştirebilirsiniz. Bu, grupların ayrıntı düzeyini ayarlamanıza olanak tanır. Aşağıdaki diyagram, dağınık kayıtların ayrı gruplara nasıl ayrıldığını göstermektedir.
Kullanabileceğiniz farklı kümeleme türleri vardır:
Özel (bölümleme)
Bu kümeleme yönteminde, veriler her bir kaydın yalnızca bir kümeye ait olabileceği şekilde gruplandırılır.
Örnek: K-anlamı
Aglomeratif
Bu kümeleme tekniğinde, her kayıt kendi başına bir küme olarak başlar. En yakın iki küme arasındaki yinelemeli birleşimler, küme sayısını azaltır.
Örnek: Hiyerarşik kümeleme
üst üste gelmeping
Bu teknikte, bulanık kümeler Verileri kümelemek için kullanılırlar. Her nokta, farklı üyelik dereceleriyle iki veya daha fazla kümeye ait olabilir.
Burada veriler uygun bir üyelik değeriyle ilişkilendirilecektir. Örnek: Bulanık C-Ortalamalar
Olasılık
Bu teknik, kümeleri oluşturmak için olasılık dağılımını kullanır.
Örnek: Aşağıdaki anahtar kelimeler
- "Erkek ayakkabısı."
- “kadın ayakkabısı.”
- “kadın eldiveni.”
- "Erkek eldiveni."
Bunlar "ayakkabı" ve "eldiven" veya "erkek" ve "kadın" olmak üzere iki kategoriye ayrılabilir.
ClusterTürler
Aşağıda, denetimsiz makine öğreniminde en sık karşılaşılan algoritmalar yer almaktadır. İlk iki algoritma kayıtları gruplandırırken, son üç algoritma küme oluşturmaktan ziyade boyutları azaltır ve K-NN algoritması, K-means ile sıklıkla karıştırıldığı için listelenmiştir.
- Hiyerarşik kümeleme — kümeleme
- K-ortalama kümeleme — kümeleme
- K-NN (k en yakın komşu) — denetimli bir sınıflandırıcıdır, kümeleme yöntemi değildir.
- Temel Bileşen Analizi — boyut indirgeme
- Tekil Değer Ayrıştırması — boyut indirgeme
- Bağımsız Bileşen Analizi — boyut indirgeme
Hiyerarşik Clustering
Hiyerarşik kümeleme, kümeler arasında bir hiyerarşi oluşturan bir algoritmadır. Tüm verilerin kendi kümesine atanmasıyla başlar. Burada, birbirine yakın iki küme aynı kümede birleştirilir. Bu algoritma, yalnızca bir küme kalana kadar devam eder. Ayrı ayrı adlandırılmaya değer iki temel fikri tanımlar.
Aglomeratif kümeleme
Bu aşağıdan yukarıya doğru işleyen hiyerarşik kümeleme yöntemi, girdi olarak küme sayısı K'yı gerektirmez. Birleştirme süreci, her kaydı tek bir küme olarak oluşturarak başlar.
Bu yöntem, bir mesafe ölçüsü kullanır ve birleştirme işlemiyle küme sayısını (her yinelemede bir) azaltır. Sonuç olarak, tüm nesneleri içeren büyük bir kümemiz olur ve analist, ağacı mantıklı sayıda grup veren yükseklikte keser.
Dendrogram
Dendrogram kümeleme yönteminde, her seviye olası bir kümeyi temsil eder. Dendrogramın yüksekliği, birleştirilen iki küme arasındaki benzerlik seviyesini gösterir. İşlemin alt kısmına ne kadar yakınlarsa, kümeler o kadar benzerdir; nihai grupları tanımlayan kesimin seçimi otomatik değildir ve çoğunlukla özneldir.
K-anlamı Clustering
K-means, grupları iyileştirerek kümeleme işlemini gerçekleştiren yinelemeli bir algoritmadır.ping Her yinelemede. Başlangıçta, istenen küme sayısı seçilir. Bu kümeleme yönteminde, veri noktalarını k gruba ayırmanız gerekir. Daha büyük bir k, daha fazla ayrıntı düzeyine sahip daha küçük gruplar anlamına gelir; daha küçük bir k ise daha az ayrıntı düzeyine sahip daha büyük gruplar anlamına gelir.
Algoritmanın çıktısı bir grup "etiket"tir. Her veri noktasını k gruptan birine atar. K-ortalama kümelemesinde, her grup o grup için bir merkez noktası oluşturularak tanımlanır. Merkez noktaları, kümenin kalbi gibidir; kendilerine en yakın noktaları yakalar ve kümeye ekler.
K- En yakın komşular
K-en yakın komşu, tüm makine öğrenimi sınıflandırıcılarının en basitidir. Diğer makine öğrenimi tekniklerinden farklı olarak bir model üretmez. Mevcut tüm örnekleri depolayan ve yeni örnekleri bir benzerlik ölçüsüne göre sınıflandıran basit bir algoritmadır. Sınıflandırma için etiketlenmiş örneklere ihtiyaç duyduğu için K-NN denetimli bir yöntemdir; burada sadece mesafe tabanlı mantığı kümelemeye benzediği için yer almaktadır.
Örnekler arasında anlamlı bir mesafe olduğunda çok iyi çalışır. Eğitim veri seti büyük olduğunda öğrenme hızı yavaşlar ve mesafe hesaplaması karmaşık hale gelir.
Temel bileşenler Analizi
Temel Bileşen Analizi, yüksek boyutlu bir uzayı ele alır ve yeni bir temel seçer,ping Sadece en önemli puanlarını alır. Bu temeldeki her yön, ana bileşen olarak bilinir. Sakladığınız alt küme, orijinal alana kıyasla küçük boyutlu yeni bir alan oluşturur. Verilerin karmaşıklığının mümkün olduğunca çoğunu korur.
Dernek
İlişkilendirme kuralları, büyük veritabanlarındaki veri nesneleri arasında ilişkiler kurmanıza olanak tanır. Bu denetimsiz teknik, büyük veritabanlarındaki değişkenler arasında ilginç ilişkiler keşfetmekle ilgilidir ve temel bir yöntemdir. veri madenciliğiÖrneğin, yeni bir ev satın alan kişilerin yeni mobilya satın alma olasılığı daha yüksektir.
Diğer Örnekler:
- Gen ekspresyon ölçümlerine göre gruplandırılmış kanser hastalarının bir alt grubu.
- Alışveriş yapanların internette gezinme ve satın alma geçmişlerine göre gruplandırılması
- Filmler, izleyiciler tarafından verilen puanlara göre gruplandırılmıştır.
Denetimli ve Denetimsiz Makine Öğrenimi Karşılaştırması
İşte arasındaki temel fark Denetimli ve Denetimsiz Öğrenme Karşılaştırması:
| Parametreler | Denetimli makine öğrenimi tekniği | Denetimsiz makine öğrenimi tekniği |
| Giriş Verileri | Algorithms etiketlenmiş veriler kullanılarak eğitilir. | Algorithms etiketlenmemiş verilere karşı kullanılır |
| Hesaplamalı Karmaşıklık | Denetimli öğrenme daha basit bir yöntemdir. | Gözetimsiz öğrenme hesaplama açısından karmaşıktır |
| doğruluk | Doğruluk, bilinen etiketlere göre doğrudan ölçülebilir. | Doğruluk doğrudan ölçülemez; sonuçların yorumlanması gerekir. |
| Tipik çıktı | Her yeni rekor için bir tahmin. | Gruplar, kurallar veya sıkıştırılmış özellikler |
Denetimsiz Makine Öğrenimi Uygulamaları
Denetimsiz Öğrenme Tekniklerinin bazı uygulama alanları şunlardır:
- ClusterBu işlem, veri setini benzerliklerine göre otomatik olarak gruplara ayırır.
- Anormallik tespiti, veri kümenizdeki olağandışı veri noktalarını keşfedebilir. Hileli işlemleri bulmak için kullanışlıdır
- İlişkilendirme madenciliği, veri kümenizde sıklıkla bir arada bulunan öğe kümelerini tanımlar
- Gizli değişken modelleri, veri ön işleme süreçlerinde, örneğin bir veri kümesindeki özellik sayısını azaltmak veya veri kümesini birden fazla bileşene ayırmak gibi uygulamalarda yaygın olarak kullanılmaktadır.
Denetimsiz Öğrenmenin Dezavantajları
- Veri sıralamasıyla ilgili kesin bilgi edinemezsiniz, çünkü denetimsiz öğrenmede kullanılan veriler etiketlenmemiş verilerdir ve gerçek gruplama verileri belirsizdir.ping bilinmiyor
- Less Sonuçların doğruluğu sınırlıdır, çünkü girdi verileri önceden bilinmiyor ve insanlar tarafından etiketlenmiyor. Bu da makinenin bunu kendi başına yapması gerektiği anlamına gelir.
- Spektral sınıflar her zaman bilgi sınıflarına karşılık gelmez.
- Kullanıcının, sınıflandırmadan kaynaklanan sınıfları yorumlamak ve etiketlemek için zaman ayırması gerekiyor.
- Sınıfların spektral özellikleri de zamanla değişebilir, bu nedenle bir görüntüden diğerine geçerken aynı sınıf bilgilerini koruyamazsınız.
