
Denetimli Makine Öğrenimi: Algorithms, Türler ve Örnekler
 Evelyn Clarke
⚡ Akıllı Özet
Denetimli Makine Öğrenimi, sayısal hedefler için regresyon, spam veya dolandırıcılık gibi kategori hedefleri için ise sınıflandırma kullanarak, daha önce hiç görmediği veriler için sonuçları tahmin edebilmesi amacıyla etiketlenmiş örnekler üzerinde bir algoritmayı eğitir.
Denetimli Makine Öğrenimi Nedir?
Denetimli Makine Öğrenimi, öngörülemeyen veriler için sonuçları tahmin etmenize yardımcı olmak amacıyla etiketlenmiş eğitim verilerinden öğrenen bir algoritmadır. Denetimli öğrenmede, makineyi iyi "etiketlenmiş" veriler kullanarak eğitirsiniz. Bu, bazı verilerin zaten doğru cevaplarla etiketlendiği anlamına gelir. Bir gözetmen veya öğretmenin varlığında öğrenmeye benzetilebilir.
Doğru denetimli makine öğrenimi modellerini başarıyla oluşturmak, ölçeklendirmek ve dağıtmak, yüksek vasıflı veri bilimcilerinden oluşan bir ekibin zamanını ve teknik uzmanlığını gerektirir. Veri bilimcileri ayrıca, ürettikleri içgörülerin temel veriler değiştikçe doğru kalması için modelleri periyodik olarak yeniden oluşturmalıdır.
Denetimli Öğrenme Nasıl Çalışır?
Denetimli makine öğrenimi, istenen sonuçları elde etmek için eğitim veri kümelerini kullanır. Bu veri setleri, modelin daha hızlı öğrenmesine yardımcı olan girdileri ve doğru çıktıları içerir. Örneğin, iş yerinizden eve arabayla gitmenizin ne kadar süreceğini tahmin etmenize yardımcı olması için bir makineyi eğitmek istiyorsunuz.
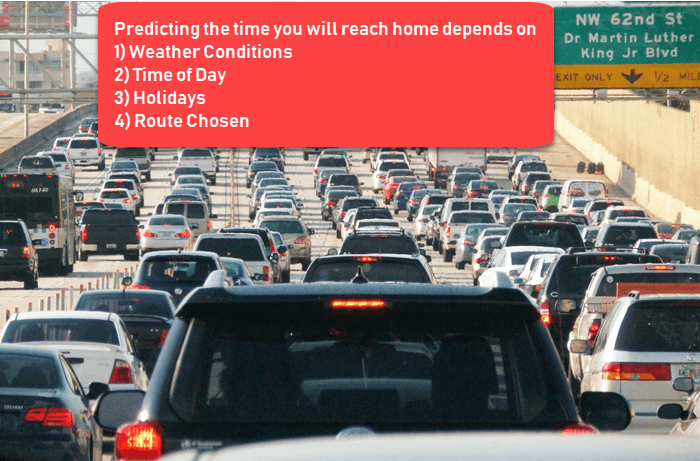
Burada bir dizi etiketli veri oluşturarak başlarsınız. Bu veriler şunları içerir:
- Hava koşulları
- Günün saati
- Tatil
- Seçilen rota
Bu örnekte, tüm bu detaylar sizin girdilerinizdir. Çıktı ise aşağıdaki resimde gösterildiği gibi, o gün eve geri dönmenin ne kadar sürdüğüdür.
Dışarıda yağmur yağıyorsa eve arabayla gitmenin daha uzun süreceğini içgüdüsel olarak bilirsiniz. Ancak makinenin verilere ve istatistiklere ihtiyacı var.
Öncelikle bir eğitim seti oluşturmanız gerekiyor. Bu set, toplam işe gidiş-dönüş süresini ve hava durumu, zaman vb. gibi ilgili faktörleri içerecektir. Bu eğitim setine dayanarak, makineniz yağmur miktarı ile eve ulaşmanız için gereken süre arasında doğrudan bir ilişki olduğunu görebilir.
Yani, yağmur ne kadar çok yağarsa, eve dönüş yolculuğunuzun o kadar uzun süreceğini tespit ediyor. Ayrıca, işten çıkış saatiniz ile yolda geçireceğiniz süre arasında da bir bağlantı kurabilir. Saat 18:00'e ne kadar yakınsanız, eve ulaşmanız o kadar uzun sürer.
Makineniz, etiketlenmiş verilerinizle bazı ilişkiler kurabilir. Bu öğrenme aşaması aşağıda gösterilmiştir.
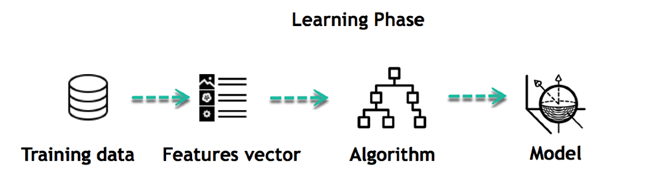
Bu, Veri Modelinizin başlangıcıdır. Yağmurun insanların araç kullanma şeklini nasıl etkilediğini ve günün belirli bir saatinde daha fazla insanın seyahat ettiğini kaydetmeye başlar.
Denetimli Makine Öğrenimi Türleri Algorithms
Aşağıda Gözetimli Makine Öğrenmesi algoritmalarının türleri listelenmiştir:
Gerileme
Regresyon tekniği, eğitim verilerini kullanarak tek bir sürekli çıktı değeri tahmin eder.
Örnek: Eğitim verilerinden ev fiyatını tahmin etmek için regresyonu kullanabilirsiniz. Girdi değişkenleri konum, evin büyüklüğü vb. olacaktır.
Avantajları: Çıktıların yorumlanması kolaydır ve algoritma aşırı uyumdan kaçınmak için düzenlenebilir.
Zayıf yönleri: Doğrusal bir model esnek değildir, bu nedenle ek özellikler olmadan karmaşık ilişkileri yakalayamaz.
İşte birkaç Regresyon türü: Algorithms:
- Doğrusal regresyon
- Polinom regresyon
- Ridge ve Lasso regresyonu
- Lojistik regresyon (sınıflandırma için)
- Karar ağacı ve rastgele orman regresyonu
- Destek vektör regresyonu
Lojistik regresyon:
Lojistik regresyon, belirli bir bağımsız değişken kümesine dayalı olarak ayrık değerleri tahmin etmek için kullanılır. Verileri bir logit fonksiyonuna uydurarak bir olayın meydana gelme olasılığını tahmin etmenize yardımcı olur. Bu nedenle, logit regresyonu olarak da bilinir. Bir olasılığı tahmin ettiği için, çıktı değeri 0 ile 1 arasında yer alır ve birden fazla veya doğrusal olmayan karar sınırları olduğunda yetersiz performans gösterebilir.
Sınıflandırma
Sınıflandırma, çıktıyı bir sınıf içinde gruplandırmak anlamına gelir. Algoritma girdiyi iki farklı sınıfa ayırmaya çalışıyorsa, buna ikili sınıflandırma denir. İkiden fazla sınıf arasında seçim yapmak ise çok sınıflı sınıflandırma olarak adlandırılır.
Örnek: Bir kişinin kredi borcunu ödememe durumunun olup olmayacağının belirlenmesi.
Güçlü Yönleri: Sınıflandırma ağaçları pratikte çok iyi performans gösterir.
Zayıf yönleri: Kısıtlanmamış olduklarından, bireysel ağaçlar aşırı uyum sorununa yatkındır.
İşte birkaç sınıflandırma türü: Algorithms:
- Naive Bayes sınıflandırıcıları
- Karar ağaçları
- Destek Vektör Makinesi
- K-En Yakın Komşular
- Rastgele orman ve gradyan artırma
Naive Bayes Sınıflandırıcıları
MKS Naif bayanlar Bu modelin oluşturulması kolaydır ve büyük veri kümeleri için çok kullanışlıdır. Bu yöntem, bir ebeveyn ve birkaç çocuktan oluşan yönlendirilmiş döngüsel olmayan grafiklerden oluşur. Çocuk düğümlerinin ebeveynlerinden bağımsız olduğunu varsayar.
Karar ağaçları
Karar ağaçları, bir örneği özellik değerine göre sıralayarak sınıflandırır. Bu yöntemde, her düğüm sınıflandırılması gereken örneğin özelliğini, her dal ise düğümün alabileceği bir değeri temsil eder. Sınıflandırma için yaygın olarak kullanılan bir tekniktir.
Aynı yapı regresyon için de geçerlidir: bir regresyon ağacı, gerçek değerleri (araba satın alma maliyeti, çağrı sayısı, toplam aylık satışlar vb.) tahmin etmenize yardımcı olur.
Destek Vektör Makinesi
Destek Vektör Makinesi (SVM), 1990'larda ortaya çıkan bir öğrenme algoritması türüdür. Bu yöntem, Vladimir Vapnik ve meslektaşları tarafından geliştirilen istatistiksel öğrenme teorisinin sonuçlarına dayanmaktadır.
SVM'ler ayrıca çoğu öğrenme görevi için merkezi bir kavram olan çekirdek fonksiyonlarıyla da yakından bağlantılıdır. Çekirdek çerçevesi ve SVM'ler çeşitli alanlarda kullanılmaktadır. Bunlar arasında multimedya bilgi erişimi, biyoinformatik ve örüntü tanıma yer almaktadır. Yukarıdaki her bir tahminleyici, ayar parametreleriyle birlikte belgelenmiştir. scikit-öğrenme referans.
Denetimli ve Denetimsiz Makine Öğrenme Teknikleri
Yöntemi yanına yerleştirmek denetimsiz öğrenme Sınırlarını netleştiriyor.
| Dayalı | Denetimli makine öğrenimi tekniği | Denetimsiz makine öğrenimi tekniği |
|---|---|---|
| Giriş Verileri | Algorithms etiketlenmiş veriler kullanılarak eğitilir. | Algorithms etiketlenmemiş verilere karşı kullanılır |
| Hesaplamalı Karmaşıklık | Denetimli öğrenme daha basit bir yöntemdir. | Gözetimsiz öğrenme hesaplama açısından karmaşıktır |
| doğruluk | Son derece doğru ve güvenilir bir yöntem. | Less Doğru ve güvenilir yöntem. |
| Tipik algoritmalar | Lojistik regresyon, karar ağaçları, SVM, Naive Bayes | K-ortalamalar, hiyerarşik kümeleme, PCA |
| Sonuçlar nasıl değerlendirilir? | Bilinen yanıtlara göre puanlama (doğruluk, RMSE) | İçsel ölçütler ve insan değerlendirmesiyle değerlendirilmiştir. |
Denetimli Makine Öğreniminde Karşılaşılan Zorluklar
Denetimli makine öğreniminde karşılaşılan zorluklar şunlardır:
- Eğitim verilerindeki alakasız girdi özellikleri, hatalı sonuçlara yol açabilir.
- Veri hazırlama ve ön işleme her zaman zorlu bir iştir.
- Eğitim verisi olarak imkansız, olasılık dışı ve eksik değerler girildiğinde doğruluk oranı düşer.
- İlgili uzman müsait değilse, diğer yaklaşım "kaba kuvvet"tir. Bu, makineyi hangi özellikler (giriş değişkenleri) üzerinde eğiteceğinizi tahmin etmeniz gerektiği anlamına gelir ve bu tahmin yanlış olabilir.
Denetimli Öğrenmenin Avantajları
Bu zorluklara karşılık, denetimli makine öğreniminin avantajları şunlardır:
- Denetimli öğrenme Makine öğrenmesi Bu, önceki deneyimlerden veri toplamanıza veya veri çıktısı üretmenize olanak tanır.
- Deneyimi kullanarak performans kriterlerini optimize etmenize yardımcı olur
- Denetimli makine öğrenimi, çeşitli türdeki gerçek dünyadaki hesaplama problemlerini çözmenize yardımcı olur.
Denetimli Öğrenmenin Dezavantajları
Aşağıda denetimli makine öğreniminin dezavantajları yer almaktadır:
- Eğer eğitim veri setinizde bir sınıfta olmasını istediğiniz örnekler yoksa, karar sınırı aşırı eğitilmiş olabilir.
- Sınıflandırıcıyı eğitirken her sınıftan çok sayıda iyi örnek seçmeniz gerekir.
- Büyük veri kümelerini sınıflandırmak gerçek bir zorluk olabilir.
- Denetimli öğrenmeye yönelik eğitim, çok fazla hesaplama süresi gerektirir.
Denetimli Öğrenme İçin En İyi Uygulamalar
Aşağıdaki sıralama bir projenin devamlılığını sağlar. track:
- Başka bir şey yapmadan önce, eğitim seti olarak ne tür verilerin kullanılacağına karar verin.
- Öğrenilecek fonksiyonun yapısını ve öğrenme algoritmasını belirleyin.
- İlgili sonuçları insan uzmanlardan veya ölçümlerden toplayın.
- Modelin asla görmediği bir test veri setini ayırın ve bu set üzerindeki puanı bildirin.
