
Hadoop Pig Eğitimi: Apache Pig Nedir? Archidoku, Örnek
 Prafulla Ranadive
⚡ Akıllı Özet
Apache Pig, Hadoop üzerindeki büyük veri kümelerini analiz etmek için kullanılan üst düzey bir platformdur; Pig Latin veri akışı dilini, her bir betiği MapReduce, Tez veya diğer formatlara derleyen bir çalışma ortamıyla birleştirir. Spark işleri otomatik olarak.
Bu eğitim, Apache Pig'in ardındaki fikirle başlıyor, ardından kurulumunu ve baştan sona eksiksiz bir Pig Latin betiğinin çalıştırılmasını adım adım açıklıyor.
Apaçi Domuzu nedir?
Domuz yüksek seviyeli bir hayvandır. Programlama dili Büyük veri kümelerini analiz etmek için kullanışlıdır. Pig, Yahoo!'daki geliştirme çalışmalarının bir sonucuydu.
MapReduce çerçevesinde, programların bir dizi Map ve Reduce aşamasına dönüştürülmesi gerekir. Ancak bu, veri analistlerinin aşina olduğu bir programlama modeli değildir. Bu nedenle, bu açığı kapatmak için, bir abs yaklaşımı geliştirilmiştir.tracPig adlı yapı, onun üzerine inşa edildi. Hadoop'un.
Apache Pig, insanların büyük veri kümelerini analiz etmeye daha fazla odaklanmalarını ve MapReduce programları yazmaya daha az zaman ayırmalarını sağlar. Her şeyi yiyen domuzlara benzer şekilde, Apache Pig programlama dili her türlü veri üzerinde çalışmak üzere tasarlanmıştır. İşte bu yüzden adı Pig (Domuz)! Aşağıdaki proje maskotu da aynı noktayı vurguluyor.

Proje hala aktif. Apache Pig 0.18.0 15 Eylül 2025'te yayınlandı ve Hadoop 3, Tez 0.10 ve Hive 3 desteğini ekledi. Spark 3, HBase 2 ve Python 3'e göre Apache Pig sürümleri sayfasıAşağıdaki kılavuz, çok daha eski 0.12.1 sürümüne göre yazılmıştır; bu nedenle, mevcut sürümün farklı davrandığı bazı adımlarda not düşülmüştür.
Domuz Archidoku
Pig'in mimarisi iki bileşenden oluşmaktadır:
- Bozuk Latince, bu bir dildir
- Bir çalışma zamanı ortamı, Pig Latin programlarını çalıştırmak için.
Bir Pig Latin programı, girdi verilerine uygulanan ve çıktı üreten bir dizi işlem veya dönüşümden oluşur. Bu işlemler, Hadoop Pig yürütme ortamı tarafından yürütülebilir bir gösterime çevrilen bir veri akışını tanımlar. Temelde, bu dönüşümlerin sonuçları bir dizi işlemden oluşur. Harita indirgeme Programcının farkında olmadığı işler. Bu nedenle, Hadoop'taki Pig, programcının yürütmenin doğasından ziyade verilere odaklanmasını sağlar.
Pig Latin, veri işleme alanından tanıdık anahtar kelimeler (örneğin, Join, Group ve Filter) kullanan, nispeten katı bir dildir. Aşağıdaki diyagramda bu durum gösterilmektedir. tracGrunt kabuğundan gelen bir betiği, yürütme motoruna ulaşmadan önce ayrıştırıcı, optimize edici ve derleyici aşamalarından geçirir.

Yürütme modları
Hadoop'taki Pig'in iki yürütme modu vardır ve aşağıda yer alan kurulum kılavuzunda her ikisi de kullanılmaktadır:
- Yerel mod: Bu modda, Hadoop Pig dili tek bir yerde çalışır. JVM ve yerel dosya sistemini kullanır. Bu mod, Hadoop'ta Pig kullanılarak küçük veri kümelerinin analizi için uygundur.
- MapReduce modu: Bu modda, Pig Latin dilinde yazılan sorgular MapReduce işlerine çevrilir ve bir Hadoop kümesinde çalıştırılır (küme yarı dağıtılmış veya tamamen dağıtılmış olabilir). Tamamen dağıtılmış bir küme ile MapReduce modu, Pig'i büyük veri kümelerinde çalıştırmak için kullanışlıdır.
Bu ikisi klasik bir çift. Mevcut sürümler aslında altı farklı yürütme türü veya yürütme türü sunuyor ve bunların her biri aynı şekilde seçiliyor. -x bayrak, belgelendiği üzere Pig 0.18.0 Başlangıç Kılavuzu.
| Exectype | Komuta | İşin yürütüldüğü yer |
|---|---|---|
| Yerel | domuz -x yerel | Yerel dosya sistemine karşı tek bir JVM. |
| Tez yerel | domuz -x tez_yerel | Tez çalışma ortamını kullanan tek bir JVM (deneysel) |
| Spark yerel | domuz -x spark_yerel | Tek bir JVM kullanarak Spark çalışma süresi (deneysel) |
| Harita indirgeme | domuz veya domuz -x mapreduce | HDFS'li bir Hadoop kümesi; bu varsayılan ayardır. |
| Tez | domuz -x tez | Tez motorunu çalıştıran bir Hadoop kümesi |
| Spark | domuz -x kıvılcım | A SparkHDFS ile YARN veya Mesos kümesi |
Pig Latin Veri Tipleri ve Operaları
Bir komut dosyası yazmadan önce, Pig'in neleri tutabileceğini ve bunlarla neler yapabileceğini bilmek faydalıdır. Veri modeli tamamen iç içe geçmiş durumdadır; bu da Pig'in, ilişkisel bir tablonun reddedeceği günlük dosyalarını ve diğer gevşek yapılı girdileri okumasını sağlar.
Pig Latin iki tür ailesi sunar:
- Skalar türleri:
int,long,float,double,chararray,bytearray,boolean,datetime,bigintegerhem debigdecimalÖrnek betik daha sonra her sütunu şu şekilde tanımlar:chararray. - Karmaşık türler: a tanımlama grubu Alanların sıralı bir kümesidir ve bir satır gibi davranır; çanta Düzensiz bir demet koleksiyonudur ve tablo gibi davranır; harita Anahtar ve değer çiftlerinden oluşan bir kümedir ve anahtarın bir olması gerekir.
chararray.
Operatörler az sayıda işte çalışıyor ve bunlardan sadece birkaçı neredeyse tüm boru hatlarını taşıyor:
| Kullanım | Ne yapar |
|---|---|
| YÜKLE / DEPOLA | Dosya sisteminden bir ilişkiyi okuyun ve sonucu geri yazın. |
| FILTRE | Yalnızca bir koşula uyan kayıtları saklayın. |
| HER BİRİ İÇİN … OLUŞTUR | Sütun sütun çalışarak yeni alanlar oluşturun. |
| GRUP / ORTAK GRUP | Bir veya birden fazla ilişkiyi bir anahtar kullanarak gruplandırın. |
| JOIN | İlişkileri iç veya dış birleştirme ile birleştirin. |
| BİRLİK / AYRILIK | İlişkileri birleştirin veya bir ilişkiyi birkaç parçaya bölün. |
| SİPARİŞ VER / AYRI / SINIR | Kayıtları sıralayın, yinelenenleri kaldırın ve kayıt sayısını sınırlayın. |
| DÖKÜM / TANIMLA / AÇIKLA / RESİMLE | Sonuçları, şemaları, yürütme planlarını ve örnek çalıştırmaları inceleyin. |
Dört denetim operatörünün de Grunt kısayolları var, bu da zamandan tasarruf sağlıyor.ping hata ayıklama sırasında: \d DUMP için, \de AÇIKLAMAK için, \e EXPLAIN için ve \i RESİMLEMEK İÇİN.
Önkoşullar
Pig, istemci tarafında çalışan bir araçtır. Bir betiği ayrıştırır, işi planlar ve işleri gönderir, ancak kendi depolama alanını veya kümesini sağlamaz, bu nedenle öncelikle çalışan bir Hadoop kurulumunun mevcut olması gerekir. Apache gereksinimleri listesi kısadır.
| Bileşen | gereklilik | Neden gereklidir |
|---|---|---|
| Hadoop'un | Hadoop 2.x veya 3.x, HADOOP_HOME dışa aktarılmış halde. | HDFS ve yürütme motorunu sağlar. HADOOP_HOME olmadan, Pig 0.18.0 gömülü Hadoop 2.7.3'e geri döner. |
| Java | Java 1.7 veya üzeri sürümlerde, JAVA_HOME kurulum kök dizinine ayarlanmış olmalıdır. | Pig ve Hadoop servisleri şunlardır: Java programlar |
| Python (opsiyonel) | Python 2.7 | Sadece yayın için gerekli Python kullanıcı tanımlı işlevler |
| Karınca (isteğe bağlı) | Karınca 1.8 | Sadece Pig'i kaynak koddan derlerken veya yeniden derlerken gereklidir. |
Bu listenin yanında iki pratik nokta daha var. Birincisi, her şeyi zaten bir ana dizini olan bir Linux kullanıcısı olarak çalıştırın. HDFS ve ona yazma izni; bu eğitimde şunlar kullanılır: hduserÖncelikle, Hadoop kurulumu sırasında oluşturulan hesabı kullanın. İkinci olarak, Pig'i MapReduce modunda başlatmadan önce kümeyi başlatın, çünkü NameNode ve ResourceManager kapalıysa Pig hemen başarısız olur. Eğer Hadoop henüz kurulu değilse, aşağıdaki adımları izleyin. Hadoop nasıl kurulur? İlk.
Pig Nasıl İndirilir ve Kurulur
Şimdi bu Apache Pig eğitiminde Pig'i nasıl indirip kuracağımızı öğreneceğiz:
Asıl işleme başlamadan önce, Hadoop'un kurulu olduğundan emin olun. Kullanıcıyı 'hduser' olarak değiştirin (Hadoop yapılandırması sırasında kullanılan kimlik; kendi Hadoop yapılandırmanız sırasında kullandığınız kullanıcı kimliğine geçebilirsiniz).

) 1 Adım Pig Hadoop'un kararlı son sürümünü, aşağıdaki bağlantılarda bulunan ayna sitelerinden herhangi birinden indirebilirsiniz.
https://pig.apache.org/releases.html
Aşağıda gösterildiği gibi, indirmek için tar.gz dosyasını (src.tar.gz dosyasını değil) seçin.

) 2 Adım İndirme işlemi tamamlandıktan sonra, indirilen tar dosyasını içeren dizine gidin ve tar dosyasını Pig Hadoop'u kurmak istediğiniz konuma taşıyın. Bu örnekte, /usr/local dizinine taşıyacağız.

Pig Hadoop dosyalarının yer alacağı dizine geçin.
cd /usr/local
ExtracTar dosyasının içeriğini aşağıdaki gibi inceleyin.
sudo tar -xvf pig-0.12.1.tar.gz

) 3 Adım Pig ile ilgili ortam değişkenlerini eklemek için ~/.bashrc dosyasını değiştirin.
~/.bashrc dosyasını dilediğiniz bir metin düzenleyiciyle açın ve aşağıdaki değişiklikleri yapın.
export PIG_HOME=<Installation directory of Pig>
export PATH=$PIG_HOME/bin:$HADOOP_HOME/bin:$PATH

) 4 Adım Şimdi, aşağıdaki komutu kullanarak bu ortam yapılandırmasını kaynaklayın.
. ~/.bashrc

) 5 Adım Hadoop 2.2.0'ı desteklemek için Pig'i yeniden derlememiz gerekiyor.
İşte bunu yapmak için izlenecek adımlar.
Pig ana dizinine gidin.
cd $PIG_HOME
Ant'ı kurun.
sudo apt-get install ant

Not: İndirme işlemi başlayacak ve internet hızınıza bağlı olarak zaman alacaktır.
Pig'i yeniden derleyin.
sudo ant clean jar-all -Dhadoopversion=23

Lütfen bu yeniden derleme işleminde birden fazla bileşenin indirildiğini ve bu nedenle sistemin internete bağlı olması gerektiğini unutmayın.
Ayrıca, bu işlem bir yerde takılı kalırsa ve komut isteminde 20 dakikadan fazla bir süre boyunca herhangi bir hareket görmezseniz, Ctrl + c tuşlarına basın ve aynı komutu yeniden çalıştırın.
Bizim durumumuzda bu işlem 20 dakika sürüyor.

Bu yeniden derleme adımı, gönderilen JAR dosyalarının Hadoop 1 ve diğer sürümlere göre oluşturulduğu 0.12.1 dönemine aittir. -Dhadoopversion=23 Bayrak, Ant derlemesini Hadoop 0.23 ve 2.x hattına geçirdi. Apache Pig 0.18.0, Hadoop 2.7 ve üzeri sürümlerin yanı sıra Hadoop 3'te de çalışan ikili dosyalar içeriyor, bu nedenle mevcut bir sürümde normalde tarball'ı açıp doğrudan aşağıdaki teste geçebilirsiniz.
) 6 Adım Pig kurulumunu şu komutu kullanarak test edin:
pig -help

Örnek Domuz Komut Dosyası
Pig yüklendikten sonra, bu Apache Pig eğitiminin geri kalanı eksiksiz bir komut dosyası çalıştıracaktır. Her ülkede satılan ürün sayısını bulmak için Pig komut dosyalarını kullanacağız.
Giriş: Giriş veri setimiz bir CSV dosyasıdır. SatışOcak2009.csv.
) 1 Adım Hadoop'u başlatın.
$HADOOP_HOME/sbin/start-dfs.sh
$HADOOP_HOME/sbin/start-yarn.sh
) 2 Adım Pig in Big Data, HDFS'den bir dosyayı MapReduce modunda alır ve sonuçları tekrar HDFS'ye kaydeder.
Yerel dosya sisteminde ~/input/SalesJan2009.csv konumunda bulunan SalesJan2009.csv dosyasını HDFS (Hadoop Dağıtılmış Dosya Sistemi) ana dizinine kopyalayın.
Bu Apache Pig örneğinde, dosya "input" klasöründe yer almaktadır. Dosya başka bir konumda saklanıyorsa, o konumun adını verin.
$HADOOP_HOME/bin/hdfs dfs -copyFromLocal ~/input/SalesJan2009.csv /

Dosyanın gerçekten kopyalanıp kopyalanmadığını doğrulayın.
$HADOOP_HOME/bin/hdfs dfs -ls /

) 3 Adım Domuz Yapılandırması.
Öncelikle, $PIG_HOME/conf klasörüne gidin ve orijinal özellikler dosyasının bir kopyasını saklayın.
cd $PIG_HOME/conf
sudo cp pig.properties pig.properties.original

Dilediğiniz bir metin düzenleyici kullanarak pig.properties dosyasını açın ve pig.logfile parametresini kullanarak günlük dosyasının yolunu belirtin.
sudo gedit pig.properties

Hata kaydedici, hataları kaydetmek için bu dosyayı kullanacaktır.
) 4 Adım 'pig' komutunu çalıştırın; bu komut, Pig komut istemini, yani Pig sorguları için etkileşimli bir kabuğu başlatacaktır.
pig

) 5 Adım Pig için Grunt komut isteminde, aşağıdaki Pig komutlarını sırayla çalıştırın.
— A. Veri içeren dosyayı yükleyin.
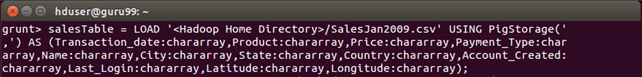
salesTable = LOAD '/SalesJan2009.csv' USING PigStorage(',') AS (Transaction_date:chararray,Product:chararray,Price:chararray,Payment_Type:chararray,Name:chararray,City:chararray,State:chararray,Country:chararray,Account_Created:chararray,Last_Login:chararray,Latitude:chararray,Longitude:chararray);
Bu komuttan sonra Enter tuşuna basın.
— B. Verileri Ülke alanına göre gruplandırın.
GroupByCountry = GROUP salesTable BY Country;

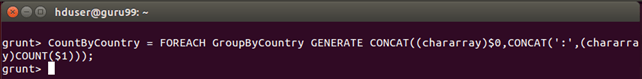
— C. 'GroupByCountry' içindeki her bir demet için, Ülke Adı: Satılan ürün sayısı biçiminde bir sonuç dizesi oluşturun.
CountByCountry = FOREACH GroupByCountry GENERATE CONCAT((chararray)$0,CONCAT(':',(chararray)COUNT($1)));
Bu komuttan sonra Enter tuşuna basın.
— D. Veri akışının sonuçlarını HDFS üzerindeki 'pig_output_sales' dizinine kaydedin.
STORE CountByCountry INTO 'pig_output_sales' USING PigStorage('\t');

Bu komutun yürütülmesi biraz zaman alacaktır. İşlem tamamlandığında aşağıdaki ekranı görmelisiniz.

) 6 Adım Sonuç, komut arayüzü üzerinden görülebilir.
$HADOOP_HOME/bin/hdfs dfs -cat pig_output_sales/part-r-00000

Sonuçlar ayrıca bir web arayüzü üzerinden de görüntülenebilir.
Bir web tarayıcısında http://localhost:50070/ adresini açın.
Hadoop 2'de 50070 numaralı port, NameNode web arayüzüdür. Hadoop 3 aynı sayfayı 9870 numaralı porta taşıdı, bu nedenle kümeniz Hadoop 3 çalıştırıyorsa bunun yerine bu adresi kullanın.

Şimdi 'Dosya sistemine göz at' seçeneğini seçin ve /user/hduser/pig_output_sales yoluna gidin.

Komut dosyasının ürettiği ülke ve ürün sayısı çiftlerini okumak için part-r-00000 dosyasını açın.

Apache Pig, Hive ve MapReduce karşılaştırması
Pig nadiren tek başına değerlendirilir. Genellikle sorulan soru, bir işin Pig'e mi yoksa başka bir şeye mi ait olduğudur. kovan Ya da elle yazılmış bir MapReduce programında, çünkü her üçü de aynı kümede iş olarak sonuçlanıyor.
| Görünüş | MapReduce (Java) | Apaçi Domuzu | Apaçi Kovanı |
|---|---|---|---|
| arayüzey | Java API | Pig Latin, bir veri akışı betik dili. | HiveQL, bir SQL lehçesi |
| Karın kaslarının seviyesitracyon | Düşük | Orta | Yüksek |
| Tipik kullanıcı | Java geliştirici | Veri mühendisi veya araştırmacı | SQL konusunda yetkin analist. |
| Veriler buna uygundur | Her şey, elle hallediliyor. | Yapılandırılmış ve yarı yapılandırılmış; şema yükleme sırasında isteğe bağlıdır. | Meta veri deposunda kayıtlı yapılandırılmış tablolar |
| Code hacim | Çoğu satır | Daha az satır | Bir sorgu için en az satır sayısı |
| Şöyle çalışır: | Bir MapReduce işi | MapReduce, Tez veya Spark iş fırsatları | MapReduce, Tez veya Spark iş fırsatları |
| en iyi | Tam kontrol ve özel mantık | Çok adımlı ETL işlem hatları | Anlık sorgulama ve raporlama |
Pratikte ayrım basittir. Veriler zaten bir tablo gibi görünüyorsa ve soru SQL gibi görünüyorsa Hive'ı tercih edin. Giriş karmaşık olduğunda, işlem hattı tek bir sorgu yerine bir dönüşüm zinciri olduğunda veya aynı betiğin dallanıp tekrar birleşmesi gerektiğinde Pig'i tercih edin. MapReduce'u yalnızca mutlak olarak hiçbir koşul söz konusu olmadığında tercih edin.tracSatır sayısı hızla arttığı için mantık ifade edilemiyor.
Domuz da ekosistemin geri kalanıyla uyumlu bir şekilde varlığını sürdürüyor. Sqoop ve Flume Ham verileri alın, Pig veya Hive ile şekillendirin ve bir zamanlayıcı kullanın, örneğin... Apaçi Oozie'si Bu adımlar, tekrarlanabilir bir işlem hattına zincirleme olarak uygulanır. Bu araçların nerede kullanıldığına dair daha geniş bir bakış açısı için kılavuza bakın. büyük veri ve özet büyük veri araçlarıElle yazılmış komut dosyalarına ticari bir ETL alternatifi için bkz. Talend.
