
Hadoop nedir? ArchiYapı, Ekosistem ve Bileşenler
 Prafulla Ranadive
⚡ Akıllı Özet
Apache Hadoop, büyük veri kümelerini sıradan makinelerden oluşan kümeler üzerinde depolayan ve işlem mantığını veriye taşıyan açık kaynaklı bir çerçevedir; böylece analiz, daha büyük sunucular yerine ucuz düğümler eklenerek ölçeklendirilebilir.
Hadoop nedir?
Apache Hadoop, dağıtılmış bir bilgi işlem ortamında yürütülen veri işleme uygulamalarını geliştirmek için kullanılan açık kaynaklı bir yazılım çerçevesidir.
Hadoop kullanılarak geliştirilen uygulamalar, ucuz ve yaygın olarak bulunan bilgisayar kümelerine dağıtılmış büyük veri kümeleri üzerinde çalıştırılır. Bu bilgisayarlar, düşük maliyetle daha yüksek işlem gücü elde etmek için büyük ölçüde kullanışlıdır.
Kişisel bilgisayar sistemlerinin yerel dosya sisteminde bulunan verilere benzer şekilde, Hadoop'ta veriler, dağıtık dosya sistemi olarak adlandırılan bir sistemde bulunur. Hadoop Dağıtılmış Dosya Sistemiİşleme modeli şunlara dayanmaktadır: 'Veri Yerelliği' Bu kavramda, hesaplama mantığı, verileri içeren küme düğümlerine (sunuculara) gönderilir. Bu hesaplama mantığı, basitçe, yüksek seviyeli bir dilde yazılmış bir programın derlenmiş bir versiyonudur. JavaBu tür bir program, depolanan verileri işler. Hadoop HDFS.
Biliyor musun? Bilgisayar kümesi, birbirine bağlı ve tek bir sistem gibi çalışan birden fazla işlem biriminden (depolama diski + işlemci) oluşur.
2 Nisan 2026'da yayınlanan 3.5.0 sürümü, mevcut kararlı sürümdür; 3.4 serisi ise hala bakım güncellemeleri almaktadır.
Hadoop Ekosistemi ve Bileşenleri
Aşağıdaki diyagram, Hadoop ekosistemindeki çeşitli bileşenleri, her birinin yaptığı işe göre gruplandırılmış olarak göstermektedir: depolama, işleme ve bunların etrafındaki sorgulama, veri alımı ve koordinasyon araçları.

Apache Hadoop iki alt projeden oluşur:
- Hadoop Haritası Azaltma: MapReduce, Hadoop'ta çalıştırılan uygulamaları yazmaya yönelik bir hesaplamalı model ve yazılım çerçevesidir. Bu MapReduce programları, büyük hesaplama düğümü kümeleri üzerinde çok büyük verileri paralel olarak işleme kapasitesine sahiptir.
- HDFS (Hadoop Dağıtılmış Dosya Sistemi): HDFS, Hadoop uygulamalarının depolama kısmıyla ilgilenir. MapReduce uygulamaları HDFS'den veri tüketir. HDFS, veri bloklarının birden fazla kopyasını oluşturur ve bunları bir kümedeki işlem düğümlerine dağıtır. Bu dağıtım güvenilir ve son derece hızlı hesaplamalara olanak sağlar.
Mevcut sürümler iki ek temel modül daha içermektedir. Hadoop İPLİKHadoop 2.x'te eklenen bu özellik, kümedeki işleri planlar ve Hadoop Ortak paylaşımlıyı elinde tutuyor Java Her modülün bağlı olduğu kütüphaneler. YARN, bu gibi motorların çalışmasını sağlayan şeydir. SparkTez ve Flink, MapReduce ile birlikte çalışır.
Hadoop, en çok MapReduce ve dağıtık dosya sistemi HDFS ile tanınsa da, bu terim aynı zamanda dağıtık hesaplama ve büyük ölçekli veri işleme şemsiyesi altında yer alan bir dizi ilgili proje için de kullanılır. Apache'deki diğer Hadoop ile ilgili projeler şunlardır: kovanHBase, Mahout, Sqoop, Flumeve ZooKeeper.
Hadoop'un Archidoku
Hadoop, veri depolama ve dağıtılmış veri işleme için ana-köle mimarisine sahiptir. Harita indirgeme ve HDFS yöntemleri. Aşağıdaki diyagram, bu rolleri yan yana, bir tarafta depolama katmanı, diğer tarafta ise işlem katmanı olacak şekilde göstermektedir.
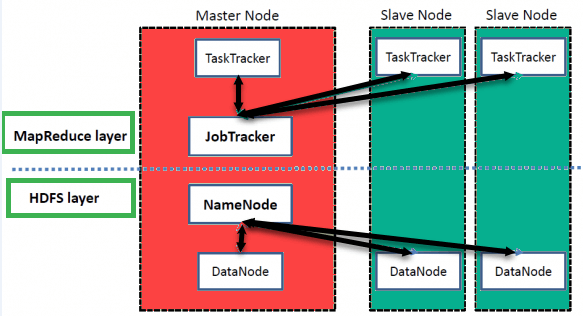
Yüksek Düzey Hadoop Archidoku
AdNode
NameNode, ad alanında kullanılan her dosya ve dizin için meta verileri depolar; bu veriler, her dosyanın hangi bloklardan oluştuğunu ve bu blokların nerede bulunduğunu içerir.
Veri Düğümü
Bir DataNode, bir HDFS düğümünün durumunu yönetir ve depoladığı bloklarla etkileşim kurmanıza olanak tanır; periyodik blok raporları ve kalp atışları ile NameNode'a geri bildirimde bulunur.
MasterNode
Ana düğüm, Hadoop MapReduce'u kullanarak verilerin paralel işlenmesini gerçekleştirmenize olanak tanır.
Köle Düğümü
Köle düğümler, Hadoop kümesinde veri depolamanıza ve karmaşık hesaplamalar yapmanıza olanak tanıyan ek makinelerdir. Dahası, her köle düğüm bir Görev (Task) çalıştırır.TracKer ve bir DataNode. Bu, süreçleri NameNode ve Job ile senkronize etmenizi sağlar.Tracsırasıyla ker.
Hadoop'ta, bulutta veya şirket içi ortamlarda ana veya yardımcı sistemler kurulabilir.
İsimlendirmeyle ilgili bir not: İşTracker hem de GörevTracker Birinci nesil MapReduce çalışma ortamına (MRv1) aittirler. Hadoop 2.x'ten itibaren YARN, görevlerini küme genelinde paylaştırır. Kaynak Yöneticisi, Düğüm Yöneticisi işçi başına ve bir Uygulama Yöneticisi Her iş için. NameNode ve DataNode değişmeden kalır.
Hadoop'un Özellikleri
Büyük Veri Analizi için uygundur.
As büyük Veri Genellikle dağıtık ve yapılandırılmamış bir yapıya sahip olan büyük verilerin analizi için Hadoop kümeleri en uygun çözümdür. Hesaplama düğümlerine akan şey verinin kendisi değil, işlem mantığı olduğundan, daha az ağ bant genişliği tüketilir. Buna "yoğunluk" denir. veri yerelliği kavramıBu da Hadoop tabanlı uygulamaların verimliliğini artırmaya yardımcı olur.
ölçeklenebilirlik
Hadoop kümeleri, ek küme düğümleri eklenerek kolayca istenilen boyuta ölçeklendirilebilir ve böylece Büyük Verinin büyümesine olanak tanır. Ayrıca, ölçeklendirme uygulama mantığında değişiklik gerektirmez.
Hata Toleransı
Hadoop ekosistemi, giriş verilerini diğer küme düğümlerine kopyalama olanağı sunar. Bu sayede, bir küme düğümünün arızalanması durumunda, başka bir küme düğümünde depolanan veriler kullanılarak veri işleme devam edebilir. HDFS, varsayılan olarak her bloğun üç kopyasını saklar; bu değer, yapılandırma dosyası tarafından belirlenir. dfs.replication Bu özellik sayesinde, NameNode bu sayının altına düşen tüm blokları yeniden çoğaltır.
Hadoop'ta Ağ Topolojisi
Ağ topolojisi (düzeni), küme boyutu büyüdükçe Hadoop kümesinin performansını etkiler. Performansın yanı sıra, yüksek kullanılabilirlik ve arıza yönetimi de dikkate alınmalıdır. Bunu sağlamak için Hadoop küme oluşturma işlemi ağ topolojisinden yararlanır.
Aşağıdaki ağaç yapısı, veri merkezinden her bir rafın içindeki düğümlere kadar bu düzenlemenin nasıl modellendiğini göstermektedir.

Genellikle, herhangi bir ağ oluşturulurken dikkate alınması gereken önemli bir faktör ağ bant genişliğidir. Bununla birlikte, bant genişliğini ölçmek zor olabileceğinden, Hadoop'ta bir ağ ağaç olarak temsil edilir ve bu ağacın düğümleri arasındaki mesafe (adım sayısı) bir Hadoop kümesinin oluşturulmasında önemli bir faktör olarak kabul edilir. Burada, iki düğüm arasındaki mesafe, en yakın ortak atalarına olan mesafelerinin toplamına eşittir.
Bir Hadoop kümesi, bir veri merkezi, raf ve işleri fiilen yürüten düğümden oluşur. Burada, veri merkezi raflardan, raf ise düğümlerden oluşur. İşlemlere sunulan ağ bant genişliği, işlemlerin konumuna bağlı olarak değişir. Yani, veri merkezinden uzaklaştıkça kullanılabilir bant genişliği azalır.
- Aynı düğümdeki işlemler
- Aynı rafta farklı düğümler
- Aynı veri merkezinin farklı raflarındaki düğümler
- Farklı veri merkezlerindeki düğümler
Raf farkındalığı aynı ağacı kullanır: HDFS, kopyaları birden fazla rafa yerleştirir, bu nedenle bir raf anahtarının kaybı, verilerin tüm kopyalarının kaybolmasına neden olmaz.
