
Hadoop Nasıl Kurulur? Ubuntuİndirme ve Kurulum Adımları
 Prafulla Ranadive
⚡ Akıllı Özet
Apache Hadoop'u Kurma Ubuntu İki aşamadan oluşur: önce parola gerektirmeyen SSH ile özel bir sistem hesabı altında sürümün paketinden çıkarılması, ardından HDFS'yi biçimlendirmeden ve tek düğümlü kümeyi başlatmadan önce dört XML dosyasının düzenlenmesi.
Bu eğitimde, Linux işletim sistemli bir bilgisayara Apache Hadoop'u adım adım nasıl kuracağınızı göstereceğiz.UbuntuBu iki aşamalı bir işlemdir: önce sürümü indirip kurun, ardından yapılandırın.
İki ön koşul vardır:
- Bunun olması gerekir Ubuntu yüklü ve koşuyor.
- Bunun olması gerekir Java yüklü.
Bu kurulum için Hadoop 3.x sürümüne ilişkin notlar.
Bu kılavuzdaki ekran görüntüleri Hadoop 2.2.0 üzerinde alınmıştır. Adımların sırası mevcut sürümlerde değişmemiştir, ancak birkaç isim ve varsayılan değer yer değiştirmiştir. Herhangi bir komutu olduğu gibi kopyalamadan önce aşağıdaki tabloyu kontrol edin.
| Ayar veya adım | Bu eğitimde (Hadoop 2.x) | Mevcut Hadoop 3.x |
|---|---|---|
| Yayın arşivi | hadoop-2.2.0.tar.gz |
hadoop-3.5.0.tar.gz3.5 sürümünün ilk kararlı versiyonu, 2 Nisan 2026'da yayınlandı. |
| Varsayılan dosya sistemi özelliği | fs.default.name düzyazıda, fs.defaultFS XML'de |
fs.defaultFS sadece; fs.default.name kullanımdan kaldırıldı |
| MapReduce özelliği | mapreduce.jobtracker.address |
mapreduce.framework.name ayarlandığında yarnİşTracYARN işi planladığında ker artık mevcut olmaz. |
| haritalanmış-site.xml | Kopyalandı mapred-site.xml.template |
Gemiler etc/hadoop Zaten öyle, bu yüzden kopyalama adımı gereksiz. |
| NameNode web kullanıcı arayüzü portu | 50070 | 9870 |
| Java | Java 6 veya Java 7 | Java 8 veya Java 11 |
Bu kılavuzdaki diğer her şey Hadoop 3'te de aynı şekilde çalışır: özel hesap, SSH anahtarı, dört yapılandırma dosyası ve başlatma ve durdurma komut dosyaları.
Bölüm 1) Hadoop'u indirin ve yükleyin
Adım 1) Bir Hadoop sistem kullanıcısı ekleyin
Aşağıdaki komutu kullanarak bir Hadoop sistem kullanıcısı ekleyin.
sudo addgroup hadoop_

sudo adduser --ingroup hadoop_ hduser_
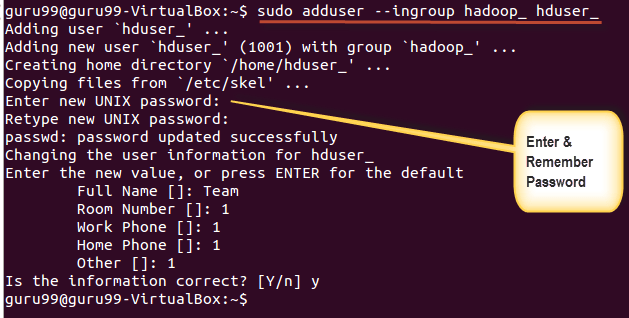
Şifrenizi, adınızı ve diğer bilgilerinizi girin.
NOT: Bu kurulum ve yükleme sürecinde aşağıda belirtilen hatanın oluşma olasılığı vardır.
“hduser sudoers dosyasında değil. Bu olay rapor edilecektir."

Bu hata, root kullanıcısı olarak oturum açarak çözülebilir.
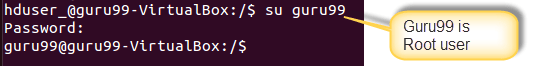
Komutu yürütün
sudo adduser hduser_ sudo

Re-login as hduser_

Adım 2) SSH'yi yapılandırın
Bir kümedeki düğümleri yönetmek için Hadoop'un SSH erişimine ihtiyacı vardır.
İlk önce kullanıcıyı değiştirin, aşağıdaki komutu girin
su - hduser_

Bu komut yeni bir anahtar oluşturacaktır.
ssh-keygen -t rsa -P ""

Bu anahtarı kullanarak yerel makineye SSH erişimini etkinleştirin.
cat $HOME/.ssh/id_rsa.pub >> $HOME/.ssh/authorized_keys

Şimdi 'hduser_' kullanıcısı olarak localhost'a bağlanarak SSH kurulumunu test edin.
ssh localhost

Not: 'ssh localhost' komutuna aşağıdaki hatayı alıyorsanız, bu sistemde SSH'nin kullanılamıyor olma olasılığı vardır.

Bunu çözmek için –
SSH'yi kullanarak temizleyin,
sudo apt-get purge openssh-server
Kurulum işlemine başlamadan önce önbelleği temizlemek iyi bir uygulamadır.

Komutu kullanarak SSH'yi yükleyin.
sudo apt-get install openssh-server

Adım 3) Hadoop'u indirin
Sonraki adım Hadoop'u indirmektir. Apache Hadoop sürümleri sayfası.

Kararlı'yı seçin

tar.gz dosyasını seçin (src ile biten dosyayı değil).

İndirme işlemi tamamlandıktan sonra, tar dosyasını içeren dizine gidin.

girin
sudo tar xzf hadoop-2.2.0.tar.gz

Şimdi hadoop-2.2.0'ı hadoop olarak yeniden adlandırın.
sudo mv hadoop-2.2.0 hadoop

Son olarak, klasörü yeni hesaba teslim edin.
sudo chown -R hduser_:hadoop_ hadoop

İndirdiğiniz sürümün yerine şunu yazın: hadoop-2.2.0 Yukarıdaki üç komutta.
Bölüm 2) Hadoop'u Yapılandırma
Adım 1) ~/.bashrc dosyasını değiştirin.
Aşağıdaki satırları ~/.bashrc dosyasının sonuna ekleyin.
#Set HADOOP_HOME
export HADOOP_HOME=<Installation Directory of Hadoop>
#Set JAVA_HOME
export JAVA_HOME=<Installation Directory of Java>
# Add bin/ directory of Hadoop to PATH
export PATH=$PATH:$HADOOP_HOME/bin
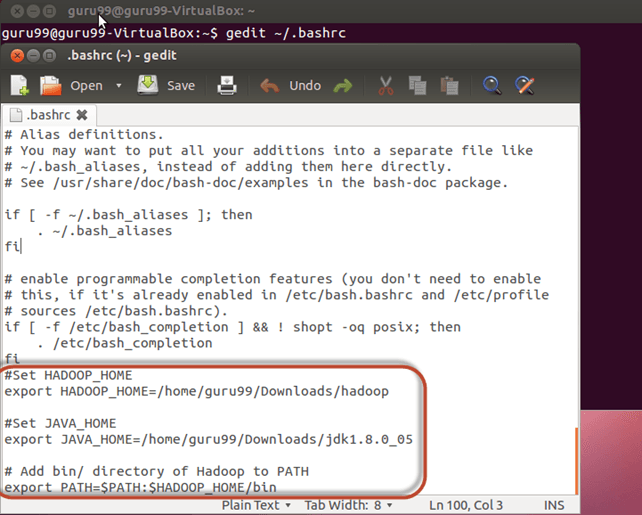
Şimdi, aşağıdaki komutu kullanarak bu ortam yapılandırmasını kaynaklayın.
. ~/.bashrc

Adım 2) HDFS ile ilgili yapılandırmalar
Aşağıda gösterildiği gibi, `$HADOOP_HOME/etc/hadoop/hadoop-env.sh` dosyasında `JAVA_HOME` değişkenini ayarlayın.


İle

$HADOOP_HOME/etc/hadoop/core-site.xml dosyasında ayarlanması gereken iki parametre bulunmaktadır.
1. 'hadoop.tmp.dir' – Hadoop'un veri dosyalarını depolamak için kullanacağı dizini belirtmek için kullanılır.
2. 'fs.defaultFS' – Bu, varsayılan dosya sistemini belirtir. Aynı özelliğin eski adı olan 'fs.default.name' artık kullanılmamaktadır.
Bu parametreleri ayarlamak için core-site.xml dosyasını açın
sudo gedit $HADOOP_HOME/etc/hadoop/core-site.xml

Aşağıdaki satırları arasına kopyalayın. etiketler.
<property>
<name>hadoop.tmp.dir</name>
<value>/app/hadoop/tmp</value>
<description>Parent directory for other temporary directories.</description>
</property>
<property>
<name>fs.defaultFS </name>
<value>hdfs://localhost:54310</value>
<description>The name of the default file system. </description>
</property>

$HADOOP_HOME/etc/hadoop dizinine gidin.

Şimdi, core-site.xml dosyasında belirtilen dizini oluşturun.
sudo mkdir -p <Path of Directory used in above setting>

Dizin için izinleri verin.
sudo chown -R hduser_:Hadoop_ <Path of Directory created in above step>

sudo chmod 750 <Path of Directory created in above step>

Adım 3) MapReduce Yapılandırması
Bu yapılandırmalara başlamadan önce, HADOOP_HOME yolunu ayarlayalım.
sudo gedit /etc/profile.d/hadoop.sh
Ve Girin
export HADOOP_HOME=/home/guru99/Downloads/Hadoop

Sonraki giriş
sudo chmod +x /etc/profile.d/hadoop.sh

Terminali kapatın ve yeniden başlatın.
Yolun doğruluğunu kontrol etmek için `echo $HADOOP_HOME` yazın.

Şimdi dosyaları kopyala
sudo cp $HADOOP_HOME/etc/hadoop/mapred-site.xml.template $HADOOP_HOME/etc/hadoop/mapred-site.xml

mapred-site.xml dosyasını açın.
sudo gedit $HADOOP_HOME/etc/hadoop/mapred-site.xml

Aşağıdaki ayarları arasına ekleyin. Ve etiketler.
<property>
<name>mapreduce.jobtracker.address</name>
<value>localhost:54311</value>
<description>MapReduce job tracker runs at this host and port.
</description>
</property>

Aşağıdaki gibi $HADOOP_HOME/etc/hadoop/hdfs-site.xml dosyasını açın.
sudo gedit $HADOOP_HOME/etc/hadoop/hdfs-site.xml

Aşağıdaki ayarları arasına ekleyin. Ve etiketler.
<property>
<name>dfs.replication</name>
<value>1</value>
<description>Default block replication.</description>
</property>
<property>
<name>dfs.datanode.data.dir</name>
<value>/home/hduser_/hdfs</value>
</property>

Yukarıdaki ayarlarda belirtilen dizini oluşturun.
sudo mkdir -p <Path of Directory used in above setting>
sudo mkdir -p /home/hduser_/hdfs

Ardından ona sahiplik ve izinler verin.
sudo chown -R hduser_:hadoop_ <Path of Directory created in above step>
sudo chown -R hduser_:hadoop_ /home/hduser_/hdfs

sudo chmod 750 <Path of Directory created in above step>
sudo chmod 750 /home/hduser_/hdfs

Adım 4) HDFS'yi Biçimlendirin
Hadoop'u ilk kez çalıştırmadan önce, aşağıdaki komutu kullanarak HDFS'yi biçimlendirin.
$HADOOP_HOME/bin/hdfs namenode -format

Adım 5) Hadoop tek düğümlü kümesini başlatın
Aşağıdaki komutu kullanarak Hadoop tek düğümlü kümesini başlatın.
$HADOOP_HOME/sbin/start-dfs.sh
Yukarıdaki komutun çıktısı aşağıda gösterilmiştir.

Ardından YARN servislerini başlatın.
$HADOOP_HOME/sbin/start-yarn.sh

'jps' aracını kullanarak Hadoop ile ilgili tüm işlemlerin çalışıp çalışmadığını doğrulayın.
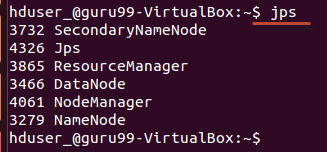
Hadoop başarıyla başlatıldıysa, jps çıktısında NameNode, NodeManager, ResourceManager, SecondaryNameNode ve DataNode listelenmelidir.
Adım 6) Durdurunping Hadoop'un
Küme kapatma işlemlerini ters sırayla gerçekleştirin.
$HADOOP_HOME/sbin/stop-dfs.sh

$HADOOP_HOME/sbin/stop-yarn.sh

Hadoop'un Çalıştığını Doğrulama ve Sık Karşılaşılan Hataları Düzeltme Yöntemleri
JPS çıktısı, işlemlerin başlatıldığını doğruluyor, ancak kümenin kullanılabilir olduğunu doğrulamıyor. Dört ek kontrol bu soruyu çözüyor.
- NameNode web arayüzünü şu adresten açın:
http://localhost:9870(Hadoop 2.x'te 50070 numaralı bağlantı noktası) ve özet raporlarında bir adet çalışan düğümün olduğunu doğrulayın. - ResourceManager arayüzünü şu adresten açın:
http://localhost:8088YARN'ın NodeManager'ı kabul ettiğini doğrulamak için. - koşmak
hdfs dfsadmin -reportKapasite, aktif DataNode'lar ve yetersiz çoğaltılmış bloklar için. - Bir şeyler yazın:
hdfs dfs -mkdir /testardındanhdfs dfs -ls /Bu, ad alanının değişiklikleri kabul ettiğini kanıtlar.
İlk denemelerde yaşanan başarısızlıkların çoğu beş kategoriye girer.
| Semptom | Sebeb olmak | sabit |
|---|---|---|
| JAVA_HOME ayarlanmamış ve bulunamadı. | Değişken .bashrc dosyasında dışa aktarılıyor ancak hadoop-env.sh dosyasında dışa aktarılmıyor. | Hadoop-env.sh dosyasında da JDK'nın mutlak yolunu belirtin. |
| SSH localhost üzerinde erişim engellendi (publickey,password). | authorized_keys eksik veya çok fazla izin verici. | id_rsa.pub dosyasını tekrar ekleyin, ardından ~/.ssh/authorized_keys dizinine chmod 600 komutunu çalıştırın. |
| 22 numaralı porta bağlantı reddedildi. | openssh-server yüklü değil veya çalışmıyor. | OpenSSH sunucusunu kurun ve SSH hizmetini başlatın. |
| Yeniden biçimlendirme sonrasında jps dosyasından DataNode kayboldu. | Cluster Biçimlendirilmiş NameNode ile eski DataNode dizini arasında kimlik uyuşmazlığı. | dfs.datanode.data.dir klasörünü boşaltın, ardından bir kez daha biçimlendirin. |
| start-dfs.sh: komut bulunamadı | Mevcut shell'de HADOOP_HOME ve PATH hiçbir zaman kaynak olarak kullanılmadı. | . ~/.bashrc komutunu çalıştırın veya yeni bir terminal açın. |
