
ETL (ExtracProcesso de Transformação e Carga (t, Transform, and Load) em um Data Warehouse
 David Carter
Resumo Inteligente
ETL (ExtracO processo de Transformação, Carga e Extrusão (T+L) em um Data Warehouse descreve o fluxo sistemático de movimentação de dados de múltiplas fontes heterogêneas para um repositório centralizado. Ele garante a consistência, a precisão e a prontidão dos dados para análise por meio de extração estruturada.tracção, transformação e mecanismos de carregamento otimizados.
O que é ETL?
ETL é um processo que extracO ETL (Extração, Transformação e Carga) extrai os dados de diferentes sistemas de origem, transforma-os (aplicando cálculos, concatenações, etc.) e, finalmente, carrega-os no sistema de data warehouse. A sigla ETL significa Extração, Transformação e Carga.tract, Transformar e Carregar.
É tentador pensar que criar um Data Warehouse envolve simplesmente extracA extração de dados de múltiplas fontes e seu carregamento em um banco de dados são tarefas complexas. No entanto, na prática, isso requer um processo ETL (Extração, Transformação e Carga) intrincado. O processo ETL exige a participação ativa de diversas partes interessadas, incluindo desenvolvedores, analistas, testadores e executivos de alto escalão, e é tecnicamente desafiador.
Para manter seu valor como ferramenta para a tomada de decisões, o sistema de data warehouse precisa se adaptar às mudanças do negócio. O ETL é uma atividade recorrente (diária, semanal ou mensal) de um sistema de data warehouse e precisa ser ágil, automatizado e bem documentado.


Por que você precisa de ETL?
Existem muitos motivos para adotar ETL na organização:
- Isso ajuda as empresas a analisar seus dados de negócios para tomar decisões críticas.
- Bancos de dados transacionais não conseguem responder a questões complexas de negócios que podem ser respondidas por um processo ETL.
- Um data warehouse fornece um repositório de dados comum.
- ETL fornece um método para mover os dados de várias fontes para um data warehouse.
- À medida que as fontes de dados mudam, o data warehouse será atualizado automaticamente.
- Um sistema ETL bem projetado e documentado é praticamente essencial para o sucesso de um projeto de data warehouse.
- Permitir a verificação das regras de transformação, agregação e cálculo de dados.
- O processo ETL permite a comparação de dados de amostra entre o sistema de origem e o sistema de destino.
- O processo ETL pode realizar transformações complexas e requer uma área extra para armazenar os dados.
- O ETL ajuda a migrar dados para um Data Warehouse, convertendo diferentes formatos e tipos em um sistema consistente.
- ETL é um processo predefinido para acessar e manipular dados de origem no banco de dados de destino.
- O processo ETL em um data warehouse oferece um contexto histórico profundo para o negócio.
- Isso ajuda a melhorar a produtividade porque codifica e reutiliza informações sem a necessidade de habilidades técnicas.
Com uma compreensão clara do valor do ETL, vamos mergulhar no processo de três etapas que faz tudo funcionar.
Processo ETL em data warehouses
ETL é um processo de 3 etapas
Passo 1) Extracção
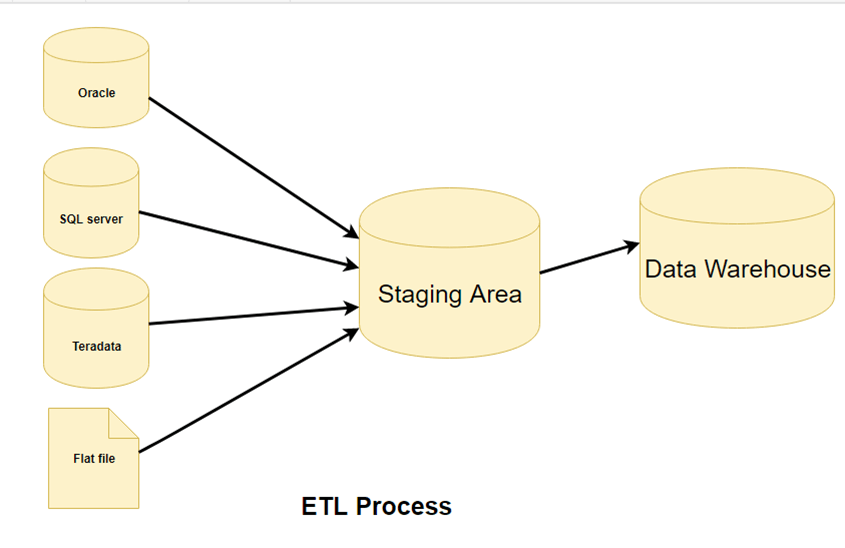
Nesta etapa da arquitetura ETL, os dados são extraídos.tracOs dados são transferidos do sistema de origem para a área de preparação. Quaisquer transformações são realizadas na área de preparação para que o desempenho do sistema de origem não seja prejudicado. Além disso, se dados corrompidos forem copiados diretamente da origem para o banco de dados do data warehouse, o rollback será um desafio. A área de preparação oferece a oportunidade de validar os dados.tracos dados são processados antes de serem movidos para o data warehouse.
O data warehouse precisa integrar sistemas que possuem diferentes SGBDs, hardwares, OperaSistemas de processamento e protocolos de comunicação. As fontes podem incluir aplicações legadas como mainframes, aplicações personalizadas, dispositivos de ponto de contato como caixas eletrônicos, centrais telefônicas, arquivos de texto, planilhas, sistemas ERP, dados de fornecedores e parceiros, entre outros.
Portanto, é necessário um mapeamento lógico de dados antes que os dados sejam extraídos.tracted e carregado fisicamente. Este mapa de dados descreve a relação entre as fontes e os dados de destino.
Três dados Extracmétodos de ção:
- Full Extracção
- Exercício parcialtracção - sem notificação de atualização.
- Exercício parcialtracção - com notificação de atualização
Independentemente do método utilizado, extracA atualização não deve afetar o desempenho e o tempo de resposta dos sistemas de origem. Esses sistemas de origem são bancos de dados de produção em funcionamento. Qualquer lentidão ou bloqueio pode afetar os resultados financeiros da empresa.
Algumas validações são feitas durante o Extracção:
- Reconciliar registros com os dados de origem
- Certifique-se de que nenhum spam/dados indesejados sejam carregados.
- Verificação de tipo de dados
- Remova todos os tipos de dados duplicados/fragmentados
- Verifique se todas as chaves estão no lugar.
Passo 2) Transformação
Dados extracOs dados provenientes do servidor de origem são brutos e não utilizáveis em sua forma original. Portanto, precisam ser limpos, mapeados e transformados. De fato, esta é a etapa fundamental em que o processo ETL agrega valor e modifica os dados de forma a gerar relatórios de BI relevantes.
É um dos conceitos importantes de ETL, onde você aplica um conjunto de funções em arquivos executáveis.tracDados não transformados. Dados que não requerem nenhuma transformação são chamados de dados não transformados. movimento direto or dados de passagem.
Na etapa de transformação, você pode realizar operações personalizadas nos dados. Por exemplo, se o usuário quiser a soma da receita de vendas que não está no banco de dados, ou se o nome e o sobrenome em uma tabela estiverem em colunas diferentes, é possível concatená-los antes do carregamento.

Os dados a seguir são apresentados. Integrity Problemas:
- Grafias diferentes do mesmo nome, como Jon, John, etc.
- Existem várias maneiras de indicar o nome de uma empresa, como por exemplo... Google, Google Inc.
- Uso de nomes diferentes como Cleaveland e Cleveland.
- Pode haver casos em que diferentes números de conta sejam gerados por vários aplicativos para o mesmo cliente.
- Em alguns casos, os arquivos de dados necessários permanecem em branco.
- Produto inválido coletado no PDV, pois a entrada manual pode levar a erros.
As validações são feitas nesta fase
- Filtragem – Selecione apenas determinadas colunas para carregar
- Usando regras e tabelas de pesquisa para padronização de dados
- Conversão de conjunto de caracteres e manipulação de codificação
- Conversão de unidades de medida, como conversões de data e hora, conversões de moeda, conversões numéricas, etc.
- Verificação de validação do limite de dados. Por exemplo, a idade não pode ter mais de dois dígitos.
- Validação do fluxo de dados da área de staging para as tabelas intermediárias.
- Os campos obrigatórios não devem ser deixados em branco.
- Limpeza (por exemplo, mapa)ping NULO para 0 ou Gênero Masculino para “M” e Feminino para “F”, etc.)
- Dividir uma coluna em várias colunas e mesclar várias colunas em uma única coluna.
- Transpondo linhas e colunas,
- Use pesquisas para mesclar dados
- Utilizando qualquer validação de dados complexa (por exemplo, se as duas primeiras colunas de uma linha estiverem vazias, a linha é automaticamente rejeitada do processamento).
Etapa 3) Carregando
O carregamento de dados para o banco de dados do data warehouse de destino é a última etapa do processo ETL. Em um data warehouse típico, um grande volume de dados precisa ser carregado em um período relativamente curto (noites). Portanto, o processo de carregamento deve ser otimizado para desempenho.
Em caso de falha de carga, os mecanismos de recuperação devem ser configurados para reiniciar a partir do ponto de falha sem perda de integridade dos dados. Os administradores do data warehouse precisam monitorar, retomar e cancelar cargas de acordo com o desempenho atual do servidor.
Tipos de carregamento:
- Carga inicial — preenchendo todas as tabelas do data warehouse
- Carga Incremental — aplicando alterações contínuas conforme necessário periodicamente.
- Atualização completa —apagar o conteúdo de uma ou mais tabelas e recarregar com dados novos.
Verificação de carga
- Certifique-se de que os dados do campo-chave não estejam ausentes nem sejam nulos.
- Teste visualizações de modelagem com base nas tabelas de destino.
- Verifique se os valores combinados e as medidas calculadas estão corretos.
- Verificações de dados na tabela de dimensões, bem como na tabela de histórico.
- Verifique os relatórios de BI na tabela de fatos e dimensões carregada.
Pipeline ETL e Processamento Paralelo
O pipeline ETL permite extracção, transformação e carregamento para ocorrer simultaneamente em vez de sequencialmente. Assim que uma porção de dados é extracTed, ele é transformado e carregado enquanto novos dados extracA ação continua. processamento paralelo Melhora significativamente o desempenho, reduz o tempo de inatividade e maximiza a utilização dos recursos do sistema.
Esse processamento paralelo é essencial para análises em tempo real, integração de dados em larga escala e sistemas ETL baseados em nuvem. Por sobreposiçãoping Com tarefas de ETL em pipeline, garante-se uma movimentação de dados mais rápida, maior eficiência e entrega de dados mais consistente para empresas modernas.
Como a IA aprimora os pipelines ETL modernos?
Inteligência artificial revolutIoniza o ETL, tornando os pipelines de dados adaptáveis, inteligentes e auto-otimizáveis. Algoritmos de IA podem mapear esquemas automaticamente, detectar anomalias e prever regras de transformação sem configuração manual. Isso permite que os fluxos de trabalho de ETL lidem com estruturas de dados em constante evolução sem esforço, mantendo a qualidade dos dados.
As plataformas ETL modernas aprimoradas por IA utilizam tecnologias como AutoML para engenharia automática de recursos e mapeamento de esquemas orientado por PNL.ping que compreende as relações semânticas entre os campos e algoritmos de detecção de anomalias que identificam problemas de qualidade de dados em tempo real. Essas funcionalidades reduzem significativamente o esforço manual tradicionalmente exigido no desenvolvimento e na manutenção de processos ETL.
Aprendizado de máquinas Aprimora o ajuste de desempenho, garantindo uma integração de dados mais rápida e precisa. Ao introduzir automação e inteligência preditiva, o ETL com IA fornece insights em tempo real e impulsiona maior eficiência em ecossistemas de dados em nuvem e híbridos.
Para implementar os conceitos discutidos acima, as organizações dependem de ferramentas ETL especializadas. Aqui estão algumas das principais opções disponíveis no mercado.
Ferramentas ETL
Há muitos Ferramentas ETL disponíveis no mercado. Aqui estão alguns dos mais importantes:
1. MarkLogic:
O MarkLogic é uma solução de armazenamento de dados que facilita e agiliza a integração de dados por meio de uma variedade de recursos corporativos. Ele permite consultar diferentes tipos de dados, como documentos, relacionamentos e metadados.
https://www.marklogic.com/product/getting-started/
2. Oracle:
Oracle É o banco de dados líder do setor. Oferece uma ampla gama de soluções de data warehouse, tanto para infraestrutura local quanto na nuvem. Ajuda a otimizar a experiência do cliente, aumentando a eficiência operacional.
https://www.oracle.com/index.html
3. Amazon VermelhoShift:
Amazon O Redshift é uma ferramenta de data warehouse. É uma ferramenta simples e econômica para analisar todos os tipos de dados usando padrões. SQL e ferramentas de BI existentes. Também permite executar consultas complexas em petabytes de dados estruturados.
https://aws.amazon.com/redshift/?nc2=h_m1
Aqui está uma lista completa de úteis Ferramentas de data warehouse.
Melhores práticas para o processo ETL
A seguir, apresentamos as melhores práticas para as etapas do processo ETL:
- Nunca tente limpar todos os dados:
Toda organização gostaria de ter todos os dados limpos, mas a maioria não está disposta a pagar para esperar, ou simplesmente não quer esperar. Limpar tudo levaria muito tempo, então é melhor não tentar limpar todos os dados. - Equilibrar a limpeza com as prioridades do negócio:
Embora você deva evitar a limpeza excessiva de todos os dados, assegure-se de que os campos críticos e de alto impacto sejam limpos para garantir a confiabilidade. Concentre os esforços de limpeza nos elementos de dados que afetam diretamente as decisões de negócios e a precisão dos relatórios. - Determine o custo da limpeza dos dados:
Antes de limpar todos os dados sujos, é importante determinar o custo de limpeza para cada elemento de dados sujos. - Para acelerar o processamento de consultas, tenha visualizações e índices auxiliares:
Para reduzir custos de armazenamento, armazene dados resumidos em fitas de disco. Além disso, é necessário equilibrar o volume de dados a serem armazenados e seu uso detalhado. Trade-off no nível de granularidade dos dados para diminuir os custos de armazenamento.
