
SAP Vista di calcolo HANA: tipi e come crearla
 Team editoriale
⚡ Riepilogo intelligente
Visualizzazione del calcolo in SAP HANA è la visualizzazione delle informazioni più potente. Combina tabelle, viste a colonne, viste analitiche e altre viste di calcolo tramite nodi di join, unione, proiezione, aggregazione e ranking.
Cos'è la visualizzazione calcolo?
SAP La vista Calcolo HANA è una potente vista delle informazioni.
SAP La misura della vista analitica HANA può essere selezionata da una sola tabella dei fatti. Quando c'è bisogno di più tabelle dei fatti nella vista informativa, entra in gioco la vista di calcolo. La vista di calcolo supporta calcoli complessi.
La base dati della vista calcolo può includere tabelle, viste colonne, viste analitiche e viste calcolo.
Possiamo creare Entra a far parte, Unioni, Aggregazione e Proiezioni sulle origini dati.
La visualizzazione calcolo può contenere più misure e può essere utilizzata per il reporting multidimensionale oppure nessuna misura utilizzata nel reporting di tipo elenco.
Caratteristica di SAP Visualizzazione del calcolo HANA come di seguito:
- Supporta calcoli complessi.
- Supporta modelli OLTP e OLAP.
- Supporto nella gestione del cliente, nella lingua e nella conversione della valuta.
- Supporta Unione, Proiezione, Aggregazione, Rango, ecc.
SAP Le visualizzazioni di calcolo HANA sono di due tipi:
- SAP Visualizzazione calcolo grafico HANA (creato da SAP Editor grafico di HANA Studio).
- SAP Calcoli basati su script HANA Viste (create da script SQL di SAP Studio HANA).
Visualizzazione del calcolo grafica vs. basata su script
Le due varianti producono lo stesso tipo di oggetto, ma vengono realizzate e gestite in modo molto diverso, ed è difficile tornare indietro una volta che una vista è in produzione.
| Parametro | Grafico | Basato su script |
|---|---|---|
| Costruito con | Trascina e rilascia i nodi nell'editor | SQLScript in un blocco CE_ o SQL |
| Ottimizzazione | Il motore può eliminare i nodi inutilizzati in fase di esecuzione. | Esegue il programma come previsto, con meno margine di ottimizzazione. |
| leggibilità | Il diagramma dello scenario si documenta da sé | Dipende interamente dall'autore |
| Capacità | Soddisfa la maggior parte dei requisiti | Gestisce la logica che nessuna combinazione di nodi può esprimere |
| Manutenzione | Qualsiasi modellista può seguirlo | Sono richieste competenze in SQLScript. |
| Consigli | Scelta predefinita | Solo laddove la grafica non è davvero in grado di farlo |
Il fattore decisivo è la performance. Una vista grafica consente a HANA di scartare i nodi il cui output non è necessario per alcuna colonna della query, quindi un join inutilizzato non comporta alcun costo. Una vista basata su script esegue ogni istruzione che contiene, indipendentemente da tutto. Iniziate con la vista grafica e spostate un singolo nodo in una vista basata su script solo quando necessario.
SAP Visualizzazione calcolo grafico HANA
In SAP HANA Vista analitica, possiamo selezionare una misura da una sola tabella.
Pertanto, quando è necessario disporre di una vista che contenga misure provenienti da una tabella diversa, non è possibile ottenerla tramite la vista analitica ma tramite la vista di calcolo.
Quindi, in questo caso, possiamo utilizzare due diverse viste analitiche per ciascuna tabella e unirle nella vista di calcolo.
Creeremo una vista di calcolo grafica “CA_FI_LEDGER” unendo due viste analitiche “AN_PURCHASE_ORDER” e “AN_FI_DOCUMENT”.
CA_FI_LEDGER visualizzerà i dettagli del documento finanziario relativo a un ordine di acquisto.
Passo 1) In questa fase,
- Vai al pacchetto (qui Modellazione) e fai clic con il pulsante destro del mouse.
- Seleziona Nuova opzione.
- Selezionare Visualizzazione calcolo.
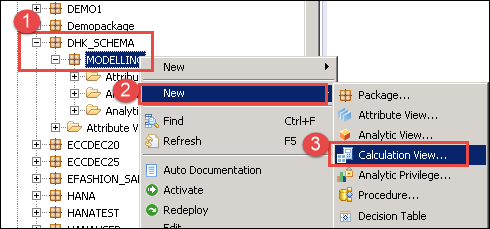
Verrà visualizzato un editor della vista di calcolo, in cui il pannello degli scenari verrà visualizzato come di seguito:
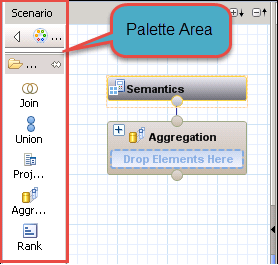
I dettagli del pannello Scenario sono i seguenti:
Tavolozza: Questa sezione contiene i seguenti nodi che possono essere utilizzati come origine per costruire le nostre viste di calcolo. Abbiamo 5 diversi tipi di nodi, che sono:
- Join: Questo nodo viene utilizzato per unire due oggetti sorgente e passare il risultato al nodo successivo. I tipi di join possono essere interno, esterno sinistro, esterno destro e join testo. Nota: Possiamo aggiungere solo due oggetti sorgente a un nodo di join.
- Unione: Viene utilizzato per eseguire l'unione di tutte le operazioni tra più origini. La fonte può essere n numero di oggetti.
- Proiezione: Viene utilizzato per selezionare colonne, filtrare i dati e creare colonne aggiuntive prima di utilizzarle nei nodi successivi come unione, aggregazione e classificazione. Nota: Possiamo aggiungere solo un oggetto sorgente in un nodo Proiezione.
- Aggregazione: Viene utilizzato per eseguire l'aggregazione su colonne specifiche in base agli attributi selezionati.
- Rango: Questo è l'esatto sostituto della funzione RANK in SQL. Possiamo definire la partizione e l'ordine per clausola in base al requisito.
Passo 2)
- Fare clic sul nodo Proiezione dalla tavolozza e trascinare e rilasciare nell'area dello scenario dalla vista analitica dell'ordine di acquisto. Rinominato in "Proiezione_PO".
- Fare clic sul nodo Proiezione dalla tavolozza e trascinare e rilasciare nell'area dello scenario per la vista analitica del documento FI. Rinominato in "Proiezione_FI".
- Trascina e rilascia le viste analitiche "AN_PURCHASE_ORDER" e "AN_FI_DOCUMENT" dalla cartella Contenuto rispettivamente al nodo "Projection_PO" e al nodo "Projection_FI".
- Fare clic su Unisci nodo dalla tavolozza e trascinare e rilasciare nell'area dello scenario.
- Unisci il nodo Projection_PO al nodo Join_1.
- Unisci il nodo Projection_FI al nodo Join_1.
- Fare clic sul nodo Aggregazione dalla tavolozza e trascinare e rilasciare nell'area dello scenario.
- Unisci il nodo Join_1 al nodo di aggregazione.
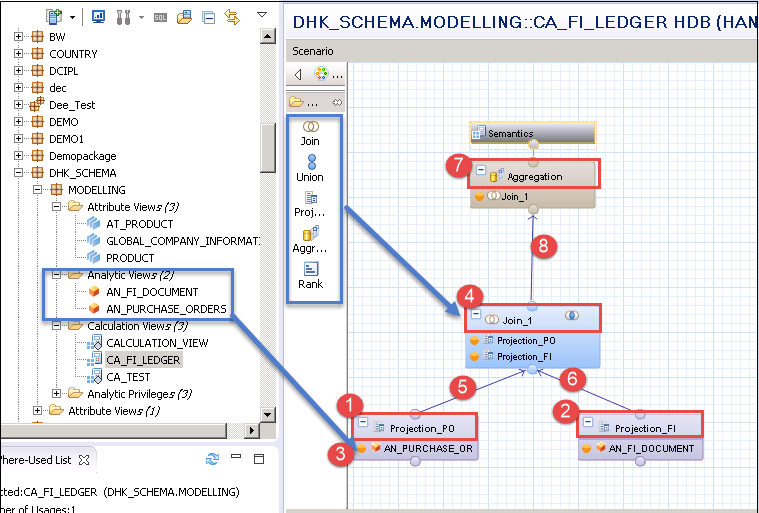
Abbiamo aggiunto due viste analitiche, per creare una vista di calcolo.
Passo 3) Fai clic sul nodo Join_1 sotto l'aggregazione e puoi vedere la sezione dei dettagli visualizzata.
- Seleziona tutte le colonne dal nodo Projection_PO per l'output.
- Seleziona tutte le colonne dal nodo Projection_FI per l'output.
- Unisci il nodo Projection_PO al nodo Projection_FI sulla colonna Projection_PO.PO_Number = Projection_FI.PO_NO.
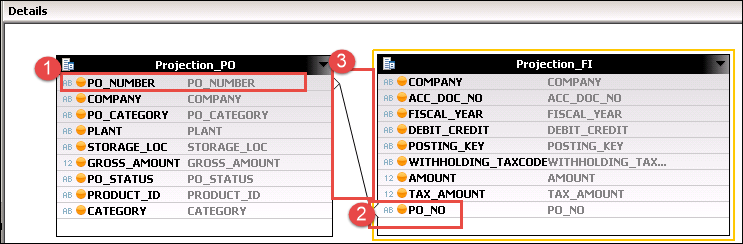
Passo 4) In questa fase,
- Fare clic sul nodo Aggregazione e i dettagli verranno visualizzati sul lato destro del riquadro.
- Selezionare la colonna per l'output dal Join_1 visualizzato sul lato destro nella finestra dei dettagli.
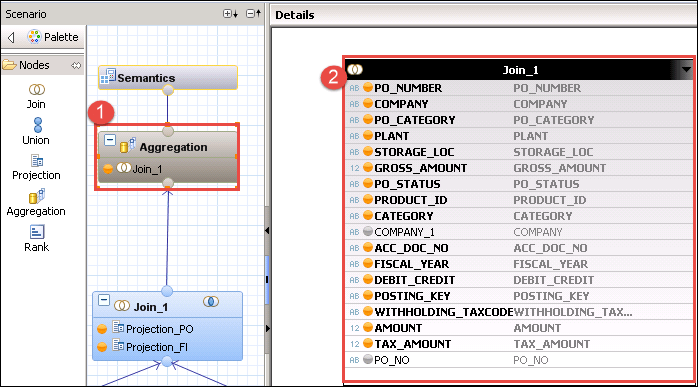
Passo 5) Ora fai clic su Nodo Semantica.
La schermata dei dettagli verrà visualizzata come di seguito. Definire l'attributo e il tipo di misura per la colonna e inoltre contrassegnare la chiave per questo output.
- Definire attributo e misura.
- Contrassegna PO_Number e COMPANY come chiave.
- Contrassegna ACC_DOC_NO come chiave.
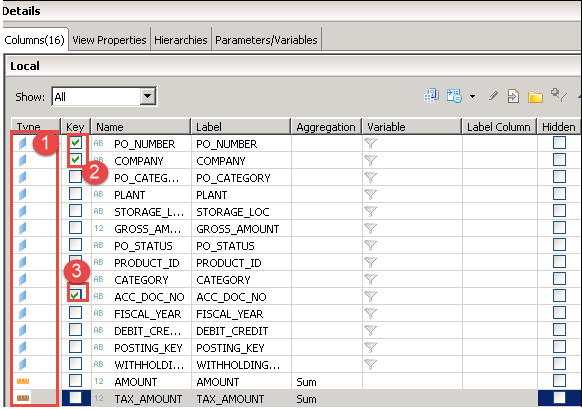
Passo 6) Convalida e attiva la vista di calcolo, dalla barra superiore della finestra.
- Fare clic sull'icona Convalida.
- Fare clic su Attiva icona.
La vista calcolo verrà attivata e verrà visualizzata nel pacchetto di modellazione come di seguito:
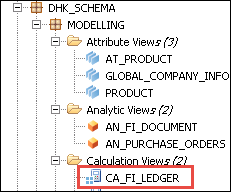
Seleziona la visualizzazione di calcolo e fai clic con il pulsante destro del mouse -> Anteprima dati
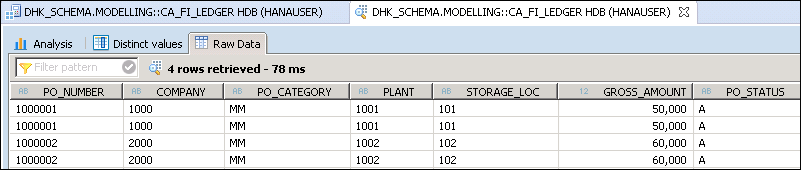
Abbiamo aggiunto due viste analitiche e selezionato la misura (TAX_AMOUNT, GROSS_AMOUNT) da entrambe le viste analitiche.
La schermata Anteprima dati verrà visualizzata come di seguito:
Funzioni CE nelle viste basate su script
⚠️ Nota sulla versione: Gli operatori del piano del motore di calcolo, le funzioni CE_ descritte di seguito, sono deprecati da SAPRimangono documentati qui perché una grande quantità di codice esistente li utilizza, ma i nuovi sviluppi dovrebbero usare SQL standard, che l'ottimizzatore ora gestisce almeno altrettanto bene. Mescolare funzioni CE_ e SQL in un'unica istruzione è anche una causa nota di piani di esecuzione scadenti.
Funzioni CE note anche come Piano del motore di calcolo Operatoro (CE Operators) sono alternativi alle istruzioni SQL.
La funzione CE è di due tipi:
Funzione di accesso all'origine dati
Questa funzione associa una tabella a colonne o una vista a colonne a una variabile di tabella. Di seguito è riportato un elenco di alcune funzioni di accesso all'origine dati:
- CE_COLUMN_TABLE
- CE_JOIN_VIEW
- CE_OLAP_VIEW
- CE_CALC_VIEW
Relazionale Operafunzione del tor
Utilizzando il Relazionale Operator, l'utente può ignorare il file SQL processore durante la valutazione e comunica direttamente con il motore di calcolo. Di seguito sono riportati alcuni esempi relazionali. Operato Elenco funzioni –
- CE_JOIN (Viene utilizzato per eseguire un inner join tra due origini dati e leggere le colonne/i dati richiesti.)
- CE_RIGHT_OUTER_JOIN (Viene utilizzato per eseguire un right outer join tra le due sorgenti e visualizzare le colonne interrogate nell'output.)
- CE_LEFT_OUTER_JOIN (Viene utilizzato per eseguire un left outer join tra le sorgenti e visualizzare le colonne interrogate nell'output).
- CE_PROJECTION (Questa funzione visualizza le colonne specifiche dalla sorgente e applica filtri per limitare i dati. Fornisce anche funzionalità di alias per i nomi delle colonne.)
- CE_CALC (Viene utilizzato per calcolare colonne aggiuntive in base ai requisiti aziendali. Corrisponde alla colonna calcolata nei modelli grafici.)
Di seguito è riportato un elenco di SQL con funzione CE con alcuni esempi-
| Nome della domanda | Query SQL | CE-Build in funzione |
|---|---|---|
| Seleziona la query sulla tabella delle colonne | SELEZIONA C, D da “COLUMN_TABLE”. | CE_COLUMN_TABLE(“COLUMN_TABLE”,[C,D]) |
| Seleziona Query sulla vista attributi | SELEZIONA C, D da "ATTRIBUTE_VIEW" | CE_JOIN_VIEW("ATTRIBUTE_VIEW",[C,D]) |
| Selezionare Query sulla vista analitica | SELEZIONA C, D, SUM(E) da “ANALYTIC_VIEW” Raggruppa per C,D | CE_OLAP_VIEW("VISTA_ANALITICA",[C,D]) |
| Selezionare Query sulla vista calcolo | SELEZIONA C, D, SOMMA(E) Da “CALCULATION_VIEW” Raggruppa per C,D | CE_CALC_VIEW("CALCOLO_VIEW",[C,D]) |
| Dove Avere | SELECT C, D, SUM(E) FROM “ANALYTIC_VIEW” WHERE C = 'value' | var1 = CE_COLUMN_TABLE(“COLUMN_TABLE”); CE_PROJECTION(:var1,[C,D],'”C” = ”value”') |
Tipi di visualizzazione dei calcoli: Dimensione, Cubo e Cubo con unione a stella
Corrente SAP Le release di HANA richiedono una categoria di dati quando si crea una vista di calcolo, e la scelta determina le funzionalità della vista e il modo in cui gli strumenti di reporting la gestiscono.
| Categoria di dati | Contiene misure | Star join disponibile | Sostituisce |
|---|---|---|---|
| Dimensioni | Nodo | Nodo | Vista attributi |
| Cubo | Si | Nodo | Semplici scenari analitici |
| Cubo con unione a stella | Si | Si | Prospettiva analitica |
Ecco perché i progetti attuali spesso creano solo viste di calcolo. Una vista di categoria Dimensione svolge il lavoro di un vista attributie il cubo con Star Join fa il lavoro di un vista analiticaPertanto, un singolo tipo di oggetto copre l'intero modello. Le viste attributive e analitiche esistenti continuano a funzionare e i concetti si mappano direttamente sulle categorie sopra descritte.
Suggerimenti per le prestazioni della visualizzazione dei calcoli
Una vista di calcolo è sufficientemente flessibile da poter essere costruita in modo approssimativo, e lo stesso scenario può essere eseguito in un secondo o in un minuto a seconda di come sono disposti i nodi. Sei regole coprono la maggior parte di questa differenza.
- Filtrare il prima possibile. Posiziona un filtro nella proiezione più vicina alla sorgente. Filtrare dopo un'aggregazione significa che l'intero set di dati è stato prima aggregato e poi la maggior parte di esso è stata scartata.
- Aggregare prima di unire, ove possibile. Unire due grandi insiemi di dettagli e aggregarli successivamente sposta molte più righe rispetto ad aggregare prima ciascun lato.
- Seleziona solo le colonne di cui hai bisogno. Ogni colonna che attraversa un nodo viene mantenuta in memoria per l'intera durata dell'esecuzione e le colonne non utilizzate bloccano la potatura del nodo.
- Preferisco l'unione per combinare dati simili. Sovrapporre i dati effettivi e quelli previsti è un'unione. Esprimerla come un join moltiplica le righe e poi richiede un filtro per annullare l'effetto.
- Osserva la cardinalità dell'unione. Dichiarare 1..1 dove i dati sono 1..N duplica le righe e gonfia ogni misura, che è la causa più comune di totali errati.
- Evitate di sovrapporre le viste troppo in profondità. Una vista di calcolo su una vista di calcolo su una vista analitica è legale, ma difficile da ottimizzare e ancora più difficile da sottoporre a debug. Di solito due livelli sono sufficienti.
Utilizza gli strumenti di analisi delle prestazioni nell'editor invece di procedere per tentativi. PianificaViz mostra quale nodo ha consumato il tempo e la risposta è spesso un filtro posizionato un nodo troppo tardi. L'approccio più ampio è descritto nel SAP Modellazione HANA tutorial e alternative procedurali in Script SQL.
