
Cos'è il test di recupero? con l'esempio
 Tommaso Hamilton
⚡ Riepilogo intelligente
Il test di ripristino verifica che il software sia in grado di riprendere il normale funzionamento dopo un arresto anomalo, un'interruzione di rete o un guasto hardware, ripristinando il sistema a un punto di funzionamento noto e rielaborando le transazioni fino al momento del guasto.
Che cosa sono i test di recupero?
Test di recupero Il test di ripristino è una tecnica di test del software che verifica la capacità del software di riprendersi da guasti quali crash del software o dell'hardware e guasti di rete. Lo scopo del test di ripristino è determinare se le operazioni del software possono continuare dopo un disastro o una perdita di integrità. Il test di ripristino prevede il ripristino del software a un punto in cui l'integrità era nota e la rielaborazione delle transazioni fino al punto del guasto.
Nell'ingegneria del software, il test di recuperabilità è un tipo di test non funzionali — copre aspetti non legati a una funzione specifica o a un'azione dell'utente, come la scalabilità o la sicurezza. Viene eseguito da tester professionisti e, prima dell'esecuzione, vengono conservati in luoghi sicuri adeguati dati di backup.
Esempio di test di recupero
Due scenari illustrano la tecnica nella sua forma più semplice. In ciascuno di essi, si provoca deliberatamente un errore e si osserva l'applicazione mentre riprende a funzionare.
- Interruzione di rete: Mentre un'applicazione sta ricevendo dati dalla rete, scollegare il cavo di connessione. Dopo un po' di tempo, ricollegarlo e verificare se l'applicazione è in grado di continuare a ricevere dati dal punto in cui la connessione è stata interrotta.
- Ripristino della sessione: Riavvia il sistema mentre un browser ha un certo numero di sessioni aperte e verifica se il browser le recupera tutte.
L'illustrazione sottostante presenta lo stesso concetto in forma visiva.
Il tempo necessario per il recupero dipende da:
- Il numero di punti di riavvio
- Il volume dei dati contenuti nell'applicazione
- Formazione e competenze delle persone che conducono attività di recupero e strumenti disponibili per il recupero
In caso di guasti multipli, i test di ripristino dovrebbero essere eseguiti in modo strutturato anziché tutti in una volta, ovvero prima su un segmento e poi su un altro.
Ciclo di vita del processo di recupero
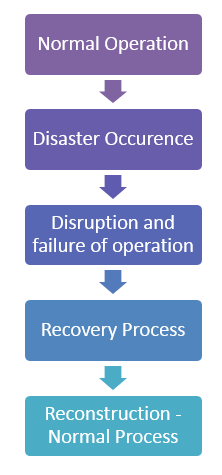
Prima di progettare i casi di test, è utile capire dove interviene un test di ripristino. Il ciclo di vita del processo di ripristino si articola in cinque fasi:
- Operazione normale
- Evento del disastro
- Interruzione e fallimento dell'operazione
- Eliminazione del disastro attraverso il processo di recupero
- Ricostruzione di tutti i processi e le informazioni, riportando l'intero sistema al normale funzionamento.
Il diagramma di flusso sottostante mostra queste cinque fasi in sequenza.
Analizziamo nel dettaglio questi cinque passaggi:
- Operazione normale. Un sistema composto da hardware, software e firmware, integrati per raggiungere un obiettivo comune, svolge la funzione per cui è stato progettato senza interruzioni entro un periodo di tempo prestabilito.
- Evento catastrofico. Un'interruzione può verificarsi a causa di un malfunzionamento del software, dovuto a cause quali un errore di input, un arresto anomalo causato da un guasto hardware o danni derivanti da incendio, furto o impatto.
- Interruzione e fallimento. Questa è la fase più dolorosa, che comporta perdite economiche, rottura dei rapporti, opportunità mancate, perdita di ore lavorative e, inevitabilmente, perdite finanziarie e di reputazione. Un piano di ripristino d'emergenza riduce al minimo questa fase.
- Sgombero post-disastro. Se sono già in atto un piano di backup e processi di mitigazione del rischio, il ripristino richiede molto meno tempo e impegno. Un team dedicato, con ruoli definiti in anticipo per ciascun membro, chiarisce le responsabilità e previene lunghi periodi di interruzione.
- Ricostruzione. Questa operazione potrebbe richiedere più sessioni per ricostruire tutte le cartelle e i file di configurazione. Per un ripristino corretto sono necessari una documentazione adeguata e un processo di ricostruzione ben definito.
Strategia di restauro
Il team di ripristino dovrebbe avere una propria strategia per recuperare codice e dati importanti al fine di riportare le operazioni alla normalità. Tale strategia è specifica per ogni organizzazione, in base alla criticità dei sistemi che gestisce, e per i sistemi critici si riduce a una serie di scelte:
- Un singolo backup o più di uno
- Backup multipli in un unico posto o in posti diversi.
- Backup online o backup offline
- I backup vengono eseguiti automaticamente in base a una policy oppure attivati manualmente.
- Un team di restauro indipendente o il team di sviluppo che esegue i lavori
Ogni scelta comporta un fattore di costo e più backup possono consumare più risorse fisiche o richiedere un team indipendente. Anche la dipendenza è importante: le aziende sono esposte attraverso il codice e i dati che mantengono con un unico fornitore e un'ampia scala AWS L'interruzione del servizio ha ripetutamente messo offline contemporaneamente noti servizi di consumo. In questi casi, la capacità di ripristino indipendente è fondamentale.
Come eseguire i test di recupero
Una volta definita la strategia, la domanda successiva riguarda la configurazione del test stesso. Durante l'esecuzione dei test di ripristino, è necessario tenere in considerazione i seguenti punti.
- Creare un ambiente di test che riproduca il più fedelmente possibile le condizioni di implementazione reali: interfaccia, protocollo, firmware, hardware e software devono corrispondere a quelli di produzione.
- Sebbene i test esaustivi possano richiedere tempo e comportare costi elevati, è comunque opportuno eseguire una configurazione identica e un controllo completo.
- Se possibile, esegui un test sull'hardware su cui verrà effettuato il ripristino finale, soprattutto se il ripristino avviene su una macchina diversa da quella che ha creato il backup.
- Alcuni sistemi di backup prevedono che il disco rigido abbia esattamente le stesse dimensioni di quello da cui è stato eseguito il backup.
- Gestire l'obsolescenza: la tecnologia delle unità avanza rapidamente e una vecchia unità potrebbe non essere compatibile con una nuova. Il ripristino a un macchina virtuale È utile perché il software di virtualizzazione può emulare l'hardware esistente, comprese le dimensioni dei dischi.
- Anche i sistemi di backup online sono soggetti a test. La maggior parte dei fornitori protegge gli utenti dai problemi relativi ai supporti di memorizzazione tramite sistemi di archiviazione a tolleranza di errore, pertanto i guasti si manifestano in un secondo momento.
- Sebbene i sistemi di backup online siano estremamente affidabili, è necessario testare la fase di ripristino per verificare che non vi siano problemi di recupero, sicurezza o crittografia.
Poiché il recupero viene eseguito dall'inizio alla fine, queste corse sono solitamente programmate insieme test di sistema piuttosto che a livello di unità.
Procedura di collaudo dopo il restauro
Il ripristino dei dati è solo metà del lavoro; la copia ripristinata deve ancora essere dimostrata utilizzabile. La maggior parte delle grandi aziende si affida a revisori esterni per condurre periodicamente esercitazioni di ripristino. Un piano completo di disaster recovery è costoso da mantenere e testare, quindi le organizzazioni più piccole spesso si affidano a backup e archiviazione esterna.
Dopo il ripristino di cartelle e file, i seguenti controlli confermano che il recupero è avvenuto correttamente:
- Rinominare la cartella del documento danneggiato in modo che la copia ripristinata non possa essere confusa con essa.
- Conta i file nelle cartelle ripristinate e confronta il conteggio con quello della cartella originale.
- Apri alcuni file con l'applicazione che li utilizza normalmente e verifica che i dati possano essere visualizzati e aggiornati come di consueto.
- Apri diversi file di vario tipo: immagini, MP3e documenti, alcuni grandi e altri piccoli.
- Utilizza le utilità di confronto di file e directory che più sistemi operativi fornire.
