
ETL (ExtracProcesso di trasformazione e caricamento (t, e) in un data warehouse
 David Carter
Riepilogo intelligente
ETL (ExtracIl processo (t, Trasforma e Carica) in un Data Warehouse descrive il flusso sistematico di spostamento dei dati da più fonti eterogenee a un repository centralizzato. Garantisce coerenza, accuratezza e prontezza dei dati per l'analisi attraverso un'elaborazione strutturata.tracmeccanismi di zione, trasformazione e caricamento ottimizzati.
Che cos'è ETL?
ETL è un processo che extracETL raccoglie i dati da diversi sistemi sorgente, quindi trasforma i dati (ad esempio applicando calcoli, concatenazioni, ecc.) e infine carica i dati nel sistema di data warehouse. La forma completa di ETL è Extract, Trasforma e Carica.
È allettante pensare che la creazione di un Data Warehouse implichi semplicemente l'extracRaccogliere dati da più fonti e caricarli in un database. Tuttavia, in realtà, ciò richiede un complesso processo ETL. Il processo ETL richiede il contributo attivo di diverse figure professionali, tra cui sviluppatori, analisti, tester e dirigenti di alto livello, ed è tecnicamente impegnativo.
Per mantenere il suo valore come strumento per i decisori, il sistema di data warehouse deve evolversi con i cambiamenti aziendali. L'ETL è un'attività ricorrente (giornaliera, settimanale o mensile) di un sistema di data warehouse e deve essere agile, automatizzata e ben documentata.


Perché hai bisogno di ETL?
Ci sono molte ragioni per adottare l’ETL nell’organizzazione:
- Aiuta le aziende ad analizzare i dati aziendali per prendere decisioni aziendali critiche.
- I database transazionali non possono rispondere a domande aziendali complesse a cui è possibile rispondere con un esempio ETL.
- Un data warehouse fornisce un repository di dati comune
- ETL fornisce un metodo per spostare i dati da varie origini in un data warehouse.
- Man mano che le fonti dati cambiano, il data warehouse si aggiorna automaticamente.
- Un sistema ETL ben progettato e documentato è pressoché essenziale per il successo di un progetto di data warehouse.
- Consentire la verifica delle regole di trasformazione, aggregazione e calcolo dei dati.
- Il processo ETL consente il confronto dei dati campione tra il sistema di origine e quello di destinazione.
- Il processo ETL può eseguire trasformazioni complesse e richiede un'area aggiuntiva per memorizzare i dati.
- ETL aiuta a migrare i dati in un Data Warehouse, convertendo diversi formati e tipologie in un unico sistema coerente.
- ETL è un processo predefinito per accedere e manipolare i dati di origine nel database di destinazione.
- L'ETL in un data warehouse offre un contesto storico approfondito per l'azienda.
- Aiuta a migliorare la produttività perché codifica e riutilizza senza bisogno di competenze tecniche.
Una volta compreso il valore dell'ETL, approfondiamo il processo in tre fasi che fa funzionare tutto.
Processo ETL nei data warehouse
L'ETL è un processo in 3 fasi
Passo 1) Es.tracproduzione
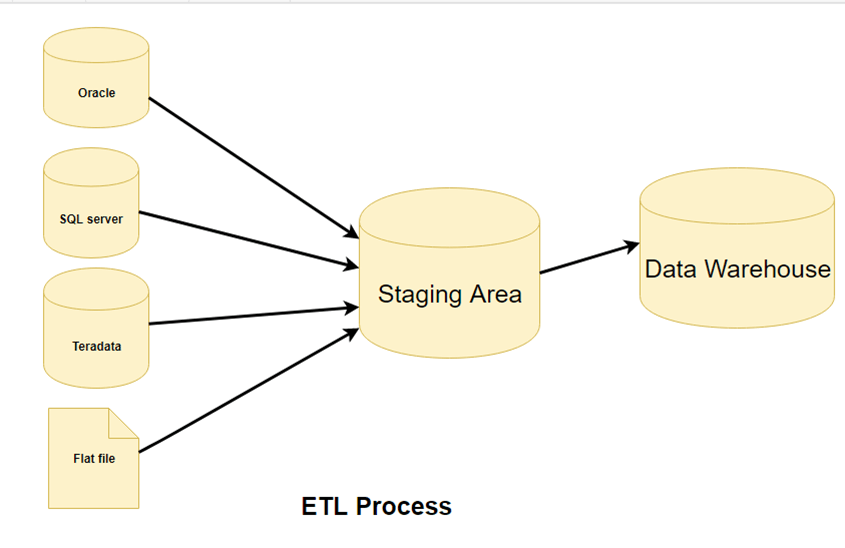
In questa fase dell'architettura ETL, i dati vengono espressitracTrasferiti dal sistema sorgente all'area di staging. Le trasformazioni, se presenti, vengono eseguite nell'area di staging in modo che le prestazioni del sistema sorgente non vengano degradate. Inoltre, se dati corrotti vengono copiati direttamente dalla sorgente nel database del data warehouse, il rollback sarà problematico. L'area di staging offre l'opportunità di convalidare l'extracelabora i dati prima che vengano spostati nel data warehouse.
Il data warehouse deve integrare sistemi che hanno diversi DBMS, Hardware, OperaSistemi di elaborazione e protocolli di comunicazione. Le fonti potrebbero includere applicazioni legacy come mainframe, applicazioni personalizzate, dispositivi di punto di contatto come bancomat, commutatori di chiamata, file di testo, fogli di calcolo, ERP, dati da fornitori e partner, tra gli altri.
Pertanto, è necessaria una mappa logica dei dati prima che i dati vengano espressitracted e caricato fisicamente. Questa mappa dei dati descrive la relazione tra i dati di origine e quelli di destinazione.
Tre dati Extracmetodi di zione:
- Esame completotracproduzione
- Esame parzialetraczione - senza notifica di aggiornamento.
- Esame parzialetraczione con notifica di aggiornamento
Indipendentemente dal metodo utilizzato, ad esempiotracL'operazione non deve influire sulle prestazioni e sui tempi di risposta dei sistemi sorgente. Questi sistemi sorgente sono database di produzione attivi. Qualsiasi rallentamento o blocco potrebbe avere un impatto negativo sui profitti dell'azienda.
Alcune convalide vengono eseguite durante Extraczione:
- Riconciliare i record con i dati di origine
- Assicurati che non vengano caricati dati indesiderati/spam
- Controllo del tipo di dati
- Rimuovi tutti i tipi di dati duplicati/frammentati
- Controllare che tutte le chiavi siano al loro posto.
Passaggio 2) Trasformazione
Dati extracI dati provenienti dal server sorgente sono grezzi e non utilizzabili nella loro forma originale. Pertanto, devono essere ripuliti, mappati e trasformati. Infatti, questo è il passaggio chiave in cui il processo ETL aggiunge valore e modifica i dati in modo tale da poter generare report di business intelligence significativi.
È uno dei concetti ETL importanti in cui si applica un insieme di funzioni su extracdati ted. I dati che non richiedono alcuna trasformazione sono chiamati mossa diretta or dati pass-through.
Nella fase di trasformazione, è possibile eseguire operazioni personalizzate sui dati. Ad esempio, se l'utente desidera la somma del fatturato non presente nel database. Oppure se il nome e il cognome in una tabella si trovano in colonne diverse, è possibile concatenarli prima del caricamento.

Di seguito sono riportati i dati Integrity Problemi di:
- Diverse grafie della stessa persona, come Jon, John, ecc.
- Esistono diversi modi per indicare il nome di un'azienda, come Google, Google Inc.
- Utilizzo di nomi diversi come Cleveland e Cleveland.
- Potrebbe verificarsi il caso in cui diverse applicazioni generino numeri di conto diversi per lo stesso cliente.
- In alcuni casi, i file dei dati richiesti rimangono vuoti
- Prodotto non valido ritirato al POS, poiché l'inserimento manuale può causare errori.
Le convalide vengono effettuate durante questa fase
- Filtraggio: seleziona solo determinate colonne da caricare
- Utilizzo di regole e tabelle di ricerca per la standardizzazione dei dati
- Conversione del set di caratteri e gestione della codifica
- Conversione di unità di misura, come conversioni di data e ora, conversioni di valuta, conversioni numeriche, ecc.
- Controllo di convalida della soglia dei dati. Ad esempio, l'età non può essere superiore a due cifre.
- Validazione del flusso dati dall'area di staging alle tabelle intermedie.
- I campi obbligatori non devono essere lasciati vuoti.
- Pulizia (ad esempio, mappa)ping NULL a 0 o Genere Maschio a “M” e Femmina a “F”, ecc.)
- Dividi una colonna in più colonne e unisci più colonne in un'unica colonna.
- Trasposizione di righe e colonne,
- Utilizza le ricerche per unire i dati
- Utilizzando qualsiasi convalida di dati complessa (ad esempio, se le prime due colonne di una riga sono vuote, la riga viene automaticamente rifiutata dall'elaborazione)
Passaggio 3) Caricamento
Il caricamento dei dati nel database del data warehouse di destinazione è l'ultimo passaggio del processo ETL. In un tipico data warehouse, un enorme volume di dati deve essere caricato in un periodo di tempo relativamente breve (qualche notte). Pertanto, il processo di caricamento deve essere ottimizzato per le prestazioni.
In caso di interruzione del carico, i meccanismi di ripristino devono essere configurati per riavviare il sistema dal punto in cui si è verificato l'errore senza perdita di integrità dei dati. Gli amministratori del data warehouse devono monitorare, riprendere e annullare i carichi in base alle prestazioni del server.
Tipi di caricamento:
- Carico iniziale — popolando tutte le tabelle del data warehouse
- Carico incrementale — applicando periodicamente modifiche continue secondo necessità.
- Aggiornamento completo —cancellare il contenuto di una o più tabelle e ricaricarlo con nuovi dati.
Verifica del carico
- Assicurarsi che i dati del campo chiave non siano né mancanti né nulli.
- Testare le viste di modellazione in base alle tabelle di destinazione.
- Controllare che i valori combinati e le misure calcolate.
- Controlli dei dati nella tabella delle dimensioni e nella tabella della cronologia.
- Controllare i report BI sulla tabella dei fatti e delle dimensioni caricata.
Pipelining ETL ed elaborazione parallela
La pipeline ETL consente l'extraczione, trasformazione e caricamento devono avvenire contemporaneamente invece che in modo sequenziale. Non appena una porzione di dati viene estrattatracted, viene trasformato e caricato mentre i nuovi dati esprimonotracLa zione continua. Questa elaborazione parallela migliora notevolmente le prestazioni, riduce i tempi di inattività e massimizza l'utilizzo delle risorse del sistema.
Questa elaborazione parallela è essenziale per analisi in tempo reale, integrazione di dati su larga scala e sistemi ETL basati su cloud. Per sovrapposizioneping Grazie all'elaborazione pipeline dei dati, le attività ETL garantiscono un trasferimento dati più rapido, una maggiore efficienza e una consegna dei dati più coerente per le aziende moderne.
In che modo l'intelligenza artificiale migliora le moderne pipeline ETL?
Intelligenza Artificiale revolutIonizza l'ETL rendendo le pipeline di dati adattive, intelligenti e auto-ottimizzanti. Gli algoritmi di intelligenza artificiale possono mappare automaticamente gli schemi, rilevare anomalie e prevedere le regole di trasformazione senza configurazione manuale. Ciò consente ai flussi di lavoro ETL di gestire senza sforzo strutture di dati in continua evoluzione, mantenendo al contempo la qualità dei dati.
Le moderne piattaforme ETL potenziate dall'IA sfruttano tecnologie come AutoML per l'ingegneria automatica delle funzionalità e la mappatura dello schema basata sull'elaborazione del linguaggio naturale.ping che comprende le relazioni semantiche tra i campi e gli algoritmi di rilevamento delle anomalie che identificano i problemi di qualità dei dati in tempo reale. Queste funzionalità riducono significativamente lo sforzo manuale tradizionalmente richiesto nello sviluppo e nella manutenzione dei processi ETL.
apprendimento automatico Migliora l'ottimizzazione delle prestazioni, garantendo un'integrazione dei dati più rapida e accurata. Introducendo l'automazione e l'intelligenza predittiva, l'ETL basato sull'intelligenza artificiale fornisce informazioni in tempo reale e favorisce una maggiore efficienza negli ecosistemi di dati cloud e ibridi.
Per implementare i concetti discussi sopra, le organizzazioni si affidano a strumenti ETL specializzati. Ecco alcune delle principali opzioni disponibili sul mercato.
Strumenti ETL
Ci sono molti Strumenti ETL disponibili sul mercato. Ecco alcuni dei più importanti:
1. SegnaLogica:
MarkLogic è una soluzione di data warehousing che semplifica e velocizza l'integrazione dei dati grazie a una serie di funzionalità aziendali. Può interrogare diversi tipi di dati, come documenti, relazioni e metadati.
https://www.marklogic.com/product/getting-started/
2. Oracle:
Oracle è il database leader del settore. Offre un'ampia gamma di soluzioni di data warehouse sia on-premise che nel cloud. Contribuisce a ottimizzare l'esperienza dei clienti aumentando l'efficienza operativa.
https://www.oracle.com/index.html
3. Amazon RossoShift:
Amazon Redshift è uno strumento di data warehouse. È uno strumento semplice ed economico per analizzare tutti i tipi di dati utilizzando standard SQL e strumenti di BI esistenti. Consente inoltre di eseguire query complesse su petabyte di dati strutturati.
https://aws.amazon.com/redshift/?nc2=h_m1
Ecco un elenco completo di utili Strumenti di data warehouse.
migliori pratiche per il processo ETL
Di seguito sono riportate le best practice per le fasi del processo ETL:
- Non tentare mai di pulire tutti i dati:
Ogni organizzazione vorrebbe che tutti i dati fossero puliti, ma la maggior parte di esse non è disposta a pagare per aspettare, o non è disposta ad aspettare. Pulirli tutti richiederebbe semplicemente troppo tempo, quindi è meglio non tentare di ripulire tutti i dati. - Bilanciare la pulizia con le priorità aziendali:
Sebbene sia opportuno evitare di pulire eccessivamente tutti i dati, è importante assicurarsi che i campi critici e ad alto impatto siano puliti per garantire l'affidabilità. Concentrare gli sforzi di pulizia sugli elementi di dati che influenzano direttamente le decisioni aziendali e l'accuratezza dei report. - Determinare il costo della pulizia dei dati:
Prima di pulire tutti i dati sporchi, è importante determinare il costo di pulizia per ogni elemento di dati sporchi. - Per velocizzare l'elaborazione delle query, disponi di visualizzazioni e indici ausiliari:
Per ridurre i costi di archiviazione, archiviare i dati riepilogati su nastri su disco. Inoltre, è necessario trovare un compromesso tra il volume dei dati da archiviare e il loro utilizzo dettagliato. Compromesso a livello di granularità dei dati per ridurre i costi di archiviazione.
