
magazzino dati Archistruttura, componenti e diagramma Concepts
 David Carter
⚡ Riepilogo intelligente
magazzino dati ArchiLa struttura definisce come i dati storici e cumulativi provenienti da molteplici fonti vengono organizzati in livelli gerarchici e componenti interconnessi, consentendo una reportistica e un'analisi affidabili, nonché un'unica versione della verità per il processo decisionale e le previsioni aziendali.
magazzino dati Concepts
A data warehouse Esiste per fornire a un'azienda un'unica versione della verità per il processo decisionale e le previsioni. Si tratta di un sistema informativo che contiene dati storici e cumulativi provenienti da una o più fonti.
Organizzando i dati per l'analisi anziché per le transazioni, un data warehouse semplifica il lavoro di reporting e analisi dell'intera organizzazione.
Caratteristiche del Data Warehouse
Un data warehouse possiede quattro caratteristiche distintive che lo differenziano da un normale database operativo:
- Orientato al soggetto
- Integrato
- Variante temporale
- Non volatile
Orientato al soggetto
Un data warehouse è orientato a un tema specifico perché fornisce informazioni relative a una determinata tematica, piuttosto che alle attività operative quotidiane di un'azienda. Tra i temi tipici si annoverano vendite, marketing e distribuzione.
Anziché concentrarsi sull'elaborazione quotidiana, il data warehouse privilegia la modellazione e l'analisi a supporto del processo decisionale. Offre una visione semplice e concisa di ciascun argomento, escludendo i dati non pertinenti al processo decisionale.
Integrato
L'integrazione è strettamente legata all'orientamento tematico. In un data warehouse, l'integrazione significa stabilire un'unità di misura comune per tutti i dati simili provenienti da database diversi e archiviare tali dati in un modo comune e universalmente accettabile.
Un data warehouse si costruisce integrando dati provenienti da diverse fonti, come mainframe, database relazionali e file di testo. Deve inoltre mantenere convenzioni di denominazione, formati e codifica coerenti.
Questa coerenza nella denominazione, nelle misure degli attributi e nella struttura di codifica è ciò che rende possibile un'analisi efficace. Si consideri il seguente esempio:
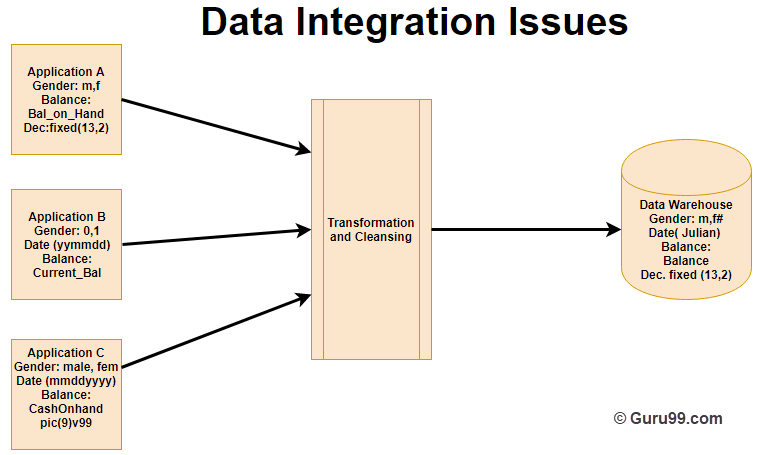
Nell'esempio precedente, tre applicazioni etichettate A, B e C memorizzano ciascuna informazioni relative a genere, data e saldo, ma ognuna le memorizza in modo diverso:
- L'applicazione A memorizza il campo relativo al genere come valori logici quali M o F.
- L'applicazione B memorizza il campo relativo al genere come valore numerico.
- L'applicazione C memorizza il campo relativo al genere come valore di tipo carattere.
- La stessa variazione si applica ai campi Data e Saldo.
Dopo il processo di trasformazione e pulizia, tutti questi dati vengono archiviati in un formato comune all'interno del data warehouse.
Variante temporale
L'orizzonte temporale di un data warehouse è molto più ampio di quello di un sistema operativo. I dati sono identificati con un periodo specifico e offrono una prospettiva storica, quindi portano sempre con sé un elemento temporale, in modo esplicito o implicito.
Una delle cause di questa discrepanza temporale risiede nella struttura della chiave primaria del record. Ogni chiave primaria nel data warehouse dovrebbe includere un elemento temporale, come il giorno, la settimana o il mese.
Un altro aspetto della variabilità temporale è che, una volta inseriti i dati nel data warehouse, non possono essere aggiornati o modificati.
Non volatile
Un data warehouse è inoltre non volatile, il che significa che i dati precedenti non vengono cancellati all'arrivo di nuovi dati. I dati sono di sola lettura e vengono aggiornati periodicamente, il che aiuta gli analisti a studiare i dati storici e a capire cosa è successo e quando.
Poiché non necessita di elaborazione delle transazioni, ripristino o controllo della concorrenza, un data warehouse omette le attività di eliminazione, aggiornamento e inserimento comuni in un'applicazione operativa. Nel data warehousing vengono eseguite solo due operazioni sui dati:
- Caricamento dei dati
- Accesso ai dati
La tabella seguente evidenzia alcune delle principali differenze tra un'applicazione operativa e un data warehouse:
| Operaapplicazione nazionale | magazzino dati |
|---|---|
| È necessario codificare programmi complessi per garantire che i processi di aggiornamento dei dati mantengano un'elevata integrità del prodotto finale. | Questo tipo di problema non si verifica perché non viene eseguito l'aggiornamento dei dati. |
| I dati vengono inseriti in un formato normalizzato per garantire una ridondanza minima. | I dati non vengono memorizzati in forma normalizzata. |
| La tecnologia necessaria per supportare le problematiche relative a transazioni, recupero dati, rollback e risoluzione dei deadlock è piuttosto complessa. | Offre una relativa semplicità nella tecnologia. |
magazzino dati Architectura
magazzino dati ArchiLa struttura è complessa perché il sistema memorizza dati storici e cumulativi provenienti da più fonti. Esistono tre approcci per la costruzione dei livelli del data warehouse: a livello singolo, a due livelli e a tre livelli.
Architettura a livello singolo Mira a minimizzare la quantità di dati memorizzati eliminando la ridondanza. È raramente utilizzato nella pratica.
Architettura a due livelli Separa le fonti fisicamente disponibili dal data warehouse. Non è facilmente espandibile, supporta un numero limitato di utenti finali e può presentare problemi di connettività a causa delle limitazioni di rete.
Architettura a tre livelli è il modello di data warehouse più diffuso.
È costituito da tre livelli: superiore, intermedio e inferiore:
- Livello inferiore: Il database del data warehouse funge da livello inferiore. Solitamente si tratta di un sistema di database relazionale, in cui i dati vengono ripuliti, trasformati e caricati utilizzando strumenti di back-end.
- Livello intermedio: Il livello intermedio è un server OLAP implementato utilizzando il modello ROLAP o MOLAP. Presenta un'astrazionetracFornisce una visione d'insieme del database e funge da mediatore tra l'utente finale e il database.
- Livello superiore: Il livello superiore è un livello client front-end. Contiene gli strumenti e le API utilizzati per connettersi e prelevare dati dal data warehouse, come strumenti di interrogazione, strumenti di reporting, strumenti di gestione delle query, strumenti di analisi e strumenti di data mining.
Componenti del datawarehouse
I componenti e l'architettura complessiva di un data warehouse lavorano insieme come mostrato nel diagramma seguente.
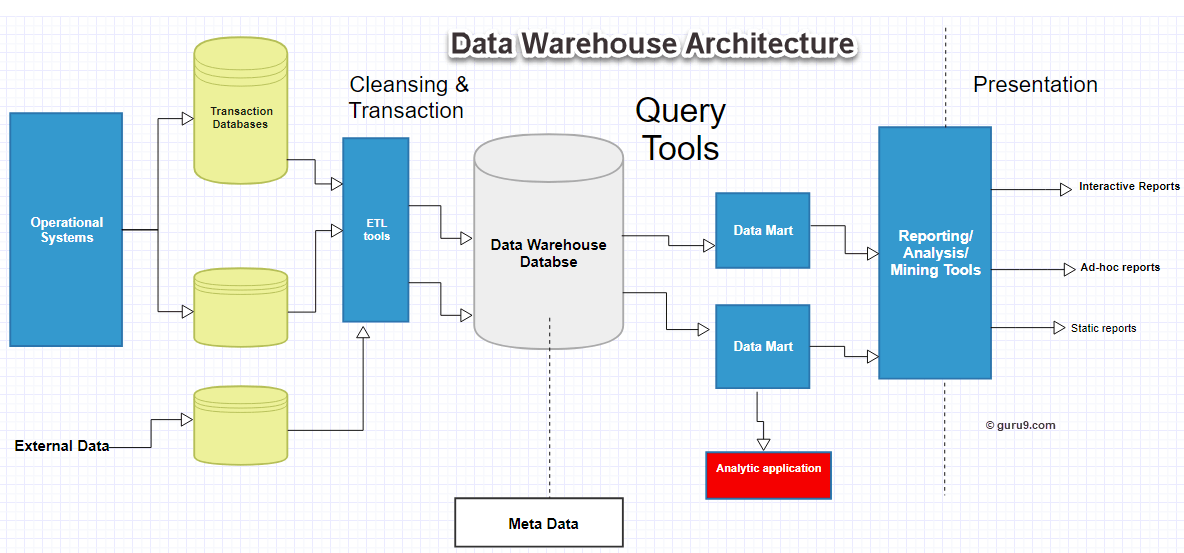
Il data warehouse si basa su un server RDBMS, un archivio centrale di informazioni circondato da componenti chiave che mantengono l'intero ambiente funzionale, gestibile e accessibile.
Un data warehouse è composto da cinque componenti principali, descritte di seguito.
Database del data warehouse
Il database centrale è il fondamento dell'ambiente di warehousing ed è implementato su RDBMS tecnologia. Poiché un RDBMS tradizionale è ottimizzato per l'elaborazione delle transazioni piuttosto che per il data warehousing, operazioni che richiedono molte risorse, come query ad hoc, join tra più tabelle e aggregazioni, possono rallentarlo.
Per questo motivo, vengono utilizzati approcci alternativi basati su database:
- I database relazionali vengono distribuiti in parallelo per consentire la scalabilità, utilizzando modelli a memoria condivisa o senza condivisione di risorse su varie configurazioni multiprocessore o massivamente parallele.
- Vengono utilizzate nuove strutture di indice per evitare le scansioni delle tabelle relazionali e migliorare la velocità.
- I database multidimensionali (MDDB) vengono utilizzati per superare i limiti dei modelli di data warehouse relazionali. Un esempio è Essbase da Oracle.
Strumenti di approvvigionamento, acquisizione, pulizia e trasformazione (ETL)
Gli strumenti di acquisizione, trasformazione e migrazione dei dati eseguono tutte le conversioni, le sintesi e le modifiche necessarie per trasformare i dati in un formato di data warehouse unificato. Sono anche chiamati ExtracStrumenti di trasformazione, caricamento e implementazione (ETL).
Le loro funzionalità includono le seguenti:
- Anonimizza i dati secondo le disposizioni normative.
- Elimina i dati indesiderati dai database operativi prima di caricarli nel data warehouse.
- Cerca e sostituisci nomi e definizioni comuni per i dati provenienti da fonti diverse.
- Calcola riepiloghi e dati derivati.
- Inserisci i dati mancanti nei valori predefiniti.
- Elimina i dati duplicati provenienti da più fonti.
Alcuni degli Strumenti ETL può generare processi cron, processi in background, programmi Cobol e script di shell che aggiornano regolarmente il data warehouse e contribuiscono a mantenere i metadati.
Poiché attingono a numerosi sistemi, gli strumenti ETL devono anche gestire l'eterogeneità dei database e dei dati.
Metadati
Il termine metadati può sembrare complesso, ma si tratta semplicemente di dati sui dati che definiscono il data warehouse. Vengono utilizzati per costruire, mantenere e gestire il data warehouse.
Nell'ambito dell'architettura, i metadati specificano la fonte, l'utilizzo, i valori e le caratteristiche dei dati e definiscono come i dati possono essere modificati ed elaborati, in modo da rimanere strettamente connessi al data warehouse.
Ad esempio, una riga in un database di vendite può contenere:
4030 KJ732 299.90
Questo dato è privo di significato finché i metadati non spiegano che rappresenta un numero di modello pari a 4030, un ID agente di vendita pari a KJ732 e un importo totale delle vendite di 299.90 dollari.
I metadati sono quindi un ingrediente essenziale per trasformare i dati in conoscenza e aiutano a rispondere a domande come:
- Quali tabelle, attributi e chiavi contiene il data warehouse?
- Da dove provengono i dati?
- Quante volte vengono ricaricati i dati?
- Quali trasformazioni e purificazioni sono state applicate?
I metadati si dividono in due categorie:
- Metadati tecnici: Questa descrizione illustra il magazzino destinato ai progettisti e agli amministratori che lo creano e lo gestiscono.
- Metadati aziendali: Ciò offre agli utenti finali un modo semplice per comprendere le informazioni memorizzate nel data warehouse.
Strumenti di interrogazione
Uno degli obiettivi principali del data warehousing è fornire alle aziende le informazioni necessarie per prendere decisioni strategiche, e gli strumenti di interrogazione rappresentano il modo in cui gli utenti interagiscono con il sistema.
Questi strumenti rientrano in quattro categorie:
- Strumenti di query e reportistica
- Strumenti per lo sviluppo di applicazioni
- Strumenti di data mining
- Strumenti OLAP
Strumenti di query e reporting
Gli strumenti di interrogazione e reporting si dividono in due gruppi: strumenti di reporting e strumenti di interrogazione gestiti.
Strumenti di segnalazione ulteriormente suddivisi in strumenti di reporting per la produzione e strumenti di creazione di report per desktop:
- Autori del rapporto: Questi strumenti sono pensati per gli utenti finali che creano le proprie analisi.
- Reportistica sulla produzione: Questi consentono alle organizzazioni di generare report operativi regolari e supportare processi batch ad alto volume come la stampa e il calcolo. Esempi popolari includono Brio, Business Objects, OraclePowerSoft e SAS Institute.
Strumenti di query gestiti Aiuta gli utenti finali inserendo un meta-livello tra l'utente e il database, che nasconde la complessità di SQL e della struttura del database.
Strumenti per lo sviluppo di applicazioni
Quando gli strumenti grafici e analitici integrati non sono sufficienti a soddisfare le esigenze analitiche di un'organizzazione, vengono creati report personalizzati utilizzando strumenti di sviluppo di applicazioni.
Strumenti di data mining
Il data mining permette di scoprire nuove correlazioni, modelli e tendenze significativi all'interno di grandi volumi di dati, e gli strumenti di data mining automatizzano questo processo di scoperta.
Strumenti OLAP
OLAP Gli strumenti sono basati su un database multidimensionale e consentono agli utenti di analizzare i dati attraverso viste elaborate e multidimensionali.
Bus del Data Warehouse Architectura
Il bus del data warehouse determina il flusso dei dati all'interno del data warehouse. Tale flusso può essere suddiviso in flusso in entrata, flusso in uscita, flusso in entrata, flusso in uscita e meta-flusso.
Nella progettazione del bus, è necessario tenere conto delle dimensioni e dei fatti condivisi che attraversano i data mart.
Data mart
A datamart È un livello di accesso utilizzato per fornire dati agli utenti. È adatto a grandi data warehouse perché richiede meno tempo e denaro per la sua realizzazione, sebbene non esista una definizione univoca e universalmente accettata di data mart.
In parole semplici, un data mart è una sussidiaria di un data warehouse. Suddivide i dati per uno specifico gruppo di utenti e può risiedere nello stesso database del data warehouse o in un database fisicamente separato.
magazzino dati Architecture migliori Pratiche
Per progettare un'architettura di data warehouse efficace, segui le migliori pratiche riportate di seguito:
- Utilizzare modelli di data warehouse ottimizzati per il recupero delle informazioni, sia che si tratti di un data warehouse, sia di un data warehouse. dimensionale, denormalizzato o approccio ibrido.
- Scegli un approccio progettuale appropriato, che sia dall'alto verso il basso o dal basso verso l'alto.
- Assicurati che i dati vengano elaborati in modo rapido e preciso, consolidandoli in un'unica versione veritiera.
- Progettare con cura il processo di acquisizione e pulizia dei dati per il data warehouse.
- Progettare un'architettura di metadati che consenta la condivisione dei metadati tra i componenti del data warehouse.
- Considera un OperaModello ODS (Original Data Store) quando le esigenze di recupero sono vicine alla parte inferiore dell'abstract dei datitracpiramide zione o quando è necessario accedere a più fonti operative.
- Assicurati che il modello dati sia integrato anziché semplicemente consolidato; in tal caso, utilizza un modello dati 3NF, ideale anche quando si acquisiscono strumenti ETL e di pulizia dei dati.
